 AIREITER
Qwen Audio 3.0 Realtime — это голосовой стек Qwen для общения в реальном времени: модель слышит пользователя и отвечает голосом почти без паузы, на уровне привычного телефонного разговора. На платформе Alibaba эта возможность доступна через Qwen3-Omni / Qwen3.5-Omni Realtime API с идентификаторами наподобие qwen3-omni-flash-realtime. Отдельно доступны Qwen-TTS-Realtime для синтеза речи и qwen3-asr-flash для распознавания. Облачные omni-модели понимают более 100 языков, поддерживают двусторонний разговор с перебиваниями и стоят доли цента за минуту диалога.
Проще всего начать с qwen3-omni-flash-realtime через WebSocket. Ниже — разбор моделей, их стоимости, сравнение с OpenAI Realtime и Gemini Live, а также практический путь к запуску. Все характеристики, цены и ID моделей привязаны к первоисточникам — в основном к документации Model Studio Realtime от Alibaba и карточке модели Qwen3-Omni. Рынок меняется быстро, поэтому при расхождении цифр ориентируйтесь на ссылки.
Как устроена линейка аудиомоделей Qwen
У Qwen было несколько поколений аудиомоделей, и их происхождение помогает не ошибиться с выбором:
Qwen-Audio(2023) иQwen2-Audioбыли моделями для понимания аудио: принимали звук на вход и возвращали текст. Самостоятельно говорить они не умели.- В актуальном поколении аудио вошло в состав omni-моделей.
Qwen3-OmniиQwen3.5-Omniработают с текстом, изображениями, аудио и видео, а на выходе выдают и текст, и естественную речь. - Режим реального времени — это способ предоставления модели: те же omni-модели вызываются через Realtime API и имеют ID с окончанием
-realtime.
Таким образом, под названием «Qwen Audio 3.0 Realtime» обычно имеют в виду семейство Qwen3-Omni в режиме реального времени. Именно о нём далее и пойдёт речь.
Из чего состоит голосовой стек Qwen
Правильнее воспринимать Qwen не как одну модель, а как конвейер. В боевом голосовом приложении обычно задействованы три модели Qwen — их можно использовать вместе или по отдельности.
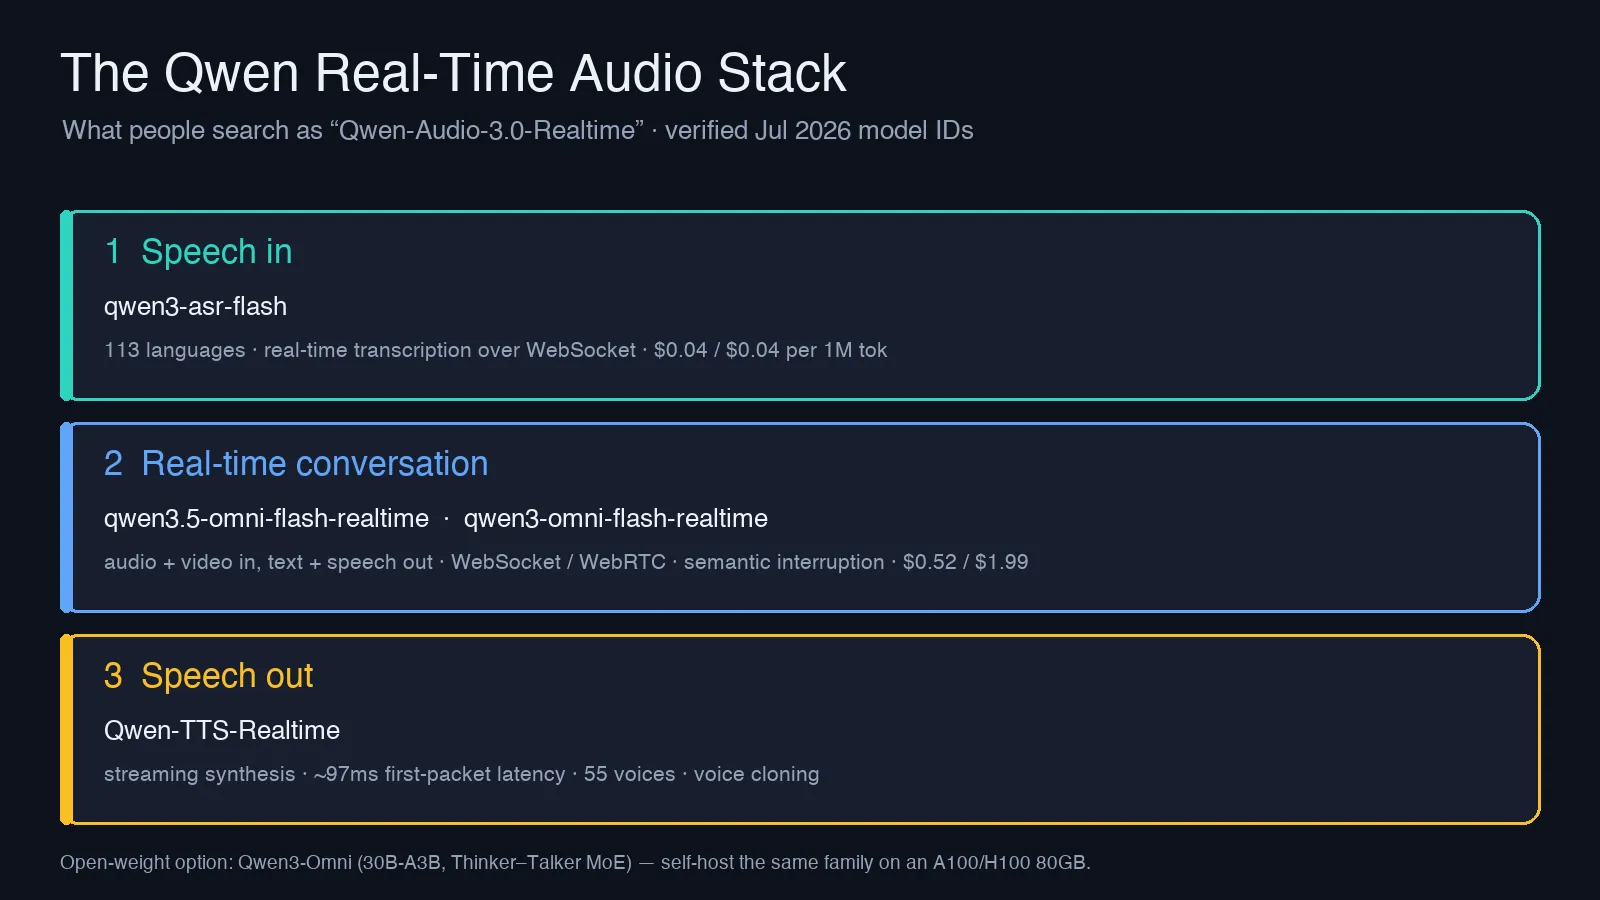
- Распознавание речи —
qwen3-asr-flash. Потоковое распознавание через WebSocket, рассчитанное на живые субтитры и фронтенды голосовых агентов. Модель работает с очень широким набором языков и служит недорогим инструментом для транскрибации. - Диалог в реальном времени —
qwen3.5-omni-flash-realtime,qwen3-omni-flash-realtime,qwen3.5-omni-plus-realtime. Основной слой: на вход поступают аудио и видеокадры, а на выходе приходят текст и синтезированная речь. Соединение остаётся открытым между репликами, а не создаётся заново для каждого запроса. - Синтез речи —
Qwen-TTS-Realtime. Отдельная потоковая TTS-модель для задач, где нужно лишь озвучить текст — например, ответ, подготовленный текстовой LLM.
Если для центрального слоя используется omni Realtime-модель, отдельные вызовы ASR и TTS часто не нужны: она сама принимает речь и возвращает речь. Выделенные модели полезны, когда компоненты нужно комбинировать, например использовать собственный STT вместе с Qwen TTS.
Характеристики, на которые стоит смотреть
Ниже приведены параметры из документации Model Studio Realtime, а не из маркетинговых материалов.
| Параметр | Qwen Realtime API (семейство omni) |
|---|---|
| Аудиовход | PCM, 16 кГц |
| Аудиовыход | PCM, 24 кГц |
| Другие типы входа | Изображения / видеокадры (JPG, до 1080p, 256 КБ после кодирования) |
| Распознавание речи | 113 языков и диалектов (облачный API) |
| Генерация речи | 36 языков и диалектов |
| Голоса | 55 всего: 47 многоязычных и 8 диалектных; в моделях 3.5 также есть клонирование голоса |
| Подключения | WebSocket (Bearer-авторизация, ручной или серверный VAD) и WebRTC (SDP-согласование) |
| Максимальная сессия | 120 минут по WebSocket |
| Дополнительные возможности | Семантическое перебивание, вызов функций, автономный веб-поиск, управление громкостью / скоростью / эмоцией голосом |
Несколько пунктов особенно важны. Семантическое перебивание позволяет модели отличить реальное прерывание от короткой реакции вроде «угу». Для голосового агента это разница между естественным и раздражающим разговором. Поддержка WebRTC критична для браузерных приложений: она берёт на себя эхоподавление и борьбу с джиттером. Наконец, заявленные 113 языков распознавания относятся к облачному API; набор языков в open-weight версии уже — об этом ниже.
По задержке: потоковый режим Qwen-TTS-Realtime ориентирован примерно на 97 мс до первого аудиопакета, согласно документации по потоковой работе Qwen3-TTS. Именно этот показатель определяет, воспринимается ли речь как мгновенная. Речь не о времени генерации целого ответа, а о первом фрагменте аудио. Полный разговорный цикл в архитектуре Thinker–Talker также рассчитан на стриминг: в техническом отчёте Qwen3-Omni описана multi-codebook архитектура, нацеленная на минимальную задержку, а тесты сообщества показывают реакцию аудио-в-аудио в диапазоне менее 250 мс при полном дуплексе и возможности перебивать модель. Реальные значения зависят от региона, сети и нагрузки, поэтому измеряйте их на собственном трафике, а не полагайтесь на одну рекламную цифру.
Сколько стоит Qwen для аудио в реальном времени
Облачные realtime-модели Qwen заметно дешевле закрытых realtime API. Ниже — ставки за миллион токенов, вход / выход, из каталога моделей DashScope от Portkey. Это сторонний агрегатор, который повторяет тарифы Alibaba; перед запуском проекта обязательно проверьте актуальные цены в консоли Model Studio:
| Модель | Вход / 1 млн токенов | Выход / 1 млн токенов |
|---|---|---|
qwen-omni-turbo-realtime | $0.27 | $1.07 |
qwen3-omni-flash-realtime | $0.52 | $1.99 |
qwen3-asr-flash (транскрибация) | $0.04 | $0.04 |
Во что это выливается на практике. Аудио расходует много токенов: примерно 427 токенов на минуту аудио. Возьмём 10-минутный голосовой разговор, где пользователь говорит 5 минут, а модель отвечает ещё 5 минут. Для qwen3-omni-flash-realtime это около 2 135 входных и 2 135 выходных токенов: примерно $0.001 за вход + $0.004 за выход ≈ полцента за 10-минутный звонок. Даже при масштабировании аудио в реальном времени остаётся недорогим; учитывать стоит прежде всего длительность исходящей речи, поскольку голосовые ответы обходятся примерно в 4 раза дороже входа.
Перед расчётом бюджета стоит учесть ещё два момента:
- Бесплатная квота есть, но зависит от региона. Для сингапурского международного endpoint предлагалась квота 1 миллион входных и 1 миллион выходных токенов на 90 дней; для endpoint в США её не было. Условия меняются, поэтому проверьте актуальное предложение для своего региона в консоли Model Studio.
- Для уровня
qwen3.5-omniдействуют ценовые диапазоны по размеру запроса, а не единая ставка. Один запрос с большим контекстом может попасть в другой тарифный диапазон по сравнению с несколькими небольшими. Проверьте это на форме вашего реального трафика до принятия решения.
Сравнение с OpenAI Realtime и Gemini Live
Среди крупных поставщиков универсальных frontier LLM в середине 2026 года очевидных вариантов для голосового общения «речь-в-речь» три: Realtime API от OpenAI, Gemini Live от Google и семейство Qwen omni Realtime. Специализированные голосовые сервисы — ElevenLabs, Deepgram, Cartesia и Hume — также активно конкурируют в TTS и STT, но здесь сравнивается именно полноценный мультимодальный модельный подход. Вместо постоянно меняющихся цен конкурентов важнее понять логику выбора:
- Стоимость. Судя по приведённым выше ценам за звонок, realtime Qwen находится у нижней границы стоимости среди облачных frontier-моделей. Для контраста: аудио в OpenAI Realtime стоило около $0.06 за минуту входа и $0.24 за минуту выхода (подробный разбор тарифов). При таком расчёте тот же 10-минутный звонок, который стоит около полцента на
qwen3-omni-flash-realtime, у OpenAI обходится ближе к $1.50. Перед тем как закладывать эту разницу в экономику, проверьте действующие тарифы с обеих сторон: цены у всех меняются, хотя разрыв остаётся значительным. Кроме того, Qwen — единственный из этой тройки вариант с open-weight версией, которую можно развернуть самостоятельно и снизить предельную стоимость почти до нуля. - Открытость. OpenAI Realtime и Gemini Live доступны только как закрытые API. Qwen3-Omni поставляется с открытыми весами, поэтому при переходе с облака на собственную инфраструктуру не придётся переписывать приложение под поведение другой модели.
- Качество. По данным сторонних обзоров, старший уровень
qwen3.5-omni-plusсопоставим с Gemini 3.1 Pro или превосходит его в некоторых бенчмарках понимания аудио. Однако любой отдельный бенчмарк — это лишь отправная точка: проверяйте качество на собственных записях. - Экосистема. У OpenAI и Google сегодня глубже наборы инструментов, SDK и примеров от сообщества. Документация Qwen качественная, но чаще придётся работать напрямую со спецификациями WebSocket и WebRTC.
Практический вывод простой: если важны цена или возможность самостоятельного хостинга, Qwen выглядит самым сильным выбором. Если нужен максимально зрелый SDK-опыт и вы готовы платить за удобство, OpenAI и Google пока выигрывают в полировке продукта. Полный разбор стоимости закрытых альтернатив — в связанных материалах ниже.
Какую модель выбрать
| Сценарий | Что использовать |
|---|---|
| Самый дешёвый облачный голосовой цикл | qwen3-omni-flash-realtime |
| Лучшее качество в облаке, длинные сессии, клонирование голоса | qwen3.5-omni-plus-realtime |
| Нужна только транскрибация | qwen3-asr-flash |
| Нужен только синтез речи | Qwen-TTS-Realtime |
| Данные должны оставаться в собственной инфраструктуре | Самостоятельно развернуть open-weight Qwen3-Omni (30B-A3B) |
Уровни 3.5 добавляют клонирование голоса, более длинный контекст и увеличенные лимиты диалога — до 100 ходов и 600 секунд сохранённого аудио. У более лёгкой qwen3-omni-flash лимит составляет 8 ходов. Для прототипа начинайте с Flash и переходите на Plus лишь тогда, когда упрётесь в конкретное ограничение.
Как получить доступ
Облачный вариант напрямую. Создайте API-ключ в Alibaba Cloud Model Studio, затем откройте WebSocket-соединение с Bearer-авторизацией. Для браузерных приложений можно согласовать WebRTC через SDP POST. В соединение передаётся PCM-аудио, а обратно поступают PCM-аудио и текст. Если не хочется вручную управлять сокетом, интерфейс Realtime оборачивает DashScope Python SDK. Минимальное подключение выглядит так — обработка ошибок намеренно опущена:
import os, json, base64, websocket

MODEL = "qwen3-omni-flash-realtime"
url = f"wss://dashscope-intl.aliyuncs.com/api-ws/v1/realtime?model={MODEL}"
ws = websocket.create_connection(
    url, header=[f"Authorization: Bearer {os.environ['DASHSCOPE_API_KEY']}"]
)

# 1. configure the session: voice, output format, server-side turn detection
ws.send(json.dumps({
    "type": "session.update",
    "session": {
        "voice": "Cherry",
        "output_audio_format": "pcm24",
        "turn_detection": {"type": "server_vad"},
    },
}))

# 2. stream microphone audio up as base64 PCM 16 kHz frames
ws.send(json.dumps({
    "type": "input_audio_buffer.append",
    "audio": base64.b64encode(pcm_frame).decode(),
}))

# 3. read events back; response.audio.delta carries PCM 24 kHz to play
while True:
    event = json.loads(ws.recv())
    if event["type"] == "response.audio.delta":
        play(base64.b64decode(event["audio"]))
При серверном VAD модель сама определяет, когда пользователь закончил говорить. Если границы реплик должны контролироваться приложением, переключайтесь на ручной режим. Поток событий во многом похож на OpenAI Realtime, поэтому существующий клиент обычно переносится с небольшими правками. Перед релизом сверяйте точные названия полей, список голосов и хост регионального endpoint с документацией Realtime: сингапурское и американское развёртывания различаются, а API продолжает развиваться.
Самостоятельный хостинг. Open-weight Qwen3-Omni построен на Mixture-of-Experts архитектуре Thinker–Talker: 30B параметров всего, около 3B активных. Alibaba рекомендует запускать модель через vLLM, а не обычный Transformers. Для BF16-инференса полной 30B-модели, по данным сторонних руководств по развёртыванию, потребуется минимум одна карта на 80 ГБ — A100 или H100. Потребительской карты на 24 ГБ, такой как RTX 4090, для полных весов недостаточно, хотя квантизованные сборки снижают требования.
Главная сложность в том, что обслуживать модель в реальном времени труднее, чем запускать пакетный инференс. При параллельной нагрузке self-hosting-практики советуют ограничивать KV-кеш, иначе возможны зависания; пропускная способность одной карты по токенам также уступает облачному API. Стриминговые серверные стеки могут заметно сократить отрыв: инженеры из Red Hat AI и vLLM сообщали, что перекрытие этапов конвейера сокращает генерацию речи для 3-секундного клипа примерно с 8 секунд до 0.5. Это реальное ускорение, но оно требует дополнительной инженерной работы. Самостоятельный хостинг убирает оплату за токены, но добавляет расходы на GPU и эксплуатацию, поэтому он оправдан при высоком стабильном объёме, а не для прототипов.
На сегодня канонический путь для omni-голоса в реальном времени — endpoint DashScope. Если инфраструктура уже пропускает нескольких поставщиков через единый шлюз, перед ним можно поставить агрегатор. Но сначала убедитесь, что в его каталоге есть конкретные realtime ID Qwen: многие посредники поддерживают текстовые и визуальные модели, но не аудиоуровень реального времени.
Ограничения, которые важно учесть заранее
- Длительность сессии ограничена 120 минутами. Для более долгих сценариев — например, линии поддержки или длительных занятий — понадобится логика переподключения с переносом контекста между сокетами.
- Регион влияет и на бесплатную квоту, и на доступность. Тестируйте тот endpoint, на котором будет работать продукт, а не первый endpoint, где вы зарегистрировались.
- Облачная и open-weight версии не идентичны. Облачный API заявляет распознавание 113 языков и генерацию на 36 языках; open-weight релиз Qwen3-Omni поддерживает более узкий набор — 19 языков для речевого ввода и 10 для речевого вывода. Если конкретный язык критичен, проверяйте именно ту версию, которую планируете выпускать.
- Стоимость real-time зависит от времени разговора, а не количества запросов. Поскольку аудио токеноёмко, разговорчивый пользователь обойдётся дороже лаконичного. Моделируйте счёт по минутам диалога, а не по числу звонков.
Частые вопросы
Поддерживает ли Qwen 3 аудио?
Да. Модели Qwen3-Omni изначально мультимодальны: они принимают аудио, текст, изображения и видео, а отвечать могут текстом или речью в реальном времени.
Может ли Qwen генерировать аудио, а не только понимать его?
Да. В отличие от оригинальной Qwen-Audio, которая выдавала только текст, omni Realtime-модели и Qwen-TTS-Realtime генерируют речь. В линейке 3.5 доступно и клонирование голоса.
Аудио Qwen в реальном времени бесплатно?
Доступна бесплатная пробная квота: исторически это был 1 миллион входных и 1 миллион выходных токенов на 90 дней для международного сингапурского endpoint. После её исчерпания действует оплата за токены. Полностью open-weight Qwen3-Omni можно запускать бесплатно, если у вас есть собственный GPU.
Как запустить Qwen Audio локально?
Скачайте open-weight Qwen3-Omni (30B-A3B) и обслуживайте модель через vLLM. Для полной модели в BF16 понадобится карта примерно на 80 ГБ — A100 или H100. Более компактные потребительские GPU подходят только для квантизованных сборок, но не для полных весов.
Материалы по теме
Основные источники:
Стоимость альтернативных решений: