 AIREITER
Главное сразу: Seed Audio 1.0 уже стоит попробовать, если вы делаете короткие аудиоролики на английском или китайском. Но получать доступ сейчас разумнее через сторонние шлюзы, а не официальный API. Модель ByteDance по одному промпту собирает целую звуковую сцену — диалоги, фоновую музыку и эффекты. От обычных TTS- или музыкальных сервисов её отличают многоголосые сцены и встроенное сведение с музыкой. Ограничений, впрочем, хватает: не более двух минут аудио за генерацию, только английский и китайский языки, а официальный API пока доступен лишь по приглашениям и без опубликованных тарифов. Разберёмся подробнее.
Что представляет собой Seed Audio 1.0
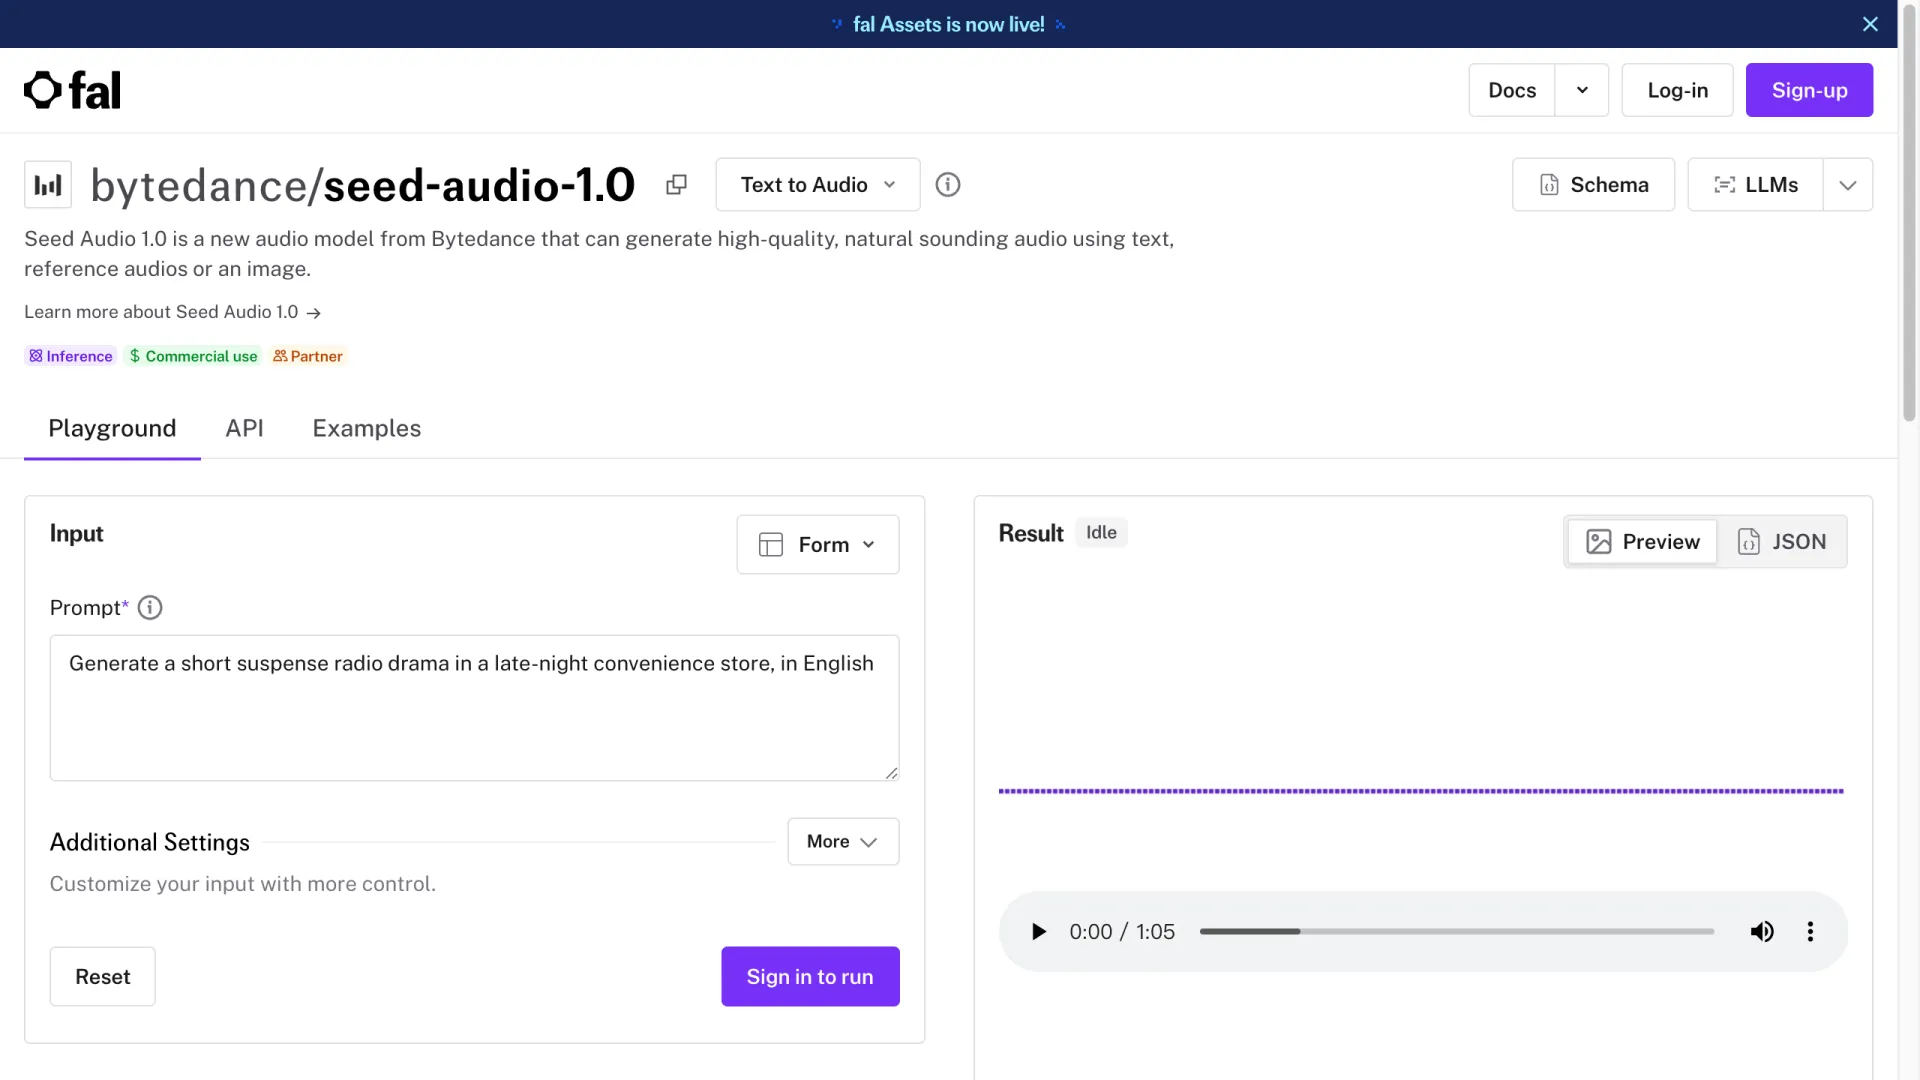
Большинство аудиоинструментов решают одну задачу: синтезируют речь, генерируют музыку или создают звуковые эффекты. Seed Audio 1.0, полное название — Doubao-Seed-Audio 1.0, объединяет всё это на одной временной шкале и генерирует результат за один проход. Достаточно описать сцену, например «напряжённая радиопостановка в круглосуточном магазине поздней ночью», — и модель вернёт готовую дорожку с репликами, атмосферными звуками и уже сведённой музыкальной подложкой.
У модели три режима работы. Text-to-audio (T2A) создаёт сцену по текстовому описанию. Text-and-audio-to-audio (TA2A) принимает референсные аудиоклипы вместе с текстом, позволяя направлять голос и стиль. Обычный TTS предназначен для чистой озвучки, когда нужна только речь. Выбор режима зависит от того, какие входные данные вы подаёте.
Важно уточнить один момент: можно ли считать это инструментом клонирования голоса? Seed Audio 1.0 способна заставить один голос сыграть несколько ролей и воспроизвести тональность референсного клипа, но результат синтезируется и не привязывается к личности конкретного реального человека. Это скорее zero-shot стилизация голоса, а не клонирование названного человека без его согласия. Модель опирается на более ранние исследования ByteDance — Seed-TTS и Seed-Music, — поэтому в одном решении сочетаются выразительная речь и генерация музыки.
Характеристики, которые определяют сценарий использования
Сначала стоит проверить, укладывается ли ваш сценарий в жёсткие ограничения модели. Ниже — ключевые параметры, сверенные по карточкам модели на fal и EvoLink:
| Параметр | Значение |
|---|---|
| Максимальная длина результата за генерацию | 120 секунд (2 минуты) |
| Лимит текстового промпта | ~1 500–2 000 символов (источники расходятся; уточняйте в консоли) |
| Референсное аудио | До 3 клипов, каждый ≤30 секунд |
| Языки | Только английский и китайский |
| Форматы вывода | WAV, MP3, PCM, OGG Opus |
| Частоты дискретизации | 48K / 24K / 16K / 8K |
| Настройки | Скорость, высота тона, громкость (без SSML) |
| Модель тарификации | По длительности сгенерированного аудио |
Сильнее всего ощущается лимит в две минуты. Полный эпизод подкаста или длинную начитку придётся делить на фрагменты и затем склеивать, а это чревато изменением тона между кусками. В примечаниях к модели на fal упоминается запланированное обновление: длительность одной генерации хотят увеличить примерно до десяти минут, добавить явный контроль длины и поддержку большего числа языков. Если вы работаете с длинными форматами, возможно, имеет смысл дождаться этого обновления.
Цены
Официальных цен пока нет. По состоянию на июль 2026 года Volcengine не публиковала стоимость Seed Audio 1.0 за секунду: на Volcano Ark модель всё ещё работает по приглашениям, а официальные тарифы обычно появляются вместе с общедоступным запуском. Шлюзы вроде fal и EvoLink также не фиксируют ставку: расчёт идёт по длительности результата (стоимость = сгенерированные секунды × ставка), поэтому повторные попытки тоже учитываются. Цифры в токенах, которые встречаются в сети, лучше игнорировать: для аудиомодели с оплатой по длительности такая схема не подходит.
Как получить доступ прямо сейчас
На практике есть два пути, и они заметно отличаются.
Официальный вариант — Volcano Ark, где Seed Audio 1.0 доступна только по приглашению. Нужно подать заявку, дождаться одобрения и работать в собственной консоли ByteDance. После общего запуска и публикации тарифов именно этот канал будет первоисточником информации.
Более практичный путь — сторонний шлюз. fal размещает модель под именем bytedance/seed-audio-1.0 без вайтлиста: endpoint можно вызывать через API с обычным ключом. Похожий доступ предлагает EvoLink. Сейчас это основной способ генерировать аудио в модели, не ожидая приглашения.
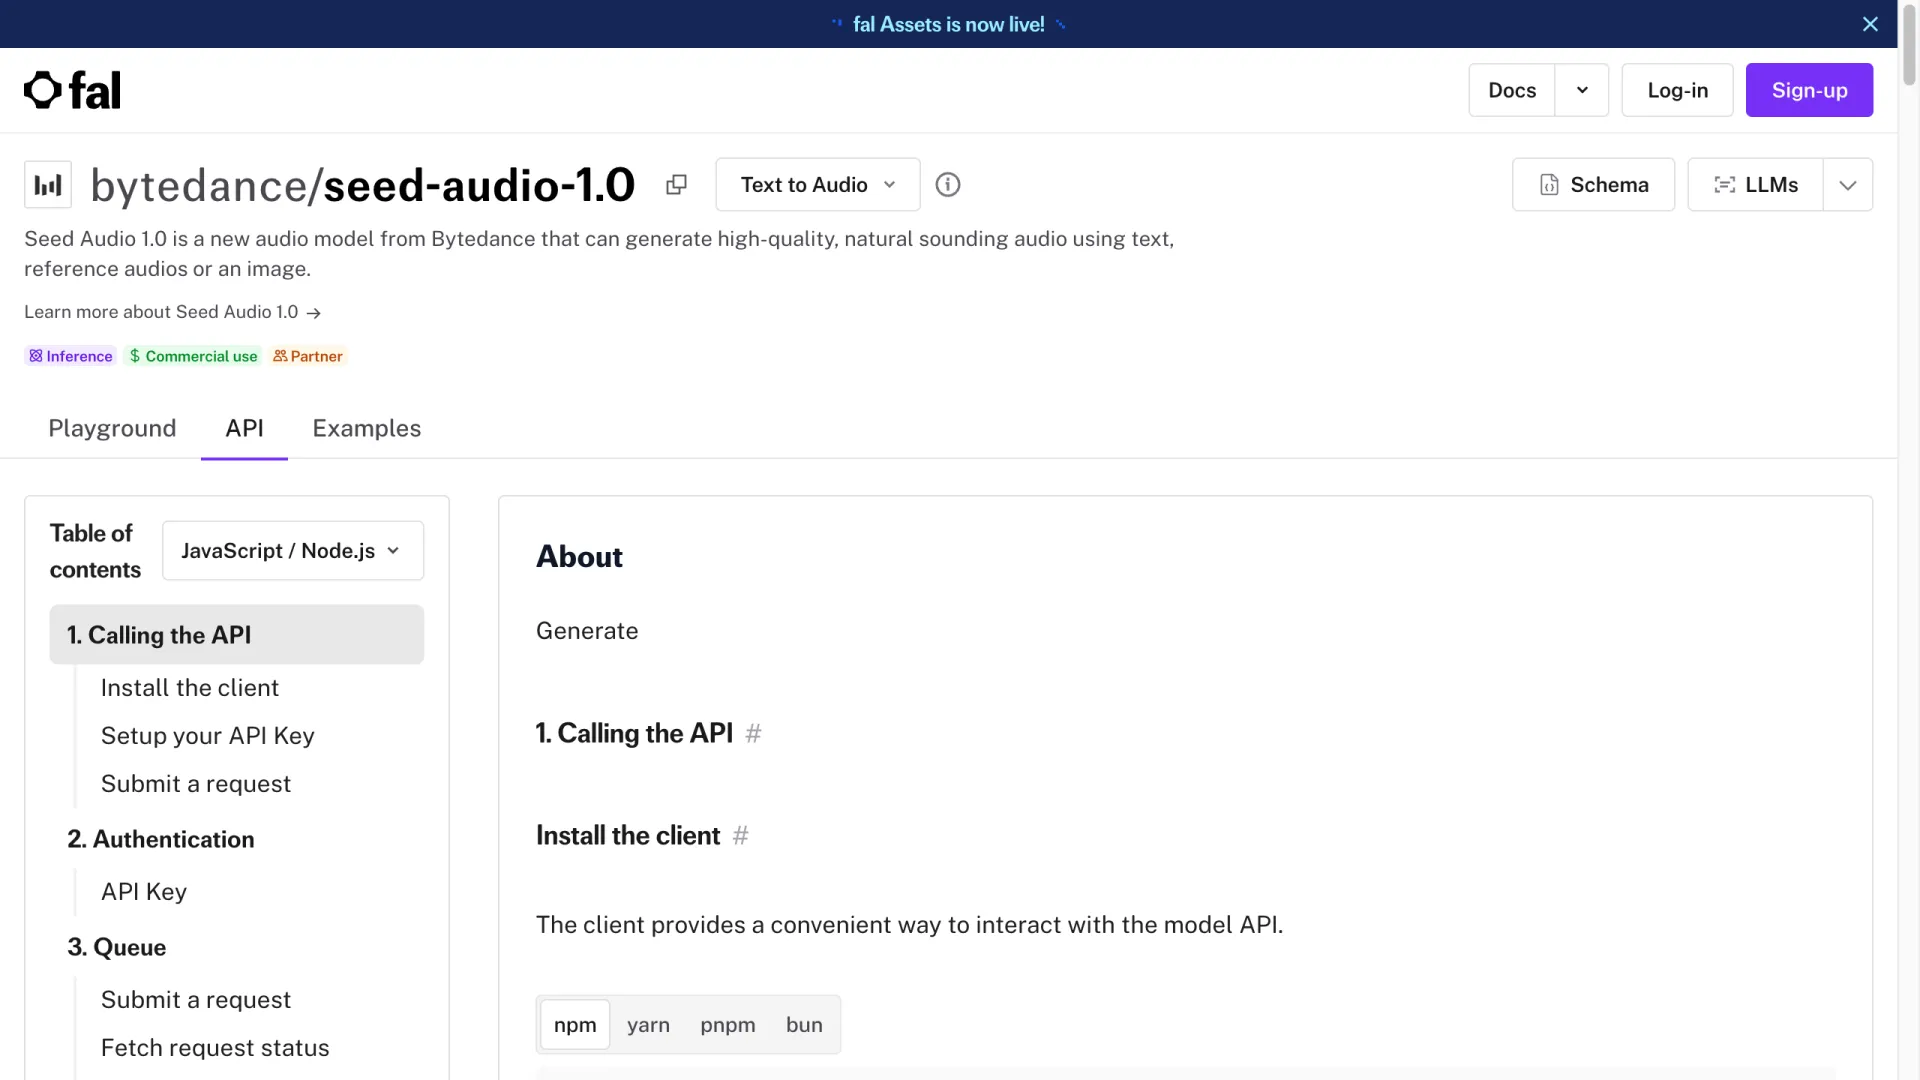
Схема вызова здесь стандартная для API с очередью: установите клиент, задайте ключ, отправьте промпт и дождитесь результата через опрос статуса. Если вы уже подключали подобные хостинговые генеративные модели, ничего принципиально нового не будет; подробнее опыт разработчика разобран в нашем обзоре fal.ai.
Для первого теста лучше взять короткую сцену с несколькими голосами, чтобы одновременно проверить диалог, атмосферу и темп. Например: «30-секундная напряжённая радиопостановка в круглосуточном магазине поздней ночью, английский язык». Первый клип стоит держать короче 30 секунд: неудачная попытка обойдётся дешевле, пока вы выясняете, как модель интерпретирует промпты.
Seed Audio 1.0 на фоне ElevenLabs, Stable Audio и AudioCraft
Сравнивать эти сервисы стоит не по качеству отдельного клипа, а по задачам, под которые каждый из них создан.
| Инструмент | Ключевая сильная сторона | Сведение сцены | Языки | Управление голосом |
|---|---|---|---|---|
| Seed Audio 1.0 | Полноценные аудиосцены (речь + музыка + SFX) | Да, за один проход | EN, CN | Zero-shot стилизация |
| ElevenLabs | Речь и клонирование голоса | Только речь | 30+ | Лучшее клонирование |
| Stable Audio | Генерация музыки и звуков | Одна дорожка | N/A (музыка) | Через промпт |
| AudioCraft | Open-source-инструмент для музыки/SFX | Одна дорожка | N/A (музыка) | Через промпт |
Если вам нужна максимально качественная речь или точное клонирование голоса на множестве языков, ElevenLabs по-прежнему впереди. Для отдельной музыки лучше подходят Stable Audio или Meta AudioCraft. Сильная сторона Seed Audio 1.0 — в объединении диалогов, музыки и эффектов в цельную редактируемую сцену: ни один другой инструмент в этой таблице не делает этого одним вызовом.
Сильные стороны и ограничения модели
Что получается лучше всего: главная причина обратить внимание на модель — многоголосые диалоги и сведение музыки с эффектами за один проход. А описанные в руководстве fal рабочие процессы редактирования — продолжение клипа, in-painting отдельных участков и склейка дублей — превращают её из разового генератора в производственный инструмент.
Где есть ограничения: двухминутный предел вынуждает склеивать всё, что длиннее. Поддержка только английского и китайского исключает большую часть международных голосовых задач. Это офлайн-модель генерации, поэтому для голосовых агентов в реальном времени она не подходит. Наконец, официальный доступ всё ещё закрыт приглашениями.
Стоит ли пользоваться Seed Audio 1.0 уже сейчас?
Если ваш контент на английском или китайском и относится к коротким форматам — дубляжу, фрагментам аудиокниг, саундтрекам для коротких видео, прототипам радиопостановок, — Seed Audio 1.0 стоит попробовать через шлюз уже сегодня. Генерация сцены одним проходом избавляет от ручного сведения речи, музыки и эффектов.
Если вам нужно взаимодействие в реальном времени, неподдерживаемый язык или длинное непрерывное аудио, лучше подождать. Общедоступный релиз и запланированное увеличение длины изменят расклад, а для живых сценариев пока лучше подойдёт модель реального времени вроде Qwen Audio 3. Для остальных это скорее момент «протестировать через шлюз и оставить текущий стек работающим», а не повод полностью переходить на новую модель.
FAQ
Seed Audio 1.0 бесплатна?
Нет. Бесплатного официального тарифа нет: API Volcano Ark доступен только по приглашениям и после получения доступа тарифицируется по длительности результата. Сторонние шлюзы взимают плату по собственным тарифам.
Можно ли клонировать свой голос в Seed Audio 1.0?
Модель может имитировать стиль референсного клипа и озвучивать несколько ролей, но генерирует синтезированную речь, а не фиксированную копию конкретного реального человека. Не стоит воспринимать её как прямую замену инструменту клонирования личности.
Какие языки поддерживает Seed Audio 1.0?
На запуске — только английский и китайский. Согласно примечаниям к модели на fal, более широкая многоязычная поддержка запланирована в будущем обновлении.
Какой длины может быть сгенерированное аудио?
Сейчас — до 120 секунд за одну генерацию. Запланированное обновление увеличит длину одной генерации примерно до десяти минут и добавит явный контроль длины.
Есть ли официальный API Seed Audio 1.0?
Да, на Volcano Ark от Volcengine, но пока только по приглашениям. Для открытого доступа без вайтлиста можно использовать шлюз вроде fal, где размещена модель bytedance/seed-audio-1.0.
Чем Seed Audio отличается от Seed Music?
Seed-Music — более раннее исследование ByteDance, сфокусированное на музыке. Seed Audio 1.0 объединяет эту музыкальную функциональность с речью и звуковыми эффектами в одной модели генерации сцен.