 AIREITER
Контекст на миллион токенов и endpoint с ценой $0 выглядят как веская причина сразу выбрать Nemotron 3 Ultra. Но для продакшена этого недостаточно: бесплатный маршрут годится для оценки модели, а рабочий сервис потребует надежного провайдера, продуманной обработки данных и платного резервного варианта.
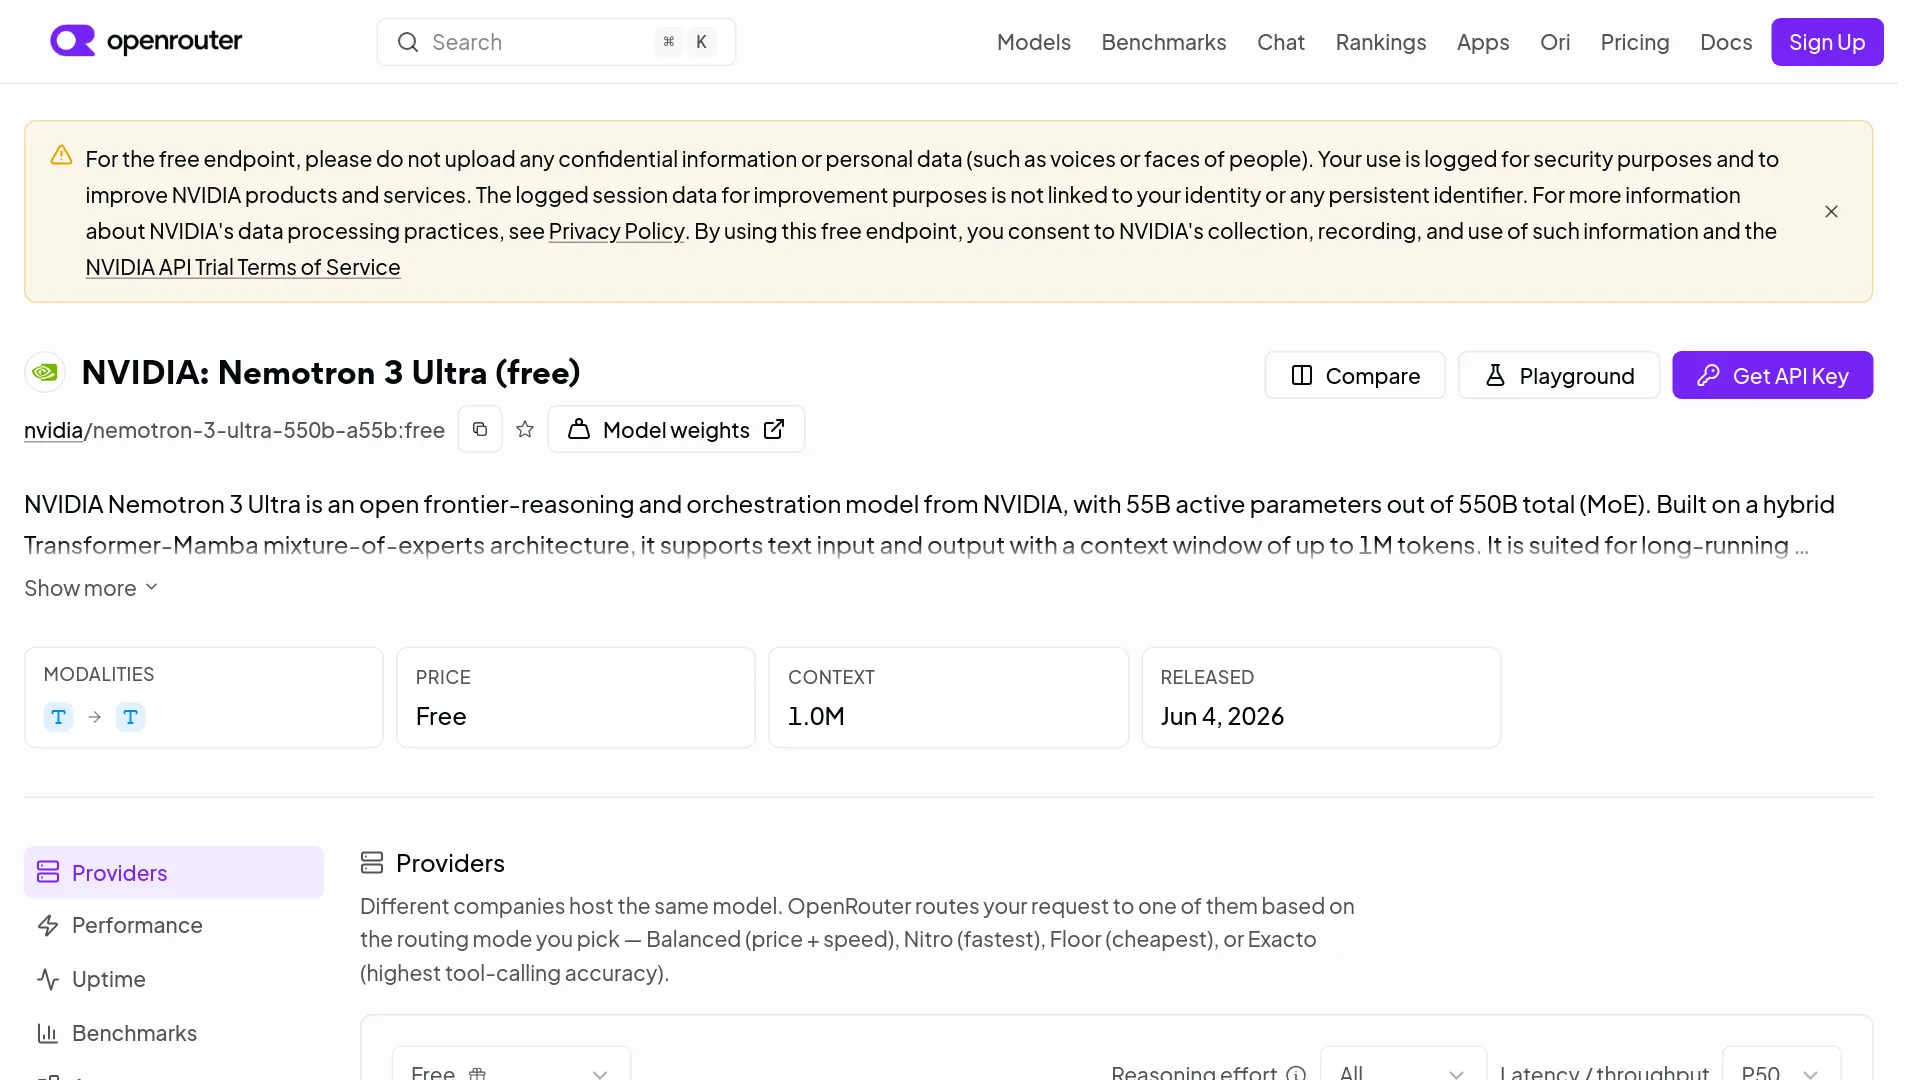
Стоит ли использовать Nemotron 3 Ultra API?
Nemotron 3 Ultra API имеет смысл протестировать для долго работающих текстовых агентов, анализа больших документов и задач программирования, которым помогает очень длинный контекст. В качестве универсального API для обычного чата с низкой задержкой он подходит хуже. То же касается конфиденциальных запросов через публичный бесплатный endpoint и продакшен-сервисов без резервного маршрута.
NVIDIA выпустила Nemotron 3 Ultra 4 июня 2026 года. В официальной карточке модели NVFP4-чекпойнт обозначен как версия 1.0 GA и распространяется для коммерческого и некоммерческого использования по лицензии OpenMDW 1.1.
| Что важно для решения | Проверенное значение | Почему это важно |
|---|---|---|
| Размер модели | 550B всего, 55B активно | Разреженные вычисления не делают полный набор весов маленьким |
| Максимальный контекст | До 1M токенов | У конкретного маршрута лимит провайдера может быть ниже |
| Модальность | Текстовый ввод и вывод | Понимания изображений и видео нет |
| Официальный NVFP4 SWE-Bench Verified | 69.7 | Важный показатель для оценки кодинг-агентов |
| Официальный NVFP4 RULER 1M | 94.0 | Поддерживает сценарии с длинным контекстом |
| Бесплатная цена в OpenRouter | $0 за ввод, $0 за вывод | Подходит для тестов, но не является SLA |
| Снимок доступности OpenRouter | 84.07% успешных запросов за три дня | Доступность endpoint не всегда означала успешное выполнение |
| Официальный минимум для самостоятельного запуска | 4x B200-класса или 8x H100 | Обычным рабочим компьютером здесь не обойтись |
Приведенные выше результаты бенчмарков взяты из карточки модели NVIDIA и отражают данные первого источника. Доступность в OpenRouter — это динамический показатель провайдера, а не постоянная гарантия.
Как вызвать бесплатный Nemotron 3 Ultra API за пять минут
Самый быстрый бесплатный вариант — совместимый с OpenAI endpoint chat-completions в OpenRouter и точный идентификатор модели nvidia/nemotron-3-ultra-550b-a55b:free. Создайте ключ OpenRouter, храните его в переменной окружения и сначала отправьте небольшой тестовый запрос — не начинайте сразу с задачи на длинном контексте.
- Создайте API-ключ в OpenRouter.
- Экспортируйте его в переменную
OPENROUTER_API_KEY. - Отправьте запрос на
/api/v1/chat/completions, указав бесплатный идентификатор модели. - Во время оценки записывайте HTTP-статус, задержку и пустые ответы.
- До выхода в продакшен добавьте платный маршрут или другую модель.
curl https://openrouter.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nvidia/nemotron-3-ultra-550b-a55b:free",
    "messages": [
      {
        "role": "user",
        "content": "Return three risks in this migration plan as a numbered list."
      }
    ],
    "max_tokens": 500
  }'
Тот же маршрут можно использовать через клиент OpenAI для Python — достаточно изменить base_url и model:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["OPENROUTER_API_KEY"],
    base_url="https://openrouter.ai/api/v1",
)

response = client.chat.completions.create(
    model="nvidia/nemotron-3-ultra-550b-a55b:free",
    messages=[
        {
            "role": "user",
            "content": "Inspect this plan and list the three highest-impact risks.",
        }
    ],
    max_tokens=500,
)

print(response.choices[0].message.content)
На что действительно можно рассчитывать в бесплатном маршруте
Бесплатный маршрут Nemotron 3 Ultra не обещает ни неограниченной пропускной способности, ни доступности уровня продакшена. В карточке OpenRouter бесплатные endpoint помечены как ограниченные по частоте запросов, но точная квота на странице модели не указана. В снимке от 19 сентября доступность составляла 100%, однако за три дня успешными были только 84.07% запросов: ошибки и пустые ответы учитывались как сбои.
В том же снимке OpenRouter указывал контекст на 1M токенов, максимальный ответ на 65,536 токенов, поддержку вызова инструментов, медианную задержку 2.28 секунды и медианную скорость 29 токенов в секунду.
Есть и ограничение, зависящее от конкретного провайдера: бесплатный маршрут OpenRouter поддерживал tools и tool_choice, но не обеспечивал принудительное соблюдение response_format. В платном маршруте Segmind заявлен вывод по JSON Schema — $0.625 за миллион входных токенов и $2.75 за миллион выходных токенов. Если код рассчитывает на строгий JSON, проверяйте именно выбранного провайдера, а не делайте выводы по возможностям базовой модели.
Не отправляйте конфиденциальные или персональные данные через бесплатный маршрут OpenRouter. В его описании сказано, что запросы журналируются в целях безопасности и могут использоваться для улучшения продуктов и сервисов NVIDIA. При 429, тайм-ауте или пустом ответе применяйте ограниченный экспоненциальный backoff, а затем переключайтесь на платный маршрут. Бесконечно повторять действие агента нельзя.
Что на практике меняет конфигурация 550B A55B
Обозначение 550B-A55B означает, что Nemotron 3 Ultra содержит 550 миллиардов параметров, но для каждого токена активирует примерно 55 миллиардов. NVIDIA использует маршрутизацию LatentMoE, Mamba-2, отдельные слои внимания и Multi-Token Prediction. Разреженная активация сокращает вычисления на токен, но все веса по-прежнему нужно хранить, распределять между ускорителями или выгружать. Поэтому A55B — это не модель, которую можно развернуть как обычную 55B.
В исследовательском релизе NVIDIA заявляет контекст до 1M токенов и сравнивает пропускную способность на необычном сценарии: 8,000 входных токенов и 64,000 выходных. По данным NVIDIA, модель обеспечивает в 5.9 раза большую пропускную способность, чем GLM-5.1-754B-A40B, в 4.8 раза большую, чем Kimi-K2.6-1T-A32B, и в 1.6 раза большую, чем Qwen-3.5-397B-17B. Абсолютные значения пропускной способности и конфигурация оборудования не указаны, поэтому превращать эти множители в прогноз задержки API не стоит.
Для выбора конфигурации полезнее официальная таблица BF16/NVFP4:
| Бенчмарк | BF16 | NVFP4 | Практический вывод |
|---|---|---|---|
| SWE-Bench Verified | 71.9 | 69.7 | Квантизация отнимает 2.2 балла в этом тесте программирования |
| Terminal Bench 2.1 | 56.4 | 53.9 | В агентских терминальных задачах результат тоже снижается |
| TauBench V3 average | 70.9 | 70.3 | Средний результат в работе с инструментами остается близким |
| GPQA, без инструментов | 87.0 | 87.9 | NVFP4 не во всех задачах слабее |
| RULER 1M | 94.7 | 94.0 | Извлечение данных из длинного контекста остается на близком уровне |
| OmniScience non-hallucination | 78.7 | 75.5 | Проверки фактической точности по-прежнему необходимы |
Разница зависит от задачи: NVFP4 теряет 3.2 балла в тесте на отсутствие галлюцинаций, но получает 0.9 балла в GPQA.
Выбирайте модель под задачу, а не по числу параметров
Nemotron 3 Ultra стоит сравнивать с DeepSeek V4, GLM 5.2 и Qwen 3.8 Max на том рабочем сценарии, который вы собираетесь запускать, а не по размеру моделей. В рамках этого материала нет результатов, полученных на одном и том же стенде, которые подтверждали бы универсального победителя. Поэтому надежный подход — составить план тестирования и заранее проверить ограничения каждого варианта.
| Задача | С чего начать | Что проверить перед выбором |
|---|---|---|
| Извлечение данных из документов на миллион токенов или их синтез | Nemotron 3 Ultra | Официальный NVFP4 RULER 1M — 94.0; проверьте точность извлечения и задержку prefill на реальной длине запроса |
| Долго работающий кодинг-агент | Nemotron 3 Ultra или DeepSeek V4 | Nemotron набирает 69.7 в SWE-Bench Verified и 53.9 в Terminal Bench 2.1; сравните успешность задач в репозитории и корректность вызовов инструментов на одном стенде |
| Автоматизация со структурированным выводом | GLM 5.2, Qwen 3.8 Max или провайдер Nemotron с поддержкой схем | Бесплатный OpenRouter не обеспечивает response_format; измерьте соблюдение схемы и число повторных запросов на конкретном маршруте |
| Большой поток коротких запросов | DeepSeek V4, GLM 5.2 или Qwen 3.8 Max | Сравните стоимость успешной задачи и p95-задержку: масштаб Ultra не делает модель автоматически выгодной |
| Развертывание открытой модели на оборудовании NVIDIA | Nemotron 3 Ultra | Сравните BF16 и NVFP4 на целевой задаче, а затем посчитайте устойчивую загрузку оборудования |
У DeepSeek V4 и GLM 5.2 есть отдельные API на AIReiter, а Qwen 3.8 Max доступна как размещенная чат-модель: руководство по DeepSeek V4 Pro API, обзор GLM 5.2 API и цены на Qwen 3.8 Max API. Это альтернативы для оценки, а не утверждение, что одна модель лучше на любой задаче.
Можно ли запустить Nemotron 3 Ultra локально?
Nemotron 3 Ultra можно развернуть самостоятельно, но «локально» здесь означает оборудование дата-центра или DGX Station, а не ноутбук. NVIDIA указывает 4x GB200, 4x B200, 4x GB300, 4x B300 или 8x H100 как минимальные конфигурации для стандартного сценария запуска.
В официальных примерах vLLM в карточке модели NVIDIA используются тензорный и экспертный параллелизм 4-way, FP8 KV-кэш, поэтапный prefill и спекулятивное декодирование MTP. В стандартном примере по умолчанию задано 262,144 токена; для включения 1,048,576 токенов требуется явно изменить параметр. Поэтому заявленный максимальный контекст не является настройкой по умолчанию.
NVIDIA также описывает специальное развертывание на одной DGX Station. NVFP4-чекпойнт запускается на одном интегрированном GPU GB300, которому доступно до 150 GiB общей памяти CPU; веса экспертов при этом выгружаются. Для такого сценария нужны vLLM 0.22.0, специализированный NVFP4-бэкенд для Blackwell и архитектура памяти DGX Station. На обычный ПК с одной видеокартой этот рецепт не переносится.
| Вариант развертывания | Когда выбирать | Главное ограничение |
|---|---|---|
| Бесплатный API OpenRouter | Для оценки промптов и поведения инструментов | Лимиты частоты, журналирование и нестабильная доступность |
| Платный размещенный API | Для запуска продукта до того, как объем использования оправдает покупку оборудования | Различия в цене провайдера, точности, контексте и возможностях |
| Самостоятельный запуск на 4x B200-класса / 8x H100 | Когда важны стабильный объем, контроль над данными или кастомизация модели | Капитальные затраты и эксплуатация распределенного инференса |
| Одна DGX Station GB300 с выгрузкой весов | Если у вас есть именно такая система с общей памятью | Задержка из-за выгрузки и привязка к конкретному оборудованию |
Частые вопросы о Nemotron 3 Ultra API
Nemotron 3 Ultra API бесплатен?
Да. OpenRouter указывает для nvidia/nemotron-3-ultra-550b-a55b:free цену $0 за входные и выходные токены, но endpoint ограничен по частоте запросов, а обращения журналируются.
Действительно ли Nemotron 3 Ultra поддерживает миллион токенов?
NVIDIA указывает максимум в 1M токенов, однако у маршрутов провайдеров настройки по умолчанию могут быть ниже. В примере NVIDIA для vLLM по умолчанию используется 262,144 токена, а 1,048,576 нужно включать отдельно.
Поддерживает ли API инструменты и структурированный JSON?
Модель поддерживает инструменты, но принудительное соблюдение формата зависит от провайдера: в бесплатном OpenRouter нет обязательного response_format, тогда как Segmind заявляет строгую поддержку JSON Schema.
Можно ли использовать Nemotron 3 Ultra в коммерческих проектах?
NVIDIA указывает, что релиз по OpenMDW 1.1 разрешает коммерческое и некоммерческое использование. Изучите условия лицензии в официальной карточке модели, особенно требования к распространению и развертыванию.
Можно ли отключить рассуждения?
Документация API NVIDIA предоставляет параметр enable_thinking=True/False. Размещенные провайдеры могут обрабатывать эту настройку по-разному, поэтому проверьте поддерживаемый параметр и учет токенов на выбранном маршруте.
Эквивалентна ли конфигурация 550B A55B плотной модели на 55B?
Нет. Для каждого токена активны примерно 55B параметров, но все 550B параметров по-прежнему нужно хранить, распределять или выгружать.
Решение о развертывании, а не гонка за лучший бенчмарк
Начать разумнее всего с бесплатного Nemotron 3 Ultra API, используя несекретные промпты и небольшой набор тестов. Переходите на платный endpoint, когда становятся важны сбои, соблюдение схемы или предсказуемая емкость. Самостоятельный запуск оправдан только тогда, когда измеренная загрузка, требования к приватности или кастомизация действительно окупают как минимум четыре современных GPU с большим объемом памяти либо описанный NVIDIA вариант с DGX Station.
| Что показало тестирование | Следующий шаг |
|---|---|
| Качество высокое, но бесплатные запросы завершаются ошибками или стоят в очереди | Добавить платный маршрут Nemotron и политику повторных запросов |
| Главное преимущество — извлечение данных из длинного контекста | Проверить самый большой реальный документ и измерить время prefill |
| Основная проблема — ошибки JSON | Выбрать провайдера с принудительной поддержкой схем или сравнить маршруты GLM/Qwen |
| Главными становятся стоимость или задержка коротких задач | Выбрать меньшую модель, оставив Ultra для сложных случаев |
| Данные не могут покидать вашу сеть | Рассчитать бюджет официального многогпу-контура до начала внедрения |