 AIREITER
У GLM-5.2 почти любой маршрут принимает запрос в формате OpenAI — но одинакового поведения за этим форматом ждать не стоит. После запуска 16 июня API GLM-5.2 выглядит выгодным выбором для экономных задач кодинга и агентов. Но в проде придётся самостоятельно закрыть три класса проблем: семантику tool calls, штормы повторных запросов и учёт кэша. Заявленные $1.40/$4.40 за миллион токенов — реальные цены, однако стоимость завершённой задачи часто оказывается совсем другой. Именно эту разницу и разбираем в обзоре.
Совместимость с OpenAI: что действительно работает
В официальной документации GLM-5.2 прямо рекомендован OpenAI Python SDK: достаточно указать base URL https://api.z.ai/api/paas/v4/ и модель glm-5.2. Для простого чата миграция действительно сводится к трём строкам. Однако совместим здесь прежде всего формат запроса, а не смысл ответов, необязательные управляющие поля OpenAI и тем более новый интерфейс Responses API.
| Параметр из документации | Значение |
|---|---|
| Модальность | Текст на входе и выходе, без зрения |
| Контекстное окно | 1M токенов |
| Максимальный вывод | 128K токенов |
| Заявленные возможности | Режим рассуждений, стриминг, function call, кэширование контекста, структурированный вывод, MCP |
| Тарифицируемый endpoint | https://api.z.ai/api/paas/v4/ |
| Endpoint Coding Plan | https://api.z.ai/api/coding/paas/v4 |
| Anthropic-совместимый endpoint | https://api.z.ai/api/anthropic |
| Официальные SDK | zai-sdk (Python), Java, OpenAI SDK |
Первое важное ограничение: у Z.ai вообще нет Responses API. Как отмечает u/quinncom, «Codex поддерживает только формат Responses API, которого в Z.ai нет». Поэтому часть пользователей прокладывает запросы через ZenMux как слой трансляции. Второй нюанс касается Claude Code: он работает через Anthropic-совместимый endpoint, но в заметках по настройке от @armor_rust выделены две ловушки. Во-первых, нужно использовать AUTH_TOKEN, а не API_KEY: второй вариант запускает подтверждение доверия, которое после одного отказа может навсегда заблокировать доступ. Во-вторых, URL для подписки и pay-as-you-go различаются. Полная инструкция есть в нашем гайде по настройке Claude Code.
Точно сформулировал один из разработчиков: «совместимость API заканчивается на форме запроса; tool calling всё равно нужно отдельно тестировать для каждого провайдера» — @sebuzdugan.
Вызовы инструментов: в коротких сценариях хорошо, в длинных — риск зацикливания
В небольших контролируемых цепочках GLM-5.2 API выдаёт ровно то, что обещает документация. Но в длительных агентных циклах активные пользователи сталкиваются с повреждёнными последовательностями вызовов, которые продолжаются, пока их не остановят ограничения на стороне клиента. Эти выводы не противоречат друг другу: всё зависит от того, какой именно цикл вы строите.
Согласно документации Z.ai и тесту GLM52.ai из 27 Docker-запросов, можно передать до 128 описаний функций. Имена ограничены 64 символами и должны соответствовать ^[a-zA-Z0-9_-]+$; параметры задаются через JSON Schema, аргументы возвращаются JSON-строкой, которую приложение обязано валидировать. Документирован только режим tool_choice: "auto". На маршруте Coding Plan этот набор прошёл 27 из 27 запросов: 4/4 точных совпадения функции и аргументов, 3/3 корректных отказа от вызова инструментов, 4/4 случая с двумя заказами в двух верхнеуровневых вызовах и медианная задержка 5.3 секунды.
Проблема начинается с полей, которые пользователи OpenAI привыкли считать доступными. В противоречивых пробах GLM52.ai endpoint отвечал HTTP 200, но затем просто игнорировал управляющие указания:
| Отправленное OpenAI-подобное управление | Наблюдаемое поведение |
|---|---|
tool_choice: "required" + «не используй инструменты» | Остановился, вызовов 0 |
| Объект принудительного выбора функции + «никогда не используй этот инструмент» | Остановился, вызовов 0 |
parallel_tool_calls: false + запрос с двумя заказами | Всё равно вернул два вызова |
strict: true | Один раз принят; доказательств соблюдения схемы нет |
Успешный HTTP-ответ ещё не означает, что вы получили контракт на ожидаемое поведение. Особенно явно это проявляется в длинных циклах.
Разработчик, прогнавший через модель примерно четыре миллиарда токенов, описал проблему без обиняков: «главная проблема GLM 5.2 после 4 млрд токенов — отсутствие vision, путаница с tool calls и смерть от повреждённых tool calls: модель просто уходит в спираль» — @RasputinKaiser. Есть и единичный отчёт без ответа о том, как модель закодировала второй tool call внутри аргументов первого. Это всего один случай, но именно от такого класса сбоев и должна защищать клиентская логика цикла.
Рабочая практическая защита — не поручать модели оркестрацию. Один разработчик запускает NVIDIA NIM с tool_call: false, оставляя весь цикл агентному фреймворку. В эталонном ограниченном цикле модель делает не более четырёх шагов, за ход разрешено максимум четыре вызова, а JSON всех аргументов проверяется до исполнения.
Стриминг и задержки: цифры, о которых не говорят в рекламе
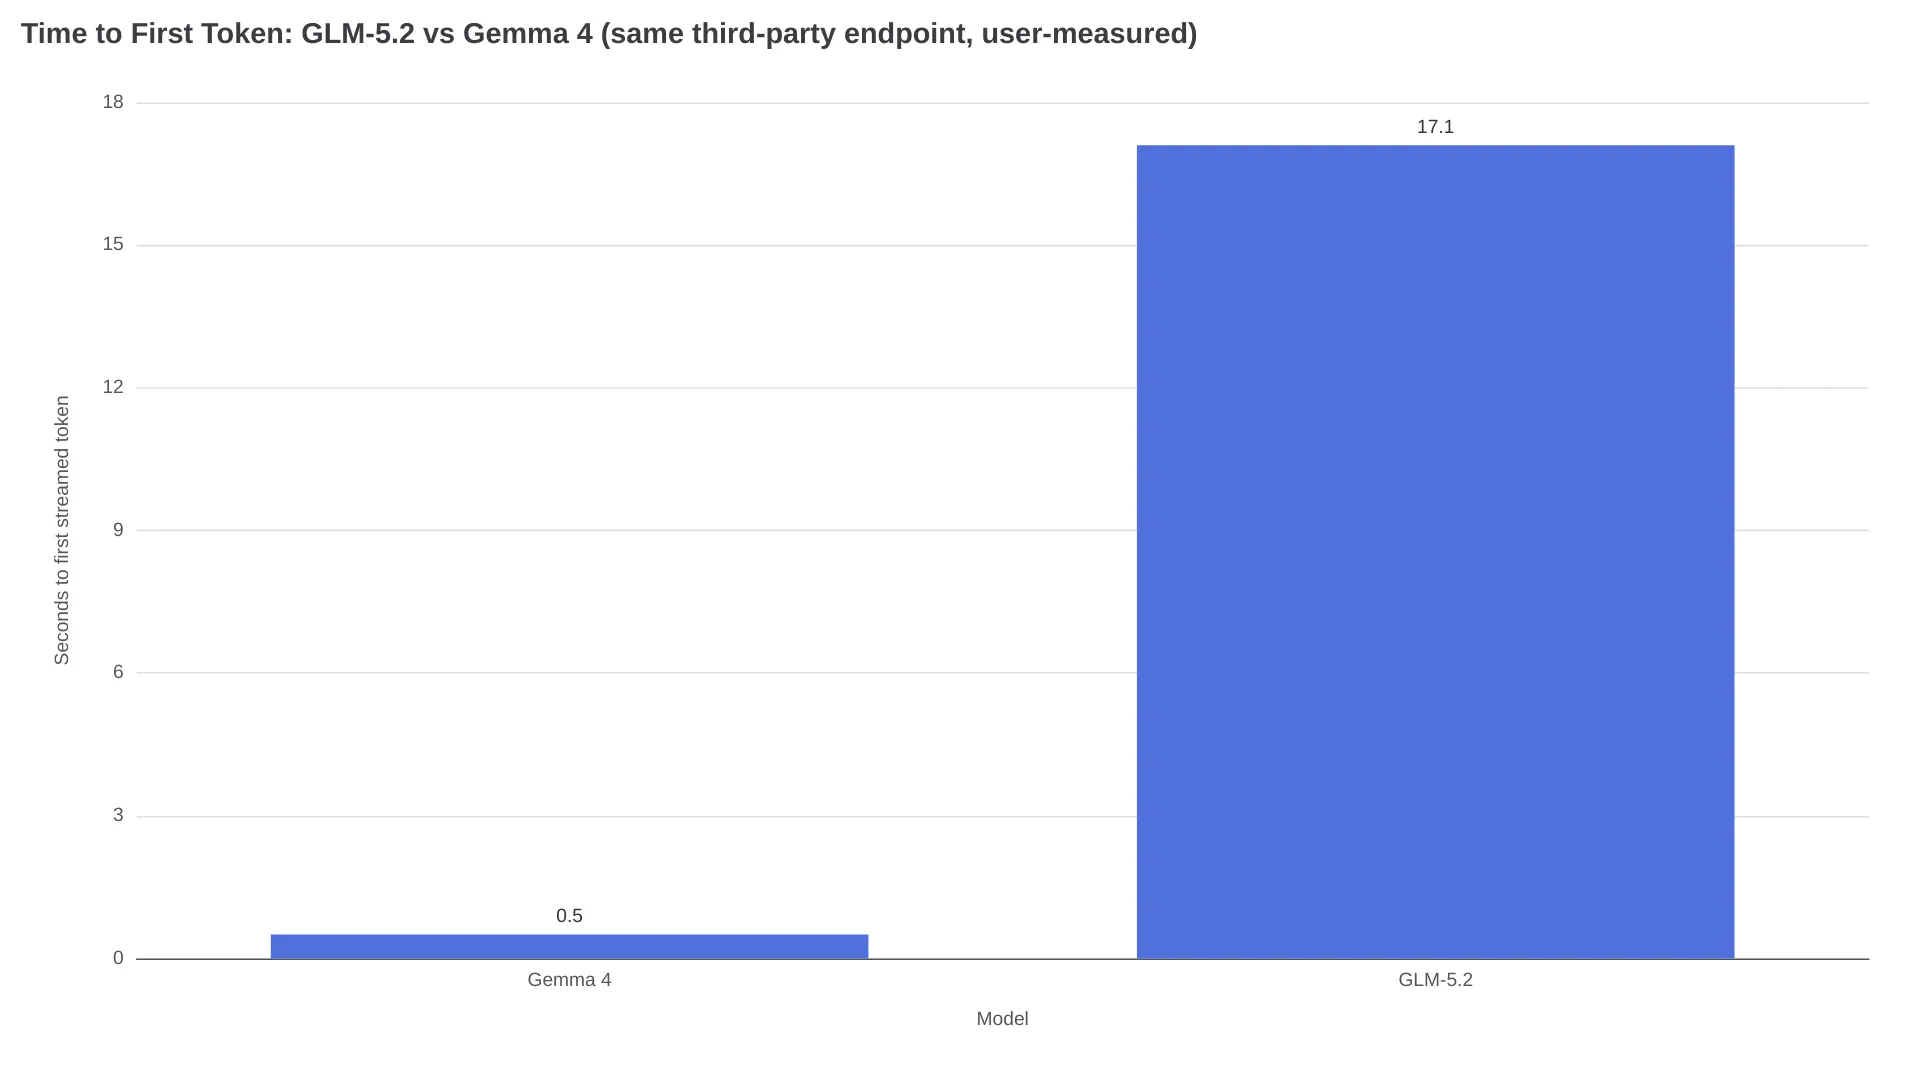
Самый слабый измеримый параметр API — задержка до первого токена. В сравнительном тесте endpoint'ов на Sarvam GLM-5.2 показала 148 токенов в секунду в стриме против 260 у Gemma 4, а time-to-first-token составил 17.1 секунды против 0.5. То есть Gemma начинает генерацию «в 33 раза раньше», как отмечает @noctus91.
С заявленной скоростью генерации ситуация похожая:
«Все эти провайдеры GLM 5.2 обещают 200+ токенов в секунду. Но пробуешь — получаешь 50 токенов в секунду» — @tomgreenwald, называющий это «benchmaxxing, только для провайдеров».
На маршрутах с подпиской пользователи также сообщают о двух типах сбоев: стрим может оборваться посреди сессии — «стриминг просто... остановился», после чего пользователь GLM Pro Coding Plan полностью отказался от сервиса; с ростом контекста приходит деградация — «после 300k+ контекста модель становится медленной» (@mosh_Ontong). Для сравнения: в выполненном бенчмарке из девяти задач DataLLM Lab на собственном gateway среднее время завершения задачи составило 12.3 секунды. Большую часть истории с задержками определяет endpoint, а не сама модель.
Лимиты и 429: повторные запросы становятся штатным режимом
В документации Z.ai нет таблицы rate limits, поэтому разработчики узнают реальные ограничения опытным путём — через 429. По отзывам сообщества о маршрутах Coding Plan, ретраи здесь скорее обычная эксплуатационная механика, чем редкий обработчик исключений. Эти обсуждения показывают типы сбоев, а не их распространённость, но сообщения достаточно однотипны.
Вот что пишут в треде r/ZaiGLM о лимитах:
- «Сейчас на coding max plan получаю 429/529 почти на каждом втором запросе. Без параллелизма...» — u/A-B-user
- «Да, почти каждый запрос повторяется, но результаты очень хорошие» — u/hyeluoh
- «Всё работает нормально, очень медленно, но без ошибок, если использовать для glm52 один параллельный запрос» — u/evia89
Ошибки зависят и от клиента: один и тот же API-ключ работает в ZCode, но выдаёт 429 в OpenClaw; другой пользователь трактует это как сообщение «слишком занято». Слой подписки добавляет новые сложности: китайские пользователи сообщают, что Coding Plan автоматически переключает нагрузки с 5.2 на GLM-5.3, которая быстрее съедает квоту, а сторонние реселлеры Coding Plan начинают ограничивать запросы уже после нескольких вызовов.
Инженерные меры, которые выдерживают практику: экспоненциальный backoff с jitter, idempotency keys для любых операций записи, бюджет ретраев на задачу, а не на отдельный запрос, и режим деградации с concurrency=1, включаемый автоматически. Паттерны повторных запросов из нашего гайда по исправлению OpenRouter 429 здесь применимы без изменений.
Нерешённый вопрос с тарификацией кэша
Кэширование контекста заявлено в документации. Когда мы проверяли страницы провайдеров 13 июля, кэшированный ввод стоил примерно $0.26 за миллион токенов против $1.40 за свежий ввод. Однако самое обсуждаемое недовольство API в изученных нами тредах связано с тем, что на некоторых маршрутах повторяющийся контекст всё равно учитывается как свежий ввод. Для каждого агентного цикла, повторно отправляющего длинный системный промпт, это многократно увеличивает цену.
«Кэшированные токены работают неправильно в GLM 5.2. Повторяющийся контекст учитывается как обычный ввод, а не как кэшированные токены» — @Da7_Tech, назвавший это «серьёзной проблемой биллинга и учёта кэша».
В этом обсуждении одна и та же задача была завершена Claude Opus 4.8 менее чем за 1.5M токенов, тогда как GLM-5.2 осталась незавершённой после 53M токенов: пятиячасовая квота достигла 100%, хотя внутренний счётчик приложения показывал около 1.67M.
Два месяца спустя тот же разработчик по-прежнему резюмировал ситуацию так: «многие пользователи жалуются, что попадания в кэш, похоже, учитываются в использовании. Если это происходит у вас, ценность плана рушится». До конца августа в этих тредах не появилось официального ответа.
Пока не подтверждено исправление проблемы, цену кэшированного ввода стоит считать лучшим сценарием, который необходимо сверять с собственными счетами. Логируйте cached_tokens из объекта usage в каждом ответе и проводите еженедельную сверку.
Reasoning effort: одна настройка под тремя именами
В официальном API используются thinking.type со значениями enabled/disabled и reasoning_effort со значениями high и max. В примерах самой документации указано reasoning_effort: "max". В рекомендациях к запуску Z.ai объясняла: max повышает возможности модели, high балансирует производительность и экономию токенов, а для кода рекомендован max.
Для интеграции отсюда следуют два важных факта. Во-первых, на coding-маршрутах по умолчанию включён max: «По умолчанию стоит max, так что менять не нужно, если не хотите снизить уровень» (r/ZaiGLM). Токены рассуждений тарифицируются по ставке выходных токенов, поэтому настройка по умолчанию незаметно увеличивает расходы. Пользователи Coding Plans, документировавшие правила учёта плана, сообщают, что запросы с max-effort расходуют в 3 раза больше квоты в будний пекинский интервал 14:00–18:00, поверх пятиячасового окна и недельных кредитов.
Во-вторых, эта настройка нередко вообще не доходит до backend. Пользователи OpenCode пишут, что «сейчас нельзя настроить reasoning effort» для кастомных провайдеров. В некоторых клиентах тот же параметр появляется под третьим названием — xhigh — и может вовсе не передаваться дальше (r/opencodeCLI). С этой же настройкой связана многословность: разработчик, ежедневно сравнивающий модели, заметил, что конкурент «не так многословен, как Opus-4.8 или GLM-5.2».
Одна строка модели — разные развёртывания
glm-5.2 — одна строка модели, которая может вести на заметно разные развёртывания. Когда в начале августа появились результаты по точности endpoint'ов, руководитель Z.ai попросил сообщество «протестировать официальный GLM-5.2 API как дополнительную точку отсчёта. Его результат может быть выше 100%» — @ZixuanLi_. Речь шла именно об официальном API, а не о сторонних endpoint'ах из отчёта.
На практике такой дрейф проявляется в ограничениях выходных токенов, способных оборвать рассуждение на середине стрима; в просадке скорости после периода запуска — том самом паттерне «benchmaxxing» выше; и в разном размере контекстного окна у хостов. Например, Together AI отдаёт GLM-5.2 с окном 256K, тогда как официальный API обещает 1M по документации, а агрегаторы из нашего июльского сравнения поддерживают полное окно.
Разброс цен ещё сильнее разброса поведения: при официальной цене Z.ai $1.40/$4.40 OpenRouter в нашем июльском сравнении провайдеров указывал $0.42/$1.32, а ставки на кэшированный ввод варьировались от $0.14 у Fireworks до $0.26. Сначала выбирайте endpoint под задачу, затем заново тестируйте именно его: успешная проверка поведения на одном маршруте не переносится на другой.
30-минутный pre-flight-тест перед продакшеном
Все перечисленные проблемы можно обнаружить за полчаса, до того как вы переведёте на сервис продовую нагрузку. Проверяйте ровно тот endpoint, строку модели и SDK, с которыми собираетесь выпускаться:
- Проверьте конфликтующие настройки инструментов. Отправьте
tool_choice: "required"вместе с инструкцией не использовать инструменты, а затемparallel_tool_calls: falseс запросом на два заказа. Ожидайте, что оба параметра будут проигнорированы; если ваша оркестрация зависит от любого из них, на этом стоит остановиться. - Нагрузочный тест ретраев. Отправьте 50 запросов при целевой параллельности и запишите долю 429/529, а также долю успешных повторов. Если ретраи превышают примерно треть запросов — это консервативный операционный порог, — снизьте параллельность до 1 и измерьте снова.
- Проверьте учёт кэша. Пять раз отправьте идентичный префикс на 10K токенов; сложите
cached_tokensиз ответов usage и сверяйте результат с объёмом входных токенов в биллинговой панели. Несовпадение делает вашу модель стоимости недействительной. - Проверьте задержку на реальном контексте. Измерьте время до первого токена и зависания в середине стрима на репрезентативных размерах контекста, а не в smoke-тесте на 1K токенов. Иначе замедление после >300K останется незаметным.
- Выберите правильный маршрут. Coding Plan рассчитан на интерактивные инструменты программирования. Согласно разборам учёта плана, лицензия не позволяет обслуживать через него сайты, ботов или SaaS-трафик. Для продуктовых backend'ов нужен тарифицируемый API.
Компромисс здесь не исчезает: GLM-5.2 предлагает одни из самых дешёвых на рынке токенов для способных coding-задач, но платой становится инженерная обвязка, которую frontier API обычно включают в цену токена.
FAQ по API GLM-5.2
Можно ли использовать OpenAI SDK с GLM-5.2?
Да, для chat completions: укажите base_url https://api.z.ai/api/paas/v4/ и модель glm-5.2. Responses API отсутствует, поэтому для нового интерфейса OpenAI и Codex потребуется слой трансляции.
Поддерживает ли API GLM-5.2 стриминг, вызовы функций и структурированный вывод?
Все три возможности заявлены в документации наряду с кэшированием контекста и MCP. Но есть поведенческие оговорки: стабильность стриминга зависит от endpoint'а, а управляющие поля инструментов из OpenAI — tool_choice помимо auto, parallel_tool_calls и strict — не соблюдаются.
Какую строку модели и base URL использовать?
Для официального тарифицируемого маршрута используйте glm-5.2 на https://api.z.ai/api/paas/v4/. У Coding Plan другой base URL, а в OpenRouter модель называется z-ai/glm-5.2.
Почему GLM-5.2 работает медленно или слишком многословно?
На coding-маршрутах по умолчанию используется максимальный reasoning effort, который тарифицируется как выходные токены. По отзывам сообщества, устойчивая скорость ближе к 50 токенам в секунду, хотя заявлено 200+. До ограничений самой модели задержка и многословность обычно определяются сочетанием конфигурации и endpoint'а.
Можно ли использовать GLM Coding Plan для API моего приложения?
Нет. Согласно разборам учёта плана, подписка предназначена для интерактивных инструментов программирования и исключает обслуживание сайтов, ботов и SaaS-продуктов. Множители квоты в пиковые часы Пекина также делают её неудобной для стабильного трафика.
Контекстное окно 1M доступно у всех провайдеров?
Нет. Официальный API и большинство агрегаторов поддерживают 1M, но Together AI ограничивает GLM-5.2 до 256K. Для workflows с репозиториями это ограничение способно изменить всю архитектуру.
Читайте также
- Обзор GLM-5.2: два месяца после хайпа — качество модели, бенчмарки и кому стоит её запускать
- GLM 5.2 API: самый дешёвый доступ, цены и бесплатные ключи — полная матрица цен у провайдеров
- GLM-5.2 vs GLM-5.3 — меняет ли августовский преемник расклад