 AIREITER
Nemotron 3.5 Lightning не пытается стать лучшей универсальной моделью своего класса — и в этом её смысл. В собственных бенчмарках NVIDIA она уступает Qwen 3.6 35B-A3B в 11 из 12 тестов, зато заявляет генерацию токенов до 4 раз быстрее. Это MoE-модель на 30B параметров, где для каждого токена задействуются лишь 3B: она рассчитана на повторяющиеся этапы агентных пайплайнов, в которых скорость и стоимость важнее предельного качества рассуждений. Нужно учитывать и требования к железу: BF16-веса требуют GPU с 80 GB памяти, а для продакшена NVIDIA рекомендует чекпойнт NVFP4.
Чем Nemotron 3.5 Lightning отличается от других моделей на 30B
В основе Nemotron 3.5 Lightning лежит гибридная архитектура: слои state-space Mamba-2 чередуются с маршрутизацией MoE и выборочными слоями attention. NVIDIA обозначает эту комбинацию тегом nemotron_h. Mamba-2 снижает затраты памяти и вычислений, характерные для attention на длинном контексте. Благодаря этому Lightning поддерживает контекст до 1M токенов; на одной H100 80GB практический предел составляет 256K, согласно карточке модели. У чисто attention-архитектуры такая длина контекста обошлась бы значительно дороже из-за квадратичного роста вычислений.
| Характеристика | Значение |
|---|---|
| Всего параметров | 30B |
| Активных параметров на токен | 3B |
| Архитектура | Гибрид Mamba-2 + MoE + Attention |
| Длина контекста | До 1M токенов (256K на одной H100) |
| Варианты точности | BF16, NVFP4 |
| Лицензия | OpenMDW v1.1 (разрешено коммерческое использование) |
| Языки | Английский, испанский, французский, немецкий, итальянский, японский + программирование |
| Корпус предобучения | 20T+ токенов |
| Режим рассуждений | Включается через enable_thinking в chat template |
| Рекомендуемые параметры семплирования | Temperature 1.0, top-p 0.95 |
NVIDIA называет Lightning самой компактной моделью семейства Nemotron 3. Её специально обучали поведению в агентной обвязке: вызовам инструментов, проверке результатов, форматированию ответа и делегированию подагентам. Сложное планирование остаётся за продвинутой reasoning-моделью наподобие Nemotron 3 Ultra, а Lightning берёт на себя рутинное исполнение, которое иначе расходовало бы токеновый бюджет дорогой модели.
Бенчмарки: в чём Lightning сильна, а в чём уступает
В карточке модели на HuggingFace опубликованы 14 строк бенчмарков, где Lightning сопоставляют с Qwen 3.6 35B-A3B, Gemma 4 26B-A4B, Nemotron 3 Nano/Super и GPT-OSS 20B. Ниже — 10 наиболее важных для выбора модели результатов.
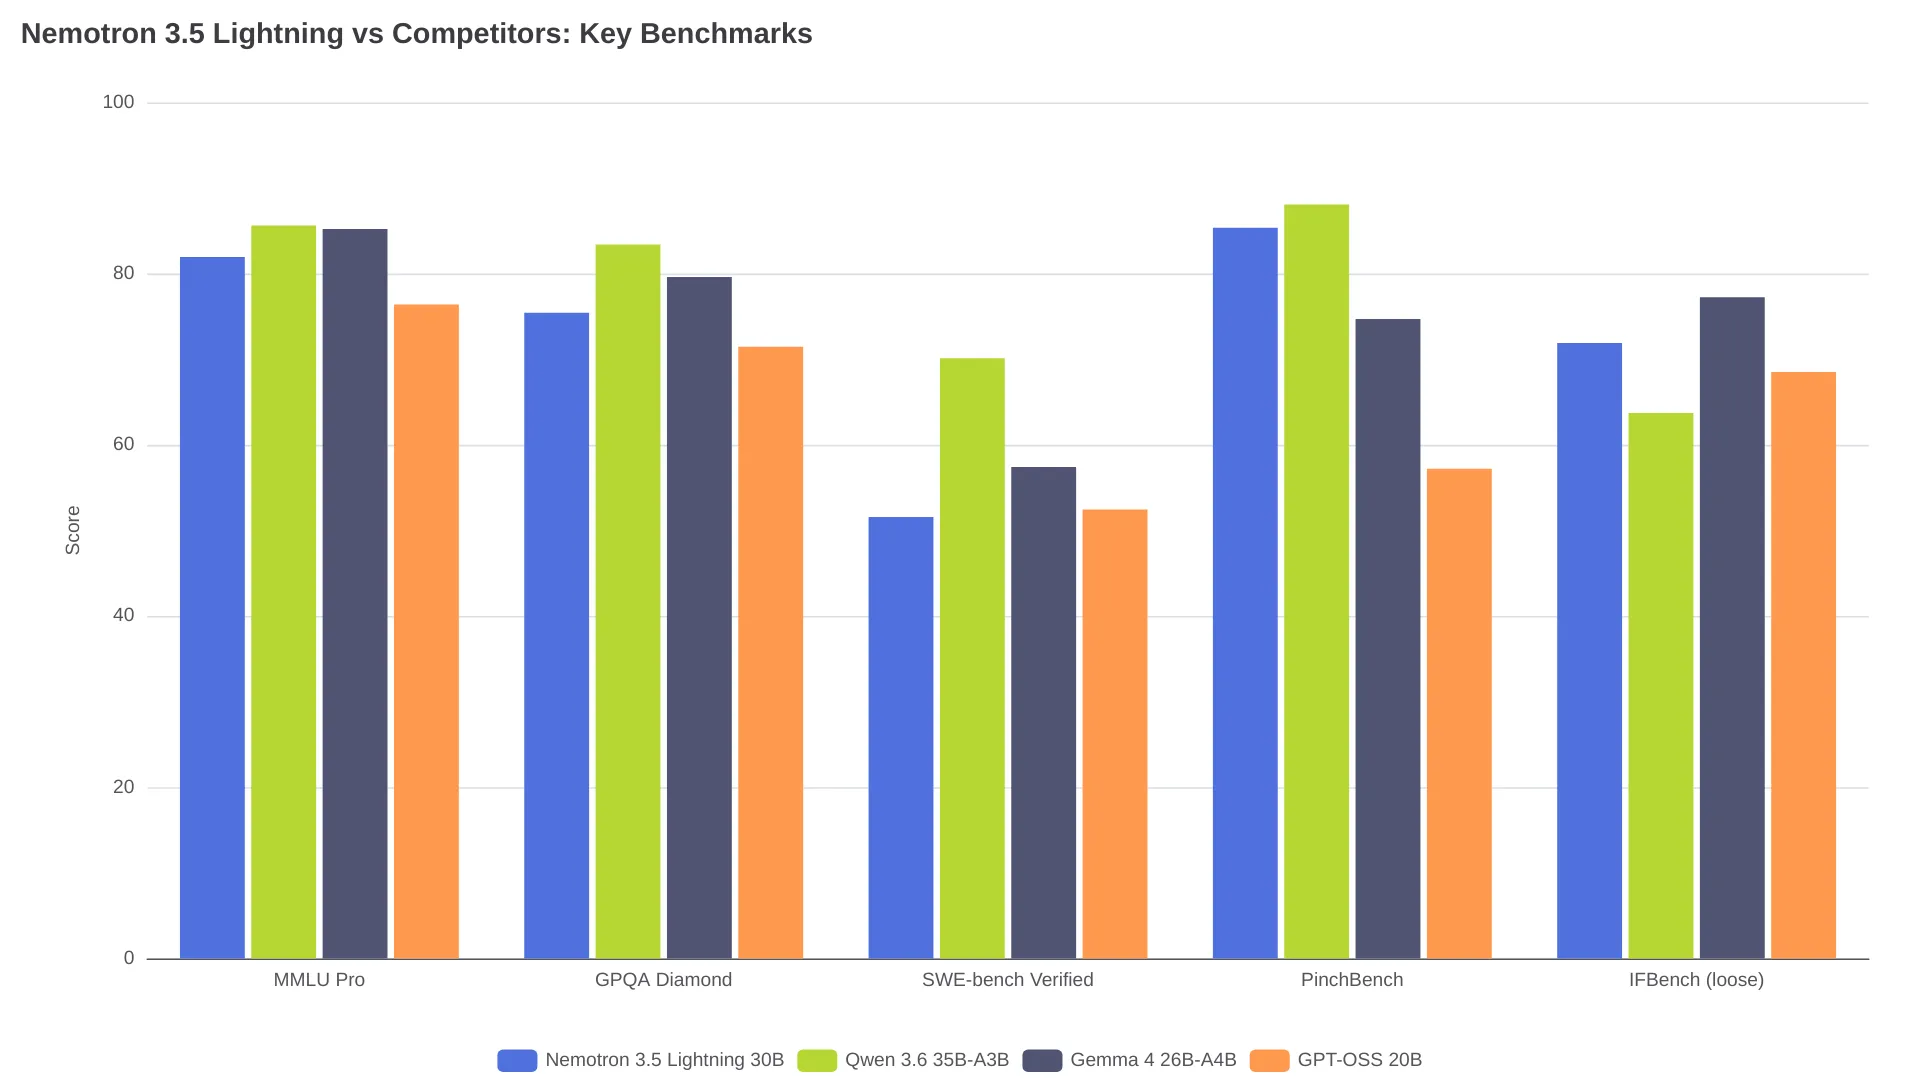
| Бенчмарк | Nemotron 3.5 Lightning | Qwen 3.6 35B-A3B | Gemma 4 26B-A4B | GPT-OSS 20B |
|---|---|---|---|---|
| MMLU Pro | 81.94 | 85.63 | 85.20 | 76.40 |
| GPQA Diamond (без инструментов) | 75.44 | 83.40 | 79.61 | 71.46 |
| SWE-bench Verified | 51.56 | 70.12 | 57.40 | 52.44 |
| SWE-bench Multilingual | 39.33 | 63.40 | 43.40 | 41.93 |
| Terminal-Bench 2.1 | 24.58 | 44.38 | 37.22 | 15.17 |
| PinchBench | 85.37 | 88.07 | 74.70 | 57.20 |
| BrowseComp | 36.97 | 48.74 | 26.30 | - |
| IFBench (loose) | 71.88 | 63.71 | 77.25 | 68.50 |
| AA-LCR | 52.00 | 61.06 | 57.56 | 32.88 |
| SciCode | 32.60 | 35.33 | 40.28 | 38.63 |
В 11 из 12 сопоставимых строк Lightning проигрывает Qwen 3.6 35B-A3B. Исключение — IFBench, оценивающий следование инструкциям в режиме loose: 71.88 против 63.71 у Qwen, преимущество в 8 пунктов. Это хорошо соответствует позиционированию модели для агентного исполнения: при форматировании tool calls и проверке результатов соблюдение инструкций может быть важнее, чем максимальная глубина рассуждений.
Главный аргумент Lightning — скорость. В тесте NVIDIA PinchBench, где 10 000 агентных задач измеряются в GPU-часах H100, модель выполняет нагрузку примерно за 16.5 GPU-часа с точностью 86%. Qwen 3.6 35B требуется 23.5–24 GPU-часа при точности 87%, а Gemma 4 26B — 25–26 GPU-часов при 73%:
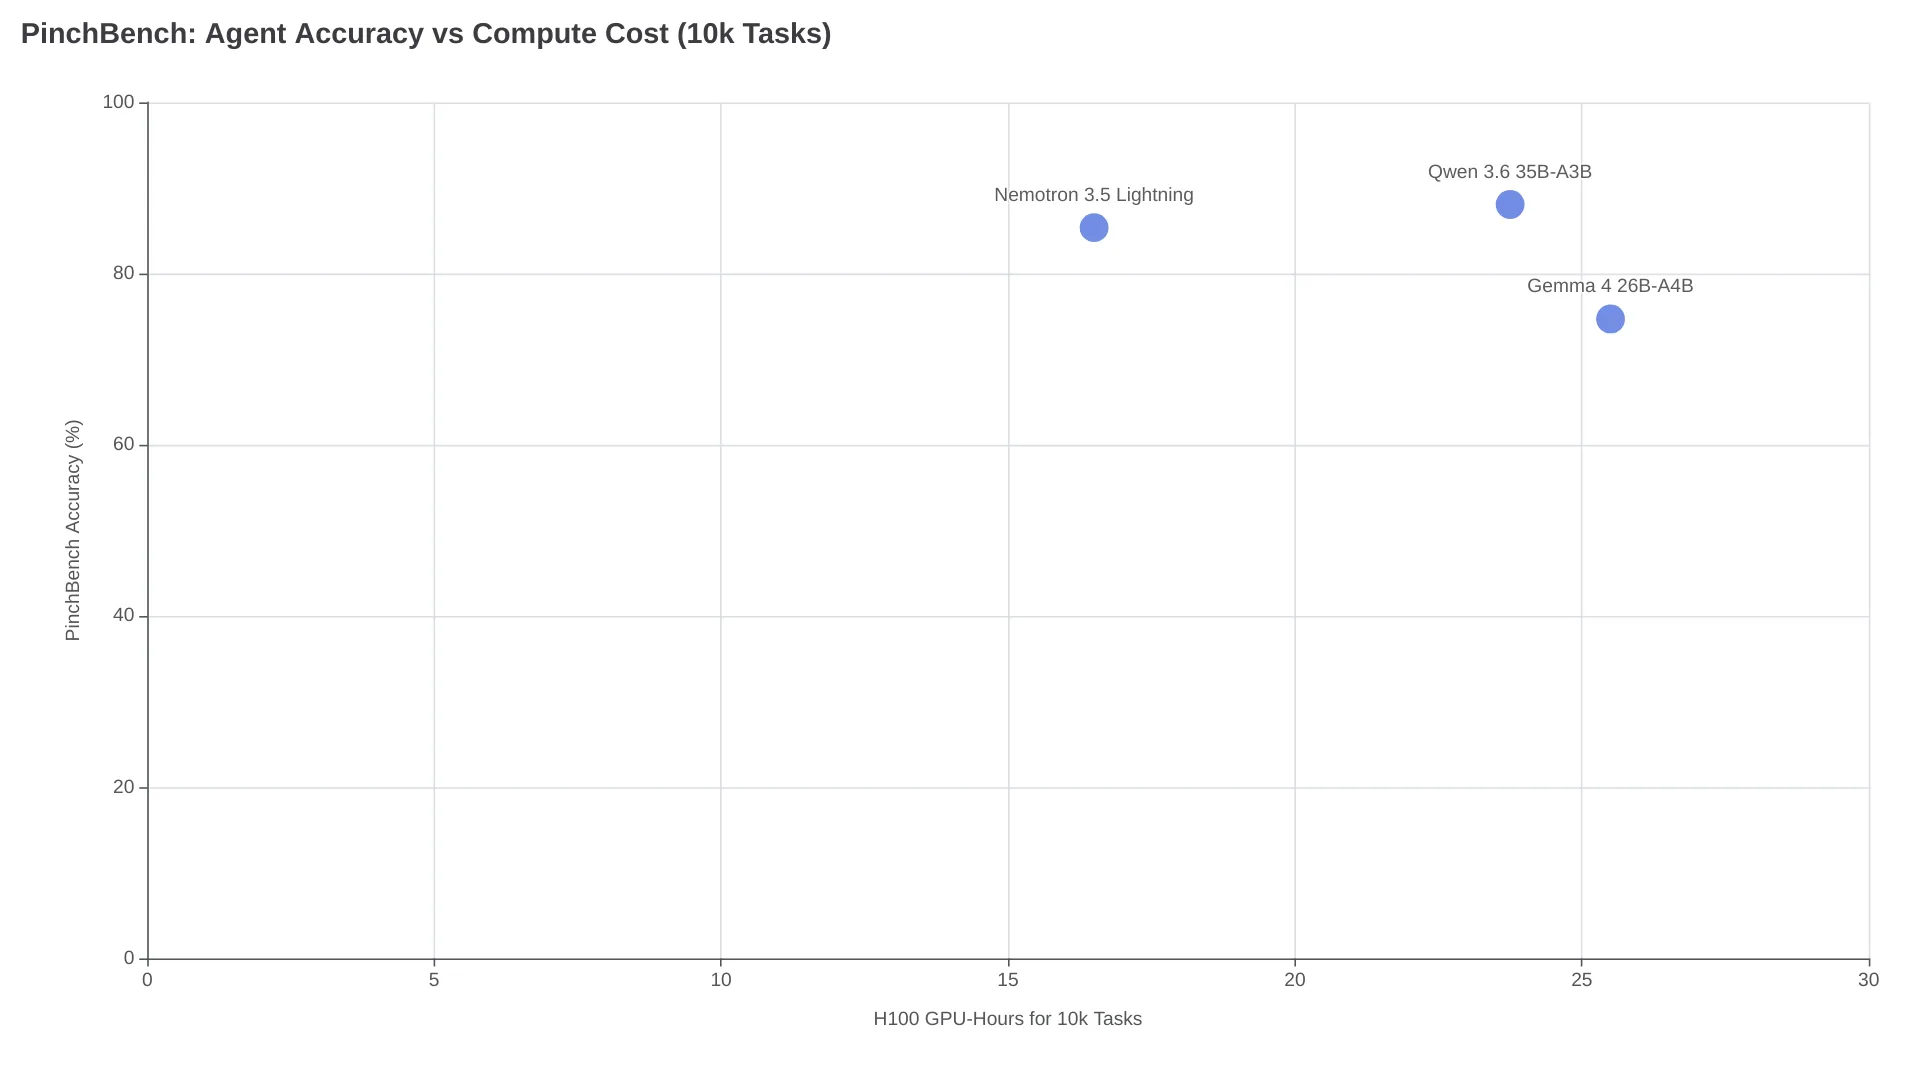
То есть при почти одинаковой точности требуется примерно на 30% меньше вычислений. Если вы оплачиваете GPU-часы и прогоняете 10 000 агентных шагов, разница становится существенной. NVIDIA также указывает скорость порядка 670 выходных токенов в секунду и около 23–24 пунктов Intelligence Index в рейтинге Artificial Analysis. Это выводит Lightning на границу Парето среди моделей с открытыми весами и суммарным числом параметров менее 40B.
Пользовательские тесты на r/LocalLLaMA показывают схожую картину. Владелец DGX Spark сообщил о 78.5 токена/с при target-only генерации и 90.7 токена/с со speculative decoding на чекпойнте NVFP4. Другой участник основной ветки обсуждения оценил качество Lightning как «между Gemma 4 26B и 31B, но заметно ближе к 26B». По его словам, модель работает примерно в 2 раза быстрее Gemma 31B, однако генерирует много thinking-токенов, что на практике частично съедает выигрыш. Ранние конверсии GGUF Q4 занимают около 25 GB и выдают предупреждения о неиспользуемых тензорах — вероятно, гибридная архитектура Mamba-2 пока поддерживается не всеми инструментами на базе GGUF.
Какое железо нужно и как запустить модель локально
Чекпойнт BF16 с эталонными полноточными весами требует для запуска на одной видеокарте 1x H100 80GB или 1x A100 80GB. Размер шардированного файла safetensors — 65.8 GB. Для продакшен-инференса NVIDIA прямо рекомендует отдельный релиз NVFP4.
| Чекпойнт | Примерный размер файла | Минимальная GPU | Оптимальный сценарий |
|---|---|---|---|
| BF16 | 65.8 GB | 1x H100/A100 80GB | Дообучение, исследования, создание квантованных вариантов |
| NVFP4 | ~16 GB | RTX 5090, DGX Spark, Jetson (Blackwell/Hopper/Ampere) | Продакшен-инференс, развёртывание агентов |
| GGUF Q4 | ~25 GB | 16 GB+ VRAM (собрано сообществом) | llama.cpp, Ollama, LM Studio |
Для поддержки с первого дня NVIDIA работала с четырьмя проектами локального сервинга: vLLM, SGLang, Ollama и llama.cpp. Также упоминаются LM Studio и Unsloth. Модель поддерживает три стратегии speculative decoding:
- DSpark — рекомендуемый вариант для DGX Spark и дата-центрового инференса с низкой конкуренцией запросов
- DFlash — альтернативная draft-модель; выбор зависит от нагрузки
- MTP (Multi-Token Prediction) — встроен в модель и лучше всего подходит для средней и высокой конкуренции запросов
Если локального железа нет, Lightning доступна через build.nvidia.com как микросервис NIM, а также на OpenRouter. Чекпойнт NVFP4 запускается на GeForce RTX 5090, DGX Spark, OEM-системах GB10 и NVIDIA Jetson.
Как Lightning встраивается в агентный пайплайн
Открытая библиотека маршрутизации NVIDIA NeMo Switchyard подбирает модель для каждого этапа агентного workflow с учётом точности, скорости и стоимости. Планирование направляется в reasoning-модель верхнего уровня, а выполнение — в Lightning. Во внутреннем бенчмарке NVIDIA Switchyard, по заявлению компании, сохранил «уровень выполнения задач, сопоставимый с frontier-моделями», при стоимости около одной трети от использования только Opus 4.8. Lightning берёт на себя такие действия, как git pull, проверка ответов инструментов, форматирование результатов и типовые API-вызовы.
Есть и практический пример. CodeRabbit опубликовала кейс на Reddit: компания дообучила Nemotron 3.5 Lightning для маршрутизации задач code review, используя целевой SFT и RLVR (reinforcement learning with verifiable rewards). На зафиксированной оценке из 1 000 задач модель превзошла их базовый вариант, а обучение обошлось менее чем в $100. Для такого процесса NVIDIA предлагает NeMo Automodel и NeMo Megatron Bridge для LoRA/SFT, NeMo RL и NeMo Gym для обучения с подкреплением, а также открытый датасет Nemotron-RL Agentic Terminal Pivot.
Для команд, создающих агентные пайплайны, вопрос сводится к следующему: можно ли дообучить Lightning так, чтобы она выполняла основную массу агентных шагов с затратами модели на 3B активных параметров, а frontier-модель подключалась лишь к немногим действительно сложным этапам?
Стоит ли выбирать Nemotron 3.5 Lightning
| Сценарий | Рекомендация | Причина |
|---|---|---|
| Маршрутизация большого потока агентных задач: tool calls, валидация, форматирование | Lightning NVFP4 | 3B активных параметров, скорость токенов в 4 раза выше, ~30% меньше вычислений при схожей точности |
| Универсальный помощник для программирования | Qwen 3.6 35B-A3B | 70.12 против 51.56 на SWE-bench Verified — разрыв 19 пунктов |
| Сложные рассуждения и планирование | Nemotron 3 Ultra или frontier-модель | Lightning прямо не позиционируется как модель для планирования |
| Локальный чат на одной потребительской GPU | Lightning NVFP4 на RTX 5090 | Работает, но конверсии GGUF пока сырые; vLLM/SGLang надёжнее |
| Дообучение под узкую агентную задачу | Lightning BF16 | 3B активных параметров = дешевле дообучать; OpenMDW v1.1 разрешает коммерческое использование |
| Массовое следование инструкциям | Lightning | IFBench: 71.88 против 63.71 у Qwen — преимущество 8 пунктов |
Lightning меняет пиковую точность на скорость при массовом исполнении. Экономия 30% вычислений накапливается за сотни агентных шагов в одной сессии, однако модель вышла 11 августа 2026 года, и экосистема вокруг неё ещё развивается. Гибридная архитектура Mamba-2 означает, что инструменты на базе GGUF могут пока поддерживать её не полностью. На оборудовании NVIDIA с vLLM или SGLang наиболее безопасный путь развёртывания сегодня — чекпойнт NVFP4. Для Apple Silicon или конфигураций, где доступен только GGUF, лучше дождаться стабилизации конверсий силами сообщества.
Частые вопросы
Можно ли запустить Nemotron 3.5 Lightning на потребительском железе?
Для потребительского оборудования NVIDIA поддерживает только чекпойнт NVFP4. Веса BF16 требуют GPU с 80GB памяти — H100 или A100. NVFP4 работает на GeForce RTX 5090, DGX Spark и NVIDIA Jetson. Для llama.cpp и Ollama существуют собранные сообществом варианты GGUF Q4, рассчитанные на системы с 16 GB+ VRAM, но в ранних сборках сообщали о проблемах с неиспользуемыми тензорами, связанными с гибридной архитектурой Mamba-2.
Как Nemotron 3.5 Lightning соотносится с Qwen 3.6 35B?
Qwen 3.6 35B-A3B превосходит Lightning в 11 из 12 опубликованных бенчмарков; самые большие разрывы заметны в SWE-bench Verified и Terminal-Bench. Lightning выигрывает в IFBench на следовании инструкциям и выполняет агентные задачи примерно на 30% быстрее при сопоставимой точности. Qwen сильнее как универсальная модель, а Lightning лучше подходит для быстрого агентного исполнения.
Подходит ли Nemotron 3.5 Lightning для программирования?
Если смотреть только на бенчмарки кода — нет: в SWE-bench Verified у Lightning 51.56 против 70.12 у Qwen 3.6. Но CodeRabbit успешно дообучила Lightning для маршрутизации code review менее чем за $100 и превзошла свой базовый вариант. Модель рассчитана на кастомизацию: после дообучения под соглашения конкретной кодовой базы она может выполнять рутинные задачи с затратами уровня 3B активных параметров.
Какая лицензия у Nemotron 3.5 Lightning?
Модель выпущена по лицензии OpenMDW v1.1 (Open Model Data Weight), которую NVIDIA описывает как максимально разрешительную. Она допускает коммерческое использование, включая веса, обучающие данные и рецепты. Полные условия лицензии приведены в карточке модели на HuggingFace.