 AIREITER
Anthropic теперь предлагает Claude Opus 5.5 как модель по умолчанию для интеллектуальной работы на платных тарифах. В целом это решение выглядит оправданным: модель сильна в исследованиях, анализе и подготовке материалов. Но в отзывах пользователей постоянно всплывает одна проблема — на Pro, Max и Team квота заканчивается заметно быстрее ожидаемого.
Opus 5.5 вышла 22 сентября 2026 года как первая модель семейства Claude 5.5. Anthropic заявила, что в большинстве задач она работает на уровне Claude Fable 5.1, но обходится на 40% дешевле Opus 5 (anthropic.com). 12 ноября 2026 года компания окончательно закрепила позиционирование в гайде для повседневной работы: начинать с Opus 5.5 на уровне Medium для исследований, анализа, текстов, отчётов, таблиц и презентаций, а повышать требования уже по необходимости (claude.com). Этот обзор объединяет официальные рекомендации, независимые бенчмарки и сообщения о расходовании квот; это не лабораторный тест от первой стороны.
Короткий вывод: оставьте Opus 5.5 основной моделью и работайте на Medium
Не переключайте Opus 5.5 без причины. Для обычных интеллектуальных задач достаточно Medium. Если ответ не тянет задачу, сначала увеличьте уровень усилий — и лишь затем меняйте модель. Sonnet 5.5 и Haiku 5.5 стоит подключать там, где важнее скорость или объём, чем качество суждений.
Дело не в привязанности к бренду, а в цифрах. В оценках Anthropic Opus 5.5 на Medium сравнялась с Opus 5 на High или превзошла её в программировании и интеллектуальной работе. Компания Factory, которую цитирует гайд Anthropic для ежедневной работы, сообщила: Medium достигает уровня Opus 5 на High, расходуя на 20–25% меньше выходных токенов. Кроме того, Medium уже выбран по умолчанию в приложениях Claude и Claude Code — большинству подписчиков даже не нужно менять настройки.
Однако лимит подписки важнее API-цены. Через API входящие токены стоят $4 за миллион, исходящие — $20 за миллион; у Opus 5 это было $5/$25. Чтение из кэша обходится в $0.20 за миллион токенов. Но, как отмечается в гайде Anthropic, более дорогие модели быстрее съедают лимиты подписки. Пользователи же сообщают, что при тяжёлой работе пятичасовое окно может исчерпаться за 15–30 минут, а недельные лимиты заканчиваются значительно раньше, чем в сентябрьский период «медового месяца».
Что изменила ноябрьская смена модели по умолчанию для Pro, Max и Team
Для подписчиков главное — как новая модель по умолчанию влияет на квоты. На старте Anthropic заявила об увеличении лимитов на пятичасовой период для Pro, Max, Team и корпоративных Enterprise-планов с оплатой за место, а также о возможности сохранить сброс rate limit для подписчиков (anthropic.com). Это произошло несмотря на описанные ниже жалобы пользователей конца октября на ускоренный расход лимита. В гайде Anthropic уточняется, что в обычные лимиты Pro, стандартных Team и корпоративных Enterprise-тарифов с оплатой за место Fable 5.2, как правило, не входит, если только не действует стартовая акция: Fable расходует usage credits. Поэтому Opus стоит считать включённой рабочей моделью, а Fable — платным исключением.
Где Opus 5.5 действительно хороша каждый день: исследования, анализ, тексты
Исследовательские записки, где можно проверить каждую цифру
Самый показательный тест — отчёт о результатах компании с обязательными источниками, где релиз с финансовыми данными намеренно было сложно найти, а любая выдуманная цифра или цитата означала провал всей работы. Opus 5.5 успешно выполнила 16 из 18 отчётов на разных уровнях усилий; по словам Anthropic, ни Fable 5.1, ни Opus 5 не прошли эту планку ни в одной попытке (claude.com). Дополняет картину внешняя проверка Walleye Capital, о которой также говорится в анонсе Anthropic: Opus 5.5 в основном решила их набор задач уже на минимальном уровне усилий, а на более высоком обнаружила ошибку индексации на единицу в инструкциях самого оценщика. По словам Walleye, ни одна из ранее протестированных моделей этого не заметила.
На практике это означает следующее: открытое исследование можно поручать модели, если чётко задать итоговый результат и приложить источники. А проверять после этого нужно прежде всего цифры, а не гладкость формулировок.
Аналитика: таблицы, расчёты по сделкам и плотные графики
В вымышленной сделке по объединению двух компаний из сферы HR-софта и Opus 5, и Opus 5.5 собрали Excel-модель с презентацией для руководства и пришли к одному выводу по сделке. Opus 5.5 справилась за 63 минуты против 93 минут, стоила, по приведённым данным, на 50% дешевле, подготовила более полную модель и допустила меньше мелких ошибок (claude.com). В более широких финансовых сценариях Hebbia сообщила о покрытии 86.6% критериев у Opus 5.5 против 60.3% у Opus 5, а Rogo — о превосходстве над Opus 5 на High в BigFinance Bench при примерно на 60% меньшем объёме выходных токенов, согласно стартовой публикации Anthropic.
С визуальными данными ситуация похожая. Anthropic называет Opus 5.5 своей лучшей моделью Opus для работы со зрением: плотными документами, значениями на графиках, скриншотами и диаграммами. Компания утверждает, что Opus 5.5 на минимальном уровне усилий точнее читала насыщенные графики, чем Opus 5 на максимальном (claude.com). Опубликованный результат Chartography — 64.4% без инструментов на максимальной оценённой настройке (claude.com) и 89.0% с инструментами в стартовой таблице результатов. В рейтинге профессиональной работы GDPval-AA Elo модель получила 1846 баллов против 1735 у Fable 5.1 и 1708 у Opus 5 (anthropic.com).
Практический совет: сразу просите готовую таблицу или презентацию, прикладывайте изображение графика вместо ручной расшифровки значений и уже в первом сообщении обозначайте критерий завершения задачи.
Тексты: готовые документы и презентации вместо планов
Заявление о качестве текстов здесь не сводится к абстрактному «лучше пишет». Речь о следовании инструкциям и проверяемости результата. По данным Anthropic, Opus 5.5 не уходит в сторону, начинает с выводов, меньше злоупотребляет жаргоном, соблюдает заданный стиль и объясняет, что именно сделала, к чему пришла и какие данные ей ещё нужны. Независимые оценки в целом подтверждают направление: Hayz Labs поставила Opus 5.5 100 баллов за тексты и 100 за код, а исследования оценила в 94. На момент октябрьской проверки модель занимала первое место в WebDev и агентах, а также второе — в творческом письме на Arena.
Честное ограничение остаётся прежним: для точного попадания в корпоративный стиль всё ещё нужны несколько итераций.
Уровень усилий — главный фактор цены
У Opus 5.5 пять уровней усилий: Low, Medium, High, Very High/Extra High и Max, согласно разбору уровней усилий eesel. Отключить размышление нельзя, пишет Hayz Labs. И на итоговый счёт этот переключатель влияет куда сильнее, чем небольшая разница в цене токена.
По данным, которые eesel приводит из расчётов Artificial Analysis, одна и та же сложная задача обходится примерно в $0.55 на Low, $1.34 на Medium и $5.98 на Max. При этом показатели Intelligence Index составляют около 42, 51 и 58 соответственно. Один запуск на Max способен выдать порядка 119,000 выходных токенов; при цене $20 за миллион выходных токенов именно здесь формируется основная часть затрат. В Pareto-анализе Hayz Labs получаются близкие значения: медиана около $1.61 на агентную задачу за 14 дней ($1.76 — медиана в основной таблице), а High — примерно $1.82.
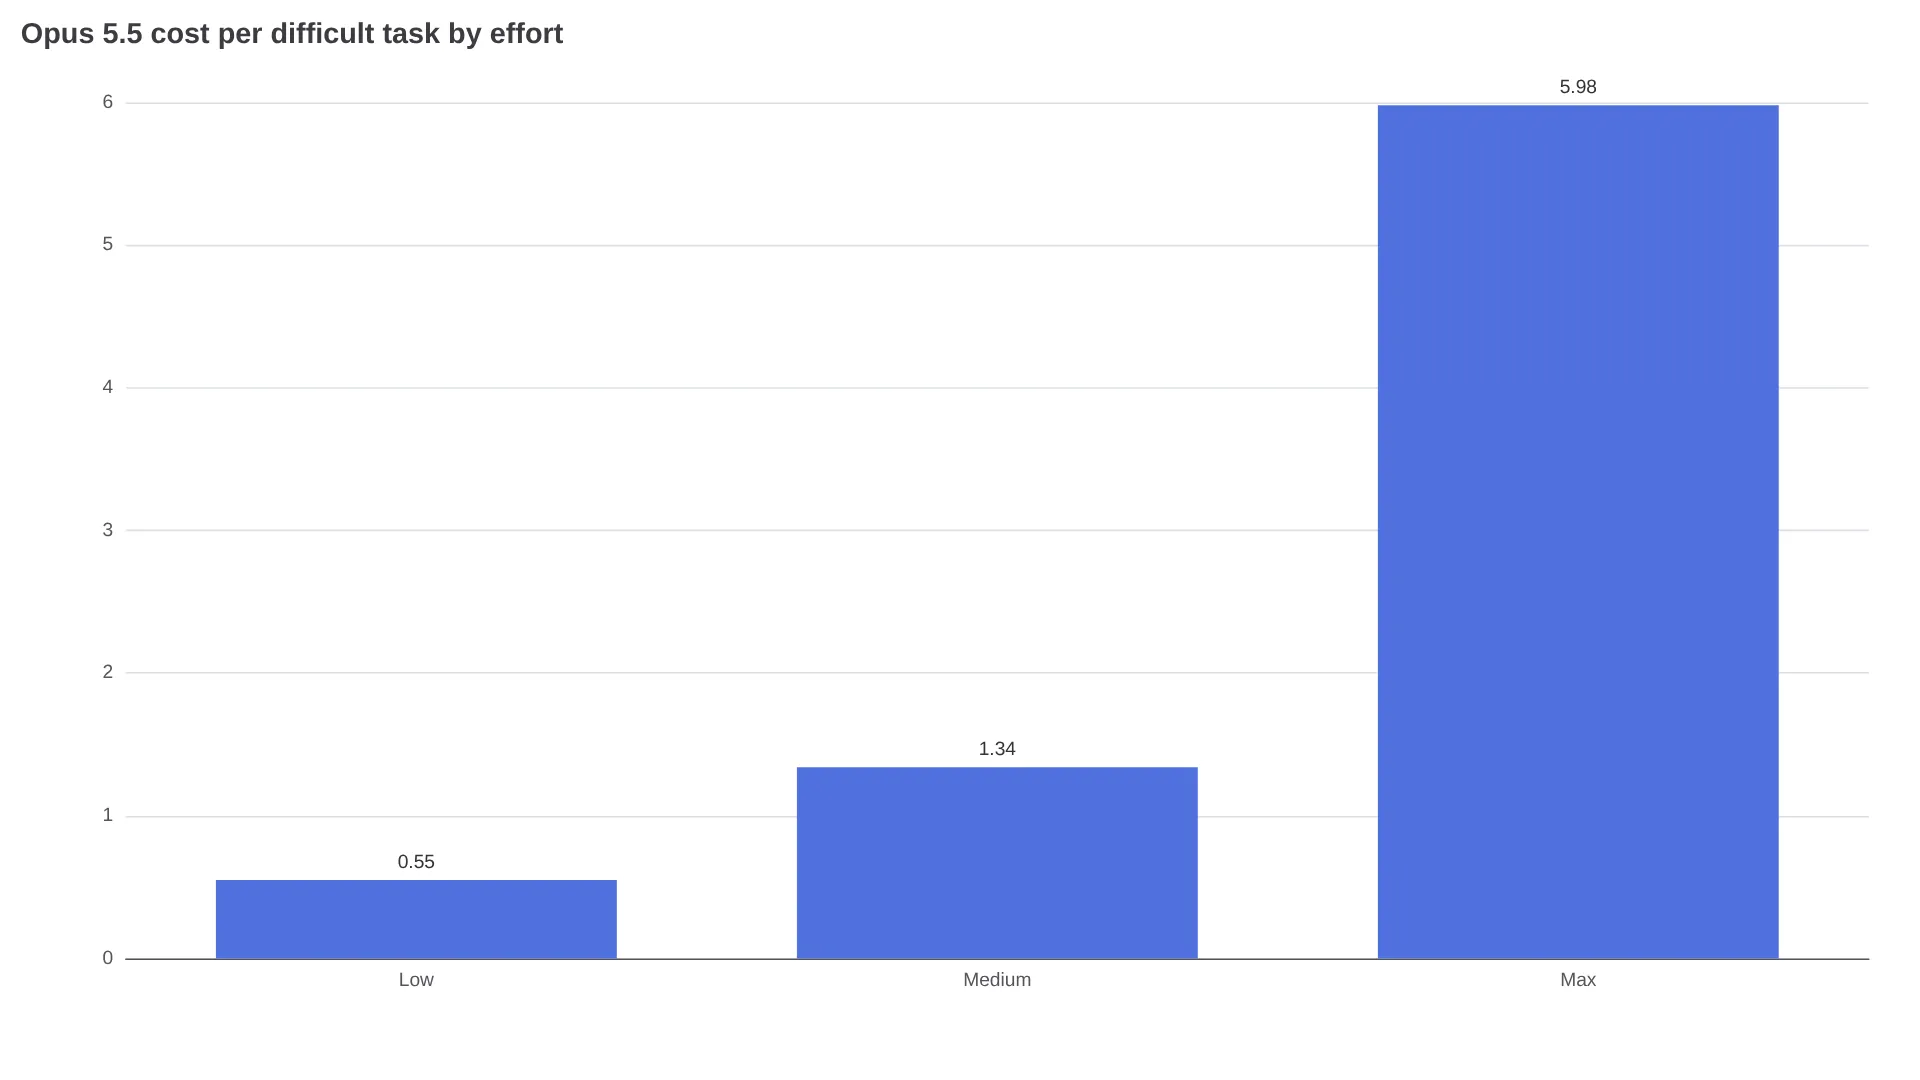
Более высокий уровень усилий требует больше времени и денег, но не всегда улучшает результат. Anthropic советует убрать из запросов формулировки вроде «хорошенько подумай»: рассуждение уже включено, а глубину определяют уровень усилий и сама задача. Повышать настройку стоит только тогда, когда Medium действительно упирается в предел.
Контекстное окно составляет 1 миллион токенов, максимальный вывод — до 128,000 токенов, либо 300,000 в Batch; также поддерживается нативное зрение, согласно спецификации eesel. Доплаты за длинный контекст нет, отмечает обзор цен eesel, и это важно для сценариев проверки объёмных документов.
Как выбирать между Opus 5.5, Sonnet 5.5, Haiku 5.5 и Fable 5.2
Ноябрьский гайд Anthropic и независимый анализ стоимости сходятся в одном: сначала меняйте уровень усилий, а уже потом модель. Цены ниже приведены по таблице цен в гайде Anthropic.
| Модель | API-цена за 1 млн токенов (вход/выход) | Для чего использовать | Когда переключаться |
|---|---|---|---|
| Haiku 5.5 | $0.10 / $0.50 до 100K токенов | Быстрые справки, резюме, сортировка, узкие задачи в большом объёме | Когда анализ становится длинным или требует серьёзных суждений |
| Sonnet 5.5 | $2 / $10 | Понятные задачи с чёткими рамками, доработка документов, слайды по готовому брифу | Когда вы регулярно доходите до Extra High или Max |
| Opus 5.5 | $4 / $20 | Большинство исследований, аналитика, финансовые задачи, готовые документы | Когда Medium не справляется даже после полноценной повторной попытки на High |
| Fable 5.2 | $8 / $40 | Открытые технические задачи, наука, программирование и финансы с долгой работой команд субагентов | Для обычной интеллектуальной работы — чаще всего избыточна |
Важно запомнить точку пересечения: Sonnet 5.5 на Extra High или Max может стоить за задачу почти столько же, сколько Opus 5.5, но при этом уступать ей по качеству суждений. Пользователи тарифов для программирования описывают ту же механику со стороны подписки: не держать Sonnet выше Medium, а перенести задачу на Opus 5.5 с Low (см., например, @cupid25157). Это согласуется и с официальной лестницей «сначала усилия, потом модель», и с расчётами стоимости на задачу.
Fable — это верхняя граница, а не прямой конкурент. В ноябрьской ветке Anthropic о Fable 5.2 Fable и Mythos названы моделями для самых амбициозных открытых технических задач, тогда как Opus 5.5 — сильнейшим повседневным вариантом для большинства задач по коду и интеллектуальной работе (@claudeai). Для подписчиков различие ещё важнее: на стандартных местах Pro/Team Fable нередко списывается из credits, поэтому спонтанный выбор «модели получше» может превратиться в счёт за credits.
Как не сжечь квоту за пятичасовое окно
Именно об этом официальные бенчмарки почти не говорят, а пользователи говорят постоянно. Главная претензия — не к возможностям модели, а к расходу квоты.
«Лимиты Opus 5.5 сегодня просто УНИЧТОЖАЮТСЯ!! Несколько человек сообщают, что пятичасовая квота заканчивается ВСЕГО за 15–30 минут обычной работы. Недельные лимиты расходуются НАМНОГО быстрее» — @TekonBurns, о расходе квоты в сессиях Claude Code
Некоторые пользователи описывают это как внезапный конец «медового месяца». Например, @kgauravnm пишет, что «фаза медового месяца Claude Opus 5.5 официально закончилась», упоминая ленивое поведение и быстрый расход недельного лимита. Владельцы мест Team, включая @ps_ios_dev, сообщают, что использование на Medium «летит» даже после бесплатного недельного сброса. Но важно учитывать и другое наблюдение: анализ 67,000 сообщений Claude Code от @sonuv_dev показал, что число вызовов инструментов, доля неудач и доля жалоб остаются примерно на прежнем уровне — «по сути, ноль доказательств ухудшения». Это говорит о том, что часть проблемы может быть вызвана более интенсивным использованием по умолчанию и дорогим рассуждением, а не скрытым урезанием модели. Выбор модели на верхнем уровне тоже имеет значение: @mohitsharmadl приводит случай, когда Fable 5.2 на Medium исправила баги, с которыми Opus 5.5 на High не справилась. То есть стратегия «Opus для всего» может зря расходовать квоту, если выбран не тот потолок возможностей.
Рабочая схема обращения с квотой, учитывающая и рекомендации Anthropic, и опыт пользователей:
- По умолчанию используйте Opus 5.5 на Medium; High должен быть осознанным повышением для конкретной проблемы, а не постоянной настройкой.
- Делите работу на подзадачи: Haiku — для поиска и сортировки, Sonnet — для черновиков и полировки в чётких рамках, Opus — для суждений, аудита и финального утверждения.
- Не держите Sonnet выше Medium по привычке: посчитайте точку пересечения и лучше переведите задачу на Opus Low/Medium.
- Прикладывайте файлы и подключайте репозитории вместо того, чтобы каждый раз вставлять один и тот же контекст вручную; повторная отправка длинного контекста добавляет токены на каждом ходе и увеличивает учитываемое потребление.
- Сохраните сброс rate limit для недели с реальным дедлайном, а не тратьте его на эксперименты.
- Оставьте Fable для узкого класса задач, где она выигрывает: долгих, многоагентных и открытых технических проектов. Сначала проверьте, списывает ли ваш тариф credits.
FAQ: вопросы о ежедневной работе с моделью
Claude Opus 5.5 достаточно хороша как основная модель на каждый день?
Да — для исследований, анализа и работы с текстами, где важны качество суждений и возможность проверить результат. Hayz Labs ставит её на первое место для агентов и WebDev с максимальными оценками за тексты, а корпоративные проверки, процитированные Anthropic, указывают в ту же сторону. Но рядом стоит держать более дешёвую модель для массовых задач.
Opus 5.5 лучше Sonnet 5.5 для повседневной работы?
Для неоднозначных задач или работы с высокой ценой ошибки — да. Для понятных, чётко ограниченных и массовых задач Sonnet на Low или Medium быстрее: Anthropic относит Sonnet к категории Fast, а Opus — к Moderate (claude.com), при этом цена токенов примерно вдвое ниже. Ошибка — по умолчанию запускать Sonnet на Extra High или Max: так экономия исчезает.
Когда стоит выбрать Fable 5.2 вместо Opus 5.5?
Opus подходит для большинства интеллектуальных задач и обычной работы с кодом. Переходите на Fable для открытых, долгих или сильно агентных технических проектов, когда Opus на High всё ещё не справляется. И сначала проверьте биллинг тарифа: на стандартных местах Pro/Team Fable часто оплачивается из credits.
Надёжно ли работает контекст в 1 миллион токенов с длинными документами?
Для аудиторских задач с приложенными файлами это самая сильная конфигурация Opus, которую выпускала Anthropic, включая результат 16 из 18 в тесте отчётов с источниками. Но очень длинные задания всё равно быстро расходуют квоту подписки. Поэтому поиск и извлечение лучше оставить Haiku, а суждения — Opus, вместо того чтобы выполнять всё на максимальном контексте.
Главный компромисс, за которым стоит следить
Opus 5.5 — правильная модель по умолчанию для интеллектуальной работы на уровне Medium. Открытым остаётся вопрос, станет ли зафиксированная пользователями теснота с квотами в конце октября новой нормой. Если да, большую часть недели всё равно придётся проводить на Sonnet — заметно больше, чем обещало стартовое позиционирование.
Читайте также: обзор цен Claude Opus 5.5, обзор Claude Opus 5.5 High, Claude Opus 5.5 против GPT-6.1 Sol.