 AIREITER
Если кодинговые агенты работают у вас целый день, выбор между Gemini 4 Hydrogen и Claude Sonnet 5.5 сводится к простому компромиссу. Hydrogen примерно на 25% дешевле при соотношении 50/50 для входных и выходных токенов — $4.50 против $6.00 за миллион. Зато Sonnet 5.5 чаще доводит до конца терминальные задачи и сценарии с управлением компьютером без постоянных подсказок. Поэтому ни цена токенов, ни таблица бенчмарков сами по себе не показывают, сколько будет стоить завершённая задача.
И Gemini 4 Hydrogen, и Claude Sonnet 5.5 предлагают контекст на 1M токенов для быстрого написания кода и агентских циклов. У Hydrogen при этом есть четыре регулируемых уровня глубины рассуждений.
Что изменится, если завтра заменить Sonnet 5.5 на Hydrogen?
Команда, которая запускает по 200 агентских задач в день, заметит замену сразу по двум направлениям: в счёте и в количестве ручных вмешательств. Hydrogen дешевле по токенам, а в независимом замере скорости LLM Leaderboard генерирует около 198 токенов в секунду против примерно 144 у Sonnet 5.5. Это типичный «массовый исполнитель»: быстрые черновики, параллельное чтение файлов и оперативные исправления.
Sonnet 5.5 — скорее «аккуратный доводчик». В таблице Google на момент запуска он обходит Hydrogen в трёх бенчмарках, связанных с терминалом и управлением компьютером: Terminal-Bench 4.1, OSWorld 2.1 и Terminal-Bench-Science. Подробности — ниже. Именно на таких задачах видно, способен ли агент восстановиться после неудачной команды или просто остановится.
Обсуждение на Reddit в первую неделю после запуска показывает ту же картину на уровне отдельных задач:
«hydrogen is alright but honestly i don't feel it's better than sonnet 5.5.» — u/FewKey5274 на r/GeminiAI
В этой ветке нет контролируемого бенчмарка для программирования, поэтому воспринимать её стоит лишь как повод для осторожности: победа на отдельной задаче не гарантирует лучшего результата в полном агентском сценарии. Перед миграцией прогоните обе модели на одном и том же рабочем процессе.
Счёт: $4.50 против $6.00 — и это только начало
Официальные тарифы API выглядят просто. Hydrogen стоит $1.50 за миллион входных токенов и $7.50 за миллион выходных — цена не меняется на всём протяжении контекстного окна, согласно анонсу Google. Для Sonnet 5.5 это $2.00 за миллион входных и $10.00 за миллион выходных токенов, по данным тарифов Anthropic и сравнения OpenRouter.
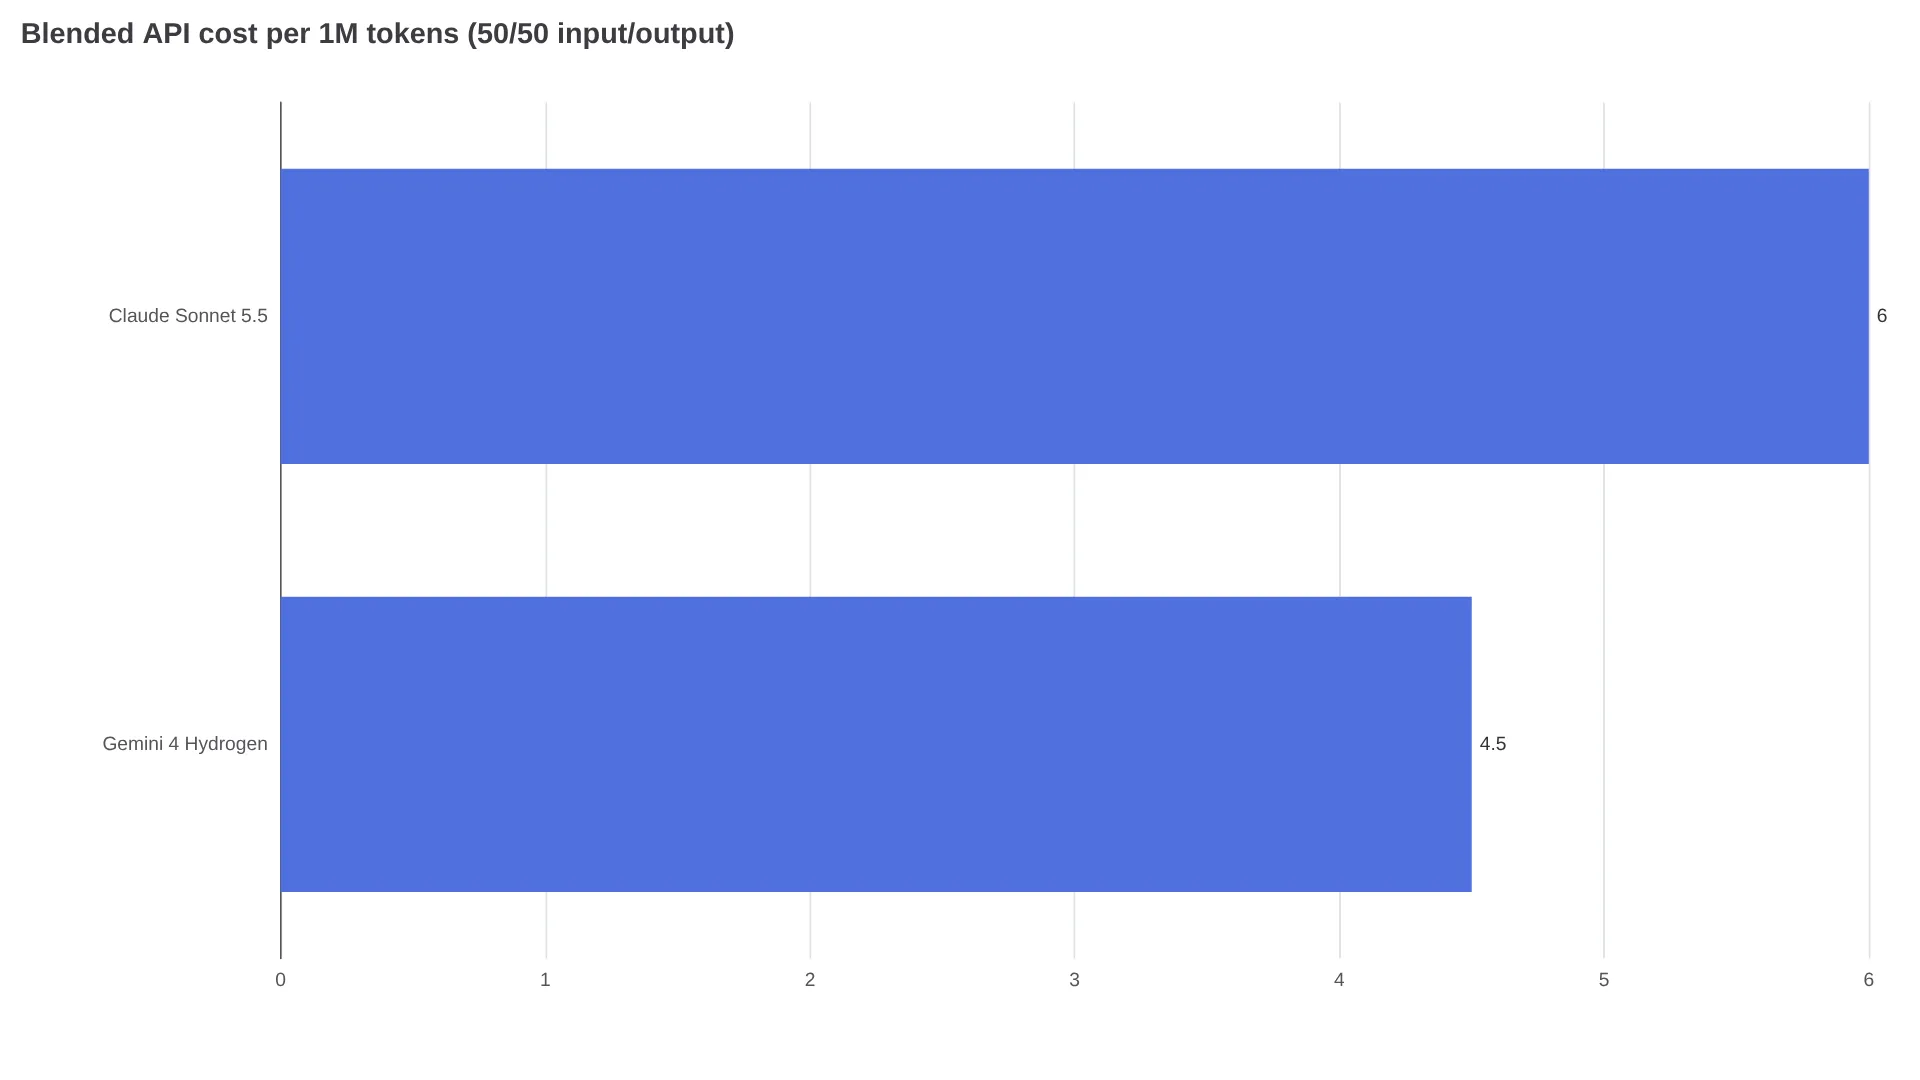
При соотношении 50/50 — 500K входных и 500K выходных токенов — получаем $4.50 за миллион у Hydrogen и $6.00 у Sonnet 5.5. Разница в 25% действительно есть, но итоговый выбор определяют ещё три обстоятельства:
- Чем больше выходных токенов, тем заметнее разрыв. В агентских циклах с длинными цепочками рассуждений расход выходных токенов обычно выше. Здесь особенно важна скидка Hydrogen в $2.50 за миллион выходных токенов.
- Кэширование и пакетные тарифы не учтены. Чтение prompt-cache у Anthropic и скидки Batch API могут изменить реальный счёт на несколько процентов. Кроме того, LLM Leaderboard отмечает, что в его замере скорости Hydrogen явное кэширование не поддерживалось.
- Пример помогает перевести тарифы в реальные суммы. Если один ход агента в среднем использует 10K входных и 3K выходных токенов, а таких ходов набирается 1 000 в день, расход составит 10M входных и 3M выходных токенов. При стандартных тарифах это примерно $37.50 в день для Hydrogen против $50.00 для Sonnet 5.5. За 22 рабочих дня разница составит около $275 в месяц на одного одновременно работающего агента — без учёта повторных запусков.
На практике всё решает число повторных попыток. Стоимость завершённой задачи — это цена одной попытки, делённая на долю успешных запусков, плюс время человека на исправления. Просто для иллюстрации: день работы Hydrogen за $37.50 при успешном результате с первой попытки в 80% случаев обходится примерно в $46.90 на 1 000 завершённых задач только по токенам. Для Sonnet день за $50.00 при показателе 95% — примерно в $52.60. Разница быстро сокращается, если меняется доля успешных запусков, поэтому лучше две недели отслеживать процент мерджей с первой попытки, а не полагаться на таблицы поставщиков.
Бенчмарки расходятся в зависимости от типа работы
Таблица Google на момент запуска, опубликованная также в карточке модели DeepMind, сравнивает Hydrogen, Sonnet 5.5 и GPT-6.1 Terra в десяти тестах. Hydrogen опережает Sonnet 5.5 в семи из десяти, а Sonnet 5.5 выигрывает остальные три. В строках с данными поставщиков используются их собственные тестовые стенды, независимые результаты получены в повторных прогонах LLM Leaderboard.
| Тип работы | Бенчмарк | Gemini 4 Hydrogen | Claude Sonnet 5.5 |
|---|---|---|---|
| Работа с репозиторием | SWE-sweep (данные поставщика) | 13.5% | 3.1% |
| Работа с репозиторием | Terminal-Bench 4.1, с поправкой на читинг (данные поставщика) | 57.0% | 63.9% |
| Автоматизация работы со знаниями | Agents' Last Exam v1.1 (данные поставщика, зависит от тестового стенда) | 71.6% | 60.4% |
| Автоматизация работы со знаниями | AutomationBench-AA (данные поставщика) | 76.1% | 71.8% |
| Автоматизация работы со знаниями | Vending-Bench 2, финальный баланс (данные поставщика) | $14,549 | $11,165 |
| Управление компьютером | Оффлайн-подмножество OSWorld 2.1 (данные поставщика) | 77.6% | 83.9% |
| Мультимодальные задачи | MKA Climb WSR (данные поставщика; независимый результат 49.52%) | 53.4% | 52.0% |
| Мультимодальные задачи | Chartography (смешанное происхождение данных) | 66.6% | 61.6% |
| Наука | Terminal-Bench-Science 0.1 (данные поставщика; независимый результат 49.52%) | 51.4% | 59.9% |
| Рассуждения | HLE-Diamond (независимый xhigh) | 58.8% | 53.3% |
Агент выигрывает или проигрывает на вызовах инструментов
Бенчмарки оценивают ответы, но настоящая работа агента происходит во время вызовов инструментов: нужно пакетно читать файлы, выбирать правильную функцию и уметь восстановиться, если поиск ничего не вернул или команда завершилась ошибкой.
По словам Google, Hydrogen параллельно обрабатывает чтение файлов и поиск, а не изучает файлы один за другим, и вносит точечные изменения в репозиторий вместо переписывания несвязанных участков. Партнёрские отчёты в публикации о запуске говорят об ускорении работы с графами и SQL в 2–2.8 раза и снижении расхода токенов на 12–23% по сравнению с Gemini 3.8 Flash, а также о завершении задач в 2.5 раза быстрее при стандартном высоком уровне рассуждений. Это выбранные поставщиком показатели партнёров, а не гарантии для любого сценария.
С другой стороны, важна зрелость тестового стенда. Это хорошо видно в обсуждении Claude Code и Antigravity: пользователи жалуются на проблемы с доступностью Antigravity и отсутствие отдельных элементов рабочего процесса — SSH, повторно используемых хуков, навыков и субагентов. Это впечатления пользователей первой недели после запуска, а не контролируемое измерение. К тому же речь идёт о тестовом стенде, а не о весах модели.
До переноса продакшен-агента проверьте три вещи: насколько надёжно параллельные вызовы инструментов работают при вашем количестве MCP-серверов, как часто агент восстанавливается после неудачного шага в bash или браузере и как ведёт себя на границах разрешений. Внутренние проверки Google заявляют о снижении лишних агентских действий до 81%, недообслуживания — до 79% и честности на уровне 96.7% в собственной оценке честности агентов. Проверьте эти заявления на собственном канареечном прогоне из 50 задач с заблокированными действиями и тупиковыми поисковыми запросами.
Уровни рассуждений: high по умолчанию, xhigh — для отдельных задач
Hydrogen поддерживает уровни low, medium, high и xhigh; по умолчанию используется high. Согласно таблице уровней рассуждений Google, показатель Artificial Analysis Intelligence Index v5.0.1 растёт с 27 до 41, 51 и 54 при переходе от low к xhigh, причём high по умолчанию с результатом 51 немного опережает Argon с 50. В той же таблице для Terminal-Bench 4.0 уровень high даёт 54.0% и обходит xhigh с 53.5%, тогда как AutomationBench-AA растёт с 60.5% до 76.1%, а HLE-Diamond — с 32.2% до 58.8%.
Для агентских циклов правило простое: начинайте с high, а до xhigh повышайте уровень только на отдельных задачах, где узким местом становятся рассуждения — например, при анализе, синтезе или исследовании нескольких документов. После этого проверьте, насколько вырос расход токенов. Согласно карточке модели DeepMind, на более высоких уровнях Hydrogen может использовать больше токенов. Кроме того, дата отсечения знаний — март 2026 года, поэтому для чувствительных к свежести данных в любом случае понадобится поиск или другой механизм извлечения информации.
Что проверить в тестовом стенде до миграции
Согласно карточке модели DeepMind, Hydrogen предлагает контекст на 1,048,576 токенов и до 64K синхронных выходных токенов — либо до 1M через фоновую длительную генерацию. По данным документации Anthropic, Sonnet 5.5 поддерживает 1M входных и до 128K выходных токенов. На бумаге окна почти одинаковы, но для больших кодовых баз важнее сжатие контекста: выясняйте, сколько информации сохраняется после 50 ходов, а не просто сравнивайте цифры в спецификации.
| Gemini 4 Hydrogen | Claude Sonnet 5.5 | |
|---|---|---|
| Контекст / лимит вывода | 1,048,576 входных токенов; 64K синхронных выходных (1M в фоновой генерации) | 1,000,000 входных токенов; 128K выходных |
| Где работает | Gemini API, AI Studio, Antigravity, приложение Gemini — согласно Google | Claude API, Bedrock, Vertex AI, Microsoft Foundry — согласно Anthropic |
В обсуждении Antigravity и Claude Code стабильность тестового стенда называют более серьёзным риском миграции, чем качество самой модели: пользователи сомневаются в сохранности контекста после сжатия, стабильности квот и доступности сервиса. Запустите один и тот же репозиторий, коммит, промпт и набор приёмочных тестов в обоих стендах. Сравните число завершённых задач за период действия подписки и долю мерджей с первой попытки.
Выбор за 60 секунд: три профиля агента
Универсального победителя нет. Если опираться на приведённое выше разделение результатов, а не на отдельное измерение, параллельные и повторяющиеся операции стоит отдавать Hydrogen, а задачи с длинным горизонтом и высокой ценой ошибки — Sonnet 5.5. Связка планировщика и исполнителя от одного поставщика упрощает работу с авторизацией и сжатием контекста. Комбинацию планировщика Claude с исполнителем Hydrogen имеет смысл тестировать только после измерения базового результата в единой экосистеме.
| Ваш агент | Выбор | Почему (уровень доказательности) |
|---|---|---|
| Высокопроизводительный исполнитель: массовые исправления, шаблонный код, обработка данных, мультимодальная сортировка | Hydrogen на уровне high | Победа в бенчмарках поставщика на AutomationBench, Agents' Last Exam и Vending-Bench; независимый замер скорости — около 198 против примерно 144 токенов/с |
| Исполнитель длинных сценариев: отладка с активным использованием терминала, автоматизация ОС и браузера, научные инструменты | Sonnet 5.5 | Победа в бенчмарках поставщика на Terminal-Bench 4.1, OSWorld 2.1 и Terminal-Bench-Science; мнение экосистемы о хуках и субагентах Claude Code |
| Синтезатор исследований: длинные документы, графики, аудио и видео, анализ с активным использованием Sheets | Hydrogen на уровне high, xhigh для самых сложных проходов | Победа в бенчмарках поставщика на HLE-Diamond, Chartography и MKA; при этом независимый повторный прогон MKA дал более низкий результат — 49.52% |
Действительно ли Hydrogen быстрее Sonnet 5.5?
По пропускной способности Hydrogen выигрывает в выборке LLM Leaderboard — около 198 против 144 токенов в секунду. Однако актуальная лента p50 OpenRouter показывает преимущество Sonnet 5.5 по задержке: 2.08 с против 6.92 с в медиане. Причина в различиях между провайдерами, регионами и нагрузкой. Измеряйте обе модели на своём провайдере.
Можно ли заменить Sonnet 5.5 на Hydrogen внутри Claude Code?
Простой заменой ID модели — нет. Sonnet 5.5 нативно работает в Claude Code, где команды используют хуки, навыки и субагентов. Hydrogen доступен через Gemini API, AI Studio, Antigravity и приложение Gemini. Такая замена означает миграцию тестовых стендов.