 AIREITER
Opus 5.5 берёт качеством, GPT-6.1 Sol — базовой ценой, но только пока каждый запрос укладывается в 272K входных токенов. Перешагните этот порог — и доплата за длинный контекст почти съест преимущество Sol. К тому же несколько пользователей Codex утверждают, что в реальном времени Sol работает медленнее.
Обе модели уже доступны. Anthropic выпустила Claude Opus 5.5 22 сентября 2026 года — это первая модель семейства Claude 5.5. OpenAI представила GPT-6.1 Sol 29 сентября 2026 года; её API ID — gpt-6.1-sol. Одних таблиц характеристик здесь недостаточно: итоговый счёт определяют порог длинного контекста, настройка усилий и то, как модель расходует квоту в подписке.
Короткий вывод
Выбирайте Claude Opus 5.5, если ошибка или чрезмерно раздутый патч обойдутся дороже самих токенов: для длительных миграций, аудита нескольких репозиториев и автономных агентов. GPT-6.1 Sol лучше подходит для больших объёмов чётко ограниченной работы, если каждый запрос содержит менее 272K входных токенов: автоматизации тикетов, извлечения данных из PDF и бизнес-процессов.
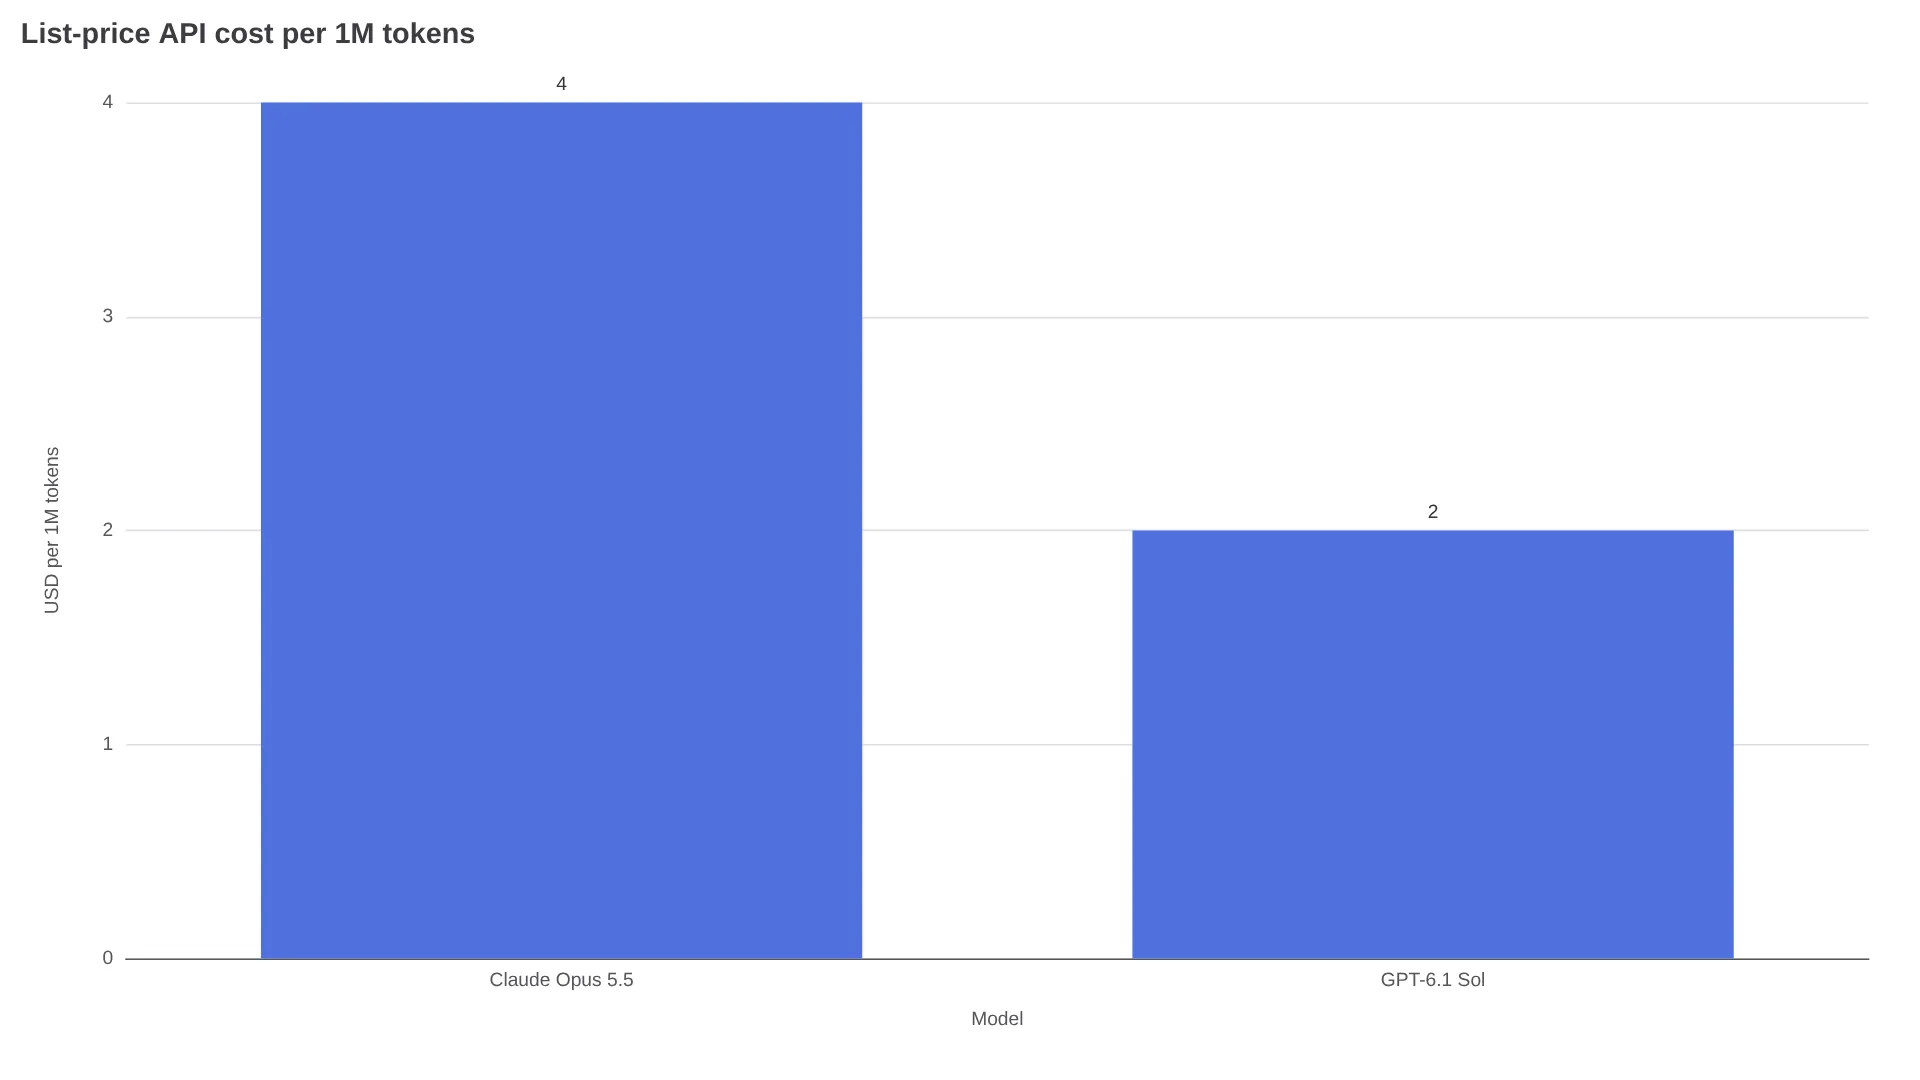
На бумаге разрыв небольшой: контекст 1M против 1.05M, максимум вывода 128K у обеих моделей, а цена составляет $4/$20 против $2/$10 за миллион входных/выходных токенов. Но по поведению разница заметнее. Opus 5.5 показывает более высокие результаты в агентном программировании — 66.4% в Terminal-Bench 4.0, 54.4% в FrontierCode v1.1 и 57.8% в CursorBench 4.0. Sol отвечает примерно вдвое меньшей базовой ценой и подтверждённой победой в AutomationBench при стоимости задачи в треть от показателя Opus. У подписчиков есть отдельный нюанс: тесты квот на Reddit показывают, что Sol расходует доступ быстрее, чем можно предположить по цене API.
Цена, контекст и варианты подключения
| Claude Opus 5.5 | GPT-6.1 Sol | |
|---|---|---|
| Провайдер | Anthropic | OpenAI |
| Дата выхода | 22 сентября 2026 года | 29 сентября 2026 года |
| API ID | семейство claude-opus-5-5 на большинстве шлюзов | gpt-6.1-sol |
| Вход / выход за 1M | $4.00 / $20.00 | $2.00 / $10.00 |
| Чтение кэшированного ввода за 1M | $0.20 | $0.10 |
| Контекстное окно | 1,000,000 токенов | 1,050,000 токенов |
| Максимальный вывод | 128K токенов | 128K токенов |
| Быстрый режим | Fast mode $8 / $40, скорость до 2.5x | Ultrafast — до 8x в Codex, примерно двойные базовые тарифы |
| Доступна через | Claude Code, API, Bedrock, Vertex, Foundry, OpenRouter | Codex, ChatGPT Work, API, Azure, Bedrock, OpenRouter |
| Недоступна в | — | обычном пользовательском Chat на старте |
Для переключения достаточно изменить строку с названием модели. AIReiter подключает обе модели из одной консоли, поэтому управлять двумя ключами разных поставщиков не придётся.
Сколько на самом деле стоят рабочие нагрузки
По базовым тарифам Sol выглядит на 50% дешевле. Но в реальных сценариях всё зависит от размера каждого запроса и доли кэшированных данных.
Наценка OpenAI применяется к каждому запросу, в котором больше 272K входных токенов: для всего такого запроса стоимость входа и чтения кэша удваивается, а вывода — увеличивается в 1.5 раза. Anthropic указывает одинаковые тарифы для полного окна 1M и не заявляет о доплате за отдельный запрос. Чтение из кэша стоит $0.20 против $0.10, поэтому в циклах с активным кэшированием Sol сохраняет часть преимущества.
| Сценарий | Opus 5.5 | GPT-6.1 Sol | Разница |
|---|---|---|---|
| Сбалансированный ассистент: 1M входных / 250K выходных, запросы менее 272K каждый | $9.00 | $4.50 | Sol дешевле на 50% |
| Поиск по данным, запросы менее 272K: 10M входных / 1M выходных | $60 | $30 | Sol дешевле на 50% |
| Поиск по данным, каждый запрос больше 272K: 10M входных / 1M выходных | $60 | ~$55 | Sol дешевле лишь примерно на 8% |
| Цикл с активным кэшем: префикс 100K записывается один раз, затем 1 000 повторов (5K новых + 100K чтения из кэша + 1K вывода) | ~$60.50 | ~$30.25 | Sol дешевле примерно на 50% |
Это расчёт по базовым тарифам, без учёта различий в токенизации. Преимущество Sol максимально в коротких и массовых запросах и минимально — в гигантских одиночных запросах на поиск данных.
Для подписок математика отличается от API. В одном сравнении на 128 фиксированных запросах GPT-6.1 Sol, GPT-6 Sol и Opus 5.5 выяснилось, что подписка на семейство Sol расходует квоту сильнее, чем можно было бы ожидать по цене токенов. Один из участников последующего обсуждения выразился ещё прямее:
«мой ChatGPT только что это процитировал. в любом случае, по расходу они могут быть сопоставимы, но Opus намного быстрее по часам, и я жалею, что в этом месяце перешёл на другую модель». — u/ebrbrbr, ветка теста квот r/ChatGPT
Другой пользователь Codex сообщил о том же:
«Я бы не был против использовать GPT 6.1 Sol, если бы с расходом всё было нормально. Но, хотя он и более “эффективный”, квота всё равно тает. Это просто невероятно». — u/Longjumping_Stop6269, r/codex
Практическое правило для бюджета: если медианный запрос превышает 272K, сначала заложите в расчёт наценку. Если вы пользуетесь тарифом за $20 или $100, отслеживайте долю квоты на каждый смерженный PR, а не количество токенов на доллар.
Программирование и агенты: бенчмарки и два практических теста
Приведённые ниже сторонние результаты стоит воспринимать как ориентир: тестовые стенды и уровни усилий различаются. Источники: Anthropic, OpenAI, тест DataCamp, скорость OpenRouter, сводка бенчмарков SpringPrompt.
| Бенчмарк | Opus 5.5 | GPT-6.1 Sol | Примечание |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | не опубликовано | тест Anthropic, xhigh |
| FrontierCode v1.1 Main | 54.4% | на уровне Fable 5.1, число не указано | разные источники |
| CursorBench 4.0 | 57.8% | не опубликовано | тест Anthropic |
| DeepSWE v1.1 | не опубликовано | на уровне Astra, +6.4 п.п. относительно GPT-6 Sol | тест OpenAI, максимальный уровень усилий |
| AutomationBench (47 инструментов) | 40.0% | +2.2 п.п. относительно Opus на среднем уровне, стоимость примерно в 1/3 | независимый тест без запасных моделей, согласно описанию Anthropic теста Zapier |
| OSWorld 2.0, частичный набор | 81.8% | ~60.5% на офлайн-наборе | разные подмножества, тесты поставщиков |
| GDPval-AA v2.1 | 1,846 Elo | Sol обходит Opus с запасными моделями в GDP.pdf при стоимости <1/2 | заявление OpenAI по результатам разных поставщиков |
Для Opus 5.5 опубликован более полный набор результатов в агентном программировании. Лучшие документированные победы Sol приходятся на бизнес-процессы и анализ документов при меньшей стоимости задачи. Anthropic сообщает, что результаты получены с включёнными защитными механизмами продакшен-уровня.
Два сторонних теста помогают лучше понять разницу:
- Создание Tetris в одном файле (DataCamp, OpenCode, один и тот же промпт, высокий уровень усилий, одна попытка). Обе модели справились со сложной логикой переворота фигур при падении. Sol получил 5.0 против 4.3 за механику, полноту и ощущения от игры. Opus завершил задачу за 3 хода и 2 вызова инструментов, Sol — за 6 ходов и 9 вызовов, но стоимость составила $0.87 против $0.26: Opus потратил 22.5K рассуждающих токенов, Sol — 8.1K.
- Тест квоты на 128 запросах (Reddit, фиксированные промпты, записывались квота и время). Sol израсходовал больше подписочной квоты, чем GPT-6 Sol на той же нагрузке, а Opus завершил работу быстрее по часам.
Пользователи также регулярно отмечают сдержанность Opus:
«Главное преимущество Opus 5.5 для меня — даже не сырая скорость программирования, а то, что он не усложняет простые исправления. Предыдущие модели переписывали 4 файла, когда их просили о патче на 3 строки; 5.5 уважает существующую архитектуру». — u/food_fatherr, r/ClaudeAI
Но встречаются и противоположные примеры с чрезмерной генерацией: один разработчик сообщил, что Sol написал 30 000 тестов для запроса на пиксельное совпадение, а после просьбы сократить результат удалил лишь 25.
Скорость по спецификациям и скорость в работе
По скорости декодирования спецификации на стороне Opus: примерно 96 против 53 токенов/с по данным Artificial Analysis через SpringPrompt и медиальная пропускная способность 74 против 29 на OpenRouter. При этом по данным SpringPrompt Sol немного быстрее выдаёт первый токен: 1.71 с против 6.89 с на низком уровне усилий. А упомянутые отчёты пользователей Codex описывают противоположную картину в задачах от начала до конца — включая простые задания на несколько минут и работу с длинными документами.
Противоречия здесь нет. Токены в секунду измеряют декодирование после появления первой порции ответа, а реальное время включает рассуждения, ожидание в очереди и накладные расходы тестового окружения.
- Режим Opus Fast стоит $8/$40 — в 2 раза дороже — и обещает скорость до 2.5x. Sol Ultrafast обещает ускорение до 8x в Codex при тарифах примерно в 2 раза выше.
- Упомянутые отчёты Codex и Work посвящены задержке, а не скорости декодирования API. В одном 40-минутном задании с PDF за один частный эпизод было использовано лишь 6% пятичасового окна — это не типичная скорость.
- Если ваш цикл интерактивный — Cursor, Claude Code или Codex CLI, — прогоните по три настоящих тикета через каждую модель, прежде чем принимать решение.
Настройки, от которых зависит счёт
Настройки по умолчанию важнее названия модели:
- Начните с Opus на Medium или High. Согласно приведённым отчётам пользователей, режимы Extra High и Max расходуют квоту, почти не давая преимуществ на обычных патчах.
- Механика рассуждений отличается. Рассуждения Opus нельзя отключить, принудительное использование инструментов отклоняется, а отредактированный контекст на новых аккаунтах может привести к ошибке 400 (заметки DataCamp об API). У Sol есть уровни от
noneдоmax; усилия можно менять прямо в диалоге без инвалидирования кэша (описание управления рассуждениями DataCamp). Для циклов с ограниченным бюджетом это удобнее. - Защитные механизмы могут перенаправлять задачи. Большинство задач по кибербезопасности в Opus перенаправляется на Opus 4.8 вне программы Cyber Verification Program; для биологических задач нужна программа Life Sciences (Anthropic). На таких сценариях возможны неожиданные изменения качества и расхода квоты из-за запасной модели.
Какую модель выбрать под конкретную задачу
| Если вы… | Выбирайте… | Почему |
|---|---|---|
| Переносите кодовую базу на 200K строк, проверяете несколько репозиториев или запускаете агента на 9 часов | Opus 5.5 | Более высокие результаты в агентных задачах, меньше нежелательных переписываний, фиксированная цена для окна 1M |
| Обрабатываете 10K тикетов в день, каждый менее 272K, или используете RAG с небольшими фрагментами | GPT-6.1 Sol | Вдвое меньшая базовая цена, сильные результаты в AutomationBench и GDP.pdf в пересчёте на доллар |
| Делаете гигантский одиночный запрос на поиск данных, превышающий 272K | Opus 5.5 или разбивайте задачу для Sol | Наценка Sol сокращает преимущество примерно до 8% |
| Работаете с финансовыми и юридическими вопросами по PDF | Сначала протестируйте Sol | Заявлена победа над Opus с запасными моделями при стоимости задачи <1/2; проверьте на собственных документах |
| Пользуетесь подпиской за $20 и интерактивным CLI | Протестируйте обе; приведённые отчёты склоняются в пользу Opus | Пользователи сообщают, что Sol расходует квоту быстрее расчётного и ощущается более медленным |
Универсального победителя нет. Sol — выбор для экономии и больших объёмов, Opus — для сдержанности и автономной работы. Практичный вариант — отдать Opus планирование и проверку, а Sol использовать для массового исполнения.
Opus 5.5 против GPT-6.1 Sol: ответы на вопросы
Какая модель дешевле через API?
Sol по базовым тарифам: $2/$10 против $4/$20, а кэшированный ввод стоит $0.10 против $0.20. Если каждый запрос превышает 272K входных токенов, разрыв сокращается примерно до 8%.
Какая модель лучше для программных агентов?
Opus 5.5 лидирует в опубликованных результатах Terminal-Bench, FrontierCode и CursorBench. Sol отвечает результатом на уровне Astra в DeepSWE и победой в AutomationBench при стоимости примерно в треть.
Какая модель быстрее в реальной работе?
По скорости декодирования впереди Opus — примерно 74–96 токенов/с против 29–53. По времени до первого токена немного выигрывает Sol. Октябрьские отчёты пользователей Codex говорят о большей медлительности Sol.
Какие API ID у моделей?
gpt-6.1-sol и слаги claude-opus-5-5 на большинстве шлюзов.
Доступна ли GPT-6.1 Sol в обычном ChatGPT?
На момент запуска 29 сентября — нет: сначала Work, Codex и API. Если доступ важен, проверьте свой тариф.
Какую настройку усилий выбрать?
Начните с Opus 5.5 на Medium или High, но не на Max. Sol запустите на среднем уровне и повышайте его только при росте числа повторных попыток. У обеих моделей рассуждающие токены тарифицируются по тому же счётчику токенов (заметки DataCamp о биллинге).
Компромисс, который не исправить промптом
Opus 5.5 бережно относится к структуре репозитория, но берёт плату за рассуждения. Sol снижает стоимость токенов, зато может завалить вас дополнительной работой для проверки — и заставить дольше ждать. Если незаметная ошибка может попасть в продакшен, платите за Opus. Если ошибки обходятся дёшево, а главное — объём, экономьте с Sol, пока запросы не превышают 272K.
Читайте также: обзор и цены Claude Opus 5.5, обзор цен API GPT-6.1 Sol.