 AIREITER
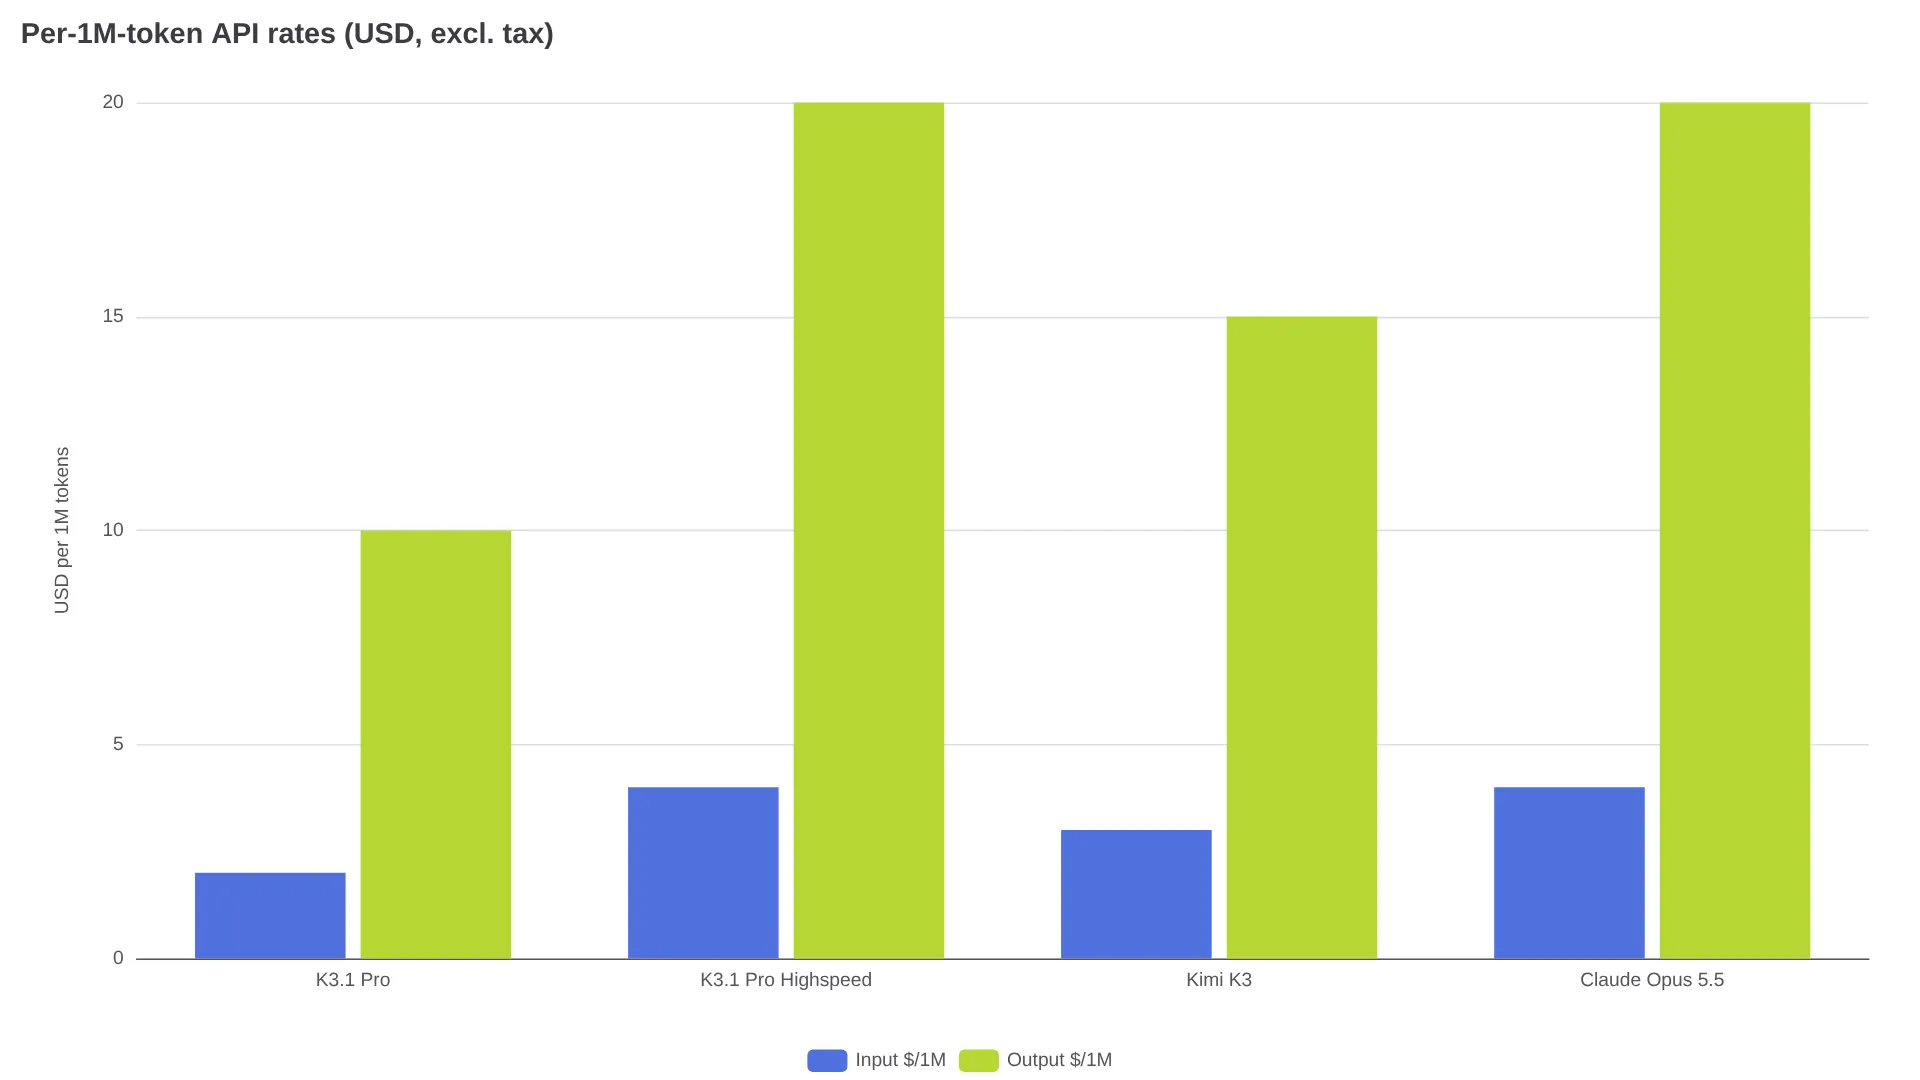
В цене Kimi K3.1 Pro API важны две вещи: базовые $2/$10 и то, сколько к счёту добавят reasoning и работа с кэшем. Стандартный тариф стоит $2 за 1 млн входных и $10 за 1 млн выходных токенов. Highspeed удваивает обе ставки ради скорости, а чтение из кэша на обоих тарифах обходится в $0.20 (platform.kimi.ai).
| Модель | Вход / 1 млн | Выход / 1 млн | Чтение из кэша / 1 млн | Запись в кэш на 5 мин / 1 млн | Запись в кэш на 1 час / 1 млн |
|---|---|---|---|---|---|
Kimi K3.1 Pro (kimi-k3.1-pro) | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
Kimi K3.1 Pro Highspeed (kimi-k3.1-pro-highspeed) | $4.00 | $20.00 | $0.20 | $4.00 | $8.00 |
| Kimi K3 (предыдущее поколение) | $3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
Тарифы указаны в долларах США за 1 млн токенов без учёта налогов. Доплаты за длинный контекст нет — ставка одинаковая для всего контекста объёмом до 1 млн токенов, согласно официальным материалам Kimi (kimi.ai).
Запрос с контекстом 100 тысяч токенов стоит $0.30 — но итоговый счёт может быть выше
Простой пример: 100 000 входных токенов без кэширования и 10 000 выходных обойдутся в $0.20 + $0.10, то есть в $0.30. Это прямой расчёт по официальным ставкам $2/$10. Для реальных запросов используйте формулу ниже. Она относится к стандартному тарифу; для Highspeed ставки входных, выходных токенов и записи в кэш нужно удвоить:
Total = (uncached_in x 2 + cached_read x 0.20 + write_5m x 2
  + write_1h x 4 + (visible_out + reasoning_out) x 10) / 1M
  + searches x 0.004
Формула учитывает все компоненты официального расчёта Kimi: входные токены без кэша, обращения к кэшу, записи с разным TTL и выходные токены (kimi.ai), а также $0.004 за каждый вызов Web Search. API работает по модели pay-as-you-go и тарифицирует каждый запрос отдельно (kimi.ai), поэтому повторная отправка запроса запускает счётчик заново. Reasoning в K3.1 Pro включён всегда и оплачивается по тарифу выходных токенов: скрытые рассуждения расходуют тот же бюджет $10 за 1 млн, что и видимый ответ. Если ответ содержит 10 000 видимых и 40 000 скрытых токенов reasoning, тарифицируются все 50 000 выходных токенов — это $0.50. Реальный пользователь сообщил о запросе с 935 входными и 56 097 выходными токенами стоимостью $0.5628 — почти точное соответствие ставке $10 за 1 млн выходных токенов (x.com).
Кэш — ещё одна строка счёта, которую легко упустить. При первом кэшировании префикса взимается плата за запись, а повторное использование неизменённого префикса в пределах заданного окна стоит всего $0.20 за 1 млн токенов. По умолчанию кэш хранится пять минут, а при каждом вызове можно выбрать вариант на один час (kimi.ai). Если изменить префикс ближе к началу контекста, повторное использование всего последующего содержимого может стать невозможным (kimi.ai). Проверять срабатывание кэша нужно по детализации использования конкретного запроса: там видны токены, прочитанные из кэша, и токены без кэширования. Одинаковая формулировка сама по себе не гарантирует cache hit.
Kimi K3.1 Pro API по строкам счёта: Standard против Highspeed
Highspeed заявляет тот же уровень интеллекта и тот же контекст на 1 млн токенов, но работает примерно в 2–3 раза быстрее. За это входные, выходные токены и запись в кэш тарифицируются ровно вдвое дороже (platform.kimi.ai), как описано в публикации Moonshot о выпуске модели (kimi.ai).
Единственная ставка, которая не удваивается, — чтение из кэша: в обеих версиях 1 млн кэшированных входных токенов стоит $0.20. Для агентских циклов с повторной отправкой длинных системных промптов и описаний инструментов это особенно важно: скидка за повторное чтение одинакова, а новые токены и reasoning в Highspeed обходятся в два раза дороже.
При любом расчёте стоит держать в голове три факта:
- API оплачивается по факту использования: входные и выходные токены считаются отдельно. Этот биллинг не связан с подписками Kimi и Kimi Code, поэтому баланс подписки нельзя использовать для оплаты API-вызовов (kimi.ai).
- API совместим с OpenAI API. Доступны идентификаторы моделей
kimi-k3.1-proиkimi-k3.1-pro-highspeed, endpoint —https://api.moonshot.ai/v1. Через шлюзы модель также доступна какmoonshotai/kimi-k3.1-proв OpenRouter и Vercel AI Gateway. - Дополнительные вызовы Web Search стоят $0.004 каждый сверх оплаты токенов. Сами загруженные файлы не тарифицируются, но их распарсенное содержимое считается входными токенами. Доступ к API открывается после минимального пополнения на $1; действуют ступенчатые лимиты запросов (kimi.ai).
Когда двойная цена Highspeed оправдана, а когда это просто лишние расходы
Highspeed имеет смысл, только если ожидание обходится дороже токенов. Интерактивная разработка, ассистенты в реальном времени и пользовательские демо — случаи, где человек смотрит на индикатор загрузки, — могут оправдать тариф $4/$20, потому что скорость здесь сама является частью продукта. Пакетные задания, ночные агентские запуски и массовые тесты, где ждать некому, лучше оставлять на стандартном тарифе $2/$10 — примерно с половиной указанных ставок за токены. Практический критерий простой: Highspeed оправдан лишь тогда, когда ценность сэкономленного времени выше дополнительной платы за токены. В запросах с большим объёмом входных данных эта доплата примерно равна полному счёту на стандартном тарифе.
Снизить объём reasoning обычно выгоднее, чем переходить на другой тариф. API поддерживает reasoning_effort со значениями low, high и max; по умолчанию используется max, именно на этой настройке основаны опубликованные Moonshot результаты бенчмарков (datacamp.com). Для простой задачи можно снизить уровень с max до high или с high до low и уменьшить расход reasoning-токенов, не переплачивая за Highspeed. В рамках одной сессии лучше не менять уровень: смена настройки сбрасывает кэш контекста (datacamp.com).
Пользовательские замеры помогают оценить компромисс. Японский пользователь сравнил задачи сопоставимого объёма: Opus 5.5 завершил работу за 14:32, а Kimi K3.1 Pro — за 27:53 при близком качестве результата. Его вывод: Kimi стоит использовать только там, где можно ждать:
Должно было получиться вдвое дешевле, но ждать пришлось почти вдвое дольше. ... Opus 5.5 — 14 минут 32 секунды, Kimi K3.1 Pro — 27 минут 53 секунды. Если честно, качество довольно близкое. Я бы отправлял в Kimi только те задачи, где можно подождать. — @rutinelabo (x.com)
Пользователи Reddit описывают похожую разницу: примерно 80 токенов/с у Highspeed против примерно 30 токенов/с у стандартной версии, отмечая при этом высокую стоимость быстрого тарифа:
И снова у модели есть высокоскоростная версия, которая стоит целое состояние и работает настолько быстрее, что глаз не успевает читать — 80 токенов/с. Обычная версия, если ей захочется, выдаёт 30 токенов/с. — u/Kiverty (reddit.com)
Практическое правило такое: начинать со стандартного K3.1 Pro, сначала снижать reasoning_effort и переходить на Highspeed только в сессиях, где результата ждёт человек.
Self-hosting после 4 ноября: что означает класс 3T на практике
Moonshot обещает выпустить полные веса Kimi K3.1 Pro к 4 ноября 2026 года. Модель описывается как относящаяся к классу 3T и имеющая контекстное окно на 1 млн токенов (kimi.com). На 2 ноября официального репозитория K3.1 Pro в организации Moonshot на Hugging Face ещё нет: на странице huggingface.co/moonshotai по-прежнему перечислены Kimi K3 и более ранние модели, а в поиске находятся только неофициальные форки. Финальная лицензия, форматы файлов и варианты квантизации также не подтверждены; сторонние трекеры отмечают их статус как неизвестный до официального релиза (ctrlaltorion.com).
Именно масштаб делает self-hosting здесь редко выгоднее API. K3.1 Pro — дообученный преемник Kimi K3, MoE-модели с 2,8 трлн параметров, и обозначение класса 3T указывает на тот же порядок величины (datacamp.com). Общее число параметров MoE не равно числу параметров, активных на каждом токене, поэтому надёжно оценить необходимый объём VRAM одной рабочей станции по доступным данным пока нельзя.
Вместо догадок о цене GPU используйте символический расчёт точки безубыточности:
API_month = monthly_tokens_1M x blended_$/1M (from formula above)
Self-host wins when cluster_monthly_cost < API_month at sustained utilization
При ставках $2 за 1 млн входных и $10 за 1 млн выходных токенов 1 млрд входных токенов плюс 100 млн выходных обойдутся в $2 000 + $1 000, то есть примерно в $3 000 API-биллинга. Self-hosting выгоден командам, у которых уже есть подходящий кластер, которые постоянно выполняют большой объём инференса или обязаны хранить данные локально. Если собственного кластера и стабильной загрузки нет, приведённая формула обычно будет в пользу API с оплатой по факту. Прежде чем что-либо планировать, дождитесь официального чекпойнта и лицензии.
Две ошибки в биллинге, на которые пользователи постоянно натыкаются
Первая — reasoning считается как выходные токены, и формула выше это уже учитывает. Ограничивайте запуски параметром max_completion_tokens, начинайте проверочные запросы с low, повышайте до high только при неудаче и оставляйте max для финальных сложных запусков.
Вторая — путаница между расходом квоты подписки и предсказуемостью API. Несколько платящих пользователей сообщали, что тратили пятичасовой лимит за считанные минуты на сложных задачах по программированию; один пользователь топового тарифа сообщил, что месячная квота закончилась за шесть часов (reddit.com). 25 октября Moonshot признала проблему, извинилась за ограничения скорости и ненужный расход квоты, а также разово восстановила 25% квоты, параллельно сократив повторные вызовы субагентов и длину ответов (x.com). Для интенсивных задач по reasoning и программированию API с оплатой по факту — $0.30 за блок из 100 000 входных и 10 000 выходных токенов — предсказуемее подписки, чья квота может исчезнуть за одну задачу.
FAQ о ценах Kimi K3.1 Pro API
Сколько стоит Kimi K3.1 Pro API за 1 млн токенов?
Стандартный тариф: $2.00 за входные, $10.00 за выходные токены, $0.20 за чтение входных токенов из кэша, $2.00 за запись в кэш на 5 минут и $4.00 за запись в кэш на 1 час. Цены указаны за 1 млн токенов без учёта налогов (kimi.ai).
Чем K3.1 Pro отличается от Highspeed?
Highspeed заявляет тот же уровень интеллекта и контекст на 1 млн токенов, но работает примерно в 2–3 раза быстрее. Стоимость составляет $4.00 за 1 млн входных и $20.00 за 1 млн выходных токенов; запись в кэш также вдвое дороже, а чтение из кэша остаётся на уровне $0.20 (platform.kimi.ai).
Какие идентификаторы моделей используются в API?
Для стандартной версии на совместимом с OpenAI endpoint Moonshot используйте kimi-k3.1-pro, для быстрой — kimi-k3.1-pro-highspeed. Через шлюзы модель указана как moonshotai/kimi-k3.1-pro (openrouter.ai).
Входит ли API в подписку Kimi?
Нет. API-биллинг не связан с подписками Kimi и тарифами Kimi Code: используются отдельные ключи и балансы, поэтому средства подписки нельзя потратить на API-вызовы (kimi.ai).
Можно ли отключить reasoning, чтобы снизить расходы?
Нет. K3.1 Pro всегда выполняет рассуждение. Управлять расходами можно через reasoning_effort (low, high, max; по умолчанию — max) и max_completion_tokens, но не отключением reasoning (datacamp.com).
Когда выйдут открытые веса и стоит ли ждать?
Moonshot ориентируется на 4 ноября 2026 года, но на 2 ноября официального репозитория на Hugging Face и финальной лицензии ещё нет. Пока используйте API, а к self-hosting возвращайтесь после публикации официального чекпойнта и лицензии.
Читайте также: Kimi K3.1 Pro API: цены, бенчмарки и разбор Highspeed — подробный разбор результатов тестов; цены Kimi K3 — тарифы предыдущего поколения; и страница Kimi K3 API — вызов моделей Kimi с помощью одного ключа.