 AIREITER
Пока промпт укладывается в 100 000 токенов, Claude Haiku 5.5 обходится в двадцать раз дешевле Sonnet 5.5. После этого порога разрыв сокращается до 4 раз — а агентные циклы накапливают такой контекст гораздо быстрее, чем обычно рассчитывают команды. Для коротких, повторяемых API-задач Haiku 5.5 вполне хватает; в отладке и многошаговой разработке премия за Sonnet 5.5 по-прежнему оправданна.
До 100K токенов Haiku дешевле в 20 раз, после — уже нет
У Claude Haiku 5.5 и Claude Sonnet 5.5 одинаковые ключевые лимиты, но совершенно разная стоимость использования. Обе модели поддерживают контекстное окно в 1M токенов и максимум 128K токенов в ответе; их идентификаторы — claude-haiku-5-5 и claude-sonnet-5-5. Согласно анонсу Anthropic для Haiku 5.5 и анонсу Sonnet 5.5, Sonnet 5.5 вышла 28 сентября 2026 года, а Haiku 5.5 — 7 октября 2026 года. Те же лимиты — 1M контекста и 128K вывода — указаны в документации платформы Claude для Sonnet 5.5.
| Характеристика | Claude Haiku 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| Model ID | claude-haiku-5-5 | claude-sonnet-5-5 |
| Дата выхода | 7 окт. 2026 | 28 сент. 2026 |
| Контекст / максимум вывода | 1M / 128K | 1M / 128K |
| Ввод / вывод до 100K | $0.10 / $0.50 за 1M | $2 / $10 за 1M |
| Ввод / вывод при промпте свыше 100K | $0.50 / $2.50 за 1M | $2 / $10 за 1M (без отдельного тарифа) |
| Чтение кэша | $0.01 за 1M | $0.10 за 1M |
| Effort по умолчанию | medium | high |
Это рекомендованные тарифы Anthropic. Как отмечено в сводке APIKO по ценам Anthropic, если промпт Haiku 5.5 превышает 100 000 токенов, повышенный тариф применяется ко всему запросу, включая чтение и запись кэша.
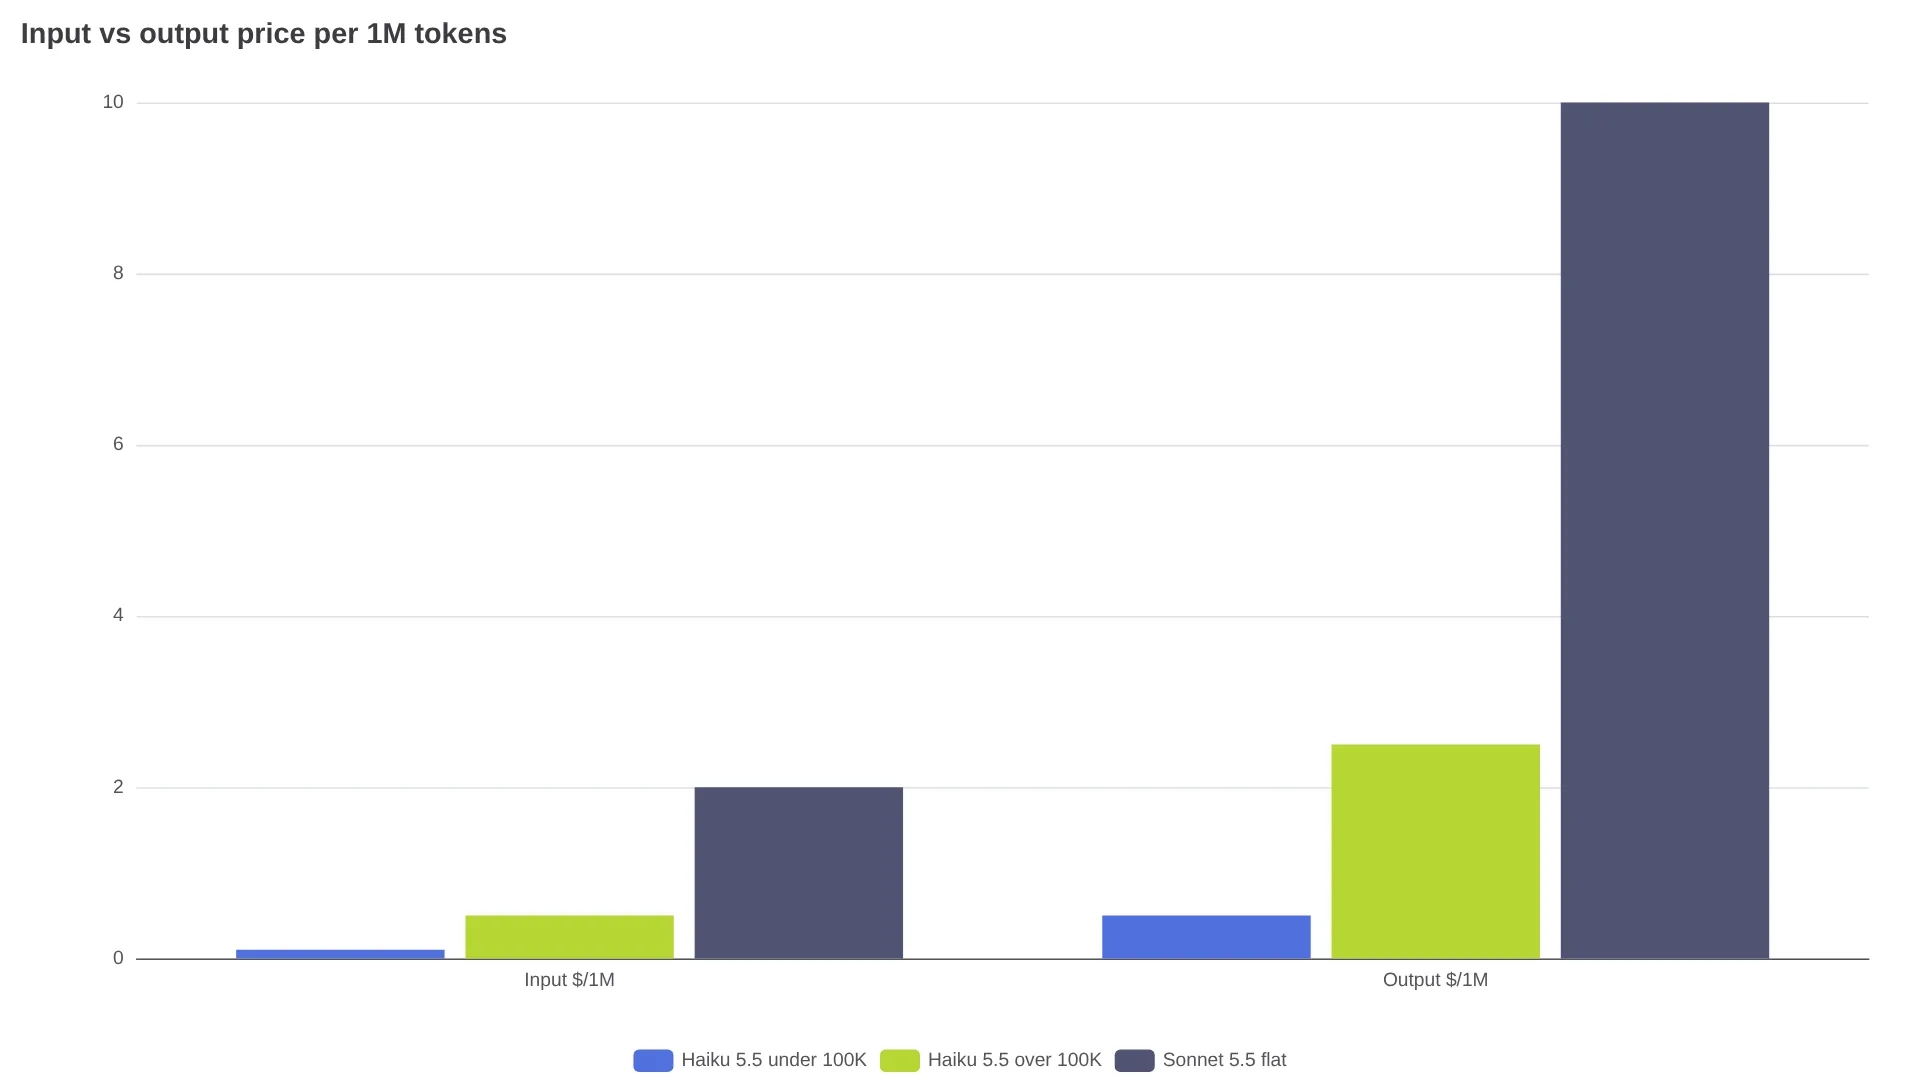
Для 1 000 одинаковых документов по 99K токенов с ответом в 1K токенов пакет обойдётся примерно в $10.40 по рекомендованным тарифам; APIKO указывает $4.54 за тот же пакет по своим ставкам. Но 1 000 документов по 101K токенов стоят уже около $53.00 по list price: в пять раз больше всего из-за 2 000 дополнительных токенов на документ. Для сравнения, Sonnet 5.5 на том же пакете из 101K документов обойдётся примерно в $212.00. Это простые расчёты по list price, приведённым в тесте APIKO Haiku 5.5 vs Sonnet 5.5. По модели расчёта из сравнения цен Sonnet 5.5 и Haiku 5.5 от Sim, 1 000 вызовов с 10K токенов на входе и 1K на выходе стоят $30.00 на Sonnet 5.5 против $1.50 на Haiku 5.5 — снижение расходов на 95%.
В реальных агентных сценариях этот порог достигается сам собой. В одной ветке r/ClaudeAI о расходе токенов Haiku 5.5 пользователь заметил, что прогоны начали пересекать 100K примерно на двадцатом вызове модели. Из следующих 164 вызовов 145 уже считались по повышенному тарифу: накапливались история и вывод инструментов. Участники обсуждения советовали дробить задачи, ограничивать набор файлов, отключать шумный вывод тестов и запускать новых подагентов вместо ведения одного длинного диалога. Короткие задания на Haiku действительно дёшевы. Для пайплайнов с длинным контекстом Sonnet нужно сразу закладывать в бюджет.
«Низкая цена Haiku 5.5 сохраняется только до 100K контекста. После 100K входных токенов стоимость вырастает в 5 раз; на небольших задачах вроде перевода и суммаризации можно экономить, а для работы с длинным контекстом лучше использовать Sonnet». — @zookmas1314
Для подробностей по каждой модели отдельно смотрите стоимость API Claude Haiku 5.5 и обзор и цены API Claude Sonnet 5.5.
Что показывают бенчмарки Haiku 5.5 и Sonnet 5.5
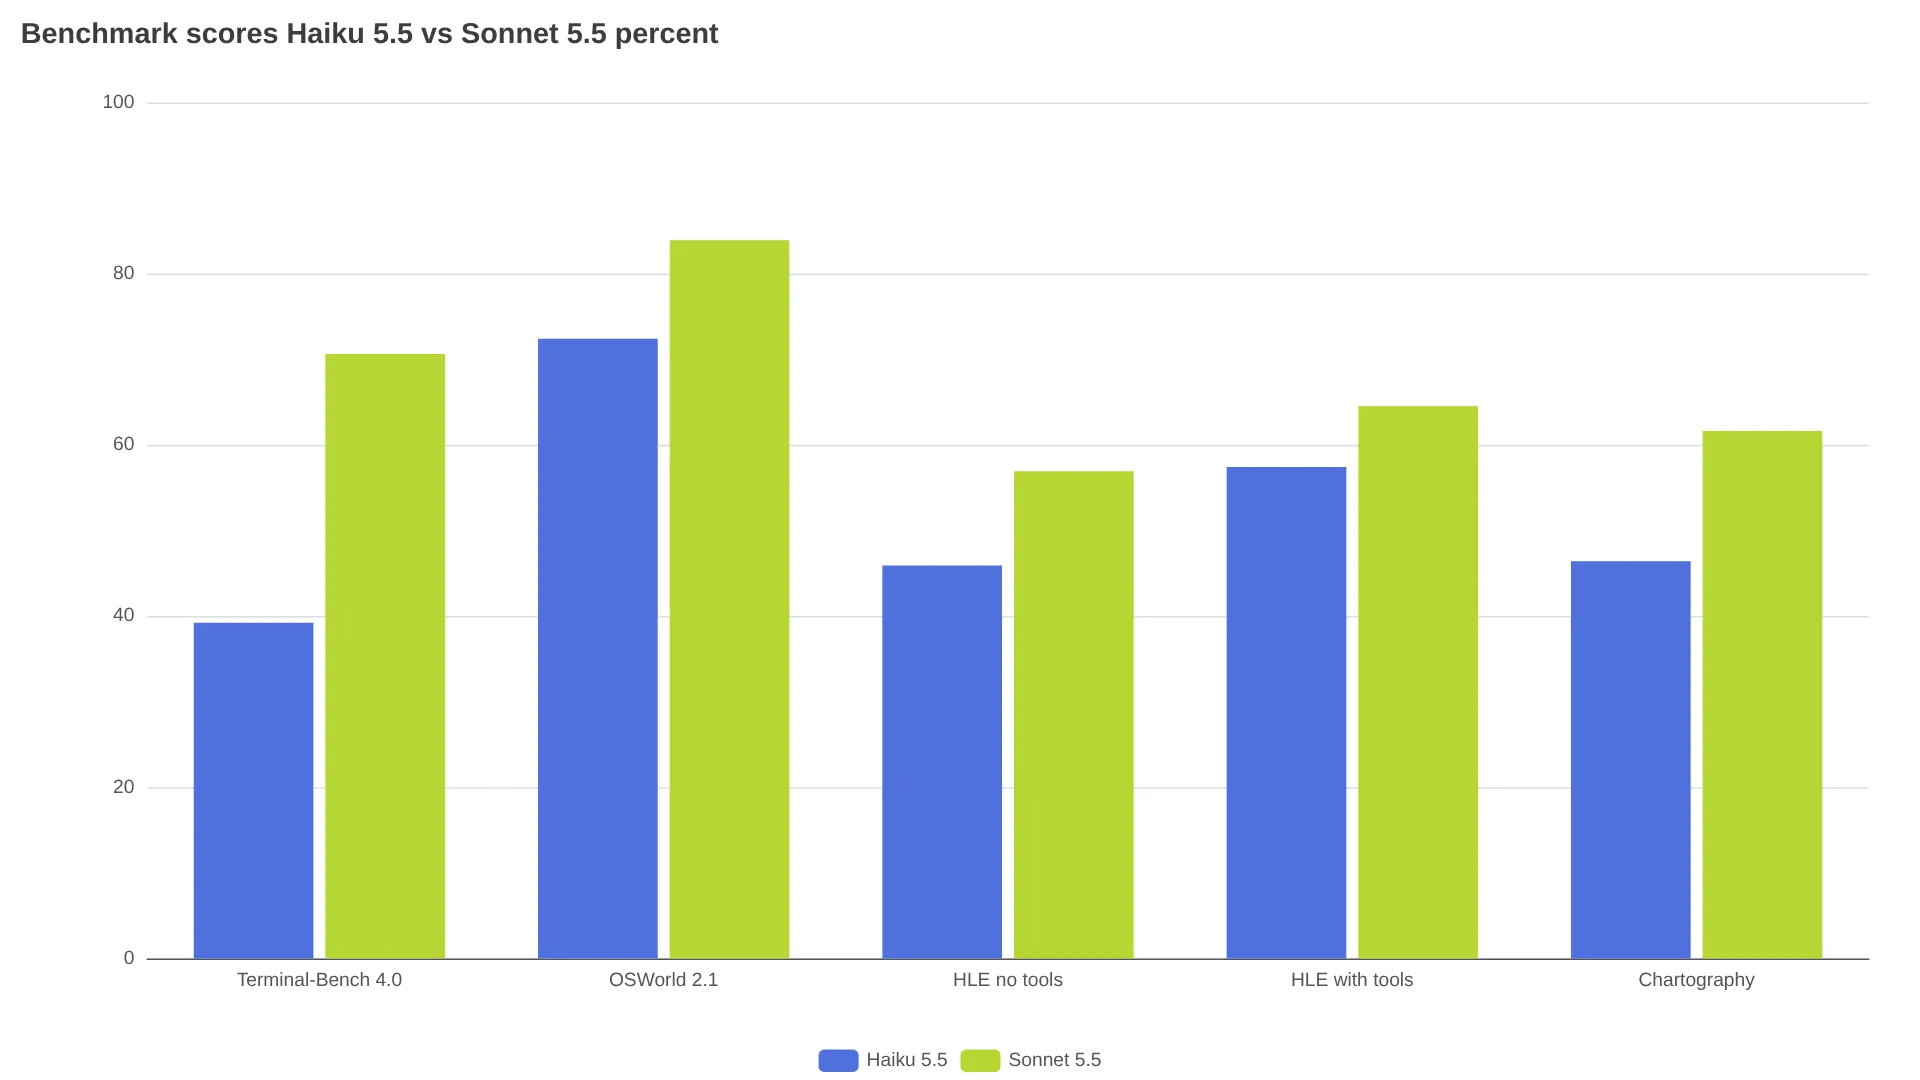
Во всех прямых сравнениях, опубликованных Anthropic, Sonnet 5.5 опережает Haiku 5.5. Максимальная разница заметна там, где агенту нужно писать и выполнять код. В Terminal-Bench 4.0 для агентного программирования Haiku 5.5 набирает 39.2%, а Sonnet 5.5 — 70.6%. В OSWorld 2.1, оценивающем работу с компьютером, разрыв меньше: 72.4% против 83.9%. В Humanity's Last Exam без инструментов результаты составляют 45.9% и 56.9%, с инструментами — 57.4% и 64.5%. Эти показатели собраны в сравнительной таблице APIKO.
Настройка effort может как сократить, так и увеличить этот разрыв. В результатах Artificial Analysis, приведённых в том же сравнении, Haiku с xhigh и Sonnet с medium получили по 41 баллу в Intelligence Index, а показатели Terminal-Bench почти совпали: 29.3% против 29.8%. При этом Haiku с xhigh стоила $0.12 за задачу против $0.48 для Sonnet с medium, но выполняла её за 295 секунд, а не за 122 секунды. Ни одна конфигурация Haiku не достигла результата Sonnet по умолчанию с high — 47 баллов в этом датасете. В этих цифрах не учтён тариф Haiku для запросов свыше 100K, поэтому для задач с длинным контекстом их стоит считать лишь нижней границей расходов.
Для узкой экстракции и классификации преимущество Sonnet в программировании не требуется. Но ведущему агенту в разработке, длинным циклам вызова инструментов и визуальному рассуждению — например, Chartography: 46.4% против 61.6% — оно необходимо. Не стоит воспринимать один Elo-рейтинг или индекс как универсальную оценку качества. В одном тесте на Reddit Haiku-medium сравнялась с Sonnet на смешанной кодовой базе Rust и legacy-кода при стоимости $0.08 против $1.68. В том же процессе Haiku-high сделала 385 запросов, но не дала прироста качества — согласно контролируемому тесту Haiku 5.5 для программирования в r/ClaudeCode.
Важнее не модель, а уровень effort: Haiku low против Sonnet low
Многие жалобы на избыточную многословность Haiku объясняются настройкой effort по умолчанию. Haiku 5.5 запускается с medium, Sonnet 5.5 — с high; конфигурация thinking у моделей тоже различается. Для Haiku thinking отключается через {"type": "disabled"}. Sonnet при effort high и ниже использует {"type": "between_tools"}, а при xhigh/max — adaptive либо отсутствие параметра thinking. Это описано в документации платформы Claude и заметках APIKO о поведении моделей.
В оценке APIKO от 10 октября 2026 года использовался endpoint Messages: 22 задачи и 528 запросов. Haiku на low успешно прошла 65 из 66 прогонов, тогда как Sonnet в зависимости от конфигурации прошла от 64 до 66; для этих коротких задач стоимость через gateway у Haiku была примерно в 18 раз ниже. Полное отключение thinking снизило результат Haiku до 56 из 66: ошибки в основном пришлись на рассуждения и строгое соблюдение формата, например суммирование CSV и трассировку кода. Haiku с настройкой по умолчанию medium прошла все 66 из 66, но выдала в 4.4 раза больше токенов, чем Haiku на low, преимущественно thinking-токенов.
Практические правила по этим данным и пользовательским отчётам:
- Для ограниченных задач — классификации, роутинга, извлечения данных, короткого JSON — начинайте с Haiku
low, а не с Haikumediumпо умолчанию. - Если нужна лучшая точность при сохранении ценового уровня Haiku, попробуйте Haiku
highилиxhighдо перехода на Sonnetlow. По данным Artificial Analysis из сравнения APIKO, Haikumaxнабрала 43 балла против 36 у Sonnetlowпри цене около 60% от стоимости Sonnet. - Sonnet
mediumи выше оставьте для отладки, многошаговой реализации и длинных цепочек инструментов, где дополнительная задержка Haiku-high уже не приносит качества. - В общем коде задавайте thinking явно для каждой модели. По данным теста gateway APIKO, единый шаблон, отправляющий
between_toolsв Haiku илиdisabledв Sonnet, получает upstream-ошибку 400.
«Opus/Sonnet — основной оркестратор и ревьюер, а Haiku — рабочая лошадка; для каждой фичи запускается новый экземпляр Haiku». — u/ohrajaaa в r/ClaudeAI
Роутить нужно по цене незамеченной ошибки, а не по сложности задачи
Полезный вопрос при роутинге звучит не «сложная ли это задача», а «что произойдёт, если Haiku ошибётся правдоподобно и никто этого не заметит». Несколько упомянутых пользовательских тестов показывают одинаковую картину: Haiku может тихо ошибаться в задачах, где требуется суждение, а Sonnet окупается там, где дорого проверять результат.
| Тип задачи | Основная модель |
|---|---|
| Классификация тональности, маршрутизация тикетов, преобразование разрешений в JSON, сводки логов, OCR и аннотация, выборка SQL, подагенты для сжатия контекста | Haiku 5.5 |
| Поиск по кодовой базе, правки в одном файле, обработка документов за один проход | Haiku 5.5 |
| Ведущий агент для кода, настоящая отладка, многошаговый рефакторинг, фактчекинг, атрибуция документов | Sonnet 5.5 |
Пользователи сообщают об ускорении в 3 раза и существенном снижении расхода лимитов в одношаговых высоконагруженных сценариях Haiku. В одном случае за несколько долларов обработали несколько мегабайт документов — об этом говорится в обсуждении r/ClaudeAI «What is Haiku 5.5 best suited for?».
В сравнении подагентов на шести задачах Haiku оказалась дешёвой, но заметно менее надёжной в исследованиях и фактических суждениях: она пропускала файлы, при этом результат «выглядел чистым». Это следует из теста подагентов Haiku vs Sonnet vs Opus в r/ClaudeCode. Правило безопасности из той ветки сформулировано жёстко:
«Если результат запускает какое-либо действие… он либо уходит в более крупную модель, либо проверяется более крупной моделью». — u/vladgladi в r/ClaudeCode
Есть и важная оговорка для продакшена: структурированный вывод не даётся Haiku бесплатно. В оценке APIKO зафиксирован промах строгого формата на low: корректные метки были обёрнуты в JSON-объект вместо голого массива. Пользователи r/ClaudeCode также сообщают о пропущенной проверке и игнорировании ограничений при низком effort — согласно тому же контролируемому тесту программирования.
Haiku-first схема, которая выдерживает продакшен
Код интеграции должен учитывать специфичные для моделей thinking, выбор инструментов и историю сообщений — это показал проведённый APIKO 10 октября тест gateway по документированным сценариям. Haiku принимает принудительный tool_choice, а Sonnet отклоняет его на upstream-уровне: используйте auto или структурированный вывод. Haiku не умеет читать thinking-блоки Sonnet. Sonnet, напротив, может читать историю Haiku, если она добавляется только в конец; повторная отправка отредактированных блоков Sonnet может вернуть ошибку 400.
Вот Haiku-first подход, к которому пользователи приходят независимо друг от друга:
- Для первого прохода — классификации, извлечения или черновика — вызывайте Haiku 5.5 с effort
low; чтобы полностью отключить thinking, используйтеthinking: {"type": "disabled"}. - Принимайте только метки из allow-list или JSON, прошедший валидацию схемы. Всё неуверенное, невалидное или значимое эскалируйте в Sonnet 5.5 с
medium. - Подагенты должны быть свежими и одноразовыми: отдельный экземпляр Haiku для каждого файла или фичи вместо разрастания одного диалога за пределы 100K.
- Если результат запускает действие, отправляет сообщение или правит production-код, ставьте Sonnet или Opus на ревью.
«Haiku очень хороша, если вы понимаете, что делать, и знаете, как проверять качество её работы». — u/Awric в r/ClaudeCode
Anthropic позиционирует Haiku 5.5 как подагента для высоконагруженных задач вроде суммаризации в связке с Sonnet или Opus, отмечает @ClaudeDevs. В одной из распространённых схем рой Haiku ищет по репозиторию, а Sonnet удерживает diff и тесты — по данным @mirku21.
FAQ: Haiku 5.5 и Sonnet 5.5
Насколько Haiku 5.5 дешевле Sonnet 5.5?
По рекомендованным тарифам — в 20 раз дешевле при промптах до 100K токенов: $0.10/$0.50 против $2/$10 за 1M токенов ввода/вывода. После 100K разница составляет 4 раза: $0.50/$2.50 против $2/$10. Чтение кэша стоит $0.01 против $0.10 за 1M.
У Haiku 5.5 и Sonnet 5.5 одинаковое контекстное окно?
Да. Anthropic и документация платформы указывают для обеих моделей окно в 1M токенов и максимальный вывод 128K токенов.
Подходит ли Haiku 5.5 для production API?
Да, для узких, высоконагруженных задач, результат которых можно проверить, — обычно с effort low и валидацией схемы. Для ведущего агента в разработке и исследований, требующих взвешенных суждений, пользователи сообщают о более высокой частоте пропусков и ложноположительных результатов, чем у Sonnet 5.5.
Какая модель лучше для агентов программирования?
Sonnet 5.5 — для ведущего агента и отладки: 70.6% против 39.2% в Terminal-Bench. Haiku 5.5 — для поиска, механической работы с кодом и задач подагента в одном файле, если результат проверяет Sonnet или Opus.
Как не перейти порог Haiku в 100K токенов?
Делите документы до достижения порога, ограничивайте подагентов нужными файлами, отключайте многословный вывод тестов и запускайте нового подагента для каждой задачи. История агентного диалога пересекает 100K примерно за 20 вызовов.
Можно ли в середине диалога перейти с Sonnet 5.5 на Haiku 5.5?
Без потерь — нет. Haiku не читает thinking-блоки Sonnet, поэтому нужно либо оставаться на Sonnet, либо перезапускать работу на Haiku. Перенос истории Haiku в Sonnet сохраняет рассуждения, если история только дополняется.
Компромисс, который не решить одним роутингом
| Если ваша нагрузка выглядит так | Выбор | Почему |
|---|---|---|
| Сотни классификаций, извлечений, сводок, нормализаций JSON | Haiku 5.5 с low | На коротких задачах при валидации точность близка к Sonnet, а стоимость составляет около 1/18 |
| Одна большая кодовая база, длинные циклы инструментов, отладка, где нельзя ошибиться | Sonnet 5.5 | Преимущество в Terminal-Bench на 31 пункт и меньше незаметных ошибок |
| Документы на границе 100K | Считать цену для обеих | Тариф Haiku, вырастающий в 5 раз, съедает большую часть разницы; выше порога Sonnet дороже лишь в 4 раза |
| Любая задача, где незаметная ошибка попадёт в продакшен | Черновик Haiku плюс ревью Sonnet | Стоимость проверенного успешного результата важнее номинальной цены токена |
Haiku 5.5 выигрывает по цене одной попытки. Но Sonnet может оказаться дешевле, когда основную часть расходов съедают проверка и повторные запуски. Стройте роутер вокруг этого различия — и обе модели перестанут быть лотереей.