 AIREITER
Os números do Qwen-UI-Agent no uso de celulares chamam atenção: 92,2% no MobileWorld-Real, executado em dispositivos reais, e 97,5% no AndroidDaily. Mas o modelo de 27B por trás desses resultados não tem pesos públicos confirmados nem API. Por enquanto, dá para ler o relatório técnico, assistir às demonstrações e baixar apenas os antecessores menores da família MAI-UI. Essa distância entre o desempenho nos rankings e a disponibilidade prática define o lançamento — por isso, este guia reúne todos os resultados oficiais e verifica exatamente o que está acessível.
Todos os resultados do Qwen-UI-Agent
O Qwen-UI-Agent é um agente de GUI de base publicado pela equipe Tongyi-MAI, da Alibaba, em um relatório técnico de 30 de julho de 2026 (arXiv 2607.28227). Um único modelo cobre cenários de celular, uso de computador, web e DeepSearch, com um espaço unificado de ações que abrange operações de GUI, execução de CLI e sequências de ações em lote. Na página oficial de resultados, o Qwen-UI-Agent lidera todos os benchmarks de mobile e grounding exibidos, fica em segundo no OSWorld-Verified e em terceiro no teste de longo horizonte OSWorld-v2. O relatório avalia variantes de 27B, 35B-A3B e 4B; os números abaixo são do carro-chefe de 27B.
Mobile: onde está o recorde
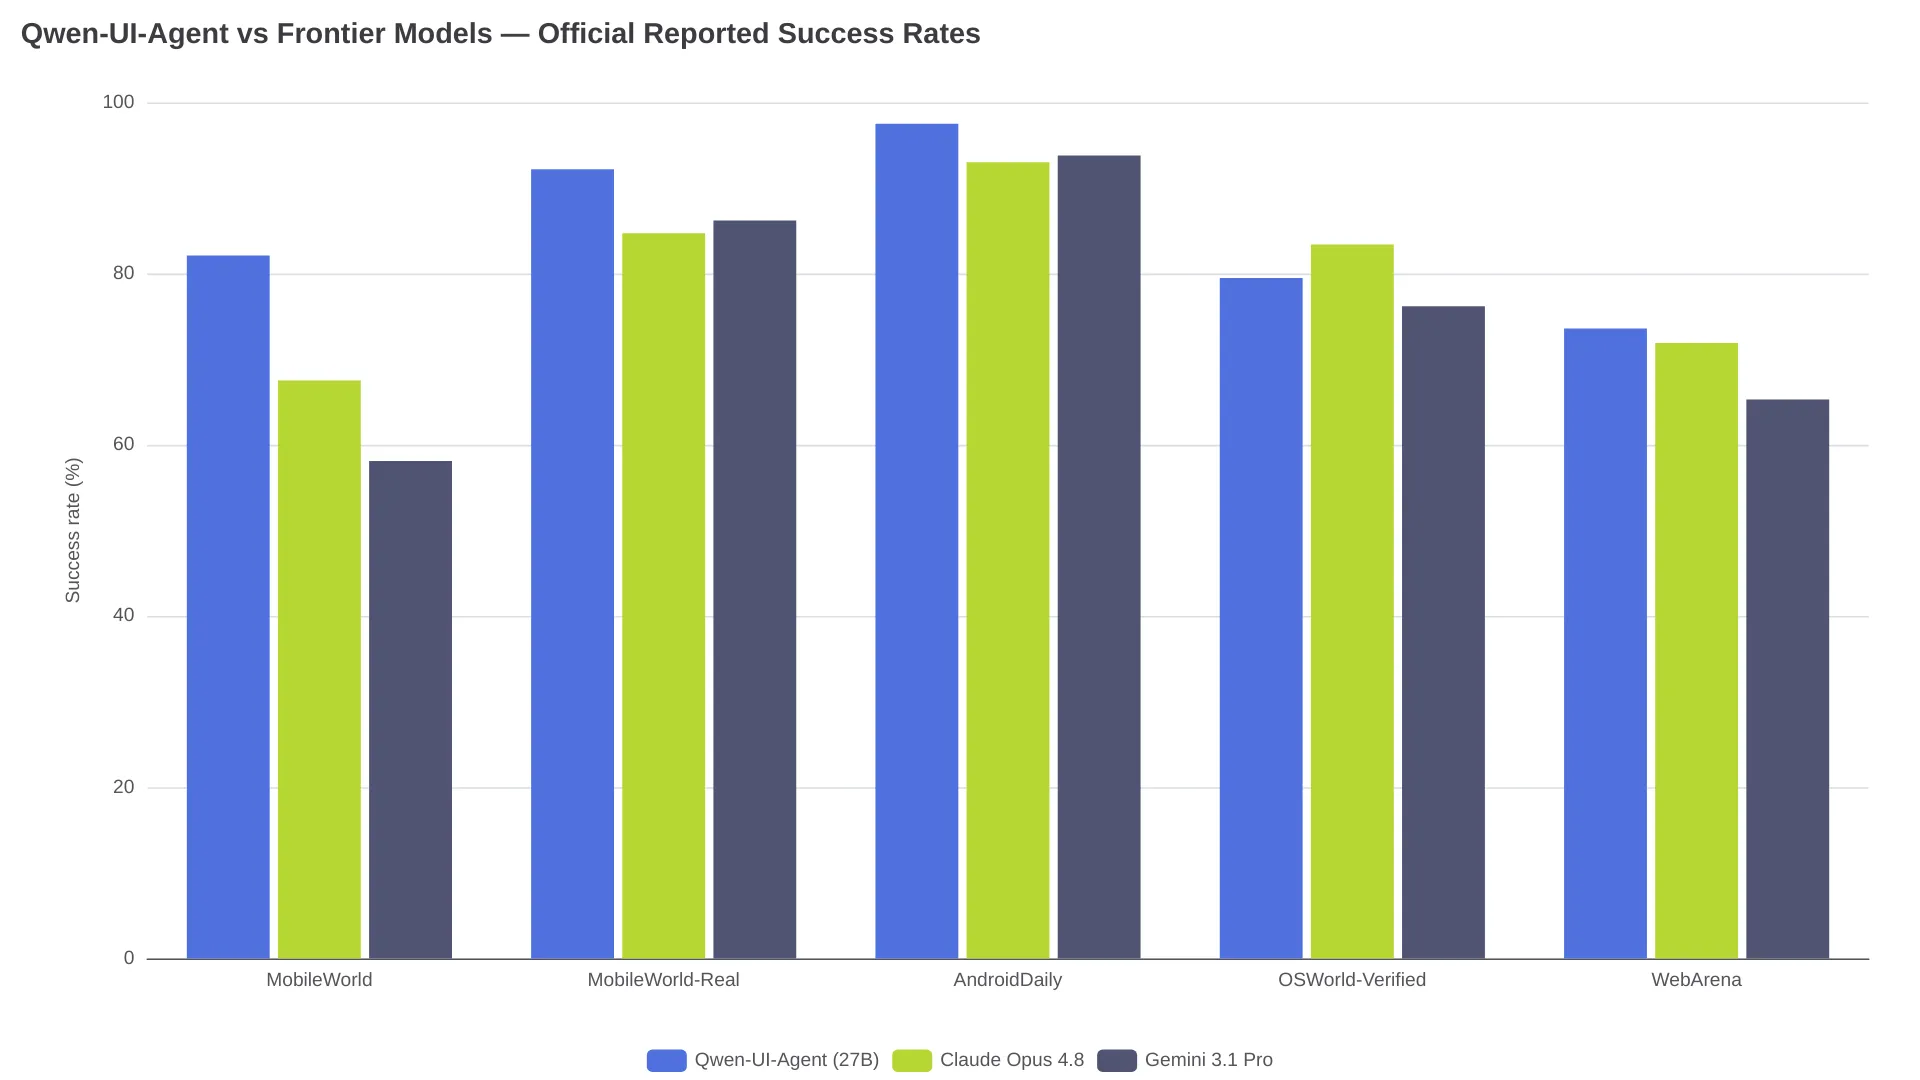
É no mobile que o relatório reivindica o estado da arte, com uma vantagem expressiva. No recorte apenas de GUI do MobileWorld, os 82,1% do Qwen-UI-Agent ficam 8,9 pontos à frente do próximo modelo de uso geral, o Seed 2.1 Pro, com 73,2%, e 38,2 pontos acima do agente de GUI especializado mais forte, o GUI-Owl-1.5-32B-Instruct, com 43,9%.
| Modelo | MobileWorld (somente GUI) | MobileWorld-Real | AndroidDaily |
|---|---|---|---|
| Qwen-UI-Agent (Alibaba) | 82.1 | 92.2 | 97.5 |
| Seed 2.1 Pro (ByteDance) | 73.2 | 88.7 | 95.2 |
| Claude Opus 4.8 (Anthropic) | 67.5 | 84.7 | 93.0 |
| Gemini 3.1 Pro (Google) | 58.1 | 86.2 | 93.8 |
| Qwen 3.7 Plus (Alibaba) | 62.3 | 72.7 | 79.8 |
Nas linhas de mobile, as tabelas oficiais usam GPT-5.6 Sol (70.1 / 85.4 / 92.6); para desktop, usam GPT-5.5. Vale considerar essa diferença antes de citar um número qualquer de "GPT".
O MobileWorld-Real é o benchmark de destaque e foi criado pelos próprios autores: são 409 tarefas de ponta a ponta em 104 apps Android reais, distribuídas por sete domínios de uso cotidiano. Os testes rodam em dispositivos ativos, com contas reais e interrupções do mundo real, e são avaliados por voto majoritário de cinco VLMs.
Uso de computador: competitivo, mas não líder
No desktop, a palavra "competitivo" do relatório ganha peso. Os 79,5% do Qwen-UI-Agent no OSWorld-Verified o colocam em segundo, 3,9 pontos atrás do Claude Opus 4.8. No OSWorld-v2 de longo horizonte, os 40,0% medem progresso parcial — a taxa de conclusão binária é de 13,9% —, e Claude Opus 4.8 (54.8) e GPT-5.5 (49.5) ficam claramente à frente.
| Modelo | OSWorld-Verified | OSWorld-v2 (parcial) | OSWorld-v2 (binário) |
|---|---|---|---|
| Claude Opus 4.8 | 83.4 | 54.8 | não informado |
| Qwen-UI-Agent | 79.5 | 40.0 | 13.9 |
| Seed 2.1 Pro | 78.8 | não informado | não informado |
| GPT-5.5 | 78.7 | 49.5 | 13.0 |
| MiniMax M3 | não informado | 22.3 | não informado |
O argumento de eficiência, porém, tem base: as ações em lote reduzem a média para 135,8 etapas por tarefa, contra 326,7 do MiniMax M3 e 173,5 do Qwen 3.7 Plus. Ainda assim, o modelo supera todos os modelos de pesos abertos em mais de 17 pontos no progresso parcial. No OSWorld-v2, comandos de CLI representam mais de 50% das operações do agente — o design híbrido de GUI+CLI tem efeito mensurável aqui.
Navegador e DeepSearch
No WebArena, o Qwen-UI-Agent alcança 73,6%, à frente de Claude Opus 4.8 (71.9), GPT-5.5 (69.5) e Gemini 3.1 Pro (65.3). Na vertente de pesquisa, ele marca 64,1 no BrowseComp, contra 61,0 do baseline Qwen3.5-27B, e 75,0 no BrowseComp-ZH, contra 62,1. Ou seja, o treinamento DeepSearch transfere capacidade além de simplesmente apontar e clicar.
Grounding de GUI: liderança em todos os testes
Em grounding — clicar no pixel correto a partir de uma instrução visual —, a varredura é completa: segundo a página oficial de resultados, o Qwen-UI-Agent fica em primeiro em todos os benchmarks de grounding mostrados.
| Benchmark | Qwen-UI-Agent | Melhor concorrente |
|---|---|---|
| ScreenSpot-Pro (sem zoom) | 76.6 | 72.9 (GUI-Owl-1.5) |
| ScreenSpot-Pro (com zoom) | 81.5 | 80.7 (Seed 2.1 Pro) |
| SS-V2 | 97.5 | 96.6 (Seed 2.1 Pro / Qwen 3.7 Plus) |
| MM-GUI-L2 | 92.6 | 91.3 (MAI-UI) |
| OSW-G-R | 78.5 | 78.2 (Qwen 3.7 Plus) |
| UI-Vision | 70.0 | 68.0 (Qwen 3.7 Plus) |
O custo de ser generalista é baixo
Modelos especializados em GUI costumam sacrificar a capacidade de atuar como modelos de linguagem. O Qwen-UI-Agent quase não sofre esse efeito: marca 86,5 no MMLU-Pro, frente aos 86,0 do Qwen3.5-27B, e 90,2 no IFEval, contra 90,4. Em comparação com o campo especializado, a diferença é enorme.
| Benchmark | Qwen-UI-Agent | Qwen3.5-27B | UI-Venus 30B-A3B | GUI-Owl 32B | OpenCUA-72B |
|---|---|---|---|---|---|
| Tau2-Bench | 89.9 | 89.2 | 22.7 | 6.1 | 14.4 |
| Terminal-Bench 2.0 | 50.1 | 41.1 | 3.2 | 0.0 | 9.0 |
| BFCL-v4 | 74.2 | 71.3 | 19.8 | 32.7 | 28.3 |
| BrowseComp | 64.1 | 61.0 | não informado | não informado | não informado |
| QwenClawBench | 44.2 | 48.5 | 6.4 | 5.1 | 11.4 |
A única derrota visível para o próprio baseline está no QwenClawBench (44.2 vs 48.5). Também vale observar que a página oficial identifica essas métricas de capacidade mais ampla como reproduzidas no ambiente de avaliação dos autores.
Como o Qwen-UI-Agent foi treinado
Segundo o relatório técnico, os dados de treinamento do Qwen-UI-Agent vêm de uma frota de dispositivos reais: mais de 100 telefones físicos, cobrindo mais de 150 apps. Essa estrutura alimenta um ciclo de dados conduzido pelo próprio agente, que constrói e diagnostica suas próprias tarefas. Após o ajuste fino supervisionado, há RL em múltiplos estágios sobre trajetórias com mais de 100 turnos, geradas em mais de 10.000 ambientes simultâneos.
Até que ponto confiar nos números
Há três ressalvas na própria página oficial, e elas devem acompanhar qualquer resultado citado. Primeiro, o MobileWorld-Real foi criado pelos autores. Segundo, as pontuações de baseline marcadas com adaga foram reproduzidas pelos autores em seu próprio ambiente; harness, avaliador, simulador e subconjuntos de tarefas podem ser diferentes das avaliações oficiais de outros fornecedores. Terceiro, os 40,0% no OSWorld-v2 representam progresso parcial, não taxa de sucesso. (Fonte: as notas da página oficial de resultados e o relatório técnico.)
"O novo agente de GUI da Alibaba vence no celular e emperra no desktop." - @Daily_AI_Brief no X, que também observou que "a Alibaba pontuou todos os baselines em seu próprio ambiente".
Leituras independentes no X chegaram à mesma interpretação. Uma análise em japonês de @itarutomy destacou a liderança em mobile com dispositivos reais, mas ressaltou que os resultados de desktop ficam em segundo lugar. A thread de anúncio oficial de Pengxiang Li, do próprio Tongyi Lab (@oliverlee1999), é a fonte primária sobre o lançamento. Em resumo: trate o MobileWorld-Real como uma alegação forte que ainda aguarda reprodução independente, e o OSWorld-Verified como a comparação mais transferível — não foi um benchmark introduzido pelos autores.
Como acessar o Qwen-UI-Agent hoje
No momento, o Qwen-UI-Agent é um lançamento de pesquisa: há artigo, página de projeto e repositórios de código, mas nenhum checkpoint público confirmado do modelo. Veja o que cada artefato público oferece.
O que existe em cada recurso público
| Recurso | Link | Conteúdo |
|---|---|---|
| Relatório técnico | arxiv.org/abs/2607.28227 | Artigo completo, submetido em 30 de julho de 2026; PDF, HTML e código-fonte TeX |
| Página do projeto | tongyi-mai.github.io/Qwen-UI-Agent | Demonstrações de capacidades, gráficos completos de benchmarks e informações de citação |
| Repositório MAI-UI | github.com/Tongyi-MAI/MAI-UI | Repositório Apache-2.0, renomeado para Qwen-UI-Agent; aponta para os checkpoints MAI-UI-8B e MAI-UI-2B no Hugging Face, lançados em dezembro de 2025 |
| Repositório Qwen-UI-Agent | github.com/Tongyi-MAI/Qwen-UI-Agent | Apenas o código-fonte do site — o repositório informa que não contém modelo, código de treinamento nem implementação do agente |
O repositório MAI-UI é a casa oficial de continuidade da linha: ele anunciou o Qwen-UI-Agent em 30 de julho de 2026 e, atualmente, aponta para os únicos checkpoints baixáveis dessa família.
A situação dos pesos
Os únicos checkpoints disponíveis para download são MAI-UI-8B e MAI-UI-2B, predecessores lançados em dezembro de 2025 e referenciados pelo repositório MAI-UI no Hugging Face. Não há checkpoint público confirmado do Qwen-UI-Agent 27B, 35B-A3B ou 4B. A disponibilidade foi verificada nos repositórios oficiais e na página do projeto no fim de agosto de 2026, e nenhum lançamento foi encontrado. Não trate links para checkpoints do MAI-UI ou para o repositório com o código do site como pesos do modelo Qwen-UI-Agent.
Ainda não há API nem auto-hospedagem
Nenhum endpoint público de API, produto hospedado ou pacote para vLLM/Ollama do Qwen-UI-Agent aparece nos canais oficiais. Na prática, as opções hoje são estas: para fluxos de trabalho de desktop que precisam chegar à produção, os resultados reportados no OSWorld favorecem Claude Opus 4.8; para experimentação de GUI com pesos abertos, o caminho disponível é MAI-UI 2B/8B com seu próprio harness — e isso é MAI-UI, não Qwen-UI-Agent. Acompanhe os repositórios oficiais da Tongyi-MAI e os canais da Qwen para anúncios de lançamento. Para a linha Qwen de uso geral, que já tem API disponível, o catálogo de modelos Qwen da AIReiter acompanha endpoints e preços atuais.
Onde o Qwen-UI-Agent se encaixa na evolução da família
O Qwen-UI-Agent é a terceira geração da linha de agentes de GUI da Alibaba. O UI-TARS inaugurou a abordagem Qwen para GUI em 2025; o MAI-UI (arXiv 2512.22047, dezembro de 2025) introduziu o ciclo de dados centrado no mundo real e abriu os pesos 2B/8B; e o Qwen-UI-Agent escala essa receita para 27B, com execução híbrida de GUI+CLI. Nas tabelas acima, o Claude Opus 4.8 lidera as duas métricas do OSWorld.
Perguntas frequentes sobre o Qwen-UI-Agent
O Qwen-UI-Agent é open source?
Os repositórios de código usam licença Apache-2.0 e o relatório é público, mas não há confirmação de que o modelo tenha pesos abertos. Só os checkpoints dos predecessores MAI-UI-8B e MAI-UI-2B estão disponíveis para download no Hugging Face, desde dezembro de 2025. Até o momento desta publicação, não havia lançamento público confirmado de um checkpoint Qwen-UI-Agent 27B, 35B-A3B ou 4B.
Já é possível rodar o Qwen-UI-Agent localmente?
Não há uma instalação local verificada: não existe checkpoint, pacote GGUF ou Ollama, nem receita para vLLM. Os experimentos locais se limitam ao MAI-UI 2B/8B com seu próprio harness.
Existe uma API do Qwen-UI-Agent?
Não foi anunciado nenhum endpoint público nem produto hospedado. Acompanhe os repositórios oficiais da Tongyi-MAI no GitHub e os canais da equipe Qwen para anúncios de lançamento.
Como o Qwen-UI-Agent se compara ao Claude Opus 4.8 em uso de computador?
O Claude Opus 4.8 lidera no OSWorld-Verified por 83.4 a 79.5 e no progresso parcial do OSWorld-v2 por 54.8 a 40.0. Já o Qwen-UI-Agent lidera o WebArena por 73.6 a 71.9 e todos os benchmarks de mobile exibidos. Hoje, o trabalho de desktop de longo horizonte favorece Claude; os números reportados do Qwen-UI-Agent são mais fortes em tarefas centradas em mobile.
O que é o MobileWorld-Real?
É um benchmark Android em dispositivos reais criado pelos autores do Qwen-UI-Agent: reúne 409 tarefas em 104 apps ativos, distribuídos por sete domínios de uso cotidiano, e usa um avaliador de voto majoritário entre cinco VLMs. Os resultados são autorreportados e ainda aguardam reprodução independente.
O que mudaria essa avaliação
Três sinais mudariam materialmente esta análise:
| Sinal | Por que importa |
|---|---|
| Um checkpoint Qwen-UI-Agent na presença da Tongyi-MAI no Hugging Face | Transformaria o lançamento de pesquisa em uma opção utilizável para desenvolvimento e abriria caminho para métricas de terceiros |
| Uma reprodução do OSWorld-Verified fora do harness da Alibaba | Mostraria se os 79.5% se sustentam além do ambiente dos autores |
| Qualquer superfície de produto: API, integração ao app Qwen ou preview | Levaria a comparação das tabelas do artigo para as decisões práticas de produção |
Até lá, permanece a questão central: as lideranças em uso mobile nos comparativos publicados até agora são autorreportadas, em um benchmark desenvolvido pela mesma equipe.
Leitura relacionada: o mais novo flagship de uso geral da Alibaba e o status de seus pesos abertos são abordados em Qwen3.8-Max open weights, enquanto os custos de endpoint estão no guia de preços da API Qwen3.8-Max.