 AIREITER
Depois de três semanas em modo "em breve", os pesos do Qwen3.8-2.4T-A95B foram disponibilizados no ModelScope em 12 de agosto de 2026. O número que chama atenção é 2,4 trilhões de parâmetros totais, embora apenas 95 bilhões sejam ativados por token. Há, porém, uma barreira importante: mesmo quantizado em 4 bits, o modelo ocupa cerca de 1,2 TB de VRAM. Na prática, quase ninguém fora de um datacenter conseguirá executá-lo localmente. A seguir, veja o que veio no lançamento, quanto custa usá-lo e por que a API será o único caminho sensato para a maioria.
Os pesos do Qwen3.8-2.4T-A95B já estão disponíveis
Os pesos estão no ar. A equipe Qwen, da Alibaba, publicou o checkpoint do Qwen3.8-2.4T-A95B pela conta da comunidade no ModelScope no fim de 12 de agosto. É o primeiro modelo da linha Qwen-Max a receber um lançamento de pesos abertos. Os três Qwen Max anteriores — Qwen3.5-Max, Qwen3.6-Max e Qwen3.7-Max — continuaram restritos à API.
Antes de avançar, vale separar dois produtos que usam o nome "Qwen3.8":
| Nome | O que é | Onde obter |
|---|---|---|
| Qwen3.8-2.4T-A95B | Modelo-base com pesos abertos | ModelScope (checkpoint para download) |
| Qwen3.8-Max | Versão hospedada na nuvem, com recursos adicionais de produção | Alibaba Token Plan, Qoder, QoderWork |
O Qwen3.8-Max é construído sobre o modelo A95B de pesos abertos, mas recebe aprimoramentos de pós-treinamento. A Alibaba descreve um sistema em três estágios que abrange escalonamento em ambiente real, sinais de recompensa unificados e balanceamento de dados online. Os pesos abertos entregam o modelo-base, não toda a pilha de produção do Max.
Portanto, guias que ainda dizem que os pesos foram "prometidos, mas não estão disponíveis" já ficaram desatualizados: o lançamento chegou dentro da janela projetada pela Alibaba, a "semana de 10 de agosto".
Especificações confirmadas: 95B ativos e contexto nativo de 256K
Nas semanas seguintes ao preview lançado em 19 de julho, o total de parâmetros ativos era a especificação ausente mais pedida. Vários guias de terceiros indicavam explicitamente esse dado como "não publicado". Agora há confirmação: são 95 bilhões de parâmetros ativos por token, dentro de um total de 2,4 trilhões.
| Especificação | Valor confirmado |
|---|---|
| Parâmetros totais | 2.4T |
| Parâmetros ativos por token | 95B |
| Arquitetura | MoE (continua o design híbrido do Qwen3.5) |
| Especialistas por camada MoE | 512 |
| Especialistas roteados por token | 10 |
| Especialistas compartilhados por token | 1 |
| Janela de contexto nativa | 262.144 tokens (256K) |
| Contexto expansível | 1.010.000 tokens (1.01M) |
| Método de treinamento | Multi-Token Prediction (MTP) |
| Primeiro lançamento Qwen-Max com pesos abertos | Sim (12 de agosto de 2026) |
Dois pontos merecem atenção. Primeiro, a janela de contexto nativa é de 256K, e não 1 milhão de tokens, como se supunha amplamente. O número de 1,01M se refere a um modo expansível cujas perdas de qualidade ainda não foram documentadas pela Alibaba. Segundo, o roteamento MoE é extremamente esparso: só 11 dos 512 especialistas entram em ação por token, sendo 10 roteados e 1 compartilhado. Essa ativação de cerca de 4% dos parâmetros — 95B de 2,4T — é o que torna economicamente viável cobrar US$ 2/M tokens de entrada, apesar da enorme dimensão total do modelo.
O treinamento MTP (Multi-Token Prediction) permite que mecanismos de inferência compatíveis prevejam vários tokens a cada passagem forward, com potencial de melhorar o throughput. A Alibaba ainda não informou quais engines oferecem suporte a isso.
Auto-hospedagem: o custo real de um modelo com 2,4T de parâmetros
As especificações impressionam até chegar a hora de carregar o modelo. A conta é simples.
Com quantização de 4 bits, 2,4 trilhões de parâmetros exigem aproximadamente 1,2 TB de armazenamento, antes de considerar cache KV, memória de ativações ou overhead de execução. Uma GPU NVIDIA H200 tem 141 GB de memória. Oito H200 somam 1.128 GB, o que não basta para manter os pesos e atender simultaneamente uma janela de contexto minimamente útil.
| Cenário de implantação | VRAM necessária (estimativa) | Hardware | É viável? |
|---|---|---|---|
| Precisão total (16 bits) | ~4.8 TB | 34+ GPUs H200 | Apenas datacenter |
| Quantizado em 4 bits | ~1.2 TB | 9+ GPUs H200 | Apenas datacenter |
| Quantizado em 1.5 bit | ~450 GB | 4+ GPUs H200 | No limite; perda de qualidade incerta |
| Qwen3.8-27B (alternativa) | ~27 GB em 4 bits | 1 GPU de consumo | Sim |
Os 95B de parâmetros ativos ajudam no throughput de inferência por token, pois o modelo percorre apenas uma fração dos especialistas em cada passagem forward. Mas parâmetros ativos não reduzem a memória necessária para armazenar todas as 512 redes de especialistas. Como resumiu o GEO Toolbox: "A ativação esparsa torna o modelo barato para executar em escala, não barato para possuir."
Para rodar localmente ou em um único servidor, a opção realista é a variante Qwen3.8-27B. Ela compartilha a linhagem de treinamento do Qwen3.8, mas cabe em uma única GPU de consumo em 4 bits. O modelo de 2,4T é voltado a pesquisa e datacenters.
Quando usar a API faz mais sentido
Como hospedar um modelo MoE de 2,4T está fora do alcance de praticamente qualquer equipe, é pela API que o acesso prático acontece. O Model Studio, da Alibaba, lista o Qwen3.8 Max por US$ 2 por milhão de tokens de entrada e US$ 6 por milhão de tokens de saída. É mais barato que seu antecessor e também que seu rival chinês mais próximo.
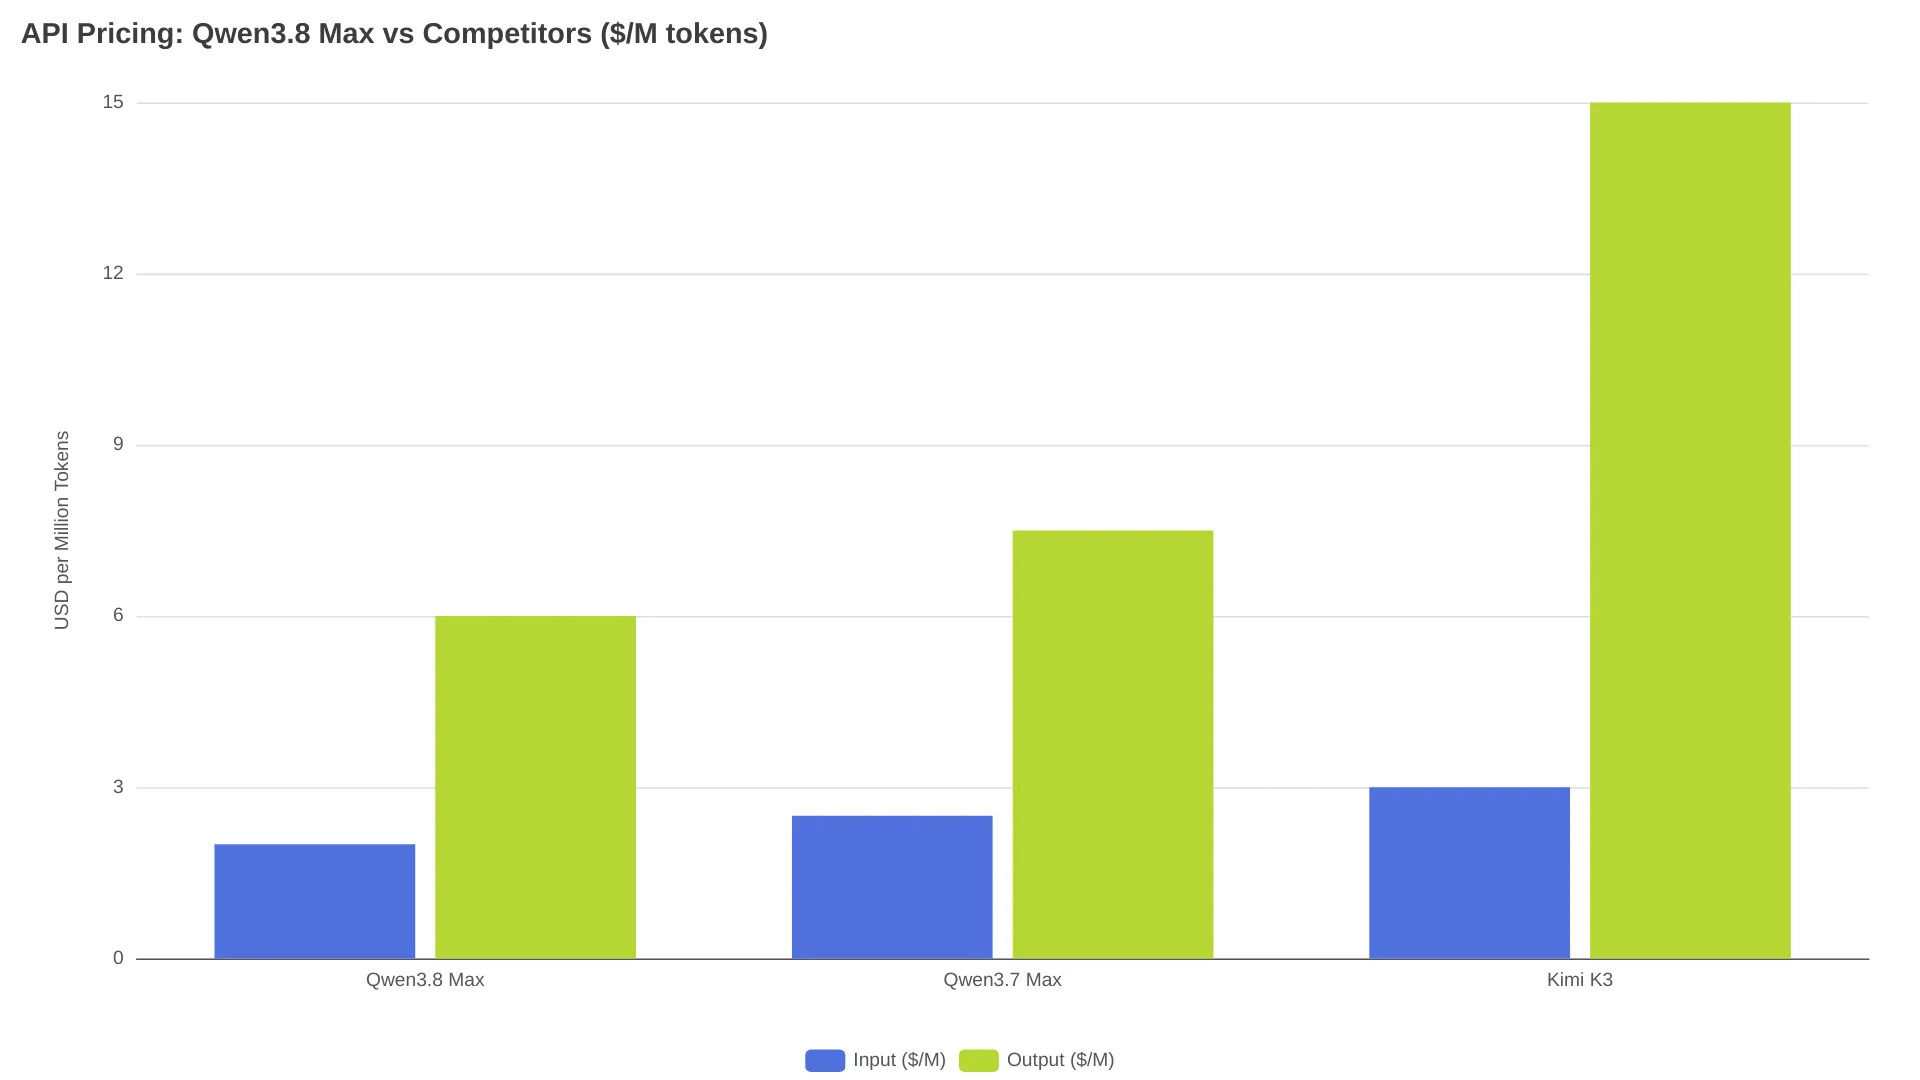
| Modelo | Entrada (US$/M) | Saída (US$/M) | Contexto |
|---|---|---|---|
| Qwen3.8 Max | $2.00 | $6.00 | 256K nativo (1.01M expansível) |
| Qwen3.7 Max | $2.50 | $7.50 | 1M |
| Kimi K3 | $3.00 | $15.00 | 1M |
Além da cobrança por token via API, a Alibaba oferece três planos de assinatura:
- Lite: US$ 6/mês (~10.000 créditos)
- Standard: US$ 18/mês (~40.000 créditos)
- Pro: US$ 68/mês (~160.000 créditos)
O endpoint Token Plan suporta formatos de API compatíveis tanto com OpenAI quanto com Anthropic. Assim, ferramentas como Claude Code, Cursor e OpenCode funcionam sem alterações no lado do cliente. O Qoder, produto de programação da Alibaba, oferece em horários de menor demanda (14:00-00:00 UTC) taxas promocionais de crédito a partir de 0,01x do valor padrão. São descontos de lançamento, porém, não uma precificação permanente.
O modelo de assinatura tem uma ressalva importante. O modo de raciocínio do Qwen3.8 Max é prolixo, e os relatos da comunidade sobre consumo acelerado de cota são consistentes:
"O Qwen tende a pensar demais, DEMAIS." - u/darko, r/Qwen_AI
Na mesma discussão no Reddit, um assinante Lite relatou ter esgotado sua franquia semanal em menos de dois dias, com cerca de 50 milhões de tokens. Um usuário do plano Pro disse ter consumido 500 milhões de tokens em um único dia com sete agentes paralelos e taxa de acerto de cache de 94%. O parâmetro reasoning_effort, configurável como low, medium ou xhigh, controla diretamente a quantidade de raciocínio gerada pelo modelo — e, portanto, a velocidade com que os créditos acabam. No teste de um usuário, ajustá-lo para low reduziu o tempo de pensamento para cerca de 10 segundos por solicitação.
Para ver uma análise detalhada de custos, consulte nosso guia de preços da API do Qwen3.8 Max.
Benchmarks: onde o Qwen3.8 Max se destaca — e onde fica atrás
A Alibaba publicou números de benchmark comparando o Qwen3.8 Max com Fable 5 e GPT-5.6 Sol. O quadro é misto, e a diferença entre os resultados divulgados pelo fornecedor e as medições independentes é relevante.
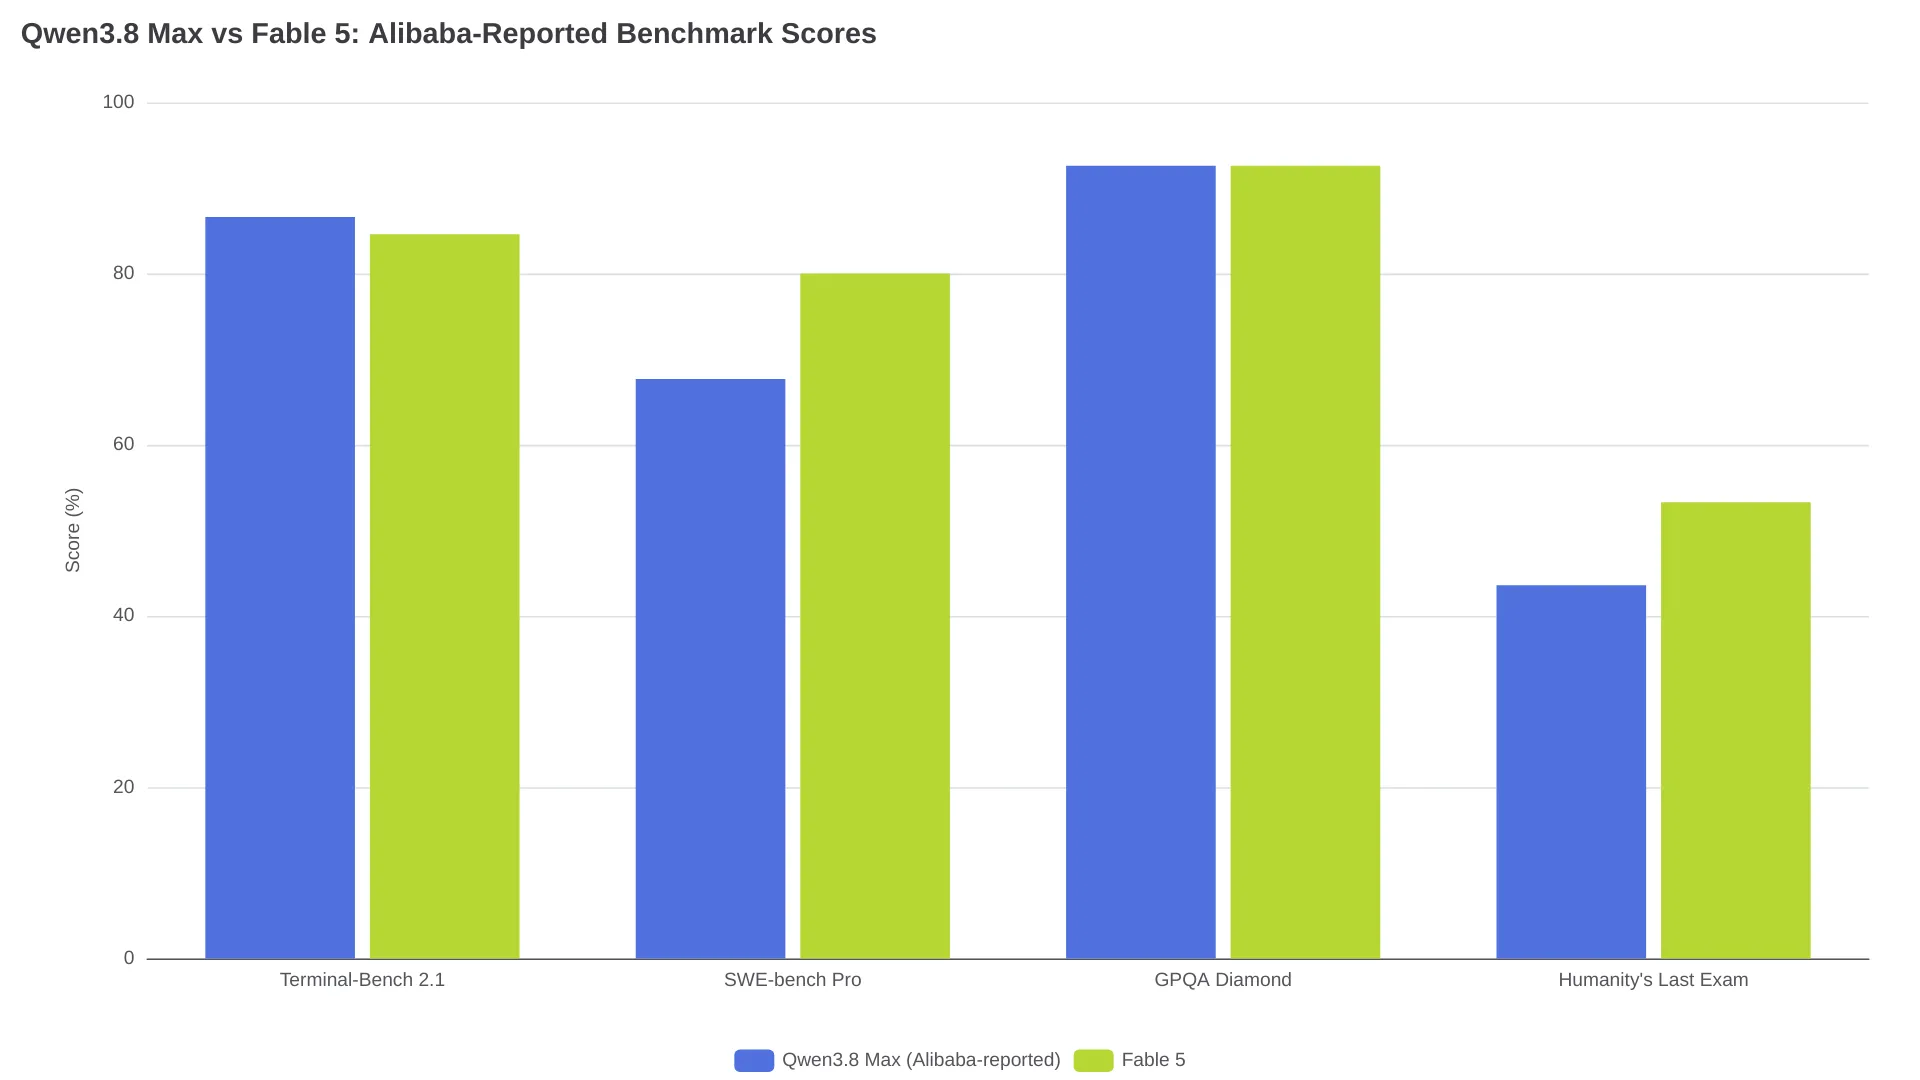
| Benchmark | Qwen3.8 Max (Alibaba) | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench 2.1 | 86.6 | 84.6 | Maior que o Qwen (pontuação exata não publicada) |
| SWE-bench Pro | 67.7 | 80.0 | 64.6 |
| GPQA Diamond | 92.6 | 92.6 | Maior que o Qwen |
| Humanity's Last Exam | 43.6 | 53.3 | Não publicada |
As medições independentes contam outra história. A Artificial Analysis registrou 81,3% para o Qwen3.8 Max no Terminal-Bench 2.1, uma queda de 5,3 pontos em relação aos 86,6% informados pela Alibaba. Com essa pontuação independente, o Qwen fica aproximadamente em décimo lugar geral, atrás do Fable 5, com 84,6%, e do Kimi K3, com 85,0%.
Há áreas em que o Qwen3.8 Max de fato leva vantagem: seus 67,7% no SWE-bench Pro superam os 64,6% do GPT-5.6 Sol, enquanto as pontuações multimodais são fortes — MathVision 95,2 contra 92,7 do Fable 5 e LogicVista 91,9 contra 85,7. O modelo também avançou bastante em relação ao Qwen3.7 Max no DeepSWE 1.1, de 21,6 para 56,6, sinalizando ganhos reais em tarefas de agentes para engenharia de software.
O sentimento da comunidade acompanha essa divisão. A mesma discussão no Reddit com críticas ao excesso de raciocínio também trouxe o seguinte comentário:
"Mas a resposta foi de nível divino." - u/TangerineLogical9779, r/Qwen_AI
A velocidade também parece instável, variando de 8 tokens/s a 60 tokens/s conforme a carga e o horário. Para uma comparação direta com o Kimi K3, veja nosso comparativo entre Qwen3.8 Max e Kimi K3.
Perguntas frequentes
Os pesos do Qwen3.8-Max estão disponíveis para download?
Sim. A Alibaba lançou o checkpoint Qwen3.8-2.4T-A95B no ModelScope em 12 de agosto de 2026. É o primeiro modelo da linha Qwen-Max com pesos abertos. O Qwen3.8-Max hospedado na nuvem inclui recursos adicionais de produção sobre esse modelo-base.
Qual licença os pesos abertos utilizam?
A licença exata ainda não havia sido confirmada no momento da publicação. O histórico sugere Apache 2.0 — o Qwen3.6 foi lançado sob essa licença —, mas o Qwen3.7 Max permaneceu fechado. Antes de criar qualquer produto comercial, leia o arquivo de licença no repositório do ModelScope.
Qual é a diferença entre Qwen3.8-2.4T-A95B e Qwen3.8-Max?
O Qwen3.8-2.4T-A95B é o modelo-base com pesos abertos: 2,4T de parâmetros, 95B ativos, arquitetura MoE e contexto nativo de 256K. Já o Qwen3.8-Max é a versão em nuvem da Alibaba, baseada nesse modelo e ampliada com pós-treinamento em ambiente de produção, incluindo sistemas de recompensa unificados e balanceamento de dados online. Os pesos abertos entregam a base; a API oferece a versão aprimorada.
Posso executar o Qwen3.8-Max localmente?
Na prática, não. Com quantização de 4 bits, o modelo exige aproximadamente 1,2 TB de VRAM — nove ou mais GPUs H200 apenas para os pesos, sem espaço para o cache de contexto. Mesmo em 1,5 bit, ainda são necessárias centenas de gigabytes. A variante Qwen3.8-27B é a alternativa local realista e cabe em uma única GPU de consumo.
Quanto custa a API do Qwen3.8 Max?
A API do Model Studio cobra US$ 2 por milhão de tokens de entrada e US$ 6 por milhão de tokens de saída. As assinaturas começam em US$ 6/mês no plano Lite e chegam a US$ 68/mês no Pro. O Qoder oferece descontos promocionais de crédito de até 98% nos horários de menor demanda, mas esses são preços de lançamento e podem mudar.