 AIREITER
Agosto de 2026 redefiniu a comparação entre Qwen 3.8 e Kimi K3. Agora que os pesos das duas famílias podem ser baixados e seus modelos de ponta estão disponíveis de forma geral, a melhor escolha depende do cenário de implantação: o Kimi K3 tem o histórico verificado mais forte em programação agentiva, o Qwen 3.8 Max vence no preço por token, e o Qwen 27B sob Apache-2.0 roda em uma única GPU de consumo. Há uma ressalva importante no Kimi: seu flagship "aberto" é um checkpoint relatado de 1,56 TB. Ter pesos abertos não significa que o self-hosting seja viável na prática.
O que Qwen 3.8 e Kimi K3 realmente entregaram
O Kimi K3, da Moonshot AI, chegou em 16 de julho de 2026 como um único modelo flagship: um MoE de 2,8 trilhões de parâmetros, com 104B ativos por token, Kimi Delta Attention mais Gated MLA, janela de contexto de 1.048.576 tokens e visão nativa. Os pesos e o relatório técnico saíram em 27 de julho, sob a licença proprietária Kimi K3 License — os termos resumidos na comparação da Emergent impõem condições a revendedores comerciais em larga escala e produtos acima de 100 milhões de usuários mensais.
A resposta da Alibaba foi uma família de modelos, não apenas um. O Qwen 3.8 Max entrou em preview em 19 de julho, alcançou disponibilidade geral no QwenCloud em 3 de agosto com 2,4T de parâmetros totais / ~95B ativos, e seus pesos apareceram no Hugging Face por volta de 12 de agosto como Qwen/Qwen3.8-2.4T-A95B, sob uma licença personalizada qwen3.8-max. Poucos dias depois veio o Qwen/Qwen3.8-27B: um modelo denso vision-language de 27B sob Apache-2.0, com contexto nativo de 262K, expansível a 1M com YaRN (datado de 13 a 14 de agosto pela Yotta Labs).
| Kimi K3 | Qwen 3.8 Max | Qwen3.8-27B | |
|---|---|---|---|
| Parâmetros totais / ativos | 2,8T / 104B | 2,4T / ~95B | 27B denso |
| Contexto | 1.048.576 | 1M (991,8K de entrada máxima) | 262K nativo, 1M via YaRN |
| Licença | Kimi K3 License (personalizada) | Licença personalizada qwen3.8-max | Apache-2.0 |
| Pesos disponíveis desde | 27 de julho de 2026 | ~12 de agosto de 2026 | ~13 a 14 de agosto de 2026 |
| Entrada de visão | Texto + imagem (formal) | Texto, imagem, vídeo via API | Texto, imagem, vídeo |
A Moonshot também teria pausado novas assinaturas de consumidores nas 48 horas após o lançamento do K3, quando a demanda superou a capacidade de GPU. É algo a considerar antes de basear um produto em um único fornecedor.
Benchmarks: o que foi medido e o que foi declarado
Os dois fornecedores publicam tabelas extensas de benchmarks, mas ambas misturam harnesses diferentes. O próprio card do Kimi alerta que as pontuações dos concorrentes vêm de harnesses de agentes distintos e, em algumas linhas, de hardware H20 em vez de H100. Portanto, trate as linhas compartilhadas abaixo como números informados pelos fornecedores, não como resultados auditados.
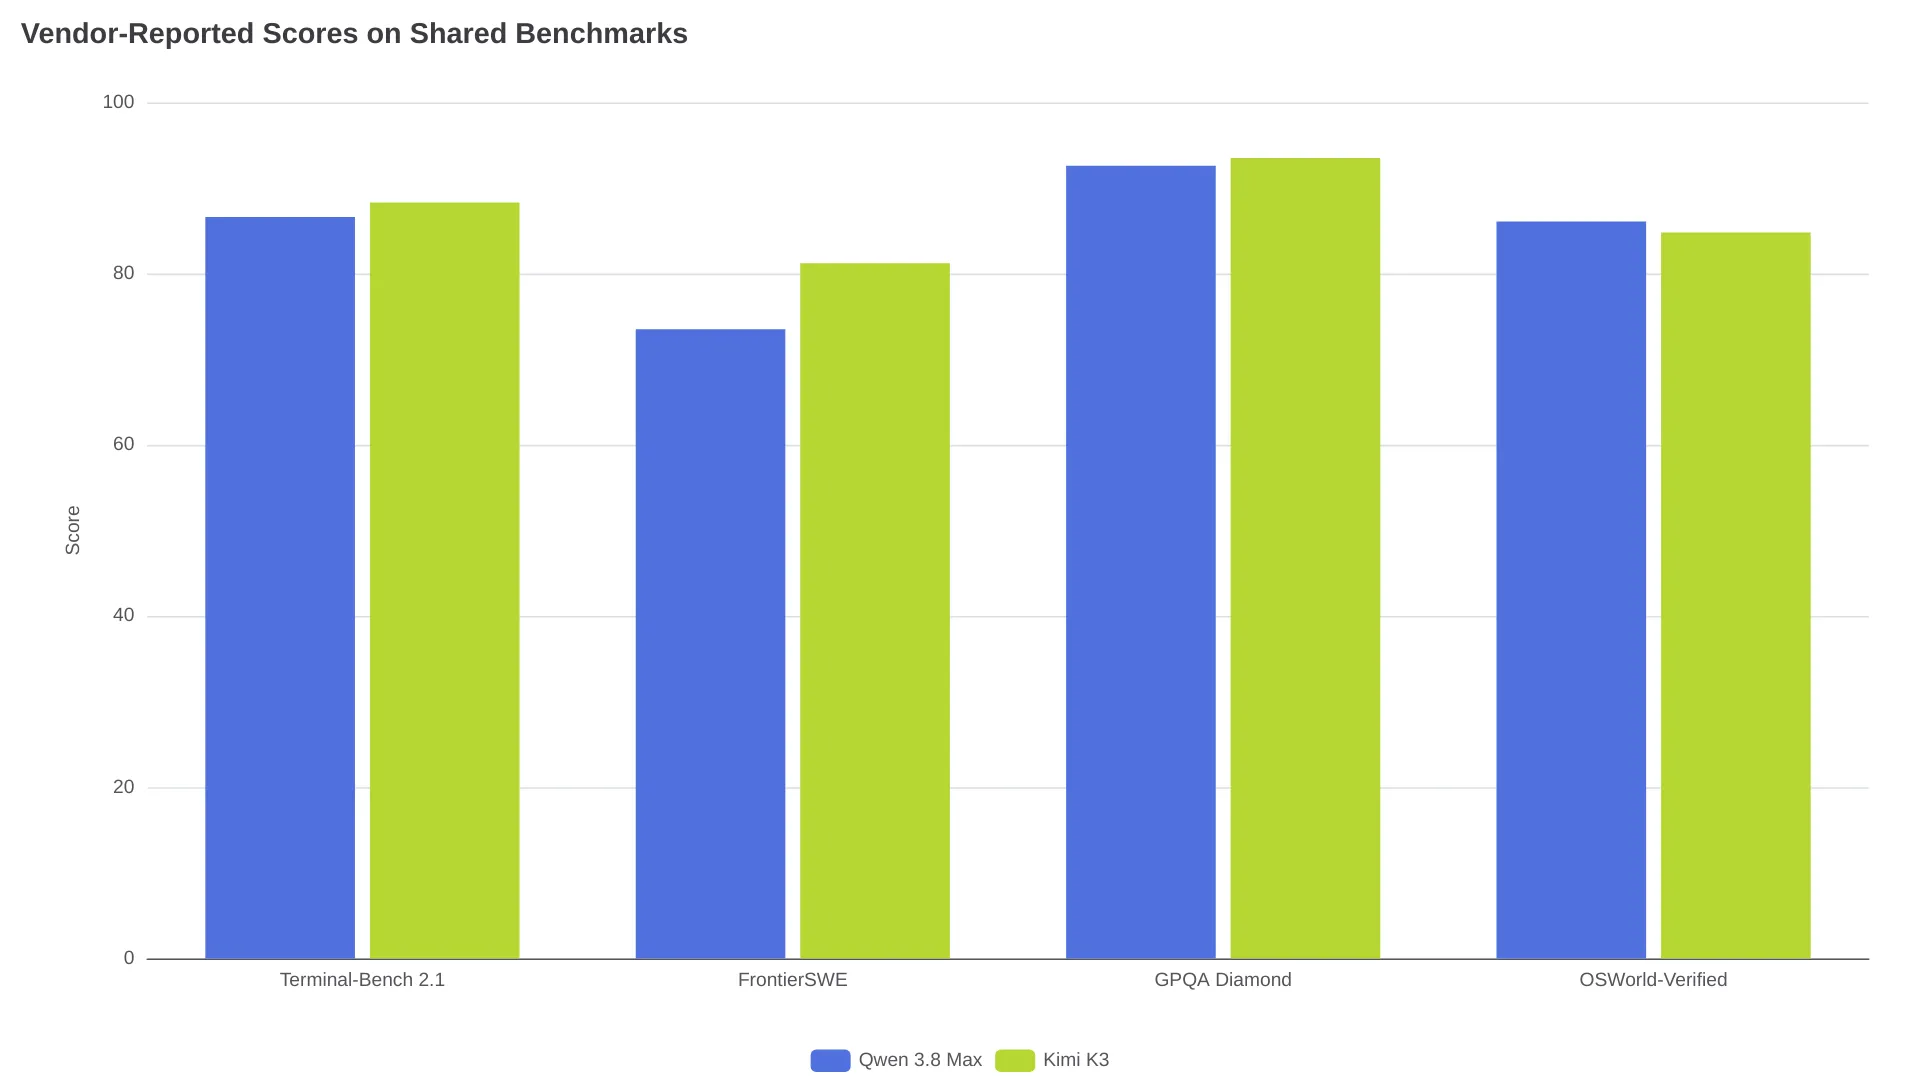
Nessas linhas compartilhadas, o Kimi K3 leva vantagem justamente onde a programação agentiva importa: segundo seu model card, marca 81,2 no FrontierSWE contra 73,5 e 88,3 no Terminal-Bench 2.1 contra 86,6 (lado da Qwen: model card do modelo 2.4T). Os materiais de lançamento da Qwen apontam 86,1 no OSWorld-Verified, ante os 84,8 no card do K3, e o card da Qwen traz destaques isolados — PaperBench 93,0, IFBench 82,8 e SWE-bench Pro 67,7. Já o K3 registra SWE-Marathon 42,0, BrowseComp 91,2 e MCPMark-Verified 94,5 em linhas que a Qwen não informa.
Até agora, o histórico independente pende claramente para um lado. O acompanhamento da Emergent atribui ao Kimi K3 um Artificial Analysis Intelligence Index de 57 no lançamento e 60 na versão atual do índice, atrás de Claude Fable 5 e GPT-5.6 Sol. A comparação da Orcarouter acrescenta um 1º lugar no Frontend Code Arena, com 1.679 Elo. O Qwen 3.8 Max não foi indexado de forma independente no lançamento; o rastreador do cheapestinference.com informou 53 como número do índice Artificial Analysis, enquanto posts da comunidade que alegam uma atualização para 56 continuam sem verificação.
O único confronto direto na mesma tarefa, a análise de arquitetura StackPerf da TrilogyAI (documentada pela Orcarouter), deu 83/100 ao K3 contra 80/100 ao Qwen no endpoint de preview. O Qwen registrou 354 citações de repositórios contra 274 do Kimi, 22 requisições ao gateway contra 53 do Kimi e nenhuma chamada de ferramenta com falha, ante duas do Kimi.
Agora, a linha que as tabelas compartilhadas deixam de fora: no próprio card da Qwen, o 27B faz 84,3 no OSWorld-Verified, contra 84,8 do K3. Um modelo denso de 27B fica a menos de meio ponto de um flagship de 2,8T em uso de computador. Ele não está na mesma categoria do K3 em programação — 73,0 contra 88,3 no Terminal-Bench —, mas os 90,3 no LiveCodeBench v6 e 61,7 no SWE-bench Pro o tornam uma ferramenta de trabalho séria. Uma comparação prática no r/AISEOInsider chegou à mesma conclusão dos dados: o Qwen vence mais builds de uma só tentativa, enquanto o Kimi avança à medida que o contexto e a profundidade das revisões aumentam.
Custo de API: a barreira dos US$ 15 na saída e o custo do raciocínio
Os preços de tabela apontam na mesma direção. O gasto real reforça ainda mais isso, porque ambos os modelos raciocinam por padrão — K3 com reasoning_effort: max, Qwen com xhigh — e os tokens de raciocínio são cobrados como saída.
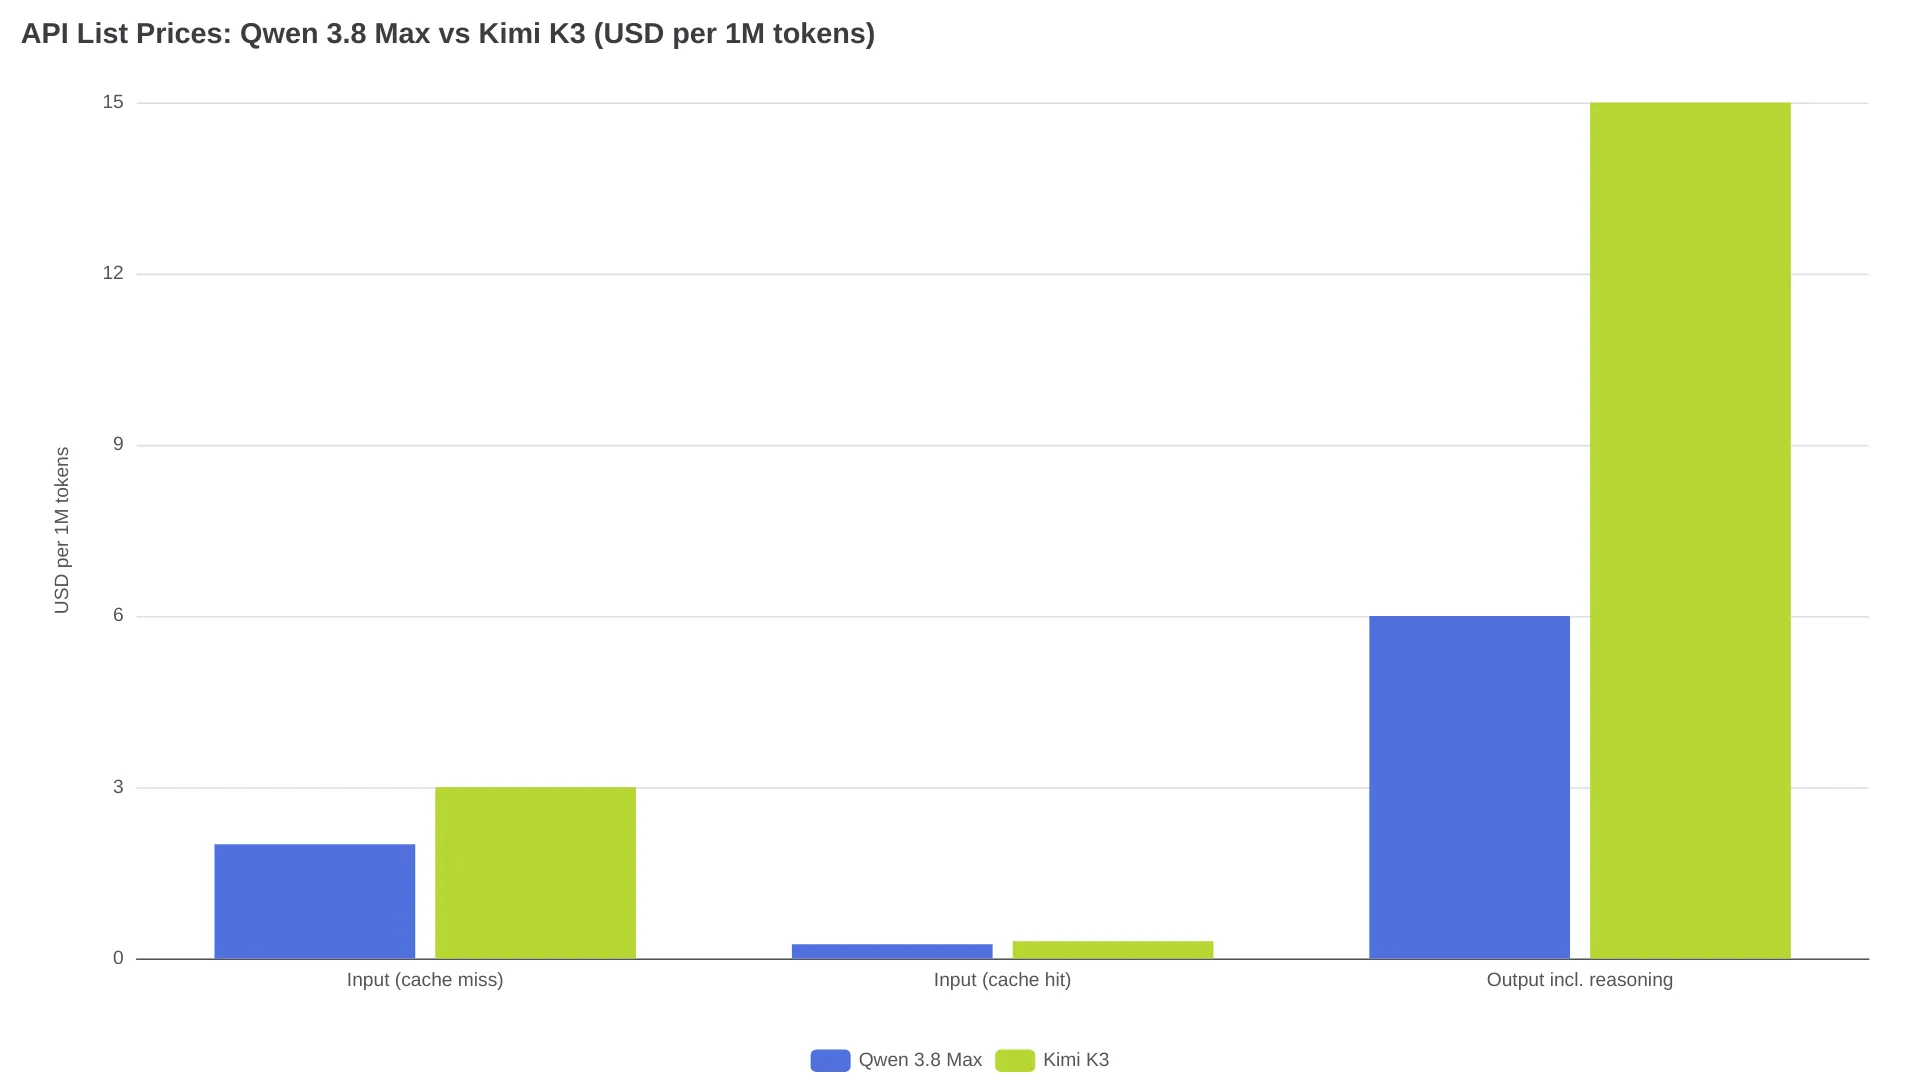
| Por 1M de tokens | Qwen 3.8 Max (QwenCloud) | Kimi K3 (Moonshot) |
|---|---|---|
| Entrada (sem cache) | $2.00 | $3.00 |
| Entrada (com cache) | $0.25 | $0.30 |
| Saída, incluindo raciocínio | $6.00 | $15.00 |
| Criação / leitura explícita de cache | $2.50 / $0.17 | — |
Dois exemplos de sessões, usando os preços de tabela de agosto de 2026:
| Sessão | Qwen 3.8 Max | Kimi K3 | Diferença |
|---|---|---|---|
| Programação agentiva: 500K de entrada (60% em cache), 40K de saída | $0.72 | $1.29 | 1.8× |
| Pipeline de documentos com contexto novo: 2M de entrada, 100K de saída | $4.60 | $7.50 | 1.6× |
Daí sai uma regra simples de roteamento: envie uma tarefa ao K3 apenas quando a taxa de aceitação dele na sua carga de trabalho superar a do Qwen em mais que a diferença de custo por token de ~1,8×. A própria Moonshot oferece a alternativa econômica: Kimi K2.7 Code, por $0.95 de entrada / $4.00 de saída em contexto de 256K. Ou seja, a rota de programação mais barata da família Kimi não é o K3. Se você está roteando para o K3 hoje, o endpoint da API está listado aqui com as tarifas publicadas pela Moonshot; a mecânica detalhada de preços de ambos está nas análises de preços do Qwen3.8-Max e no guia de preços do Kimi K3.
Self-hosting: 1,56 TB contra uma RTX 4090
É aqui que as histórias de pesos abertos dos dois modelos se separam por cerca de duas ordens de grandeza.
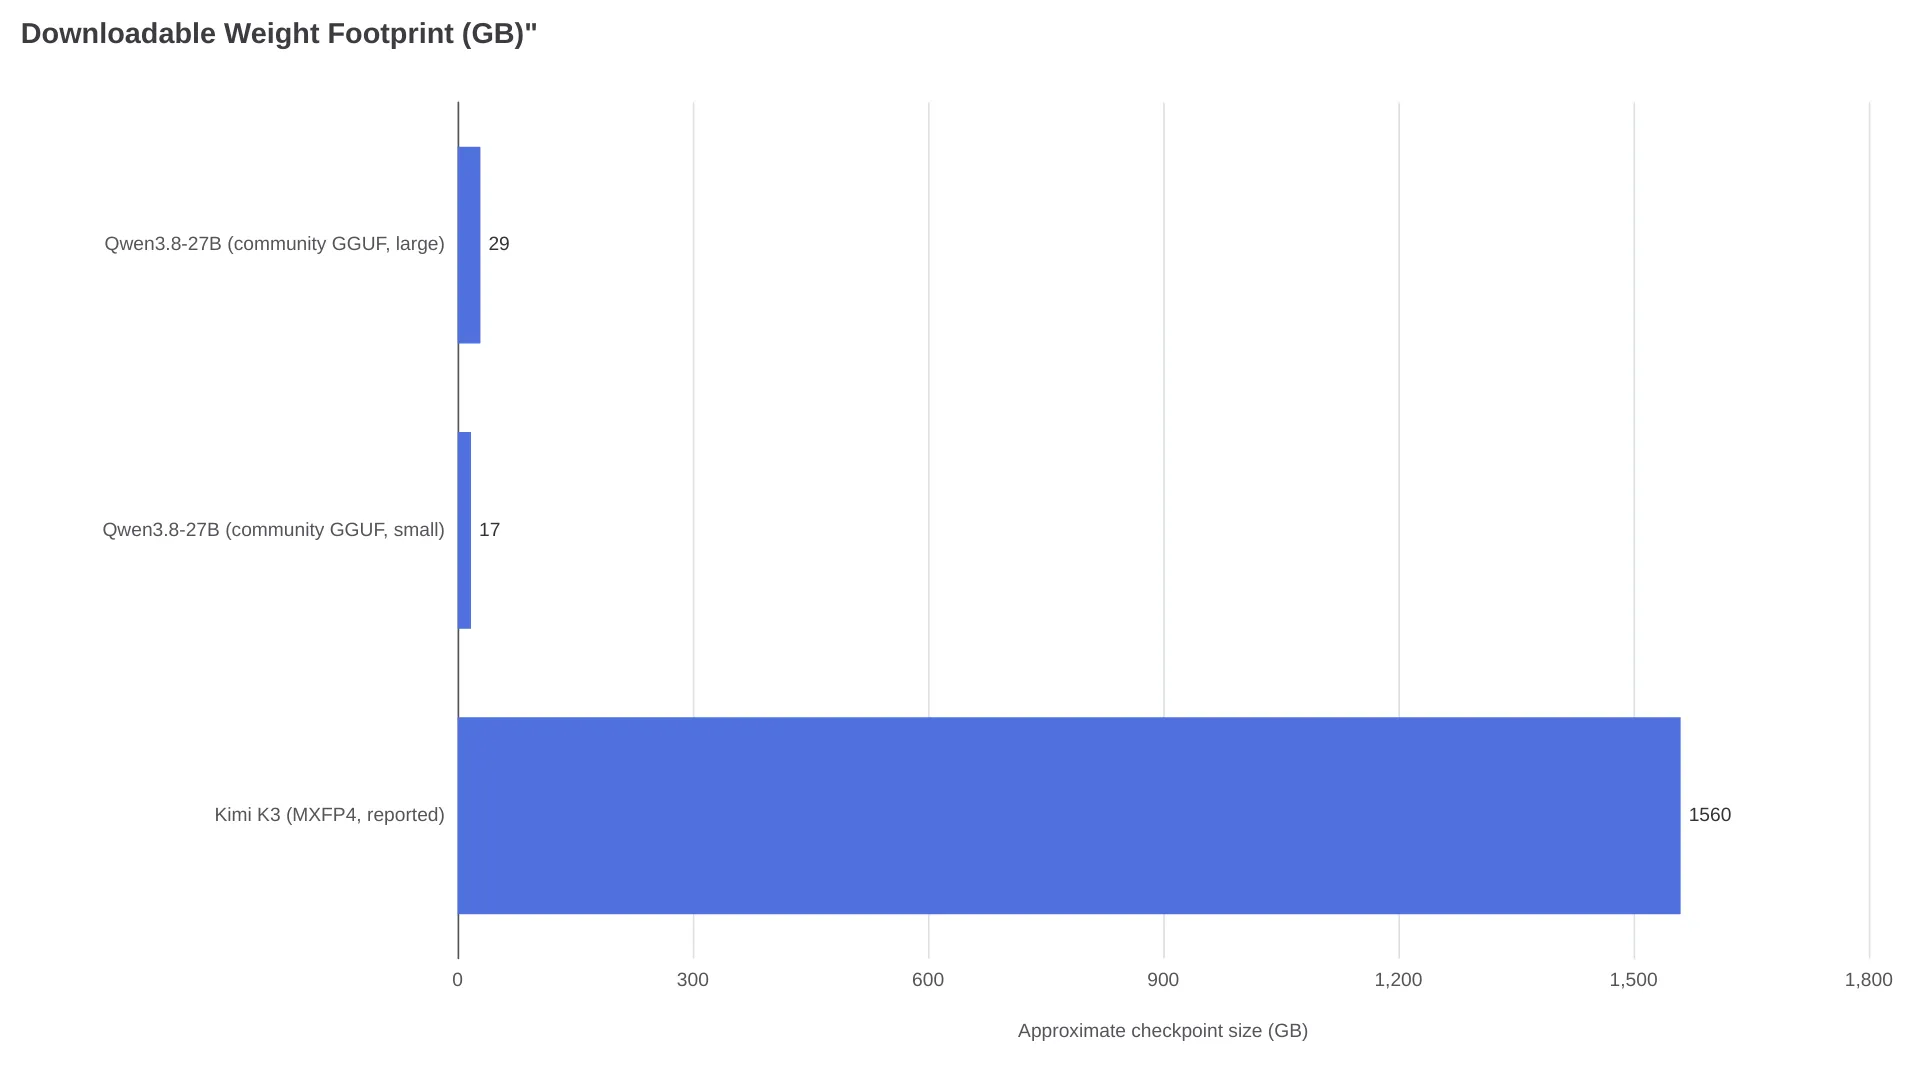
O K3 traz pesos MXFP4 com reconhecimento de quantização (model card), mas um checkpoint relatado em 1,56 TB é projeto para cluster — a mesma fonte recomenda vLLM em 64 ou mais aceleradores. É um custo real, ainda que alugável, antes mesmo de servir um único token, além das condições da licença para uso em larga escala.
Com o 27B, a história é oposta. As builds GGUF da comunidade vão de cerca de 8,5 GB a 28,9 GB; as builds Dynamic GGUF e NVFP4 da Unsloth cabem em aproximadamente 17 GB no mínimo, e há uma variante FP8 oficial para implantação em servidor. Ele roda em hardware que muita gente já tem:
"Qwen3.8-27B com 160K de contexto em uma ÚNICA RTX 4090 — 47–57 tok/s, offload completo para a GPU" — post de implantação no r/Qwen_AI
Os pesos do Max ficam no meio-termo: o Qwen3.8-2.4T-A95B e sua variante FP8 podem ser baixados sob a licença personalizada qwen3.8-max, mas o artefato aberto trabalha apenas com texto e tem raciocínio que não pode ser desativado. Entrada de visão, modo sem raciocínio e contexto padrão de 1M pertencem à camada de API do QwenCloud, não ao checkpoint. Para saber tudo o que o 27B pode e não pode fazer em cada quantização, o guia de campo do Qwen3.8-27B traz tabelas de runtimes e VRAM; o lançamento dos pesos do K3 é detalhado no artigo sobre os pesos abertos do Kimi K3.
Detalhes de integração que definem projetos com agentes
Há três comportamentos no nível do model card que podem custar um dia de depuração se você só descobrir isso em produção.
| Modelo | Comportamento / limite | Consequência na implementação |
|---|---|---|
| Kimi K3 | Raciocínio sempre ligado; clientes multi-turn e de uso de ferramentas precisam reenviar toda a mensagem anterior do assistente, incluindo reasoning_content e tool_calls (card) | Remover o rastro de raciocínio degrada os loops do agente; preservá-lo faz o gasto crescer conforme o loop se alonga |
| Qwen3.8-27B | preserve_thinking vem ativado por padrão; reasoning_effort reduz para medium/low; YaRN acima de 262K usa escalonamento estático (card) | É possível desativar por requisição; o card alerta que menor esforço nem sempre reduz o tempo total, pois as tentativas repetidas consomem a economia; ative YaRN apenas em trabalhos longos |
| Limites do Qwen 3.8 Max vs K3 | Max: 991,8K de entrada / 131,07K de saída (QwenCloud); K3: 1.048.576 de entrada / 131K de saída padrão, subindo em direção a 1M | Nenhum dos dois "contextos de 1M" promete 1M de saída útil; um teste de agulha de terceiros encontrou 18/18 fatos em 248K e não testou além disso |
Perguntas frequentes
Qwen 3.8 é melhor que Kimi K3 para programação?
Pelas evidências disponíveis, não. O Kimi K3 lidera nas linhas mais relevantes de programação agentiva — FrontierSWE 81,2 contra 73,5 e Terminal-Bench 2.1 88,3 contra 86,6 — e tem os únicos resultados de índice independente. O Qwen 3.8 Max fica próximo em trabalho de terminal e custa menos por token e nas sessões modeladas; o 27B pertence a uma classe de pesos completamente diferente.
Qual é mais barato, Qwen 3.8 ou Kimi K3?
O Qwen 3.8 Max vence em todas as linhas de tabela: $2 contra $3 na entrada e $6 contra $15 na saída. Como os dois cobram o raciocínio ativado por padrão como saída, a desvantagem do Kimi aumenta com a dificuldade da tarefa — cerca de 1,8× em uma sessão agentiva com cache na conta acima.
É possível fazer self-hosting? Sob quais licenças?
Sim, os três checkpoints podem ser baixados. O Qwen3.8-27B usa Apache-2.0 e cabe quantizado em uma única GPU de 24 GB; o Kimi K3 exige hardware de escala de cluster para seu checkpoint MXFP4 de ~1,56 TB e usa a licença personalizada Kimi K3 License; os pesos do Qwen3.8-Max são públicos como Qwen3.8-2.4T-A95B, sob a licença personalizada qwen3.8-max.
A janela de contexto de 1M é real nos dois?
Em termos gerais, sim. O Kimi K3 especifica 1.048.576 tokens; o Qwen 3.8 Max lista 1M, com entrada máxima de 991,8K; o 27B tem 262.144 nativos e só chega a 1M via escalonamento YaRN, que sacrifica qualidade em contexto curto. A verificação independente existe apenas até o nível de 248K.
A escolha recomendada — e o que poderia mudá-la
| Seu cenário | Escolha | Motivo |
|---|---|---|
| Agentes de programação via API, qualidade em primeiro lugar | Kimi K3 | FrontierSWE 81,2, Terminal-Bench 88,3, AA-verificado 60 |
| Trabalho via API em que custo importa, com muitos documentos/visão | Qwen 3.8 Max | $6 contra $15 na saída, OSWorld 86,1, cache explícito a $0.17/leitura |
| Self-hosting no hardware que você já possui | Qwen3.8-27B | Apache-2.0, quantizações de ~17–29 GB, contexto de 160K em uma RTX 4090 |
| Self-hosting de um flagship de fronteira | Kimi K3 | O único checkpoint aberto aqui com resultados independentes de nível frontier — reserve orçamento para um cluster |
Duas coisas poderiam alterar partes desta tabela: uma avaliação independente do Qwen 3.8 Max — o 53 relatado por rastreador contra o 60 verificado do K3 se apoia em evidência limitada — e a publicação dos termos da licença personalizada qwen3.8-max. Até que uma delas aconteça, o comparativo direto de API entre Qwen 3.8 Max vs Kimi K3 cobre com mais profundidade o cenário exclusivamente via API.
Leituras relacionadas: Qwen3.8-27B: o que está confirmado e o que 17GB realmente roda · Pesos abertos do Kimi K3 · Qwen 3.8 Max vs Kimi K3: edição API