 AIREITER
Um contexto de 1 milhão de tokens e um endpoint a US$ 0 fazem a API do Nemotron 3 Ultra parecer uma escolha óbvia. Não é bem assim: a rota gratuita serve para avaliação, mas o uso em produção depende da confiabilidade do provedor, do tratamento dos dados e da existência de uma alternativa paga.
A API do Nemotron 3 Ultra vale a pena?
A API do Nemotron 3 Ultra merece ser testada em agentes que executam tarefas longas, análise de documentos extensos e fluxos de programação que se beneficiam de uma janela de contexto muito ampla. Já para chat rotineiro de baixa latência, prompts confidenciais enviados a um endpoint gratuito com registro de uso ou serviços de produção sem fallback, ela não é uma boa escolha padrão.
A NVIDIA lançou o Nemotron 3 Ultra em 4 de junho de 2026. O model card oficial identifica o checkpoint NVFP4 como a versão 1.0 GA, licenciada para uso comercial e não comercial sob a OpenMDW 1.1.
| Fato para decidir | Valor verificado | Por que isso importa |
|---|---|---|
| Tamanho do modelo | 550B no total, 55B ativos | O processamento esparso não torna todos os pesos pequenos |
| Contexto máximo | Até 1M de tokens | Os limites do provedor podem ser menores dependendo da rota |
| Modalidade | Entrada e saída de texto | Não há compreensão de imagens ou vídeos |
| SWE-Bench Verified oficial em NVFP4 | 69.7 | Evidência relevante para avaliar agentes de programação |
| RULER 1M oficial em NVFP4 | 94.0 | Reforça o caso de uso com contexto longo |
| Preço gratuito no OpenRouter | US$ 0 na entrada, US$ 0 na saída | Adequado para testes, não para um SLA |
| Disponibilidade gratuita no OpenRouter | 84.07% de sucesso em três dias | Estar acessível nem sempre significou estar utilizável |
| Mínimo oficial para self-hosting | 4x B200-class ou 8x H100 | Não é uma implantação comum em workstation |
Os resultados de benchmark acima vêm do model card da NVIDIA e devem ser considerados resultados de primeira parte. A disponibilidade do OpenRouter é uma medição dinâmica do provedor, não uma garantia permanente.
Chame a API gratuita do Nemotron 3 Ultra em cinco minutos
A maneira mais rápida de testar gratuitamente usa o endpoint de chat completions compatível com a API da OpenAI no OpenRouter, junto do model ID exato nvidia/nemotron-3-ultra-550b-a55b:free. Crie uma chave no OpenRouter, mantenha-a em uma variável de ambiente e faça um teste pequeno antes de tentar uma tarefa com contexto longo.
- Crie uma chave de API no OpenRouter.
- Exporte-a como
OPENROUTER_API_KEY. - Chame
/api/v1/chat/completionsusando o model ID gratuito. - Registre o status HTTP, a latência e as respostas vazias durante a avaliação.
- Adicione uma rota paga ou outro modelo antes de levar o fluxo para produção.
curl https://openrouter.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nvidia/nemotron-3-ultra-550b-a55b:free",
    "messages": [
      {
        "role": "user",
        "content": "Return three risks in this migration plan as a numbered list."
      }
    ],
    "max_tokens": 500
  }'
A mesma rota funciona com o cliente Python da OpenAI: basta alterar base_url e model:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["OPENROUTER_API_KEY"],
    base_url="https://openrouter.ai/api/v1",
)

response = client.chat.completions.create(
    model="nvidia/nemotron-3-ultra-550b-a55b:free",
    messages=[
        {
            "role": "user",
            "content": "Inspect this plan and list the three highest-impact risks.",
        }
    ],
    max_tokens=500,
)

print(response.choices[0].message.content)
O que a rota gratuita realmente oferece
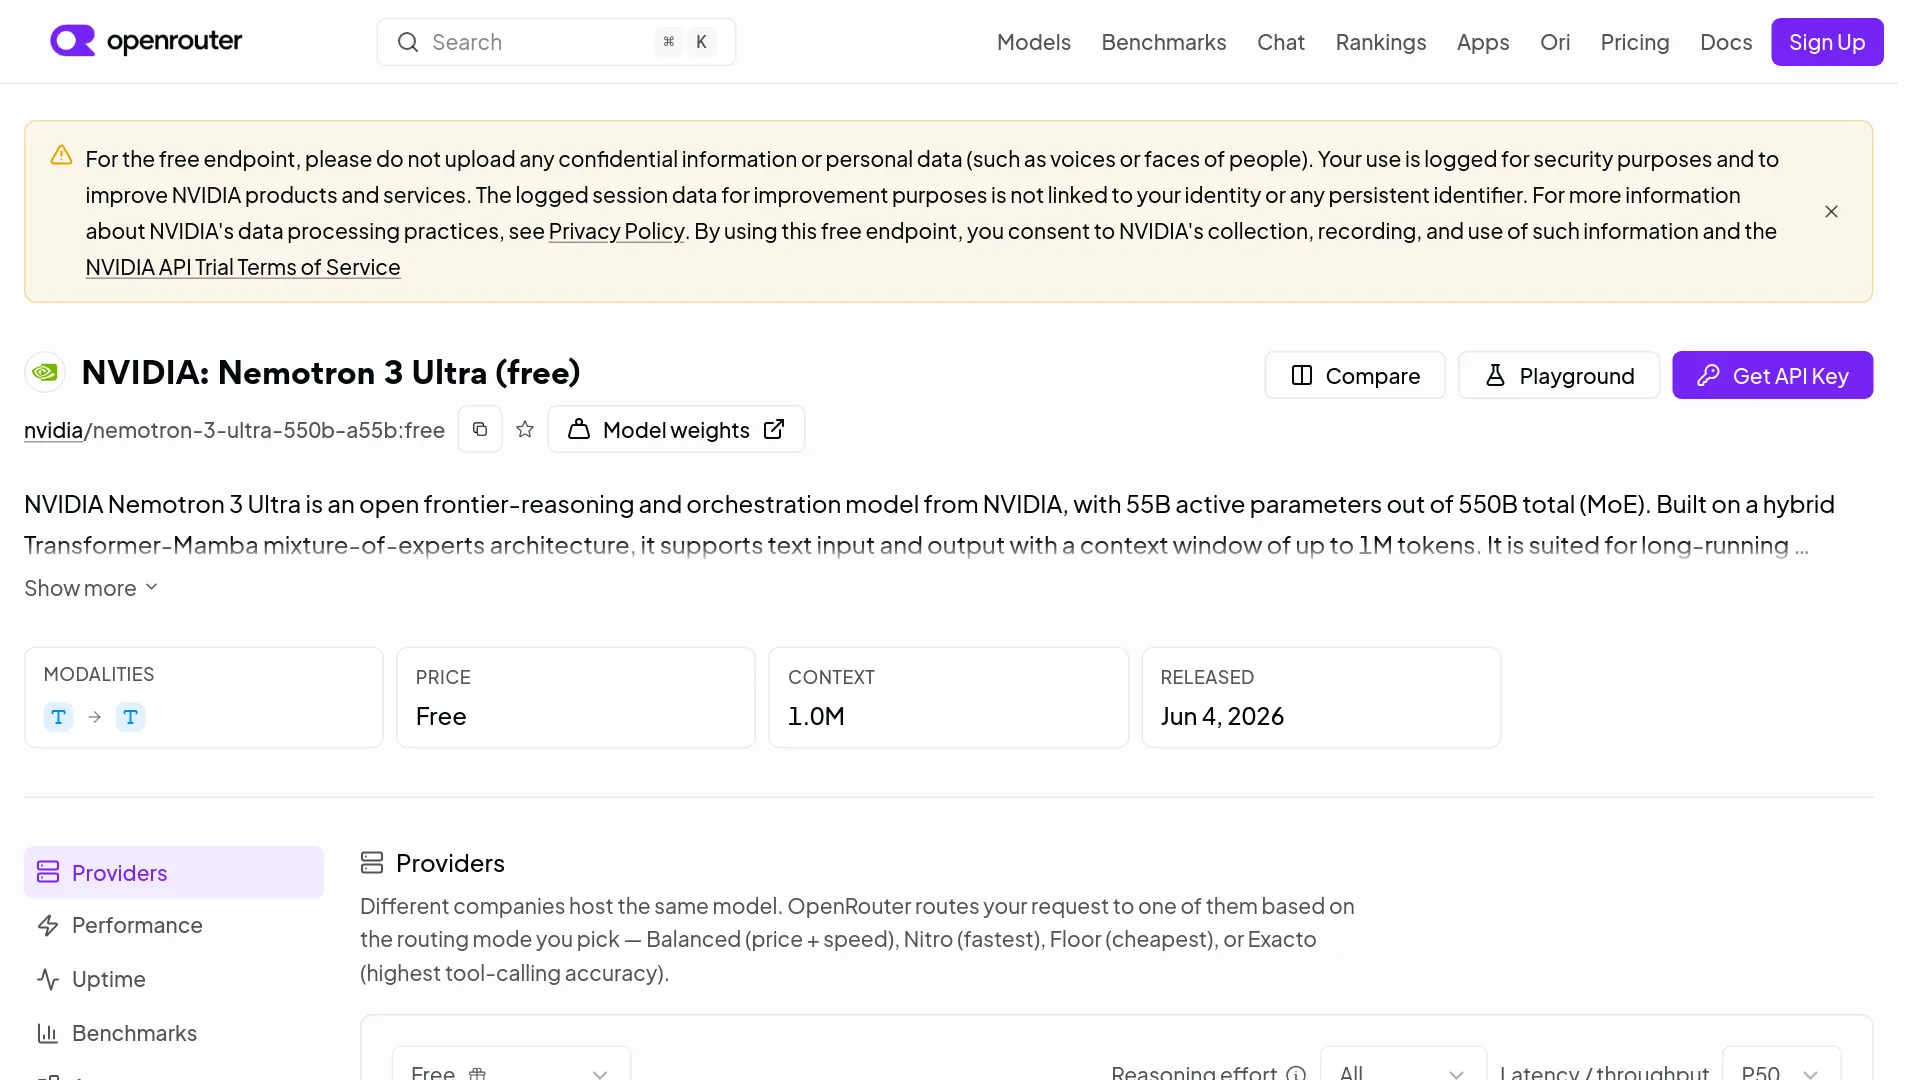
A rota gratuita do Nemotron 3 Ultra não garante capacidade ilimitada nem disponibilidade para produção. O anúncio no OpenRouter identifica os endpoints gratuitos como sujeitos a limites de uso, mas não publica uma cota exata na página do modelo. No snapshot de 19 de setembro, a alcançabilidade era de 100%, mas a disponibilidade bem-sucedida ficou em apenas 84.07% ao longo de três dias; erros e respostas vazias foram contabilizados como falhas.
Naquele snapshot, o OpenRouter exibia contexto de 1M de tokens, conclusão máxima de 65.536 tokens, chamadas de ferramentas, latência mediana de 2,28 segundos e throughput mediano de 29 tokens por segundo.
Também existe uma diferença de recursos específica do provedor: a listagem gratuita do OpenRouter aceitava tools e tool_choice, mas não aplicava response_format. A rota paga da Segmind documenta saída em JSON Schema a US$ 0,625 por milhão de tokens de entrada e US$ 2,75 por milhão de tokens de saída. Código que depende de JSON estrito precisa ser testado no provedor escolhido, em vez de presumir suporte com base apenas no modelo.
Não envie dados confidenciais ou pessoais pela rota gratuita do OpenRouter. A listagem informa que o uso é registrado por motivos de segurança e pode ser usado para melhorar produtos e serviços da NVIDIA. Em caso de 429, timeout ou resposta vazia, use exponential backoff limitado e depois faça failover para uma rota paga; não repita indefinidamente uma ação de agente.
O que o 550B-A55B muda na prática
A identificação 550B-A55B significa que o Nemotron 3 Ultra armazena 550 bilhões de parâmetros no total, mas ativa cerca de 55 bilhões para cada token. A NVIDIA combina roteamento LatentMoE, Mamba-2, camadas de atenção selecionadas e Multi-Token Prediction. A ativação esparsa reduz o processamento por token, mas todos os pesos ainda precisam ser armazenados, distribuídos ou enviados para offload; A55B não transforma o modelo em uma implantação de 55B.
O lançamento da pesquisa da NVIDIA informa até 1M de tokens de contexto e compara o throughput em uma carga incomum, com entrada de 8.000 tokens e saída de 64.000 tokens. A NVIDIA afirma que o modelo alcança 5,9x o throughput do GLM-5.1-754B-A40B, 4,8x o do Kimi-K2.6-1T-A32B e 1,6x o do Qwen-3.5-397B-17B. A página não informa o throughput absoluto nem os detalhes do hardware; por isso, esses multiplicadores não devem ser convertidos diretamente em expectativas de latência da API.
A tabela oficial em BF16/NVFP4 é mais útil para decidir a implantação:
| Benchmark | BF16 | NVFP4 | Leitura prática |
|---|---|---|---|
| SWE-Bench Verified | 71.9 | 69.7 | A quantização custa 2,2 pontos nesse teste de programação |
| Terminal Bench 2.1 | 56.4 | 53.9 | O trabalho agentivo em terminal também cai |
| TauBench V3, média | 70.9 | 70.3 | A média de uso de ferramentas permanece próxima |
| GPQA, sem ferramentas | 87.0 | 87.9 | O NVFP4 não é uniformemente mais fraco |
| RULER 1M | 94.7 | 94.0 | A recuperação em contexto longo continua próxima |
| OmniScience, não alucinação | 78.7 | 75.5 | As verificações de factualidade continuam importantes |
O impacto depende da tarefa: o NVFP4 perde 3,2 pontos em não alucinação, mas ganha 0,9 ponto no GPQA.
Escolha pela tarefa, não pela contagem de parâmetros
O Nemotron 3 Ultra deve ser comparado com DeepSeek V4, GLM 5.2 e Qwen 3.8 Max usando a carga de trabalho que realmente chegará à produção, não o tamanho do modelo. Nenhum resultado obtido no mesmo harness para este guia sustenta a existência de um vencedor universal. A comparação mais defensável é um plano de testes com limites verificados.
| Tarefa | Comece com | Evidência e teste antes de escolher |
|---|---|---|
| Recuperação ou síntese de documentos com 1 milhão de tokens | Nemotron 3 Ultra | O RULER 1M oficial em NVFP4 é 94.0; teste a precisão da recuperação e a latência de prefill no tamanho real do prompt |
| Agente de programação com execução prolongada | Nemotron 3 Ultra ou DeepSeek V4 | O Nemotron marca 69.7 no SWE-Bench Verified e 53.9 no Terminal Bench 2.1; compare o sucesso em tarefas de repositório e a validade das chamadas de ferramentas em um único harness |
| Automação com saída estruturada | GLM 5.2, Qwen 3.8 Max ou um provedor do Nemotron com suporte a schema | O OpenRouter gratuito não aplica response_format; meça a aderência ao schema e as tentativas extras na rota exata |
| Solicitações curtas em alto volume | DeepSeek V4, GLM 5.2 ou Qwen 3.8 Max | Compare o custo por tarefa concluída e a latência p95; a escala do Ultra não é automaticamente vantajosa |
| Implantação de pesos abertos em hardware NVIDIA | Nemotron 3 Ultra | Compare BF16 e NVFP4 na tarefa-alvo e depois calcule a utilização sustentada |
DeepSeek V4 e GLM 5.2 têm superfícies de API dedicadas na AIReiter, enquanto o Qwen 3.8 Max está disponível como modelo de chat hospedado: guia da API do DeepSeek V4 Pro, análise da API do GLM 5.2 e preços da API do Qwen 3.8 Max. São alternativas de avaliação, não uma afirmação de que algum desses modelos vence em todas as tarefas.
Dá para rodar o Nemotron 3 Ultra localmente?
É possível fazer self-hosting do Nemotron 3 Ultra, mas “local” aqui significa hardware de data center ou uma DGX Station, não um notebook. A NVIDIA lista 4x GB200, 4x B200, 4x GB300, 4x B300 ou 8x H100 como configurações mínimas para o caminho de implantação normal.
Os exemplos oficiais com vLLM no model card da NVIDIA usam paralelismo tensorial e de especialistas em 4 vias, cache KV em FP8, prefill em blocos e decodificação especulativa com MTP. Um exemplo padrão usa 262.144 tokens; para habilitar 1.048.576 tokens, é necessário fazer um override explícito. Portanto, o contexto anunciado não é a configuração padrão de serving.
A NVIDIA também documenta uma implantação especial em uma única DGX Station. Ela executa o checkpoint NVFP4 em uma GPU GB300 integrada, disponibilizando até 150 GiB de memória coerente de CPU e fazendo offload dos pesos dos especialistas. Essa receita exige vLLM 0.22.0, o backend NVFP4 específico para Blackwell e a arquitetura de memória da DGX Station; ela não se aplica a um PC comum com uma única GPU.
| Implantação | Escolha quando | Principal limitação |
|---|---|---|
| API gratuita do OpenRouter | Você está avaliando prompts e comportamento de ferramentas | Limites de uso, registro de dados e disponibilidade variável |
| API hospedada paga | Você precisa colocar o serviço no ar antes que o uso justifique o hardware | Diferenças de preço, precisão, contexto e recursos entre provedores |
| Self-hosting em 4x B200-class / 8x H100 | Volume sustentado, controle dos dados ou customização do modelo são importantes | Custo de capital e operação de inferência distribuída |
| DGX Station GB300 única com offload | Você possui exatamente esse sistema de memória coerente | Latência do offload e dependência de um hardware específico |
FAQ da API do Nemotron 3 Ultra
A API do Nemotron 3 Ultra é gratuita?
Sim. O OpenRouter lista nvidia/nemotron-3-ultra-550b-a55b:free a US$ 0 para tokens de entrada e de saída, mas o endpoint tem limite de uso e registra as solicitações.
O Nemotron 3 Ultra realmente suporta 1 milhão de tokens?
A NVIDIA especifica um máximo de 1M de tokens, mas as rotas dos provedores podem expor padrões menores; o exemplo da NVIDIA com vLLM usa 262.144 tokens por padrão, a menos que o operador habilite 1.048.576.
A API oferece suporte a ferramentas e JSON estruturado?
O modelo oferece suporte a ferramentas, mas a aplicação depende do provedor: a rota gratuita do OpenRouter não aplica response_format, enquanto a Segmind documenta JSON Schema estrito.
Posso usar o Nemotron 3 Ultra comercialmente?
A NVIDIA afirma que a versão sob a OpenMDW 1.1 permite uso comercial e não comercial. Consulte os termos da licença vinculados no model card oficial para conhecer as obrigações de redistribuição e implantação.
Posso desativar o raciocínio?
A documentação da API da NVIDIA expõe enable_thinking=True/False. Os provedores hospedados podem mapear esse controle de outra forma; confirme o parâmetro aceito e a contabilização de tokens na rota escolhida.
550B A55B equivale a um modelo denso de 55B?
Não. Cerca de 55B de parâmetros são ativados por token, mas todos os 550B ainda precisam ser armazenados, distribuídos ou enviados para offload.
Uma decisão de implantação, não um troféu de benchmark
O melhor primeiro passo é usar a API gratuita do Nemotron 3 Ultra com prompts não sensíveis e um conjunto pequeno de avaliação. Mude para um endpoint pago quando falhas, aplicação de schema ou capacidade previsível começarem a importar; faça self-hosting apenas quando a utilização medida, a privacidade ou a customização justificarem pelo menos quatro GPUs atuais de alta memória ou o caminho documentado da DGX Station.
| Seu resultado após os testes | Próxima ação |
|---|---|
| A qualidade é boa, mas as chamadas gratuitas falham ou ficam em fila | Adicione uma rota paga do Nemotron e uma política de retry |
| A recuperação em contexto longo é o diferencial | Teste o maior documento real e meça o tempo de prefill |
| As falhas de JSON são predominantes | Use um provedor com aplicação de schema ou compare as rotas do GLM/Qwen |
| Custo ou latência em tarefas curtas são o fator principal | Prefira um modelo menor e reserve o Ultra para escalonamentos |
| Os dados não podem sair da sua rede | Inclua no orçamento a implantação oficial com múltiplas GPUs antes de se comprometer |