 AIREITER
O DeepSeek V4 Pro GA foi lançado oficialmente em 13 de agosto de 2026 com resultados completos de benchmarks, pesos abertos sob licença MIT e três níveis de esforço de raciocínio. Para quem usa a API, o ponto mais importante está na página oficial de preços: a cobrança por horário de pico e fora de pico começa em 16 de agosto de 2026, às 16:00 UTC. O custo de tokens de saída do V4 Pro passa de US$ 0,87 para US$ 1,98 por milhão fora do pico ou US$ 3,96 no pico.
O que chega no V4-Pro-0813
O alias de API deepseek-v4-pro agora aponta para o DeepSeek-V4-Pro-0813, disponível no app, na web e na API da DeepSeek. No anúncio de 13 de agosto, a empresa destacou "recursos de Agent significativamente aprimorados" em comparação com o build de prévia de 24 de abril.
Arquitetura e especificações:
| Item | DeepSeek-V4-Pro-0813 |
|---|---|
| Tamanho publicado do modelo | 1,7T de parâmetros (model card; a prévia tinha 1,6T) |
| Janela de contexto | 1 milhão de tokens |
| Saída máxima | 384K tokens |
| Modos de pensamento | Sem pensamento e com pensamento (com pensamento é o padrão) |
| Níveis de esforço de raciocínio | low, high, max |
| Novo módulo de decodificação | Decodificação especulativa DSpark (7 tokens especulativos) |
| Compatibilidade de API | OpenAI ChatCompletions, Responses API, Anthropic API, Codex |
| Limite de concorrência | 500 |
| Licença | MIT |
O model card recomenda temperature = 1.0 e top_p = 0.95 para cenários agênticos. Nos níveis de esforço high e max, a saída pode chegar a 384K tokens.
Benchmarks oficiais do GA
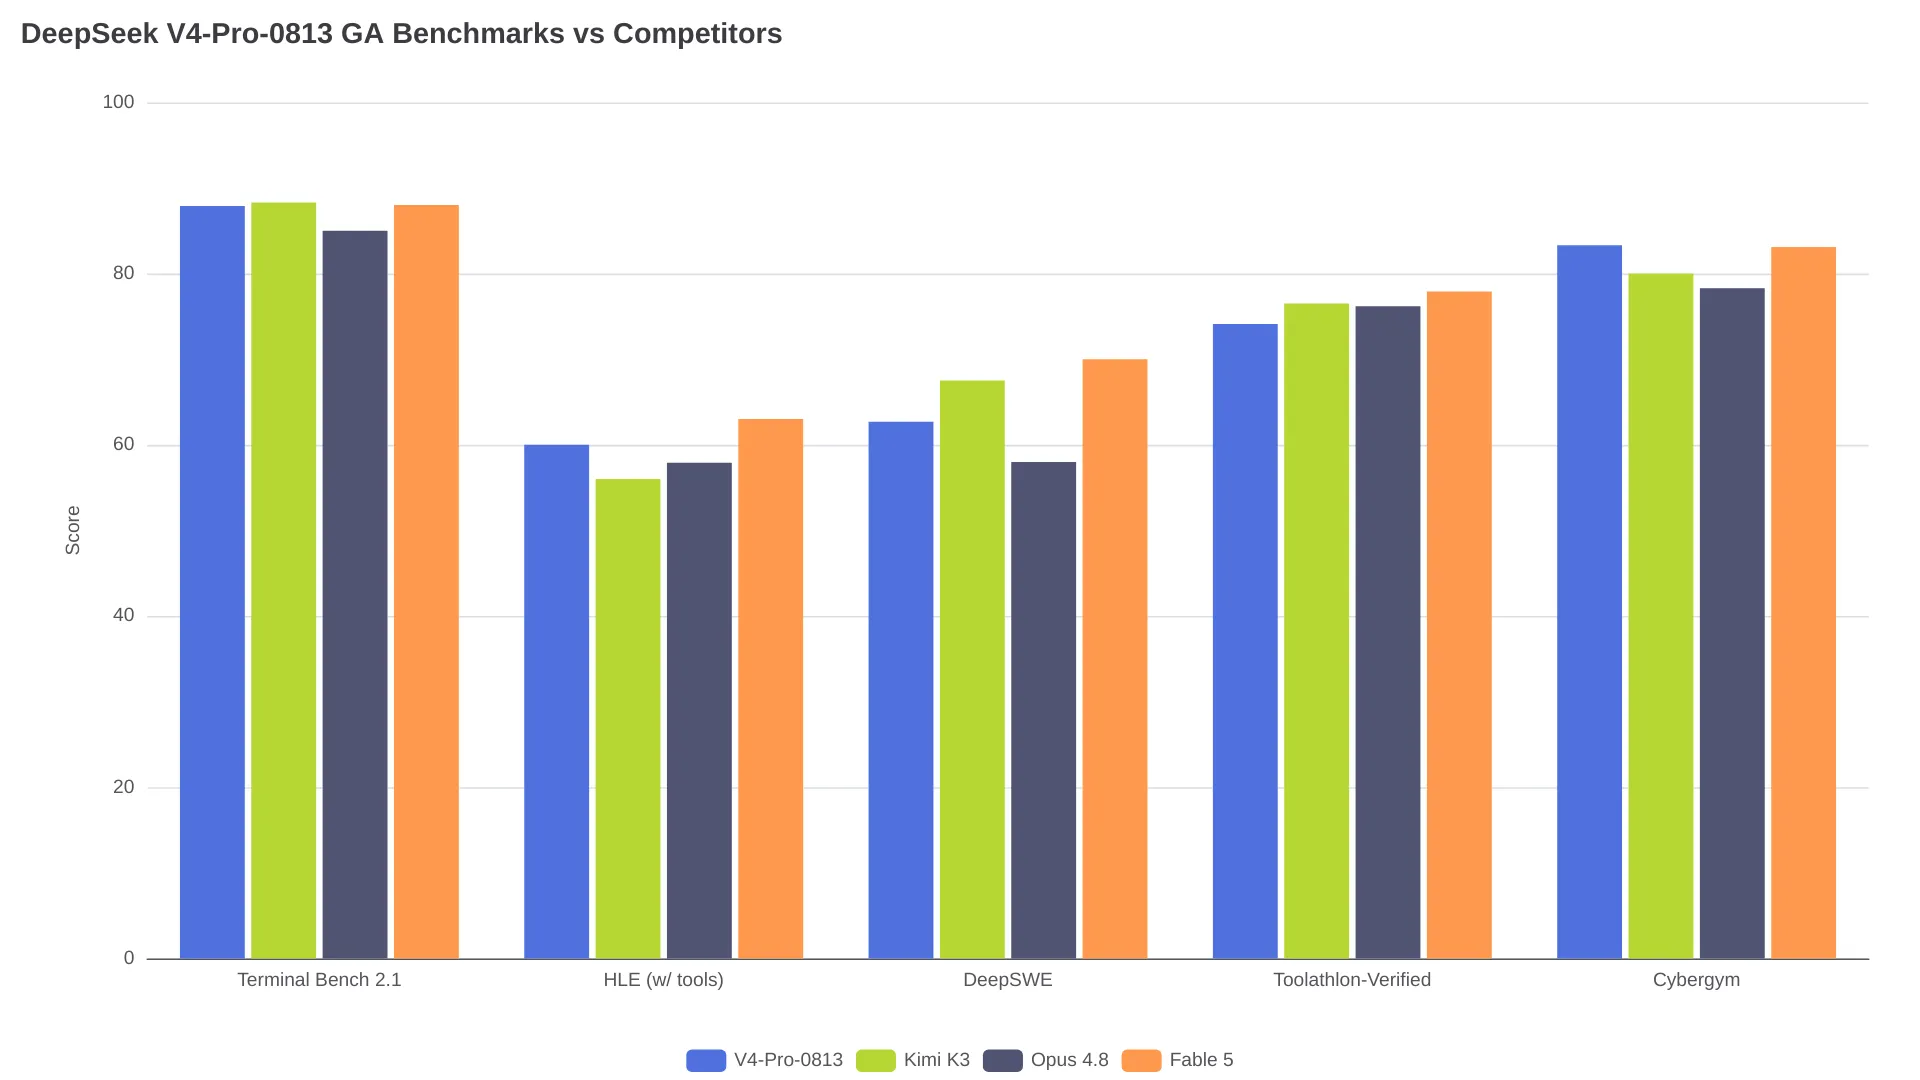
A DeepSeek publicou dez comparativos de benchmark no model card. As tarefas de agentes de código foram executadas no modo mínimo do DeepSeek Harness, com esforço de raciocínio max. As duas últimas linhas, DSBench, correspondem a conjuntos de testes internos da DeepSeek. Todas as pontuações abaixo vêm desse model card.
| Benchmark | Pro-0813 | Flash-0731 | Pro Preview | Kimi K3 | Opus 4.8 | Fable 5 |
|---|---|---|---|---|---|---|
| HLE (sem ferramentas / com ferramentas) | 42.7 / 60.0 | 37.8 / 51.5 | 37.7 / 48.2 | 43.5 / 56.0 | 49.8 / 57.9 | 53.3 / 63.0 |
| Terminal Bench 2.1 | 87.9 | 82.7 | 72.1 | 88.3 | 85.0 | 88.0 |
| DeepSWE | 62.7 | 54.4 | 12.8 | 67.5 | 58.0 | 70.0 |
| Toolathlon-Verified | 74.1 | 70.3 | 55.9 | 76.5 | 76.2 | 77.9 |
| Cybergym | 83.3 | 76.7 | 52.7 | 80.0 | 78.3 | 83.1 |
| NL2Repo | 61.5 | 54.2 | 38.5 | — | 69.7 | — |
| Agents' Last Exam | 25.7 | 25.2 | 16.5 | 27.6 | 25.7 | — |
| AutomationBench (público) | 31.8 | 25.1 | 12.8 | 30.8 | 27.2 | 29.1 |
| DSBench-FullStack (interno) | 71.1 | 68.7 | 41.8 | 73.7 | 71.6 | 77.2 |
| DSBench-Hard (interno) | 67.2 | 59.6 | 31.1 | 63.0 | 71.7 | 68.3 |
O salto do GA sobre a prévia é expressivo: o DeepSWE foi de 12.8 para 62.7, enquanto o AutomationBench passou de 12.8 para 31.8. Contra os concorrentes, o Pro-0813 lidera no HLE com ferramentas, com 60.0, à frente dos 56.0 do Kimi K3 e dos 57.9 do Opus 4.8. Por outro lado, fica atrás de Kimi K3 e Fable 5 em DeepSWE, Terminal Bench e Toolathlon-Verified. As duas linhas de DSBench são internas do fornecedor e não devem ter o mesmo peso de benchmarks mantidos de forma independente.
Pesos abertos
Os pesos da versão 0813 já estão no Hugging Face sob licença MIT, com caminhos de implantação via vLLM e SGLang. O model card traz um exemplo de serving com vLLM usando decodificação especulativa DSpark, cache KV FP8 e um único nó 4x GB300.
"Amplamente competitivo com os mais fortes modelos proprietários disponíveis." — model card do DeepSeek V4-Pro, Hugging Face
Preços da API: antes e depois de 16 de agosto
A página de preços mostra tanto uma tarifa fixa atual quanto uma tarifa programada para horários de pico e fora de pico, válida a partir de 16 de agosto de 2026, às 16:00 UTC. Os períodos de pico são 01:00–04:00 UTC e 06:00–10:00 UTC, equivalentes a 09:00–12:00 e 14:00–18:00 em Pequim. Todos os demais horários são fora de pico. A tarifa fora de pico é exatamente metade da tarifa de pico.
DeepSeek V4 Pro (DeepSeek-V4-Pro-0813)
| Categoria de cobrança | Tarifa fixa atual | Fora de pico (16 ago.) | Pico (16 ago.) | Variação no pico |
|---|---|---|---|---|
| Entrada, acerto de cache | US$ 0.003625/M | US$ 0.022/M | US$ 0.044/M | +1,114% |
| Entrada, sem acerto de cache | US$ 0.435/M | US$ 0.66/M | US$ 1.32/M | +203% |
| Saída | US$ 0.87/M | US$ 1.98/M | US$ 3.96/M | +355% |
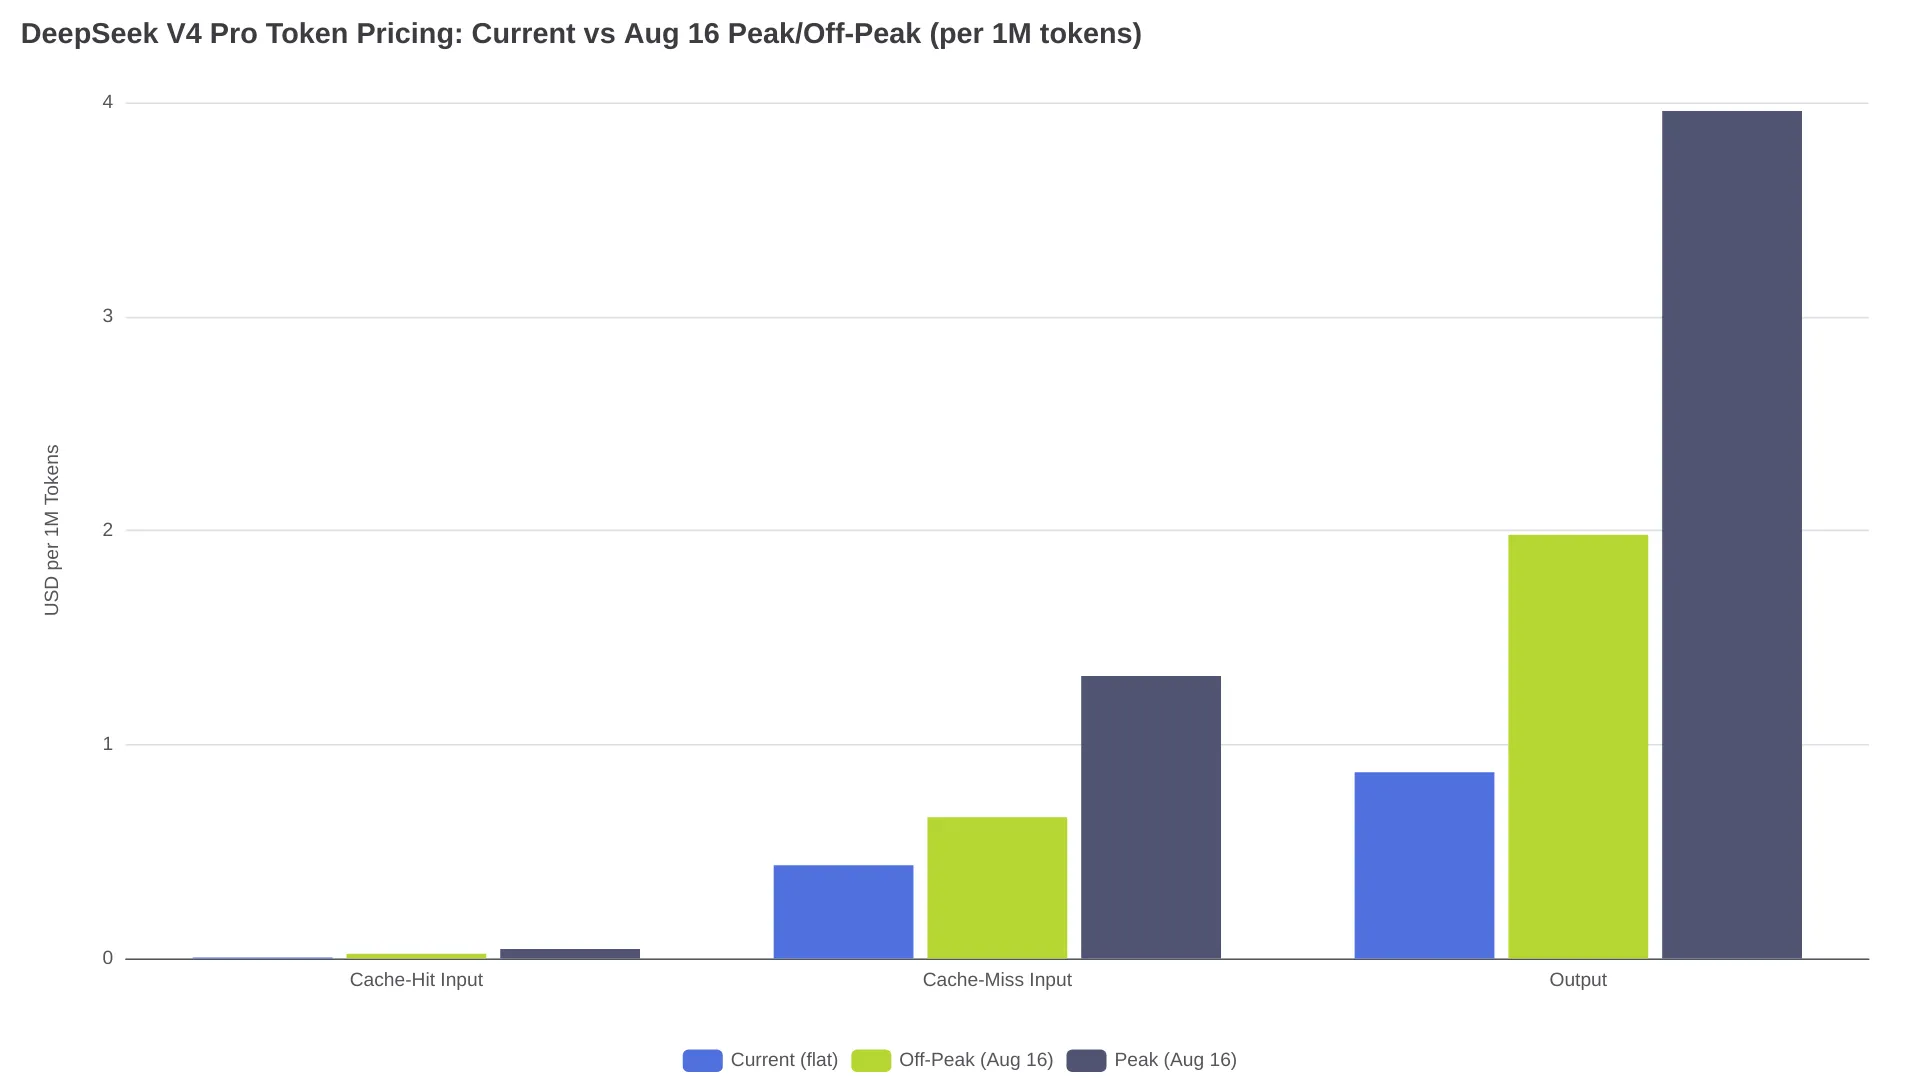
O preço de saída no pico aumenta 4.6x. Para fluxos de agentes em produção, a mudança no acerto de cache tende a ser ainda mais impactante: a tarifa anterior de US$ 0.003625/M era cerca de 120x menor que a de entrada sem cache. Depois de 16 de agosto, essa relação cai para 30x nas duas faixas, 0.022 contra 0.66 fora do pico e 0.044 contra 1.32 no pico, enquanto o custo absoluto de acerto de cache sobe de 6x a 12x.
DeepSeek V4 Flash (DeepSeek-V4-Flash-0731)
| Categoria de cobrança | Tarifa fixa atual | Fora de pico (16 ago.) | Pico (16 ago.) | Variação no pico |
|---|---|---|---|---|
| Entrada, acerto de cache | US$ 0.0028/M | US$ 0.007/M | US$ 0.014/M | +400% |
| Entrada, sem acerto de cache | US$ 0.14/M | US$ 0.22/M | US$ 0.44/M | +214% |
| Saída | US$ 0.28/M | US$ 0.66/M | US$ 1.32/M | +371% |
Limite de concorrência: 2,500 requisições simultâneas, cinco vezes a capacidade destinada ao Pro.
Horários de pico em cada fuso
| Fuso horário | Janela de pico 1 | Janela de pico 2 |
|---|---|---|
| Pequim (UTC+8) | 09:00–12:00 | 14:00–18:00 |
| Londres (UTC+1) | 02:00–05:00 | 07:00–11:00 |
| Nova York (UTC-4) | 21:00–00:00 (dia anterior) | 02:00–06:00 |
| São Francisco (UTC-7) | 18:00–21:00 | 23:00–03:00 |
Para equipes nos Estados Unidos, as janelas de pico caem em grande parte à noite e durante a madrugada. Na China e no Leste Asiático, elas coincidem com o horário comercial convencional.
Simulação: V4 Pro com 10.000 chamadas por dia
Considere um agente em produção que envie, a cada chamada, um prefixo em cache de 50K tokens e gere uma resposta de 2K tokens.
| Componente de custo | Tarifa fixa atual | Fora de pico | Pico |
|---|---|---|---|
| Entrada com acerto de cache (500M tokens) | US$ 1.81 | US$ 11.00 | US$ 22.00 |
| Saída (20M tokens) | US$ 17.40 | US$ 39.60 | US$ 79.20 |
| Total diário | US$ 19.21 | US$ 50.60 | US$ 101.20 |
| Total em 30 dias | US$ 576 | US$ 1,518 | US$ 3,036 |
Cargas reais combinam chamadas em horários de pico e fora de pico, portanto o custo final fica entre esses limites. No Flash, a mesma carga custa US$ 7.00/dia nas tarifas fixas atuais, cerca de US$ 16.70/dia fora do pico e US$ 33.40/dia no pico. O pico do Flash, US$ 33.40/dia, supera a tarifa fixa atual do Pro, de US$ 19.21/dia, mas o Flash fora do pico, a US$ 16.70/dia, fica abaixo dela.
Migração: IDs de modelo, controle de raciocínio e fixação de versão
Endpoints desativados e IDs substitutos
O anúncio da prévia de 24 de abril informou que deepseek-chat e deepseek-reasoner seriam "totalmente desativados e inacessíveis após 24 de julho de 2026, 15:59 (UTC Time)". Códigos que fazem referência a essas strings precisam ser atualizados.
| Endpoint antigo | Modelo para o qual roteava | Substituição |
|---|---|---|
deepseek-chat | V4 Flash, sem pensamento | deepseek-v4-flash |
deepseek-reasoner | V4 Flash, com pensamento | deepseek-v4-flash (com pensamento) ou deepseek-v4-pro |
Muitas equipes presumiam que deepseek-reasoner oferecia raciocínio de nível Pro. Na prática, ele roteava para o Flash no modo com pensamento. A migração para deepseek-v4-pro traz uma qualidade de saída diferente e uma fatura maior.
// Before (retired — fails)
{"model": "deepseek-reasoner", "messages": [...]}

// After
{"model": "deepseek-v4-pro", "messages": [...]}
A URL-base continua sendo https://api.deepseek.com. Nenhuma outra estrutura da requisição muda.
Níveis de esforço de raciocínio
O V4-Pro-0813 introduz três níveis de esforço de raciocínio: low para tarefas simples, high para o trabalho cotidiano com agentes e max para problemas complexos. O modo com pensamento vem ativado por padrão, e os tokens de pensamento entram na cobrança de saída. Um prompt que gere 3,000 tokens de pensamento antes de produzir uma resposta de 200 tokens será cobrado por 3,200 tokens de saída no preço de pico: US$ 0.0127 por chamada, contra US$ 0.0008 apenas pela resposta. O nível low é indicado pela DeepSeek para tarefas simples, nas quais o pensamento prolongado adiciona custo sem trazer valor.
Fixação de versão
O alias deepseek-v4-pro aponta para o build atual e pode mudar quando a DeepSeek lançar versões futuras. Para obter comportamento reproduzível em produção, verifique se seu provedor aceita identificadores de modelo com data. Alguns gateways de terceiros oferecem rotas fixadas em versão; antes de depender delas em produção, confira na documentação do provedor qual build cada rota atende.
Compatibilidade de protocolos de API
Os dois modelos aceitam os formatos OpenAI ChatCompletions e Anthropic API. O endpoint Anthropic é https://api.deepseek.com/anthropic. A compatibilidade com Responses API e Codex é nova no build GA. Se surgirem erros após a migração, teste os dois caminhos de protocolo.
Pro ou Flash: qual escolher após o aumento?
O V4-Pro-0813 supera o V4-Flash-0731 nas dez métricas publicadas. A distância, porém, varia conforme a complexidade da tarefa:
| Benchmark | Pro 0813 | Flash 0731 | Diferença |
|---|---|---|---|
| Terminal Bench 2.1 | 87.9 | 82.7 | 5.2 pts |
| DeepSWE | 62.7 | 54.4 | 8.3 pts |
| AutomationBench | 31.8 | 25.1 | 6.7 pts |
| Cybergym | 83.3 | 76.7 | 6.6 pts |
Escolha o V4 Pro se:
- Seu loop de agente envia repetidamente um prefixo grande e estável. A economia por acerto de cache continua válida, ainda que sobre uma base mais cara
- Você precisa da maior quantidade de parâmetros do Pro para raciocínio complexo, uso de ferramentas em múltiplas etapas ou geração de código em larga escala
- Sua carga de trabalho comporta o limite de 500 requisições simultâneas
Escolha o V4 Flash se:
- Suas tarefas são simples, de alto volume ou sensíveis à latência
- Você precisa do limite de 2,500 requisições simultâneas para cargas com fan-out
- A diferença de qualidade não justifica um preço de saída 3x maior
Para uma análise mais ampla, veja nosso comparativo DeepSeek V4 Flash vs Pro. Para testar os modelos sem gerenciar chaves de API, as páginas de chat do V4 Pro e do V4 Flash oferecem acesso imediato.
Perguntas frequentes
Os pesos do V4-Pro-0813 estão disponíveis para self-hosting?
Sim. Eles têm licença MIT e estão disponíveis no Hugging Face, com caminhos para vLLM e SGLang. Consulte a seção sobre pesos abertos acima para os detalhes de implantação.
Vale migrar do V4 Flash para o V4 Pro no GA?
Para a maioria das cargas de trabalho sensíveis a custo, o Flash continua oferecendo melhor custo-benefício. Nos benchmarks, ele fica atrás do Pro por margens que vão de 0.5 ponto, no Agents' Last Exam, a 8.5 pontos, no HLE com ferramentas, enquanto custa 3x menos em saída. Migre para o Pro se sua carga exigir toda a quantidade de parâmetros para raciocínio complexo em múltiplas etapas ou geração de código em larga escala.
Como reduzir o impacto do aumento de preços?
Há três alavancas: agende jobs em lote e agentes adiáveis fora dos horários de pico, entre 01:00–04:00 e 06:00–10:00 UTC; maximize os acertos de cache mantendo os prefixos de prompt estáveis; e direcione tarefas simples ao Flash ou use o esforço de raciocínio low no Pro.
A cobrança por horário de pico e fora de pico vale para o app e o site da DeepSeek?
A página oficial de preços documenta apenas a cobrança de tokens da API. O cronograma informado vale para chamadas diretas à API; provedores de gateway podem repassá-lo, aplicar margem ou usar tarifas próprias. Consulte a página de preços para os detalhes atuais.