 AIREITER
Na API GLM-5.2, todas as rotas aceitam requisições no formato da OpenAI, mas quase nenhuma se comporta igual por trás dessa fachada. Desde o lançamento em 16 de junho, a API vale a integração para trabalhos de código e agentes sensíveis a custo — desde que você implemente proteções próprias contra três falhas: semântica de tool calls, tempestades de retentativas e contabilização de cache. O preço de tabela de US$ 1,40/US$ 4,40 por milhão é real; o custo de uma tarefa concluída, porém, é outro número. É essa diferença que esta análise mede.
Compatível com OpenAI, mas só até certo ponto
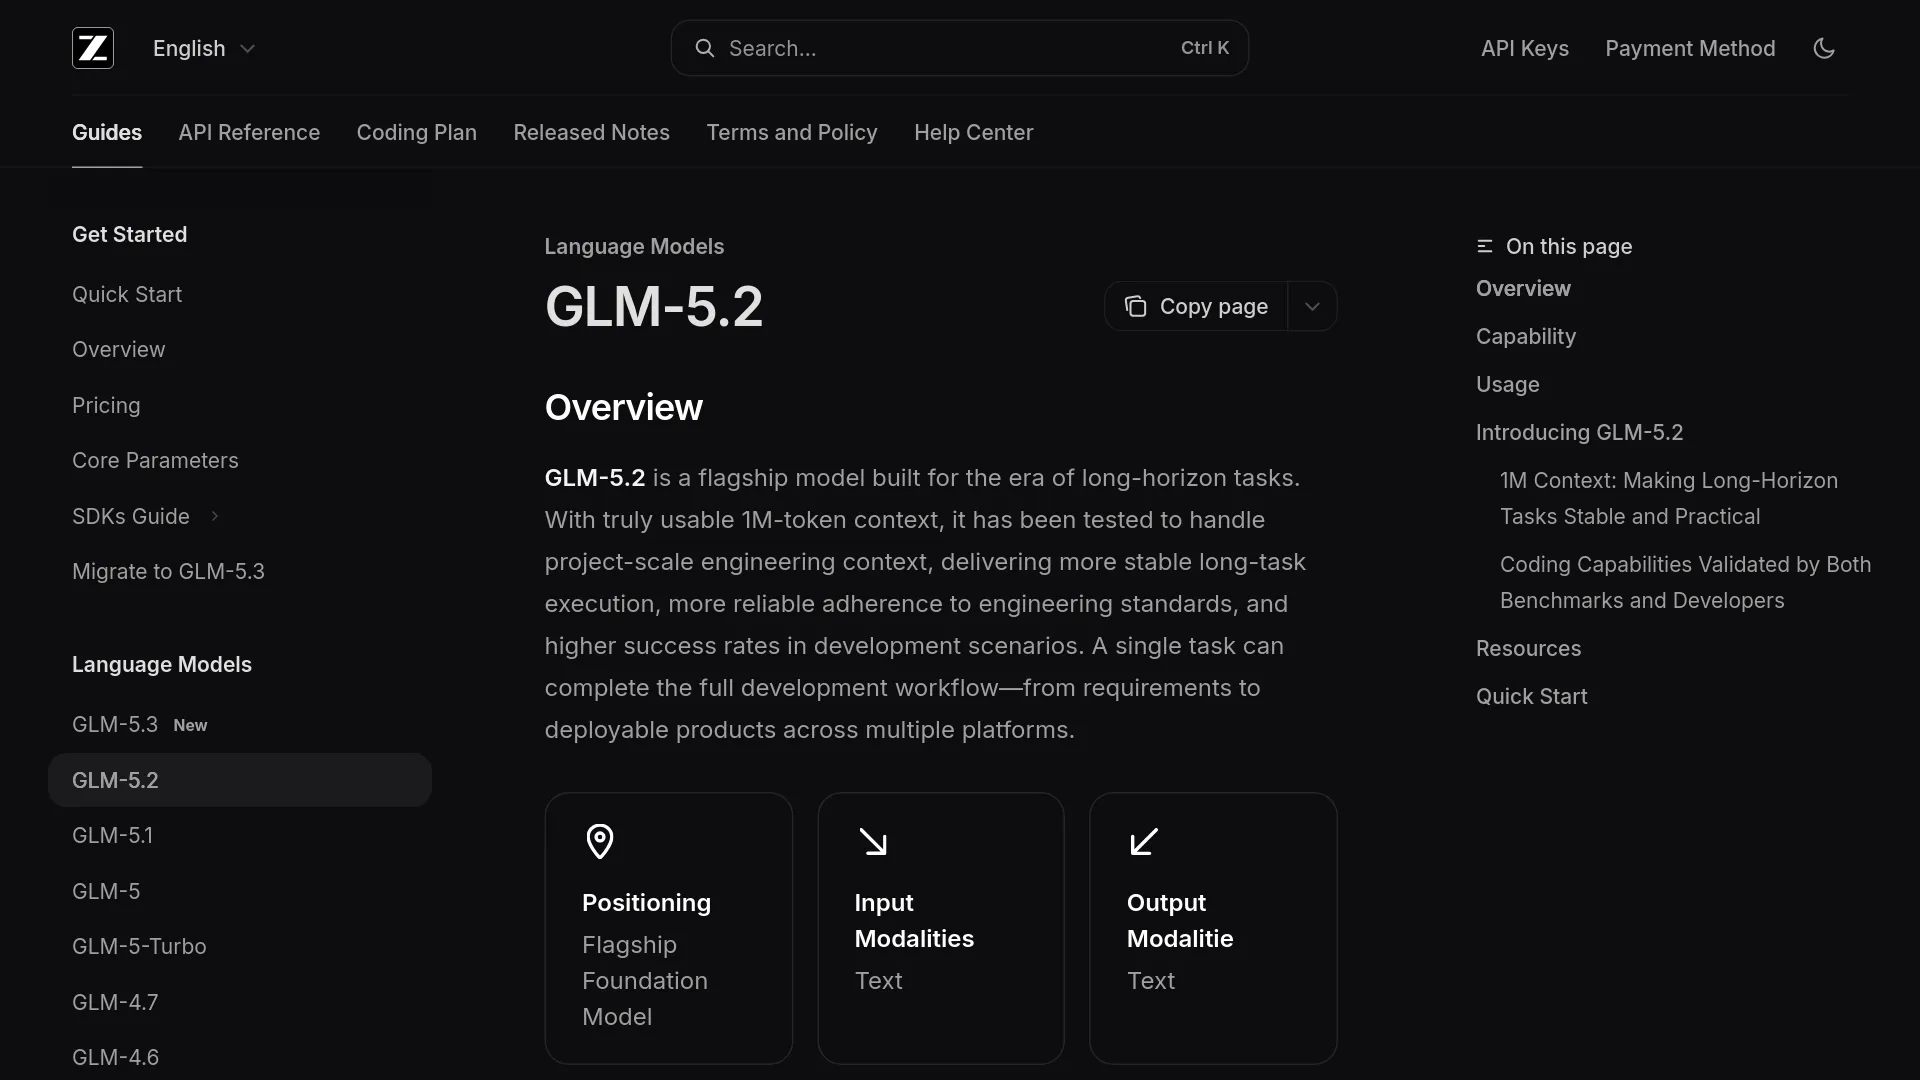
A documentação oficial do GLM-5.2 valida o SDK Python da OpenAI com a base URL https://api.z.ai/api/paas/v4/ e o identificador glm-5.2. Na prática, uma integração básica de chat muda em três linhas. A compatibilidade cobre o formato da requisição, não a semântica das respostas, os campos de controle opcionais da OpenAI ou a superfície mais recente da Responses API.
| Contrato documentado | Valor |
|---|---|
| Modalidade | Texto de entrada e texto de saída, sem visão |
| Janela de contexto | 1M de tokens |
| Saída máxima | 128K tokens |
| Recursos documentados | Modo de raciocínio, streaming, function call, cache de contexto, saída estruturada, MCP |
| Endpoint tarifado por uso | https://api.z.ai/api/paas/v4/ |
| Endpoint do Coding Plan | https://api.z.ai/api/coding/paas/v4 |
| Endpoint compatível com Anthropic | https://api.z.ai/api/anthropic |
| SDKs oficiais | zai-sdk (Python), Java, SDK da OpenAI |
O primeiro limite é direto: a Z.ai não oferece Responses API. Como observou u/quinncom, “o Codex só aceita o formato da Responses API, que não está disponível na Z.ai”; por isso, outros usuários passam pelo ZenMux como camada de tradução. O segundo envolve o Claude Code: ele funciona pela rota compatível com Anthropic, mas as notas de configuração de @armor_rust destacam duas armadilhas. Use AUTH_TOKEN, e não API_KEY: esta última aciona uma confirmação de confiança que pode recusar permanentemente após uma rejeição. Também há URLs-base diferentes para assinatura e pay-as-you-go. O passo a passo completo está em nosso guia de configuração do Claude Code.
Nas palavras de um desenvolvedor: “a compatibilidade de API para no formato da requisição; tool calling ainda exige avaliações específicas do provedor” — @sebuzdugan.
Tool calling funciona em testes curtos, mas pode desandar em loops longos
Em loops de ferramentas curtos e controlados, a API do GLM-5.2 entrega exatamente o que a documentação promete. Já em loops de agentes de longa duração, usuários intensivos relatam sequências de chamadas corrompidas que entram em ciclo até serem interrompidas pelos limites definidos no cliente. As duas conclusões coexistem: o risco depende inteiramente do tipo de loop que você está construindo.
Segundo a documentação da Z.ai e os testes da suíte Docker de 27 requisições da GLM52.ai, o contrato prevê até 128 definições de funções, nomes de até 64 caracteres compatíveis com ^[a-zA-Z0-9_-]+$, parâmetros em JSON Schema e argumentos retornados como uma string JSON que sua aplicação precisa validar. Apenas tool_choice: "auto" é documentado. A suíte passou em 27 de 27 requisições pela rota do Coding Plan: 4/4 correspondências exatas de ferramenta e argumentos, 3/3 recusas corretas de não usar ferramenta, 4/4 pedidos duplos em duas chamadas de nível superior, com latência mediana de 5,3 segundos.
A armadilha está nos campos que usuários da OpenAI presumem existir. Ao enviar testes conflitantes, a GLM52.ai recebeu HTTP 200, mas o endpoint ignorou as instruções:
| Controle no estilo OpenAI enviado | Comportamento observado |
|---|---|
tool_choice: "required" + “não use nenhuma ferramenta” | Parou, sem chamadas |
| Objeto de função forçada + “nunca use esta ferramenta” | Parou, sem chamadas |
parallel_tool_calls: false + prompt com dois pedidos | Retornou duas chamadas mesmo assim |
strict: true | Aceito uma vez; sem evidência de validação do schema |
Receber HTTP não é o mesmo que ter um contrato de comportamento. E é nos loops longos que essas fissuras aparecem.
Um desenvolvedor que rodou cerca de quatro bilhões de tokens pelo modelo resumiu sem rodeios: “o maior problema com o GLM 5.2, depois de 4 bilhões de tokens, foi a falta de visão, alguma confusão em tool calls e a morte por corrupção de tool calls, porque ele simplesmente entra em espiral” — @RasputinKaiser. Há ainda um relato isolado e sem resposta de o modelo codificar uma segunda tool call dentro dos argumentos da primeira. É um único caso, mas corresponde exatamente à classe de falha contra a qual um loop no cliente deve se proteger.
A defesa que funciona na prática é não delegar a orquestração ao modelo. Um desenvolvedor roda NVIDIA NIM com tool_call: false e deixa todo o loop sob controle do framework de agentes. O loop de referência limitado restringe os passos do modelo a quatro, permite no máximo quatro chamadas por turno e valida todo JSON de argumento antes da execução.
Streaming e latência: os números que não aparecem na propaganda
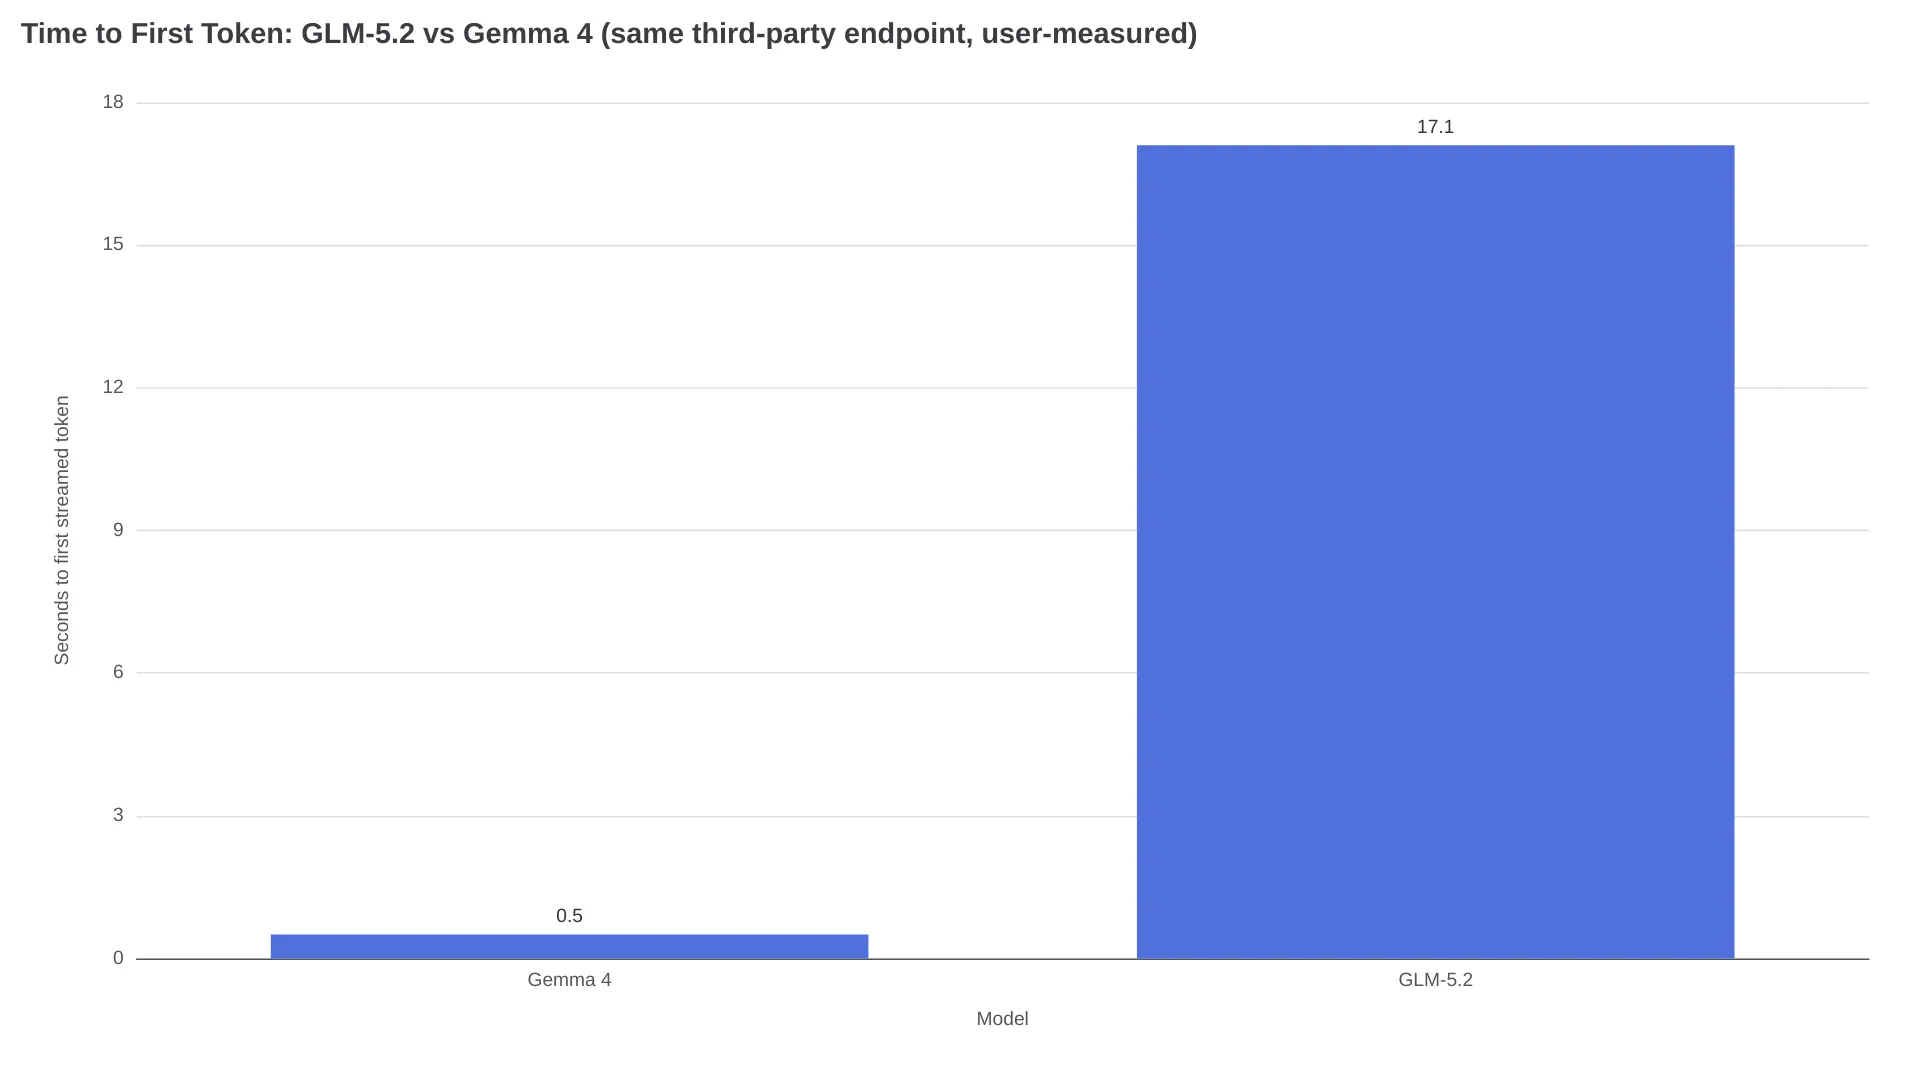
A latência até o primeiro token é o pior número medido da API. Em um teste lado a lado de endpoints no Sarvam, o GLM-5.2 alcançou 148 tokens por segundo em streaming, contra 260 do Gemma 4. O tempo até o primeiro token foi de 17,1 segundos, ante 0,5: “começa a gerar 33x mais cedo”, segundo @noctus91.
O throughput anunciado sofre do mesmo problema:
“Todos esses provedores de GLM 5.2 anunciam mais de 200 tok/s. Mas, quando você testa, recebe 50 tok/s” — @tomgreenwald, que chama isso de “benchmaxxing, só que para provedores”.
Outros dois padrões de falha aparecem em relatos sobre rotas de assinatura: streams que morrem no meio da sessão — “o streaming simplesmente... parou”, levando um usuário do GLM Pro Coding Plan a desistir de vez — e degradação conforme o contexto cresce: “quando você chega a mais de 300k de contexto, o modelo fica lento” (@mosh_Ontong). Em contraste, o benchmark executado de nove tarefas do DataLLM Lab, feito em seu próprio gateway, registrou média de 12,3 segundos por tarefa concluída. O endpoint, mais do que o modelo, define grande parte da sua história de latência.
Rate limits e 429s: retentar vira parte da rotina
A documentação de modelos da Z.ai não publica uma tabela de rate limits. Na prática, desenvolvedores descobrem os limites por tentativa e erro, recebendo 429s. Nas rotas do Coding Plan, o retrato da comunidade é claro: retentativas são operação normal, não um caminho excepcional. As discussões abaixo apontam modos de falha, não taxas de incidência, mas os relatos são consistentes.
Em uma discussão sobre rate limits no r/ZaiGLM:
- “No momento, estou recebendo 429/529 em praticamente uma de cada duas requisições no plano coding max. Sem concorrência...” — u/A-B-user
- “Sim, quase toda requisição é repetida, mas os resultados são muito bons” — u/hyeluoh
- “Funciona bem, superdevagar mas sem erros, se eu usar concorrência única para glm52” — u/evia89
Os erros também dependem do cliente: a mesma chave de API funciona no ZCode, mas gera 429s no OpenClaw, algo que outro usuário descreve como uma mensagem de “ocupado demais”. As camadas de assinatura tornam o cenário mais complexo. Usuários chineses relatam que o Coding Plan troca automaticamente workloads do 5.2 para o GLM-5.3, que consome a cota mais rápido, e que revendedores terceirizados do Coding Plan aplicam rate limiting após poucas chamadas.
As respostas de engenharia que se sustentam são: backoff exponencial com jitter, chaves de idempotência em qualquer operação que grave dados, orçamento de retentativas por tarefa em vez de por requisição e um modo degradado com concurrency=1 que possa ser ativado automaticamente. Os padrões de retry em nosso guia para corrigir 429 da OpenRouter se aplicam aqui sem mudanças.
A dúvida sobre cobrança de cache que a Z.ai não respondeu
O cache de contexto é documentado. Quando verificamos as páginas dos provedores em 13 de julho, a entrada em cache aparecia por cerca de US$ 0,26 por milhão de tokens, contra US$ 1,40 para entrada nova. A reclamação ainda sem solução — a crítica à API com maior engajamento nas discussões da comunidade que analisamos — é que, em algumas rotas, contexto repetido é cobrado como entrada nova. Isso multiplica o custo de qualquer loop de agente que reenvie um prompt de sistema extenso.
“Os tokens em cache não estão funcionando corretamente no GLM 5.2. O contexto repetido está sendo contabilizado como entrada normal, não como tokens em cache.” — @Da7_Tech, que chama isso de “um sério problema de cobrança e contabilização de cache”.
Nessa discussão, a mesma tarefa foi concluída pelo Claude Opus 4.8 com menos de 1,5M de tokens, enquanto o GLM-5.2 permaneceu incompleto depois de 53M de tokens, com a cota de cinco horas em 100%. O contador da própria aplicação mostrava cerca de 1,67M.
Dois meses depois, o mesmo desenvolvedor ainda resumiu a situação assim: “muitos usuários reclamam que os acertos de cache aparentemente contam contra o uso. Se isso acontecer com você, o valor do plano desaba.” Nenhuma resposta oficial apareceu nessas discussões até o fim de agosto.
Enquanto não houver confirmação de que isso foi corrigido, trate o preço de entrada em cache como o melhor cenário possível e valide-o nas suas próprias faturas. Registre cached_tokens do objeto de uso em todas as respostas e faça uma conciliação semanal.
Esforço de raciocínio: um controle com três nomes
A interface oficial usa thinking.type com os valores enabled/disabled, além de reasoning_effort com high e max. Os próprios exemplos da documentação usam reasoning_effort: "max". A orientação de lançamento da Z.ai dizia que max prioriza capacidade, enquanto high equilibra desempenho e eficiência de tokens; para código, a recomendação é max.
Daí surgem dois fatos de integração. Primeiro, as rotas de coding usam max por padrão: “o padrão é max, então você não precisa definir isso, a menos que queira reduzir” (r/ZaiGLM). Os tokens de raciocínio são cobrados na tarifa de saída, portanto o padrão multiplica silenciosamente o gasto. Nos Coding Plans, usuários que documentaram a contabilidade do plano relatam que chamadas com esforço max consomem 3x da cota durante a janela de 14:00 a 18:00, no horário de Pequim, em dias úteis, somando-se à janela de cinco horas e aos créditos semanais.
Segundo, muitas vezes esse controle nem chega ao backend. Usuários do OpenCode relatam que “atualmente ele não permite ajustar o esforço de raciocínio” para provedores personalizados. Alguns clientes ainda expõem a mesma opção sob um terceiro nome, xhigh, que talvez nem seja encaminhado ao provedor (r/opencodeCLI). A verbosidade segue o mesmo controle: um desenvolvedor que faz comparações diárias observou que um modelo rival “não é tão verboso quanto o Opus-4.8 ou o GLM-5.2”.
Mesmo nome de modelo, comportamento diferente conforme o endpoint
glm-5.2 é uma única string de modelo apontando para implantações materialmente diferentes. Quando resultados de precisão por endpoint circularam no início de agosto, o líder da própria Z.ai pediu à comunidade “que teste a API oficial do GLM-5.2 como um ponto de referência adicional. Ela pode pontuar acima de 100%” — @ZixuanLi_. O ponto de referência mencionado era a API oficial, não os endpoints de terceiros medidos pelo relatório.
Na prática, essa deriva aparece como limites de tokens de saída baixos o bastante para truncar o raciocínio no meio do streaming, throughput de lançamento que desaparece com o tempo — o padrão de “benchmaxxing” citado antes — e tetos de contexto diferentes conforme o host. A Together AI oferece o GLM-5.2 com 256K, enquanto a API oficial, com 1M segundo a documentação, e os agregadores da nossa comparação de julho mantêm a janela completa.
A diferença de preço é ainda maior que a de comportamento. Contra os US$ 1,40/US$ 4,40 de tabela da Z.ai, a OpenRouter listava US$ 0,42/US$ 1,32 em nossa comparação de provedores de julho, com tarifas de entrada em cache entre US$ 0,14, na Fireworks, e US$ 0,26. Escolha o endpoint conforme o workload e teste novamente naquele endpoint exato: um teste de comportamento aprovado em uma rota não se transfere para outra.
Antes de colocar em produção: teste pré-voo de 30 minutos
Todos os modos de falha acima podem ser detectados em meia hora, antes de comprometer uma carga de produção. Execute estes testes no endpoint, na string de modelo e no SDK exatos que você pretende lançar:
- Teste conflitos no contrato de ferramentas. Envie
tool_choice: "required"com uma instrução para não usar ferramentas eparallel_tool_calls: falsecom um prompt de dois pedidos. Espere que ambos sejam ignorados; se sua orquestração depende de qualquer um deles, pare aqui. - Teste de retentativas sob carga. Dispare 50 requisições na concorrência pretendida e registre a taxa de 429/529 e a proporção de retentativas bem-sucedidas. Se as retentativas superarem aproximadamente um terço das requisições — um limite operacional conservador — reduza a concorrência para 1 e meça novamente.
- Verifique a contabilização do cache. Reenvie cinco vezes um prefixo idêntico de 10K tokens; some
cached_tokensdas respostas de uso e compare com o que seu dashboard cobrou como entrada. Uma divergência aqui invalida seu modelo de custo. - Teste de latência com contexto real. Meça o tempo até o primeiro token e as interrupções durante o streaming em tamanhos de contexto representativos, não em um smoke test de 1K tokens. Caso contrário, a lentidão acima de 300K fica invisível.
- Decida a rota. O Coding Plan foi criado para ferramentas interativas de programação. Relatos de contabilização do plano indicam que ele não é licenciado para atender sites, bots ou tráfego de SaaS; portanto, backends de produto devem usar a API tarifada por uso.
O trade-off que não desaparece é este: o GLM-5.2 vende alguns dos tokens capazes para código mais baratos do mercado, mas o preço de entrada inclui engenharia de wrappers que APIs de ponta incorporam ao custo por token.
Perguntas frequentes sobre a API GLM-5.2
Posso usar o SDK da OpenAI com o GLM-5.2?
Sim, para chat completions. Aponte base_url para https://api.z.ai/api/paas/v4/ e use o modelo glm-5.2. Não existe Responses API, então a interface mais recente da OpenAI, incluindo o Codex, exige uma camada de tradução.
A API GLM-5.2 suporta streaming, function calling e saída estruturada?
Os três são recursos documentados, ao lado de cache de contexto e MCP. As ressalvas são comportamentais: a estabilidade do streaming varia conforme o endpoint, e campos de controle de ferramentas da OpenAI — tool_choice além de auto, parallel_tool_calls e strict — não são respeitados.
Qual string de modelo e URL-base devo usar?
Na rota oficial tarifada por uso, utilize glm-5.2 em https://api.z.ai/api/paas/v4/. O Coding Plan usa outra base URL, e a OpenRouter lista o modelo como z-ai/glm-5.2.
Por que o GLM-5.2 é lento ou excessivamente verboso?
As rotas de coding usam esforço máximo de raciocínio por padrão, cobrado como tokens de saída, e relatos da comunidade colocam o throughput sustentado mais perto de 50 tok/s do que dos mais de 200 anunciados. Antes de serem limitações do modelo, latência e verbosidade costumam ser efeitos da configuração e do endpoint.
Posso usar o GLM Coding Plan para alimentar a API da minha aplicação?
Não. Relatos de contabilização do plano indicam que a assinatura é voltada a ferramentas interativas de programação e exclui o atendimento de sites, bots ou produtos SaaS. Os multiplicadores de cota no horário de pico de Pequim também a tornam inadequada para tráfego constante.
A janela de contexto de 1M está disponível em todos os provedores?
Não. A API oficial e a maioria dos agregadores oferecem 1M, mas a Together AI limita o GLM-5.2 a 256K — uma diferença suficiente para mudar a arquitetura de fluxos de trabalho em escala de repositório.
Leituras relacionadas
- Review do GLM-5.2: dois meses depois do hype — qualidade do modelo, benchmarks e para quem ele faz sentido
- API GLM 5.2: acesso mais barato, preços e chaves grátis — a matriz completa de preços por provedor
- GLM-5.2 vs GLM-5.3 — se o sucessor de agosto muda a decisão