 AIREITER
Em 11 de 12 testes comparáveis, o Nemotron 3.5 Lightning fica atrás do Qwen 3.6 35B-A3B nos benchmarks da própria NVIDIA. Ainda assim, a promessa é de geração de tokens até 4x mais rápida. Essa é exatamente a proposta: um modelo mixture-of-experts de 30B, mas com somente 3B de parâmetros ativos por token, voltado às etapas repetitivas de um pipeline de agentes — cenários em que velocidade e custo pesam mais do que o raciocínio de ponta. Há uma ressalva: os pesos BF16 em precisão total exigem uma GPU de 80 GB, e a NVIDIA recomenda o checkpoint NVFP4 para uso em produção.
Por que o Nemotron 3.5 Lightning foge do padrão entre modelos de 30B
O Nemotron 3.5 Lightning combina camadas de espaço de estados Mamba-2, roteamento MoE e camadas seletivas de attention em uma arquitetura híbrida que a NVIDIA identifica como nemotron_h. As camadas Mamba-2 reduzem a sobrecarga de memória e processamento da attention em contextos longos. É assim que o Lightning oferece uma janela de contexto de 1 milhão de tokens — na prática, limitada a 256K em uma única H100 de 80 GB, segundo o model card — sem arcar com o custo quadrático de um modelo baseado exclusivamente em attention.
| Especificação | Valor |
|---|---|
| Parâmetros totais | 30B |
| Parâmetros ativos por token | 3B |
| Arquitetura | Híbrida de Mamba-2 + MoE + Attention |
| Tamanho de contexto | Até 1 milhão de tokens (256K em uma única H100) |
| Opções de precisão | BF16, NVFP4 |
| Licença | OpenMDW v1.1 (permite uso comercial) |
| Idiomas | Inglês, espanhol, francês, alemão, italiano, japonês + programação |
| Corpus de pré-treinamento | 20T+ tokens |
| Modo de raciocínio | Ativável por enable_thinking no template de chat |
| Amostragem recomendada | Temperature 1.0, top-p 0.95 |
A NVIDIA apresenta o Lightning como o menor integrante da família Nemotron 3, treinado especificamente para o comportamento de harnesses de agentes: chamadas de ferramentas, validação de saídas, formatação de resultados e delegação a subagentes. Um modelo de raciocínio de fronteira, como o Nemotron 3 Ultra, cuida do planejamento complexo; o Lightning executa as etapas rotineiras que, de outra forma, consumiriam o orçamento de tokens de um modelo premium.
Benchmarks: os pontos fortes e as limitações do Lightning
O model card no HuggingFace traz 14 linhas de benchmarks que comparam o Lightning com Qwen 3.6 35B-A3B, Gemma 4 26B-A4B, Nemotron 3 Nano/Super e GPT-OSS 20B. Abaixo estão as 10 métricas mais relevantes para a decisão:
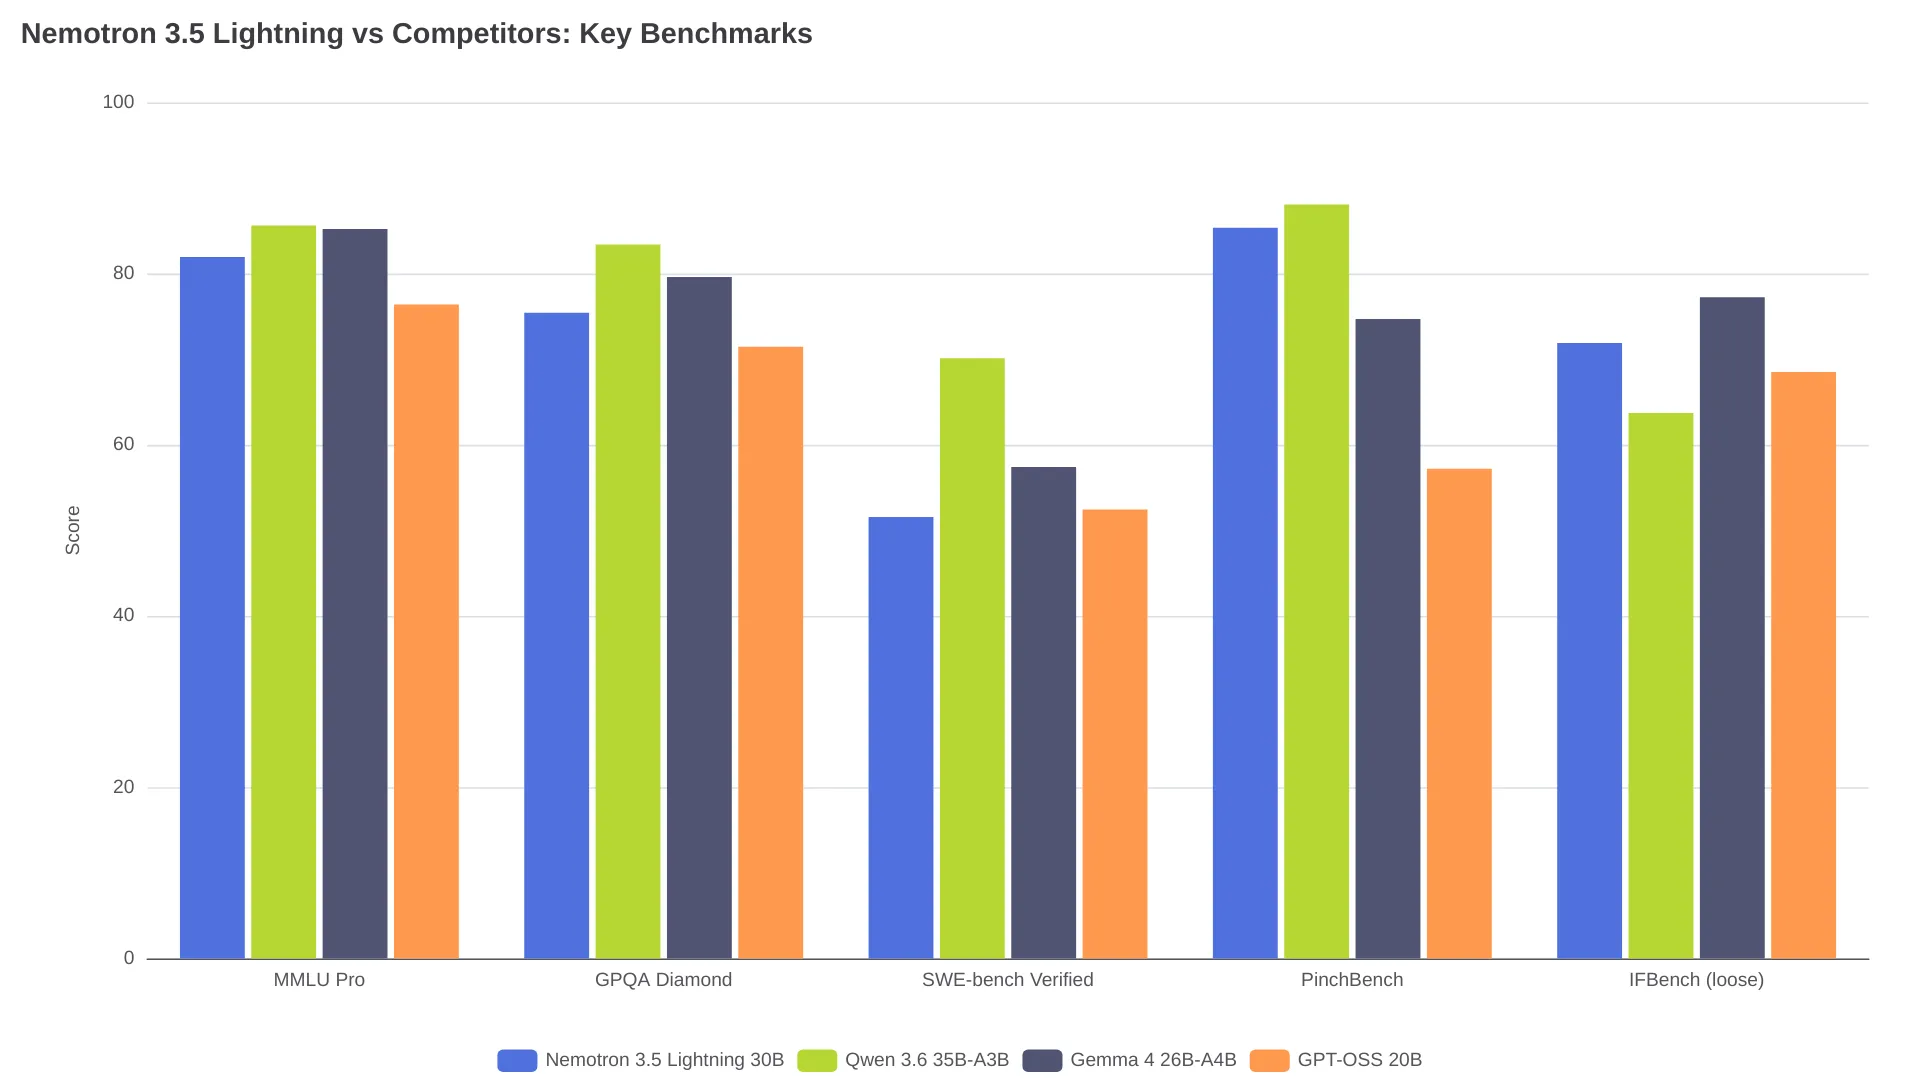
| Benchmark | Nemotron 3.5 Lightning | Qwen 3.6 35B-A3B | Gemma 4 26B-A4B | GPT-OSS 20B |
|---|---|---|---|---|
| MMLU Pro | 81.94 | 85.63 | 85.20 | 76.40 |
| GPQA Diamond (sem ferramentas) | 75.44 | 83.40 | 79.61 | 71.46 |
| SWE-bench Verified | 51.56 | 70.12 | 57.40 | 52.44 |
| SWE-bench Multilingual | 39.33 | 63.40 | 43.40 | 41.93 |
| Terminal-Bench 2.1 | 24.58 | 44.38 | 37.22 | 15.17 |
| PinchBench | 85.37 | 88.07 | 74.70 | 57.20 |
| BrowseComp | 36.97 | 48.74 | 26.30 | - |
| IFBench (flexível) | 71.88 | 63.71 | 77.25 | 68.50 |
| AA-LCR | 52.00 | 61.06 | 57.56 | 32.88 |
| SciCode | 32.60 | 35.33 | 40.28 | 38.63 |
O Lightning perde para o Qwen 3.6 35B-A3B em 11 das 12 linhas comparáveis. A exceção é o IFBench, de seguimento de instruções no modo flexível: são 71.88 pontos, contra 63.71 do Qwen — uma vantagem de 8 pontos coerente com o posicionamento do modelo para execução por agentes. Ao lidar com formatação de tool calls e validação de resultados, seguir instruções pode ser mais importante do que maximizar o raciocínio bruto.
É no desempenho que o Lightning realmente se diferencia. Na avaliação PinchBench da NVIDIA, que mede 10.000 tarefas de agentes em horas de GPU H100, o Lightning conclui a carga em aproximadamente 16.5 horas de GPU, com 86% de precisão. O Qwen 3.6 35B precisa de 23.5–24 horas de GPU para atingir 87%, enquanto o Gemma 4 26B leva 25–26 horas para chegar a 73%:
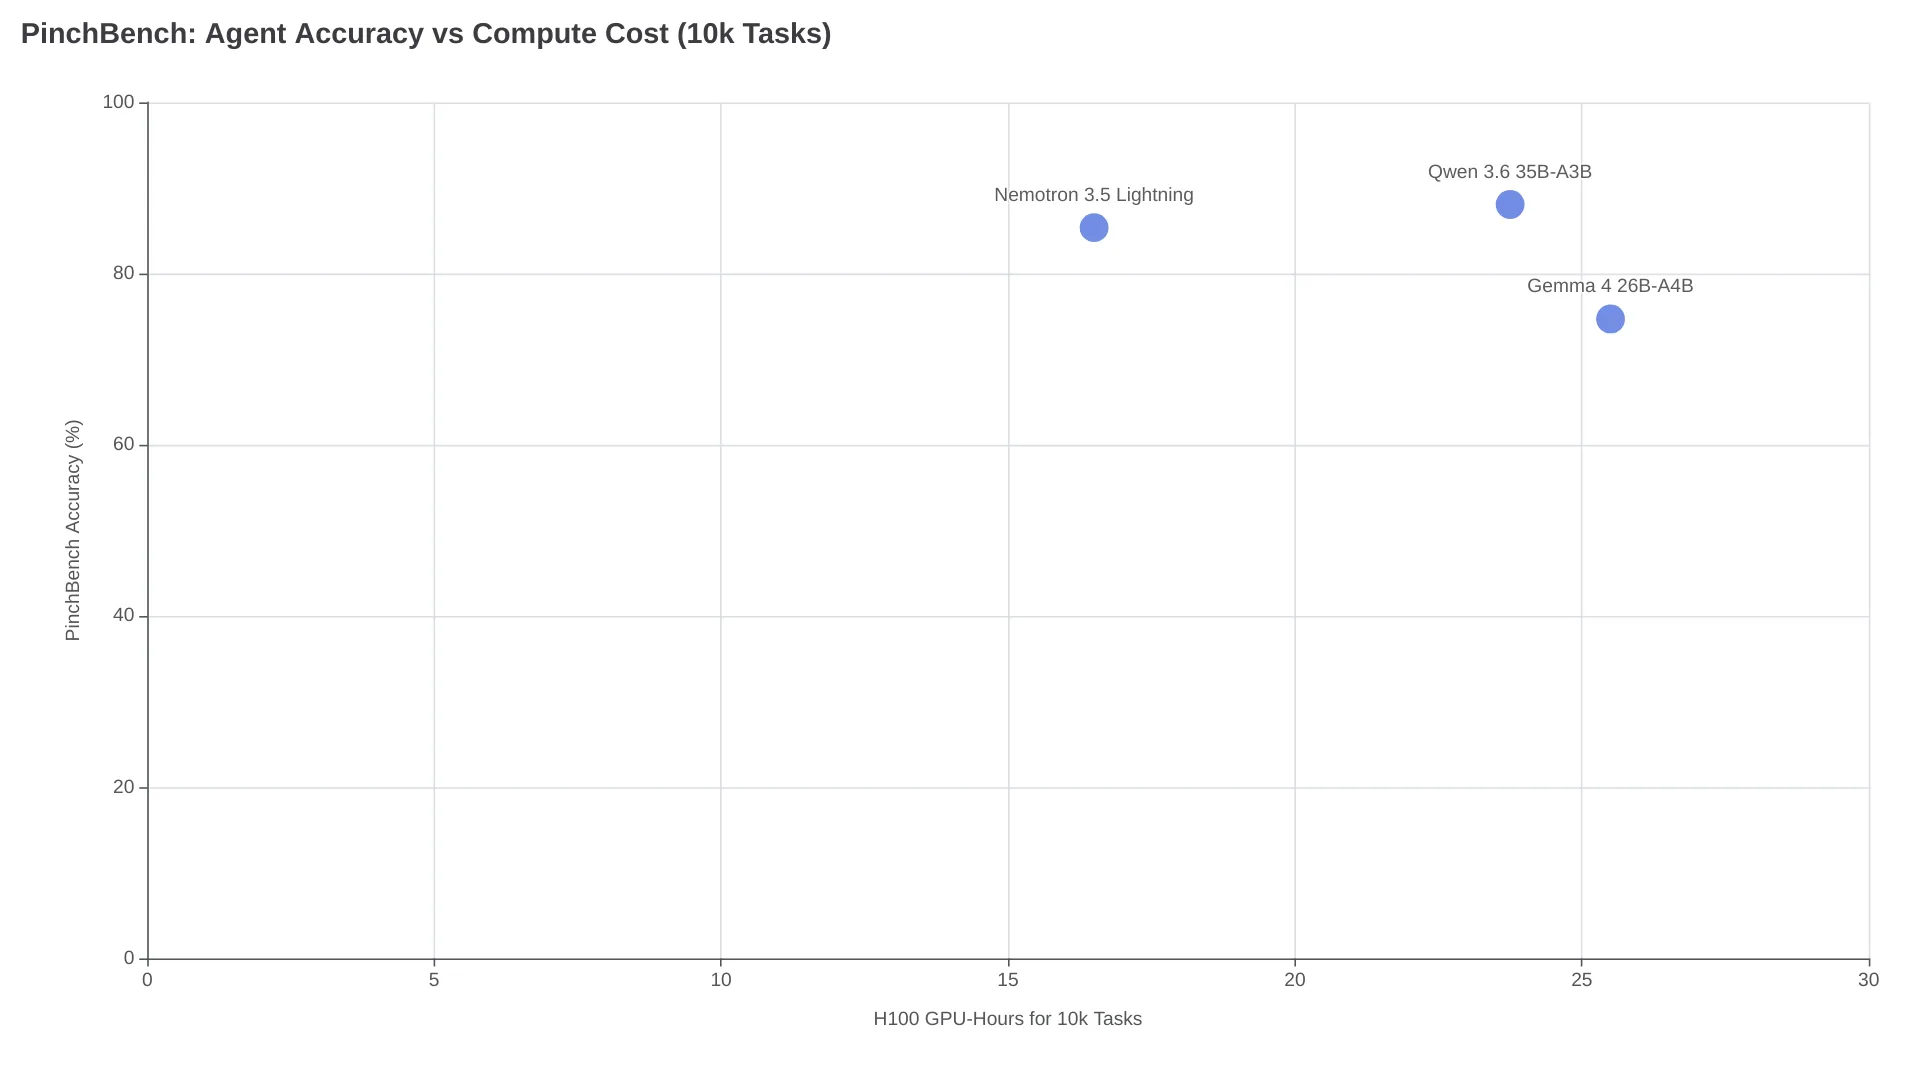
Na prática, isso equivale a cerca de 30% menos processamento para uma precisão quase idêntica — uma diferença relevante ao executar 10.000 etapas de agentes e pagar por hora de GPU. A NVIDIA também informa cerca de 670 tokens de saída por segundo para o Lightning, com aproximadamente 23–24 pontos no Intelligence Index do ranking Artificial Analysis. Com isso, o modelo entra na fronteira de Pareto entre modelos de pesos abertos com menos de 40B de parâmetros totais.
Testes da comunidade no r/LocalLLaMA chegaram a conclusões semelhantes sobre velocidade. Um usuário de DGX Spark relatou 78.5 tokens/segundo apenas no modelo alvo e 90.7 tokens/segundo com speculative decoding no checkpoint NVFP4. Outro participante da discussão principal avaliou a qualidade do Lightning como “entre o Gemma 4 26B e o 31B, bem mais próximo do 26B”. Segundo ele, o modelo roda cerca de 2x mais rápido que o Gemma 31B, mas gera muitos thinking tokens, o que na prática compensa parte desse ganho. Conversões iniciais para GGUF Q4 apontaram arquivos de 25 GB e avisos sobre tensores não usados, sinal de que a arquitetura híbrida Mamba-2 talvez ainda não tenha suporte completo em todas as ferramentas baseadas em GGUF.
Requisitos de hardware e caminhos para rodar localmente
O checkpoint BF16, que reúne os pesos de referência em precisão total, exige 1x H100 80GB ou 1x A100 80GB para implantação em uma única GPU. O arquivo safetensors fragmentado tem 65.8 GB. Para inferência em produção, a NVIDIA recomenda explicitamente a versão separada em NVFP4.
| Checkpoint | Tamanho do arquivo (aprox.) | GPU mínima | Mais indicado para |
|---|---|---|---|
| BF16 | 65.8 GB | 1x H100/A100 80GB | Fine-tuning, pesquisa e criação de variantes quantizadas |
| NVFP4 | ~16 GB | RTX 5090, DGX Spark, Jetson (Blackwell/Hopper/Ampere) | Inferência em produção e implantação de agentes |
| GGUF Q4 | ~25 GB | 16 GB+ de VRAM (criado pela comunidade) | llama.cpp, Ollama, LM Studio |
A NVIDIA colaborou com quatro projetos de serving local para oferecer suporte desde o lançamento: vLLM, SGLang, Ollama e llama.cpp. LM Studio e Unsloth também foram citados. O modelo oferece suporte a três estratégias de speculative decoding:
- DSpark - recomendado para DGX Spark e inferência em data center com baixa concorrência
- DFlash - modelo draft alternativo, dependendo da carga de trabalho
- MTP (Multi-Token Prediction) - integrado ao modelo, ideal para concorrência média a alta
Para acesso hospedado sem hardware local, o Lightning está disponível no build.nvidia.com como um microsserviço NIM e também no OpenRouter. O checkpoint NVFP4 roda em GeForce RTX 5090, DGX Spark, sistemas OEM GB10 e NVIDIA Jetson.
O padrão de roteamento de agentes em que o Lightning faz sentido
A biblioteca open source de roteamento da NVIDIA, NeMo Switchyard, direciona cada etapa do fluxo de trabalho de agentes ao modelo mais adequado, considerando precisão, velocidade e custo. O planejamento sobe para um modelo de raciocínio de fronteira; a execução desce para o Lightning. Em um benchmark interno, a NVIDIA afirma que o Switchyard manteve a conclusão de tarefas em “nível de fronteira” e reduziu o custo para aproximadamente um terço do uso exclusivo do Opus 4.8. Entre as tarefas de execução encaminhadas ao Lightning estão git pull, validação de saídas de ferramentas, formatação de resultados e chamadas rotineiras de API.
Há também uso prático desse padrão. A CodeRabbit publicou um caso real no Reddit: a empresa fez pós-treinamento do Nemotron 3.5 Lightning para roteamento de revisões de código, usando SFT direcionado e RLVR (reinforcement learning with verifiable rewards). O modelo superou a baseline em uma avaliação congelada de 1.000 tarefas, por menos de $100 em custos de treinamento. A NVIDIA dá suporte a esse fluxo com NeMo Automodel e NeMo Megatron Bridge (LoRA/SFT), NeMo RL e NeMo Gym (reinforcement learning), além de um dataset aberto chamado Nemotron-RL Agentic Terminal Pivot.
Para equipes que constroem pipelines de agentes, a questão prática é outra: dá para ajustar o Lightning para executar a maior parte das etapas dos seus agentes ao custo de 3B de parâmetros ativos e deixar um modelo de fronteira reservado apenas para as poucas etapas que realmente precisam dele?
Vale usar o Nemotron 3.5 Lightning?
| Caso de uso | Recomendação | Motivo |
|---|---|---|
| Roteamento de agentes em alto volume (tool calls, validação, formatação) | Lightning NVFP4 | 3B de parâmetros ativos, velocidade de tokens 4x maior, ~30% menos processamento com precisão semelhante |
| Assistência geral de programação | Qwen 3.6 35B-A3B | 70.12 versus 51.56 no SWE-bench Verified — diferença de 19 pontos |
| Raciocínio / planejamento complexo | Nemotron 3 Ultra ou modelo de fronteira | O Lightning explicitamente não é o modelo de planejamento |
| Chat local em uma única GPU de hardware para consumidor | Lightning NVFP4 em RTX 5090 | Funciona, mas as conversões GGUF ainda são instáveis; vLLM/SGLang são mais confiáveis |
| Fine-tuning para uma tarefa específica de agente | Lightning BF16 | 3B de parâmetros ativos = fine-tuning mais barato; OpenMDW v1.1 permite uso comercial |
| Seguimento de instruções em escala | Lightning | IFBench 71.88 versus Qwen 63.71 — vantagem de 8 pontos |
O Lightning troca precisão máxima por velocidade em execução de alto volume. A redução de 30% no processamento se acumula ao longo de centenas de etapas de agentes por sessão, mas o modelo foi lançado em 11 de agosto de 2026 e a maturidade do ecossistema ainda está em evolução. A arquitetura híbrida Mamba-2 significa que ferramentas baseadas em GGUF talvez ainda não ofereçam suporte completo. Em hardware NVIDIA com vLLM ou SGLang, o checkpoint NVFP4 é hoje o caminho de implantação mais seguro; em Apple Silicon ou configurações limitadas a GGUF, o melhor é esperar a comunidade estabilizar as conversões.
Perguntas frequentes
O Nemotron 3.5 Lightning roda em hardware de consumidor?
Para hardware de consumidor, a NVIDIA oferece suporte somente ao checkpoint NVFP4. Os pesos BF16 exigem uma GPU de 80GB, H100 ou A100. O NVFP4 roda em GeForce RTX 5090, DGX Spark e NVIDIA Jetson. Há conversões comunitárias em GGUF Q4 para llama.cpp e Ollama em sistemas com 16 GB+ de VRAM, mas as versões iniciais relataram problemas com tensores não usados na arquitetura híbrida Mamba-2.
Como o Nemotron 3.5 Lightning se compara ao Qwen 3.6 35B?
O Qwen 3.6 35B-A3B supera o Lightning em 11 dos 12 benchmarks publicados, com as maiores diferenças no SWE-bench Verified e no Terminal-Bench. O Lightning vence no IFBench de seguimento de instruções e entrega conclusão de tarefas aproximadamente 30% mais rápida, com precisão semelhante em cargas de agentes. O Qwen é o modelo mais forte para uso geral; o Lightning é o modelo mais rápido para execução por agentes.
O Nemotron 3.5 Lightning é bom para programação?
Em benchmarks brutos de programação, não: sua nota no SWE-bench Verified é 51.56, contra 70.12 do Qwen 3.6. No entanto, a CodeRabbit conseguiu ajustar o Lightning para roteamento de revisão de código por menos de $100 e superou sua baseline. O modelo foi projetado para customização: ajuste-o às convenções da sua base de código, e ele poderá executar tarefas rotineiras de programação ao custo de 3B de parâmetros ativos.
Qual licença o Nemotron 3.5 Lightning usa?
O modelo é lançado sob a licença OpenMDW v1.1 (Open Model Data Weight), que a NVIDIA descreve como disponibilizada “da forma mais permissiva possível”. A licença permite uso comercial, incluindo pesos, dados de treinamento e receitas. Os termos completos estão no model card no HuggingFace.