 AIREITER
2026년 8월, Qwen 3.8과 Kimi K3의 비교 기준은 완전히 달라졌다. 두 제품군 모두 가중치를 내려받을 수 있고 플래그십 모델도 정식 출시됐지만, 어떤 환경에 배치하느냐에 따라 답이 갈린다. 검증된 에이전트 코딩 기록은 Kimi K3가 가장 강하고, 토큰 가격은 Qwen 3.8 Max가 유리하다. 반면 Qwen의 Apache-2.0 27B 모델은 소비자용 GPU 한 장으로 돌릴 수 있다. 다만 Kimi의 ‘오픈’ 플래그십은 보고된 체크포인트 크기만 1.56TB다. 가중치를 공개했다는 것과 실질적으로 셀프 호스팅할 수 있다는 것은 다른 문제다.
Qwen 3.8과 Kimi K3, 실제 출시 사양 정리
Kimi K3는 Moonshot AI가 2026년 7월 16일 내놓은 단일 플래그십 모델이다. 전체 2.8조 파라미터의 MoE 구조이며 토큰당 활성 파라미터는 104B다. Kimi Delta Attention과 Gated MLA를 적용했고, 컨텍스트 윈도우는 1,048,576토큰이며 네이티브 비전을 지원한다. 가중치와 기술 보고서는 7월 27일 커스텀 Kimi K3 License로 공개됐다. Emergent의 비교 요약에 따르면 대규모 상업 리셀러와 월간 사용자 1억 명을 넘는 제품에는 조건이 붙는다.
Alibaba는 단일 모델이 아니라 제품군으로 맞섰다. Qwen 3.8 Max는 7월 19일 프리뷰로 공개됐고, 전체 2.4T / 활성 약 95B 파라미터 사양으로 8월 3일 QwenCloud에서 정식 제공을 시작했다. 이후 8월 12일 무렵 Hugging Face에 Qwen/Qwen3.8-2.4T-A95B 가중치가 커스텀 qwen3.8-max 라이선스와 함께 올라왔다. 며칠 뒤 공개된 Qwen/Qwen3.8-27B는 Apache-2.0 라이선스의 27B 밀집형 비전-언어 모델이다. 기본 컨텍스트는 262K이고 YaRN을 적용하면 1M까지 확장된다. Yotta Labs는 이를 8월 13~14일자로 기록했다.
| Kimi K3 | Qwen 3.8 Max | Qwen3.8-27B | |
|---|---|---|---|
| 전체 / 활성 파라미터 | 2.8T / 104B | 2.4T / ~95B | 27B 밀집형 |
| 컨텍스트 | 1,048,576 | 1M (최대 입력 991.8K) | 기본 262K, YaRN 적용 시 1M |
| 라이선스 | Kimi K3 License (커스텀) | 커스텀 qwen3.8-max 라이선스 | Apache-2.0 |
| 가중치 공개 시점 | 2026년 7월 27일 | 2026년 8월 12일 무렵 | 2026년 8월 13~14일 무렵 |
| 비전 입력 | 텍스트 + 이미지 (공식 지원) | API에서 텍스트, 이미지, 비디오 | 텍스트, 이미지, 비디오 |
Moonshot은 K3 출시 후 48시간 안에 GPU 수요가 용량을 앞지르자 신규 소비자 구독을 일시 중단한 것으로 알려졌다. 한 제공자에 제품을 전적으로 맡기려 한다면 기억해둘 만한 대목이다.
벤치마크는 누가 측정했는지부터 봐야 한다
두 벤더 모두 인상적인 벤치마크 표를 내놓지만, 각 표에는 서로 다른 하니스가 섞여 있다. Kimi의 모델 카드는 경쟁 모델 점수가 서로 다른 에이전트 하니스에서 나왔고, 일부 행은 H100이 아닌 H20 하드웨어를 사용했다고 명시한다. 아래 공통 항목은 독립 검증 결과가 아니라 벤더 보고 수치로 봐야 한다.
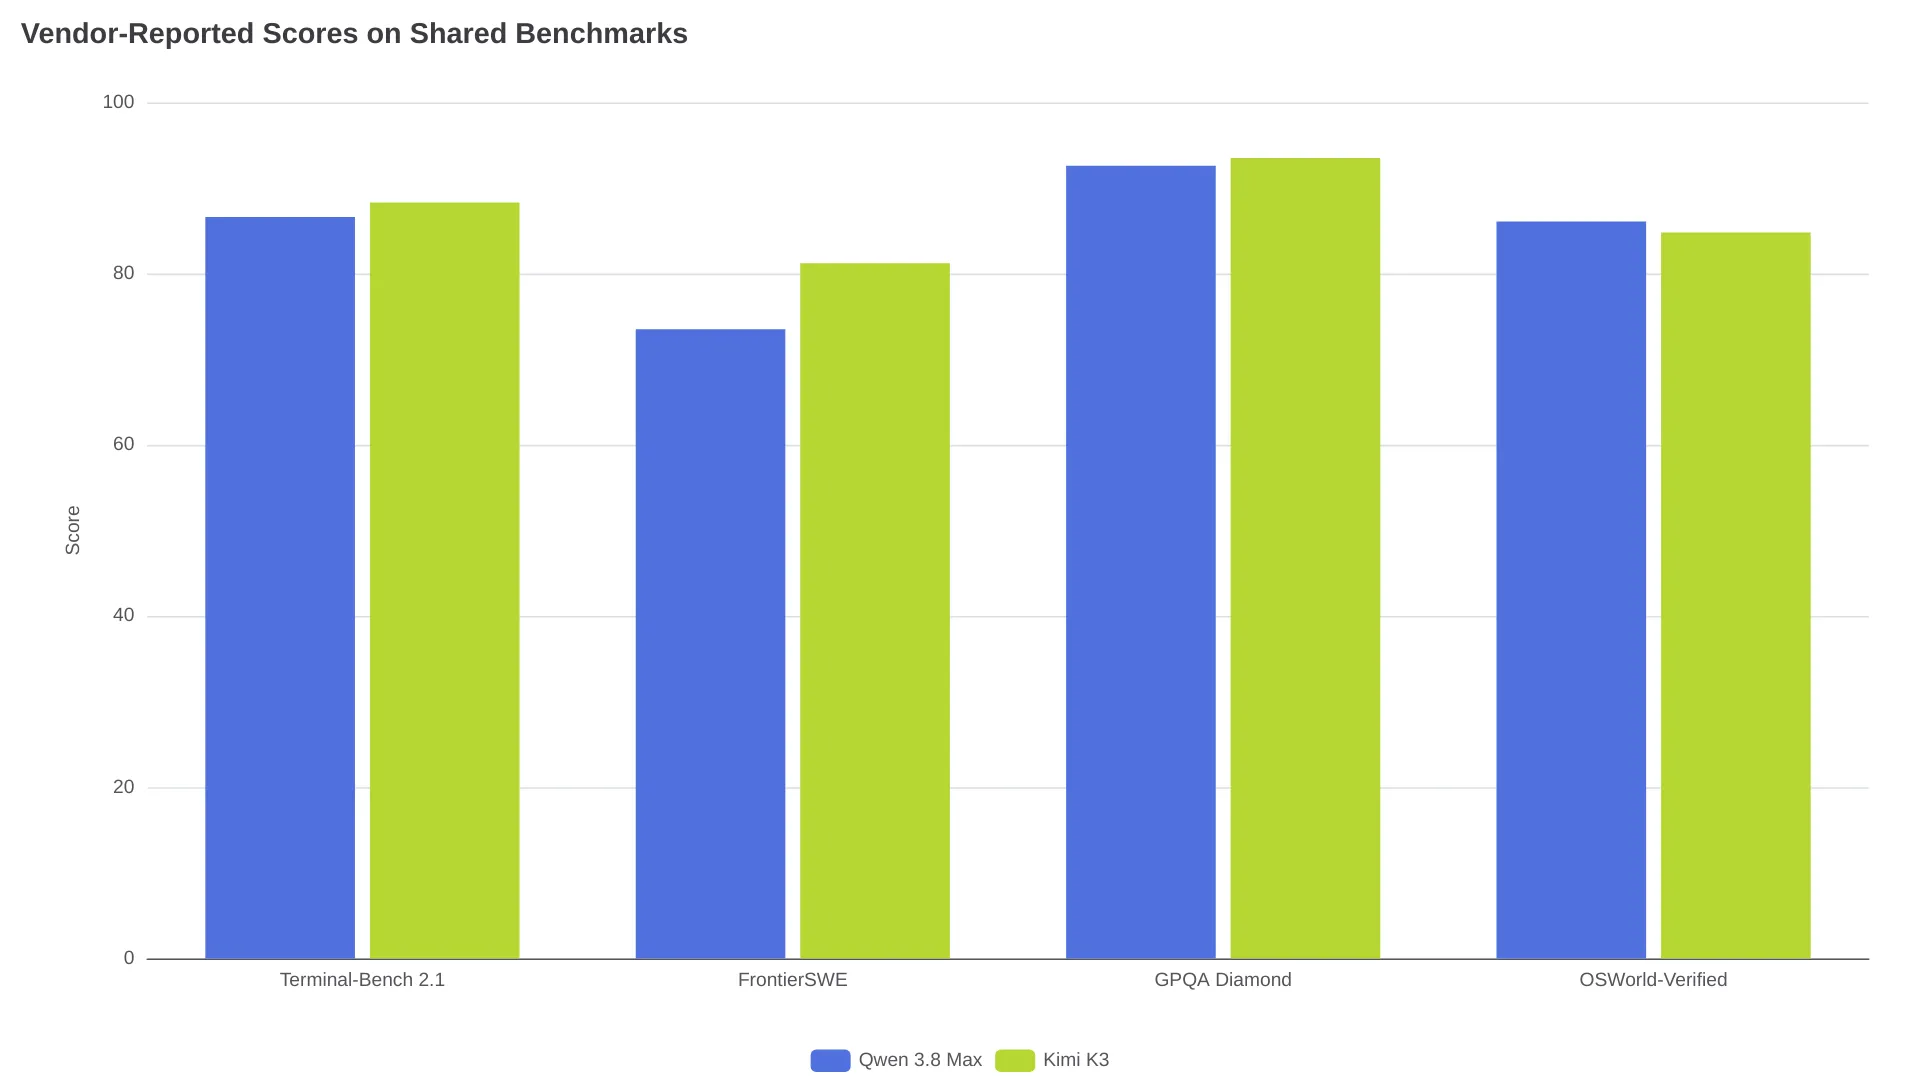
공통으로 제시된 항목에서는 에이전트 코딩 영역의 Kimi K3 우세가 뚜렷하다. 모델 카드 기준 FrontierSWE는 81.2 대 73.5, Terminal-Bench 2.1은 88.3 대 86.6이다. Qwen 측 수치는 2.4T 모델 카드에서 확인할 수 있다. Qwen의 출시 자료는 OSWorld-Verified에서 86.1을 주장하며, 이는 K3 카드의 84.8보다 높다. Qwen 카드에는 PaperBench 93.0, IFBench 82.8, SWE-bench Pro 67.7 같은 단일 항목 강점도 있다. 반대로 K3는 Qwen이 보고하지 않은 항목에서 SWE-Marathon 42.0, BrowseComp 91.2, MCPMark-Verified 94.5를 제시한다.
독립 평가 기록은 현재까지 Kimi K3 쪽으로 크게 기울어 있다. Emergent의 추적 자료는 Kimi K3가 출시 당시 Artificial Analysis Intelligence Index 57을 기록했고, 현행 인덱스 버전에서는 60으로 Claude Fable 5와 GPT-5.6 Sol 다음 순위라고 적었다. Orcarouter의 비교에는 Frontend Code Arena 1위, Elo 1,679도 추가돼 있다. Qwen 3.8 Max는 출시 당시 독립 인덱스에 포함되지 않았다. cheapestinference.com의 트래커는 Artificial Analysis 인덱스 수치로 53을 보고했으며, 56으로 올랐다는 커뮤니티 게시물은 아직 검증되지 않았다.
동일 작업을 놓고 직접 비교한 사례는 TrilogyAI의 StackPerf 아키텍처 분석 하나뿐이다. Orcarouter가 문서화한 내용에 따르면 프리뷰 엔드포인트에서 K3는 83/100, Qwen은 80/100을 받았다. Qwen은 저장소 인용 354건으로 Kimi의 274건보다 많았고, 게이트웨이 요청은 22건으로 Kimi의 53건보다 적었다. 도구 호출 실패는 Qwen이 0건, Kimi가 2건이었다.
공통 표에서 빠진 수치도 중요하다. Qwen의 모델 카드에 따르면 27B는 OSWorld-Verified에서 84.3을 기록했다. K3의 84.8보다 불과 0.5점 낮다. 27B 밀집형 모델이 컴퓨터 사용 벤치마크에서 2.8T 플래그십과 0.5점 이내 차이라는 뜻이다. 물론 K3와 같은 코딩 등급은 아니다. Terminal-Bench는 73.0 대 88.3이다. 그래도 LiveCodeBench v6 90.3, SWE-bench Pro 61.7이면 충분히 실무형 워크호스로 볼 수 있다. r/AISEOInsider의 실사용 비교 스레드도 데이터와 비슷한 결론을 냈다. 단발성 빌드에서는 Qwen이 더 자주 이겼고, 컨텍스트가 길어지고 수정 단계가 깊어질수록 Kimi가 앞섰다.
API 비용: 출력 100만 토큰 $15와 추론 비용
정가만 놓고 보면 방향은 명확하다. 실제 비용 차이는 더 벌어진다. 두 모델 모두 기본적으로 추론을 수행하기 때문이다. K3는 reasoning_effort: max, Qwen은 xhigh 설정이며, 추론 토큰도 출력 토큰으로 과금된다.
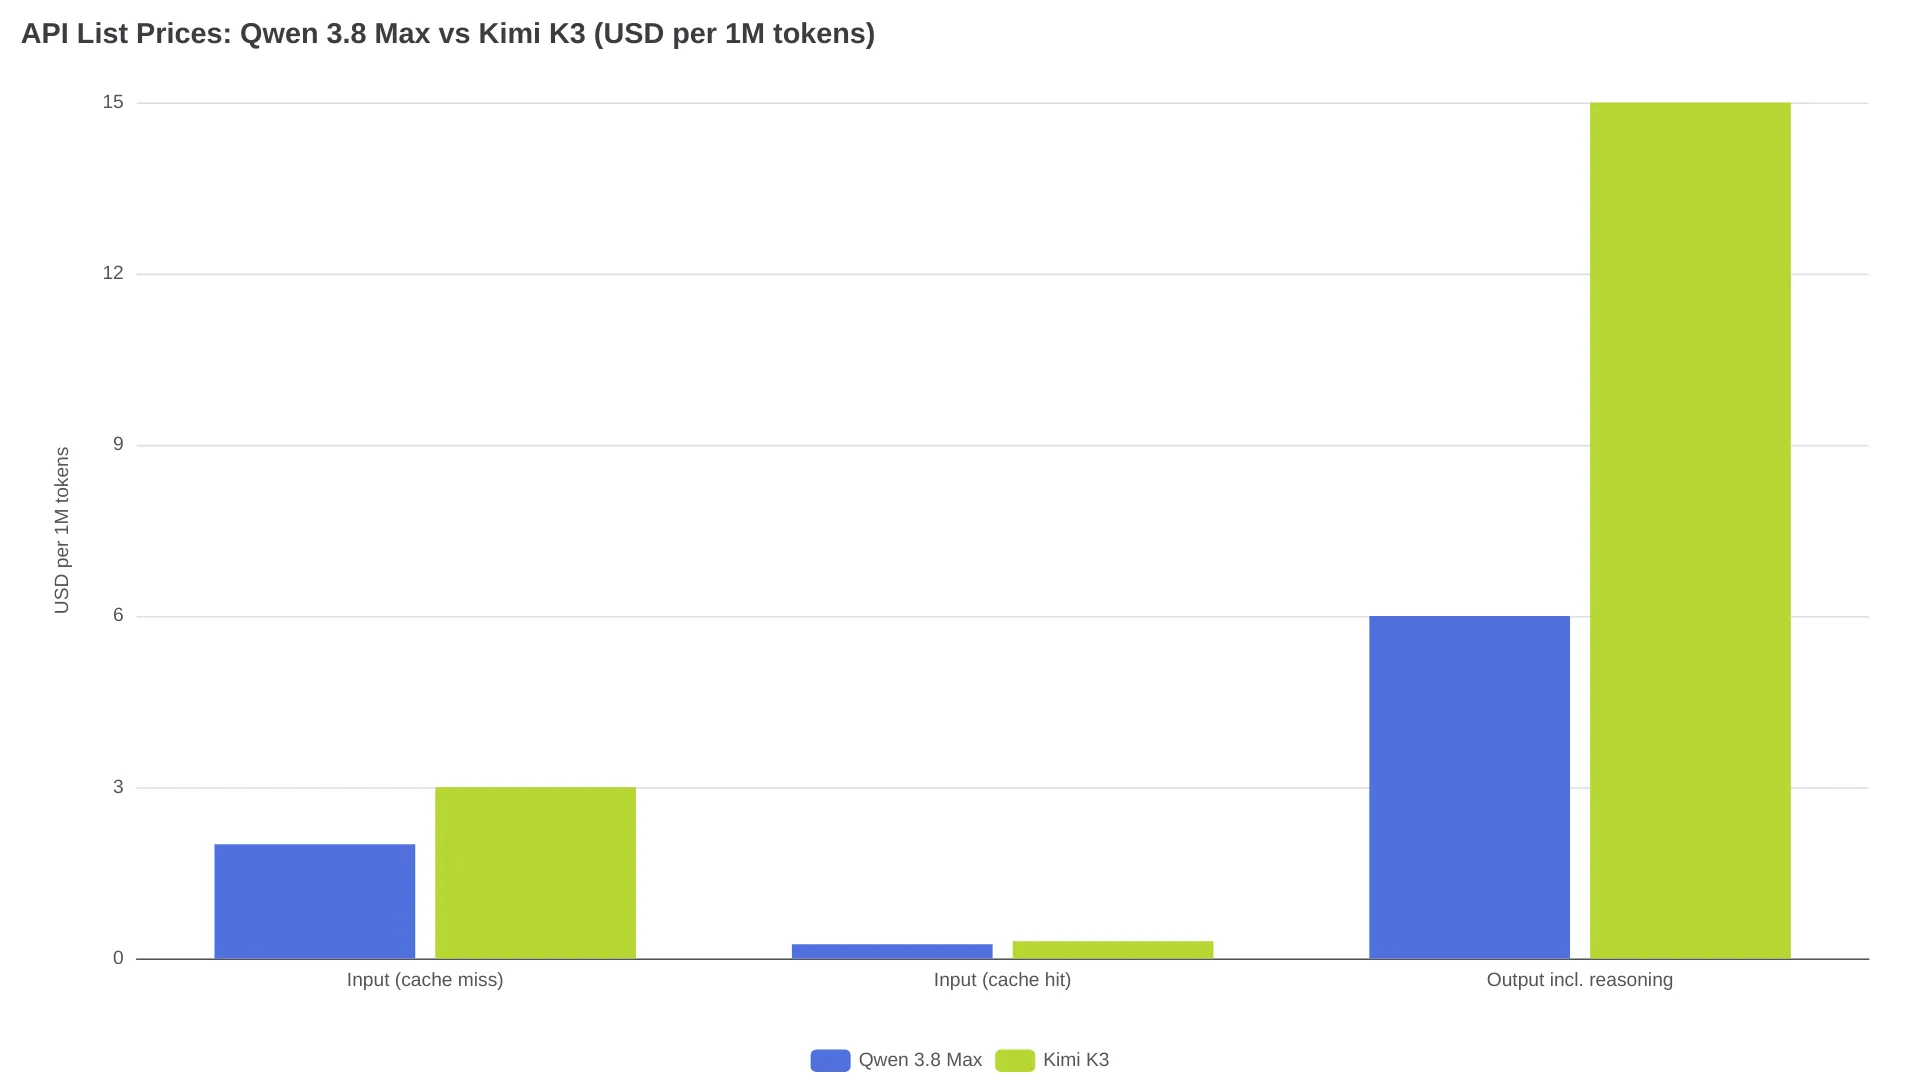
| 100만 토큰당 | Qwen 3.8 Max (QwenCloud) | Kimi K3 (Moonshot) |
|---|---|---|
| 입력 (캐시 미스) | $2.00 | $3.00 |
| 입력 (캐시 히트) | $0.25 | $0.30 |
| 출력, 추론 포함 | $6.00 | $15.00 |
| 명시적 캐시 생성 / 읽기 | $2.50 / $0.17 | — |
2026년 8월 정가를 기준으로 계산한 두 세션은 다음과 같다.
| 세션 | Qwen 3.8 Max | Kimi K3 | 차이 |
|---|---|---|---|
| 에이전트 코딩: 입력 500K (60% 캐시), 출력 40K | $0.72 | $1.29 | 1.8× |
| 새 컨텍스트 문서 파이프라인: 입력 2M, 출력 100K | $4.60 | $7.50 | 1.6× |
여기서 라우팅 기준 하나를 도출할 수 있다. 자신의 워크로드에서 K3의 수용률이 Qwen보다 약 1.8배의 토큰 비용 격차를 넘어설 때에만 K3로 보내는 편이 합리적이다. Moonshot도 저비용 대안을 제공한다. Kimi K2.7 Code는 256K 컨텍스트에서 입력 $0.95 / 출력 $4.00이다. 즉 Kimi 제품군에서 가장 저렴한 코딩 경로는 K3가 아니다. 지금 K3를 라우팅한다면 이곳에서 API 엔드포인트를 Moonshot 공개 요금으로 확인할 수 있다. 양측의 상세 비용 구조는 Qwen3.8-Max 가격 분석과 Kimi K3 가격 가이드에서 다룬다.
셀프 호스팅의 현실: 1.56TB와 RTX 4090 한 장
오픈 가중치라는 두 이야기는 여기서 약 두 자릿수 규모로 갈라진다.
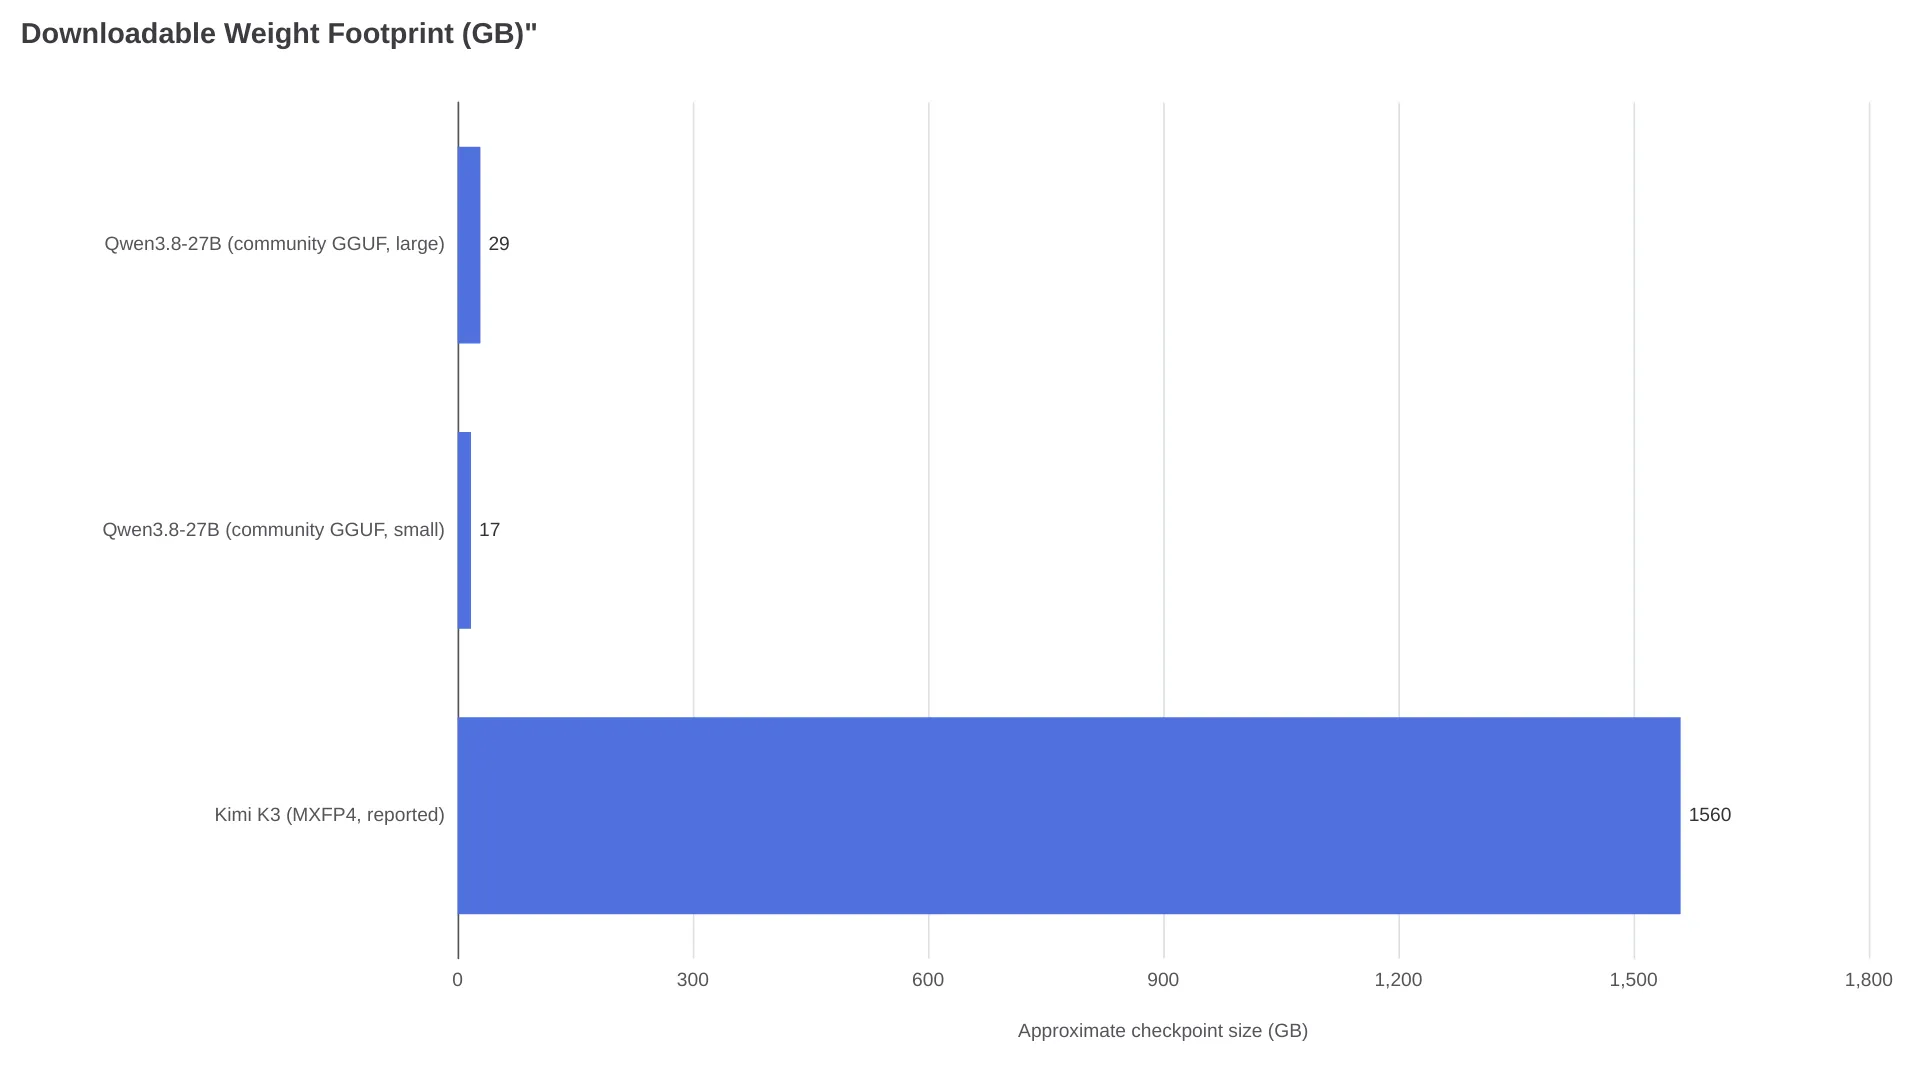
K3는 양자화 인식 MXFP4 가중치로 제공된다. 모델 카드에서도 이를 확인할 수 있다. 하지만 1.56TB로 보고된 체크포인트는 클러스터 프로젝트다. 같은 출처는 64개 이상의 가속기에서 vLLM을 사용할 것을 권장한다. 토큰 하나를 서빙하기 전부터 임대 비용이 발생하며, 여기에 라이선스의 대규모 사용 조건도 적용된다.
27B는 정반대다. 커뮤니티 GGUF 빌드는 약 8.5GB부터 28.9GB까지 분포한다. Unsloth의 동적 GGUF 및 NVFP4 빌드는 최소 약 17GB에 들어가며, 서버 배포용 공식 FP8 변형도 있다. 이미 보유한 하드웨어에서 구동할 수 있는 모델이다.
"Qwen3.8-27B at 160K context on a SINGLE RTX 4090 — 47–57 tok/s, full GPU offload" — r/Qwen_AI 배포 게시물
Max 가중치는 그 중간에 있다. Qwen3.8-2.4T-A95B와 FP8 형제 모델은 커스텀 qwen3.8-max 라이선스로 내려받을 수 있다. 다만 공개 아티팩트는 텍스트 전용이며, 생각 모드는 끌 수 없다. 비전 입력, 비추론 모드, 기본 1M 컨텍스트는 체크포인트가 아닌 QwenCloud API 계층에서 제공된다. 27B가 각 양자화 수준에서 할 수 있는 것과 할 수 없는 것, 런타임과 VRAM 표는 Qwen3.8-27B 필드 가이드에 정리돼 있다. K3의 가중치 공개 내용은 Kimi K3 오픈 가중치 글에서 확인할 수 있다.
에이전트 프로젝트를 좌우하는 통합 세부 사항
모델 카드 수준의 동작 세 가지는 프로덕션에서 처음 맞닥뜨리면 하루를 디버깅에 쓸 수 있는 요소다.
| 모델 | 동작 / 제한 | 구현 시 영향 |
|---|---|---|
| Kimi K3 | 생각 모드는 항상 켜져 있다. 멀티턴 및 도구 사용 클라이언트는 reasoning_content와 tool_calls를 포함한 이전 어시스턴트 메시지 전체를 다시 전송해야 한다 (카드) | 추론 트레이스를 빼면 에이전트 루프 성능이 떨어지고, 유지하면 루프가 길어질수록 비용이 늘어난다 |
| Qwen3.8-27B | preserve_thinking은 기본 활성화이며, reasoning_effort는 medium/low로 낮출 수 있다. 262K를 넘는 YaRN은 정적 스케일링이다 (카드) | 요청별 비활성화를 지원한다. 다만 카드는 낮은 노력 수준이 재시도로 절감분을 상쇄할 수 있어 항상 종단간 시간을 줄이지는 않는다고 경고한다. YaRN은 긴 작업에서만 켜는 편이 좋다 |
| Qwen 3.8 Max와 K3의 한도 | Max: 입력 991.8K / 출력 131.07K (QwenCloud), K3: 입력 1,048,576 / 기본 출력 131K에서 1M에 근접 | 어느 쪽도 ‘1M 컨텍스트’가 1M의 유용한 출력을 보장한다는 뜻은 아니다. 서드파티 니들 테스트는 248K에서 사실 18개 중 18개를 찾았지만, 그 이상은 시험하지 않았다 |
FAQ
코딩에는 Qwen 3.8이 Kimi K3보다 나은가?
현재 उपलब्ध한 근거로는 아니다. Kimi K3는 핵심 에이전트 코딩 항목인 FrontierSWE 81.2 대 73.5, Terminal-Bench 2.1 88.3 대 86.6에서 앞서며, 독립 인덱스 점수도 유일하게 보유하고 있다. Qwen 3.8 Max는 터미널 작업에서 근접한 성능을 내면서 토큰당 비용과 위의 계산 세션 비용이 낮다. 27B는 애초에 완전히 다른 가중치 등급의 모델이다.
Qwen 3.8과 Kimi K3 중 어느 쪽이 저렴한가?
모든 정가 항목에서 Qwen 3.8 Max가 저렴하다. 입력은 $2 대 $3, 출력은 $6 대 $15다. 두 모델 모두 기본 활성화된 추론을 출력으로 과금하므로, 작업 난도가 높아질수록 Kimi의 비용상 불리함은 커진다. 위 계산의 캐시 적용 에이전트 세션에서는 약 1.8배다.
셀프 호스팅할 수 있나? 라이선스는 어떻게 다른가?
그렇다. 세 체크포인트 모두 내려받을 수 있다. Qwen3.8-27B는 Apache-2.0이며 양자화하면 단일 24GB GPU에 맞는다. Kimi K3는 약 1.56TB MXFP4 체크포인트 때문에 클러스터급 하드웨어가 필요하고 커스텀 Kimi K3 License가 적용된다. Qwen3.8-Max 가중치는 Qwen3.8-2.4T-A95B라는 이름으로 공개됐으며 커스텀 qwen3.8-max 라이선스를 따른다.
두 모델 모두 1M 컨텍스트가 실제로 가능한가?
대체로 그렇다. Kimi K3는 1,048,576토큰을 명시한다. Qwen 3.8 Max는 최대 입력 991.8K인 1M을 표기한다. 27B는 기본 262,144이며, 짧은 컨텍스트 품질을 희생하는 YaRN 스케일링을 통해서만 1M에 도달한다. 독립 검증은 248K 수준에서만 존재한다.
용도별 선택과 판단을 바꿀 변수
| 사용 환경 | 추천 | 이유 |
|---|---|---|
| 품질 우선 API 코딩 에이전트 | Kimi K3 | FrontierSWE 81.2, Terminal-Bench 88.3, AA 검증 60 |
| 비용이 중요한 API 작업, 문서/비전 중심 | Qwen 3.8 Max | 출력 $6 대 $15, OSWorld 86.1, 명시적 캐시 읽기 $0.17 |
| 보유 하드웨어에서 셀프 호스팅 | Qwen3.8-27B | Apache-2.0, 약 17~29GB 양자화본, RTX 4090 한 장에서 160K 컨텍스트 |
| 프런티어 플래그십 셀프 호스팅 | Kimi K3 | 여기서 독립적인 프런티어급 점수를 보유한 유일한 오픈 체크포인트 — 클러스터 예산 필요 |
이 표 일부를 바꿀 변수는 두 가지다. 하나는 Qwen 3.8 Max의 독립 평가다. 트래커 보고 수치는 53이고, K3의 검증된 60과 비교하면 근거가 얇다. 다른 하나는 커스텀 qwen3.8-max 라이선스의 공개 약관이다. 둘 중 하나가 나오기 전까지 API 전용 환경의 더 깊은 비교는 Qwen 3.8 Max vs Kimi K3 API 헤드투헤드에서 확인할 수 있다.
함께 읽기: Qwen3.8-27B: 확인된 사실과 17GB에서 실제로 구동되는 것 · Kimi K3 오픈 가중치 · Qwen 3.8 Max vs Kimi K3: API 에디션