 AIREITER
유료 Claude 플랜에서 지식 노동의 기본 모델로 Claude Opus 5.5를 내세운 Anthropic의 판단은 대체로 설득력이 있다. 다만 실제 사용 경험에서 가장 크게 부딪히는 문제도 뚜렷하다. Pro, Max, Team에서는 예상보다 쿼터가 빠르게 닳는다.
Claude 5.5 제품군의 첫 모델인 Opus 5.5는 2026년 9월 22일 출시됐다. Anthropic은 대부분의 작업에서 Claude Fable 5.1급 성능을 내면서도 Opus 5보다 운영 비용은 40% 낮다고 설명했다(anthropic.com). 이어 2026년 11월 12일 공개한 데일리 드라이버 가이드에서는 방향을 더 명확히 했다. 리서치, 분석, 글쓰기, 보고서, 스프레드시트, 프레젠테이션은 Opus 5.5의 Medium 노력 수준으로 시작하고, 부족할 때만 위로 올리라는 것이다(claude.com). 이 글은 공식 가이드, 독립 벤치마크, 사용자 쿼터 제보를 종합한 리뷰이며, Anthropic이 직접 수행한 실험은 아니다.
결론부터: 기본값은 Opus 5.5, 노력 수준은 Medium
기본 모델은 Opus 5.5로 두면 된다. 일반적인 지식 노동에는 Medium으로 시작하고, 모델을 바꾸기 전에 먼저 노력 수준을 올려본다. 판단력보다 속도나 처리량이 우선인 작업이라면 Sonnet 5.5 또는 Haiku 5.5로 내리는 편이 낫다.
이는 브랜드 충성도가 아니라 계산의 문제다. Anthropic의 코딩 및 지식 노동 평가에서 Opus 5.5 Medium은 Opus 5 High와 같거나 더 나은 결과를 냈다. Anthropic의 데일리 드라이버 가이드에 인용된 Factory도 Medium이 Opus 5 High와 동등한 성능을 내면서 출력 토큰은 20~25% 적게 썼다고 밝혔다. Claude 앱과 Claude Code의 기본값도 Medium이므로, 대다수 구독자는 별도 설정 없이 이 동작을 사용하게 된다.
단, 구독자에게 진짜 제약은 API 정가가 아니라 구독 쿼터다. API 가격은 입력 100만 토큰당 $4, 출력 100만 토큰당 $20이며, Opus 5의 $5/$25에서 내려왔다. 캐시 읽기 비용은 100만 토큰당 $0.20이다. 하지만 Anthropic의 데일리 드라이버 가이드가 말하듯 비싼 모델일수록 구독 한도를 더 빠르게 소모한다. 실제 사용자들은 무거운 세션에서 5시간 한도가 15~30분 만에 끝나고, 주간 한도도 9월 초기보다 훨씬 빨리 줄어든다고 보고한다.
11월 기본 모델 전환 이후 Pro·Max·Team에서 달라진 점
구독자에게 중요한 것은 새 기본 모델 아래의 쿼터 작동 방식이다. Anthropic은 출시 당시 Pro, Max, Team, 좌석 기반 Enterprise 플랜의 5시간 사용 한도를 늘리고, 저장해 둘 수 있는 레이트 리밋 초기화 기능을 제공한다고 밝혔다(anthropic.com). 이는 아래에서 다룰 10월 말의 빠른 쿼터 소진 제보가 나온 뒤의 발표다. Anthropic 가이드에 따르면 Pro와 일반 Team, 좌석 기반 Enterprise에서는 출시 프로모션 기간을 제외하면 Fable 5.2가 통상 한도에 포함되지 않는 경우가 많다. Fable은 사용 크레딧을 차감한다. 따라서 Opus는 포함된 주력 모델로, Fable은 별도 과금이 붙는 예외 모델로 계획하는 편이 맞다.
데일리 드라이버라는 평가가 통하는 영역: 리서치·분석·글쓰기
숫자 하나까지 검증해야 하는 리서치 메모
가장 까다로운 테스트는 찾기 어렵게 배치한 실적 발표 자료를 바탕으로 기업 성과 보고서를 만드는 작업이다. 수치나 인용문 하나라도 지어내면 보고서 전체가 실패하는 조건이다. Opus 5.5는 노력 수준을 달리한 18개 보고서 중 16개를 통과했다. Anthropic에 따르면 Fable 5.1과 Opus 5는 어떤 시도에서도 같은 기준을 넘지 못했다(claude.com). Anthropic의 출시 글에 소개된 Walleye Capital의 외부 검증도 흥미롭다. Opus 5.5는 가장 낮은 노력 수준에서 테스트 모음 대부분을 풀었고, 더 높은 수준에서는 평가기 지시문 안의 off-by-one 인덱싱 오류까지 찾아냈다. Walleye는 이전에 테스트한 모델 중 이 오류를 잡아낸 모델은 없었다고 했다.
일상 업무에 적용하면 간단하다. 산출물 형식을 분명히 정하고 출처를 붙인 상태에서 오픈 리서치를 맡긴 뒤, 문장 표현보다 숫자를 우선 감사하면 된다.
스프레드시트와 M&A 계산, 복잡한 차트 분석
가상의 HR 소프트웨어 기업 두 곳의 합병 시나리오에서 Opus 5와 Opus 5.5는 모두 Excel 모델과 경영진용 프레젠테이션을 만들었고, 동일한 거래 결론에 도달했다. 그러나 Opus 5.5는 93분 대신 63분 만에 작업을 끝냈고, 보고된 제작 비용은 50% 낮았으며, 더 충실한 모델과 더 적은 경미한 오류를 보였다(claude.com). 금융 워크플로 전반에서 Hebbia는 Opus 5.5의 기준 충족률을 86.6%로, Opus 5는 60.3%로 보고했다. Rogo는 Anthropic의 출시 글 기준 BigFinance Bench에서 Opus 5 High보다 약 60% 적은 출력 토큰으로 더 좋은 결과를 냈다고 밝혔다.
비전 성능도 같은 맥락에 있다. Anthropic은 Opus 5.5를 자사 Opus 계열 중 비전에 가장 강한 모델로 소개한다. 빽빽한 문서, 차트 수치, 스크린샷, 다이어그램을 대상으로 한다. 또 가장 낮은 노력 수준의 Opus 5.5가 가장 높은 수준의 Opus 5보다 복잡한 차트를 더 정확히 읽었다고 보고했다(claude.com). 공개된 Chartography 점수는 도구 없이 최고 평가 설정에서 64.4%(claude.com)였고, 출시 스코어카드의 도구 사용 점수는 89.0%였다. GDPval-AA 전문 업무 Elo는 1846으로 Fable 5.1의 1735, Opus 5의 1708보다 높다(anthropic.com).
실무에서는 완성된 스프레드시트나 슬라이드 덱을 바로 요청하고, 차트 값은 직접 옮겨 적기보다 이미지를 첨부하는 편이 좋다. 첫 메시지에서 어디까지 하면 작업이 끝나는지도 명시해야 한다.
개요가 아니라 완성 문서와 덱을 만드는 글쓰기
글쓰기에서의 강점은 단순히 문체가 좋다는 이야기가 아니다. 지시를 지키고 검토하기 쉬운 결과를 내놓는다는 데 있다. Anthropic은 Opus 5.5가 범위를 벗어나지 않고, 결론부터 제시하며, 불필요한 전문 용어를 덜 쓰고, 제공된 스타일 규칙을 따른다고 설명한다. 또한 무엇을 했는지, 무엇을 발견했는지, 추가로 필요한 입력이 무엇인지도 알려준다. 독립 평가도 비슷한 방향을 가리킨다. Hayz Labs는 Opus 5.5에 글쓰기 100점, 코딩 100점, 리서치 94점을 줬으며, 10월 점검 기준 Arena에서 WebDev와 에이전트 부문 1위, 창작 글쓰기 2위로 평가했다.
다만 조직 고유의 문체를 정확히 맞추려면 여전히 반복 조정이 필요하다.
노력 수준 다이얼이 사실상 비용표다
eesel의 노력 수준 정리에 따르면 Opus 5.5에는 Low, Medium, High, Very High/Extra High, Max의 다섯 단계가 있다. Hayz Labs에 따르면 사고 과정 자체는 끌 수 없다. 실제 비용에는 토큰 단가보다 이 다이얼의 영향이 훨씬 크다.
eesel이 Artificial Analysis 수치를 요약한 자료에 따르면, 같은 고난도 작업은 Low에서 약 $0.55, Medium에서 $1.34, Max에서 $5.98이 든다. 해당 수준의 Intelligence Index는 각각 약 42, 51, 58이다. Max 실행은 약 119,000개의 출력 토큰을 낼 수 있는데, 출력 100만 토큰당 $20라는 가격에서 비용이 크게 발생하는 지점이다. Hayz Labs의 파레토 분석도 비슷한 수치를 제시한다. 14일간 에이전트 작업당 중앙값은 약 $1.61이며, 본문 표의 중앙값은 $1.76, High는 약 $1.82다.
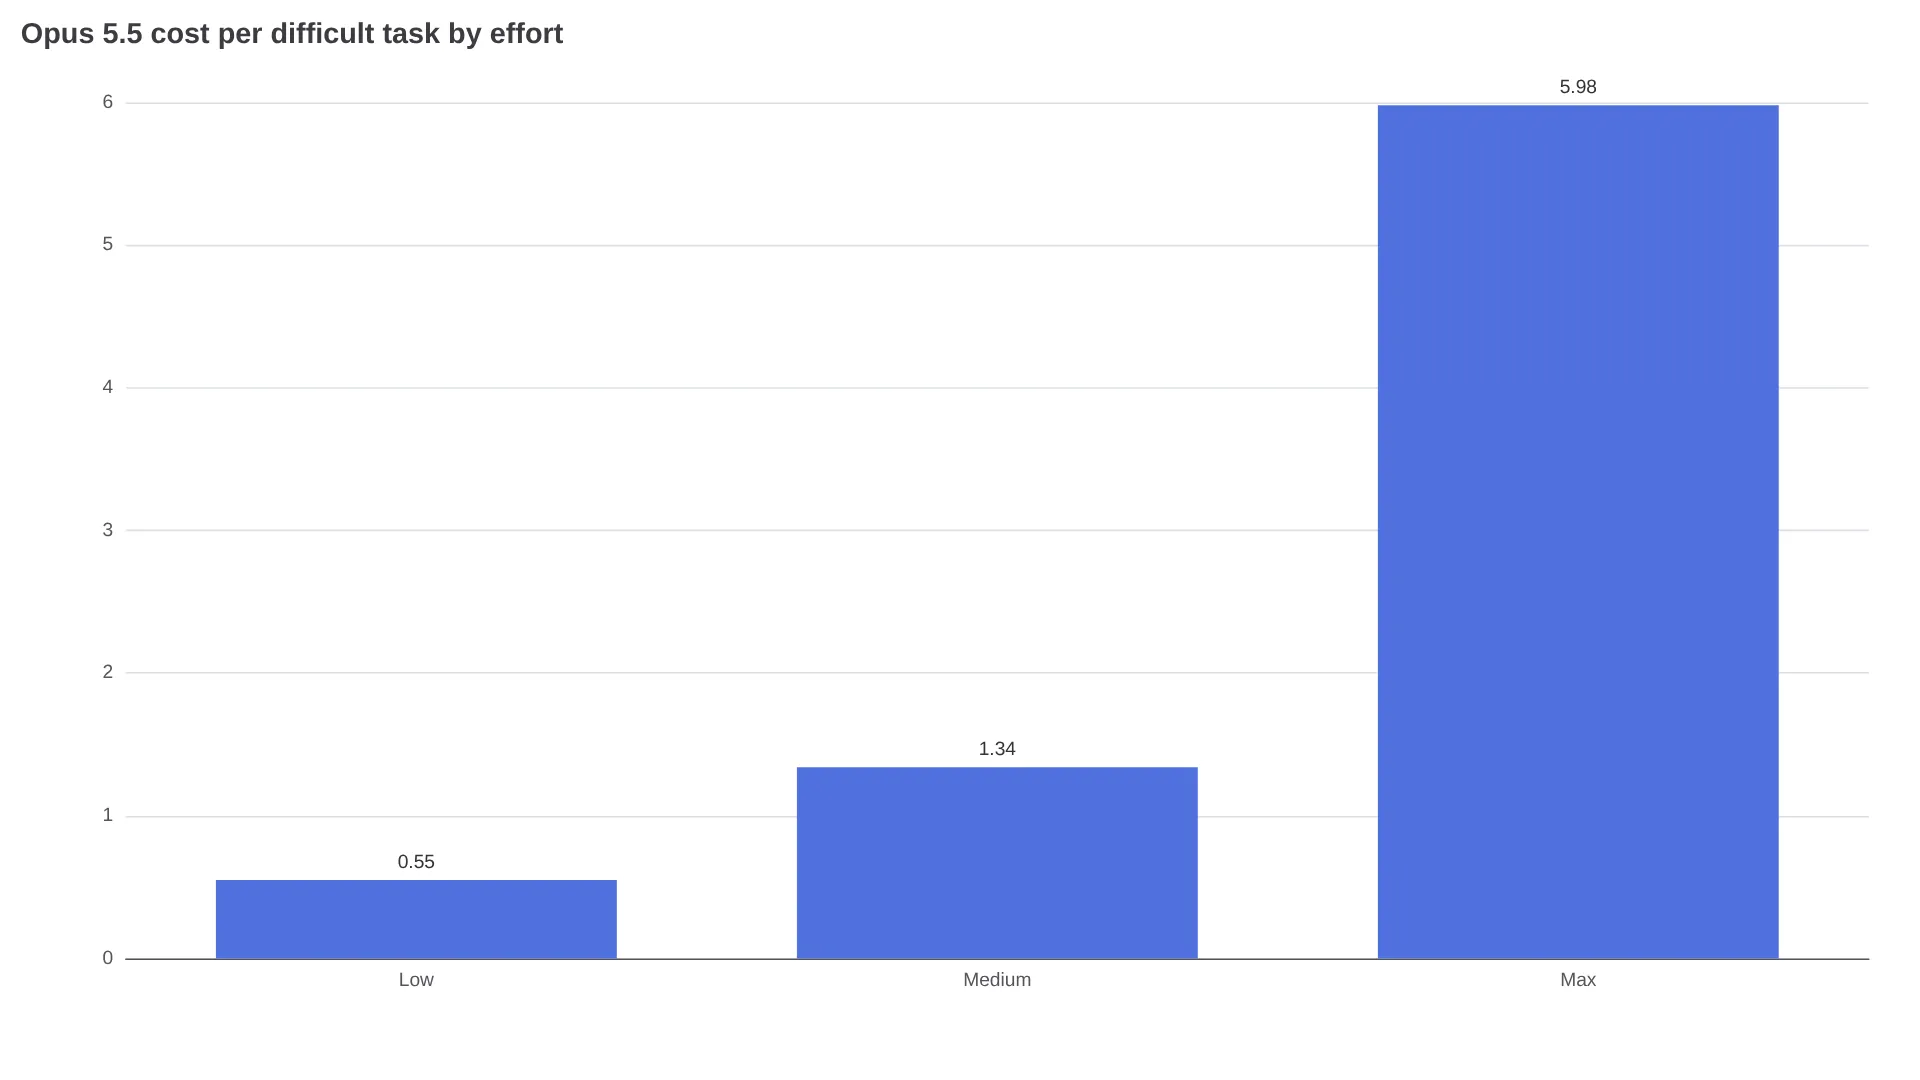
노력 수준을 높이면 시간과 비용이 늘지만, 결과가 언제나 좋아지는 것은 아니다. Anthropic도 "think hard" 같은 문구는 빼라고 조언한다. 이미 추론은 활성화돼 있고, 깊이는 노력 수준과 작업 자체가 결정한다. Medium에서 실제로 막힐 때만 한 단계 올리는 것이 낫다.
eesel의 사양표 기준 컨텍스트 창은 100만 토큰이며 출력은 최대 128,000토큰, Batch에서는 300,000토큰까지 지원한다. 네이티브 비전도 포함된다. eesel의 가격 리뷰에 따르면 장문 컨텍스트 할증은 없다. 긴 문서를 감사하는 워크플로에서 의미 있는 조건이다.
Haiku·Sonnet·Opus·Fable, 네 모델을 나누는 법
Anthropic의 11월 가이드와 독립 비용 분석은 같은 규칙으로 수렴한다. 먼저 노력 수준을 조절하고, 모델 교체는 그다음이다. 아래 가격은 Anthropic의 데일리 드라이버 가이드 가격표를 따른다.
| 모델 | API 가격: 100만 토큰당(입력/출력) | 이럴 때 쓴다 | 바꿔야 하는 시점 |
|---|---|---|---|
| Haiku 5.5 | 100K 토큰까지 $0.10 / $0.50 | 빠른 조회, 요약, 분류, 대량의 좁은 범위 작업 | 분석이 길어지거나 판단 비중이 커질 때 |
| Sonnet 5.5 | $2 / $10 | 명확하고 범위가 정해진 작업, 문서 다듬기, 구체적 브리프 기반 슬라이드 | Extra High 또는 Max가 반복적으로 필요할 때 |
| Opus 5.5 | $4 / $20 | 대부분의 리서치, 분석, 금융 업무, 완성 문서 | High로 제대로 재시도해도 Medium이 막힐 때 |
| Fable 5.2 | $8 / $40 | 장시간 서브에이전트 팀을 쓰는 개방형 기술 작업, 과학, 코딩, 금융 | 일반 지식 노동에서는 대체로 과한 선택 |
기억할 교차점은 이렇다. Sonnet 5.5를 Extra High나 Max까지 밀어 올리면 작업당 비용이 Opus 5.5에 거의 근접하면서도 판단력에서는 뒤처질 수 있다. 코딩 플랜 사용자들도 구독 환경에서 같은 현상을 말한다. Sonnet을 Medium 이상에 상시로 두지 말고, 대신 Opus 5.5 Low로 작업을 옮기라는 것이다(예: @cupid25157). 이는 공식적인 ‘모델보다 노력 수준을 먼저’라는 단계와 작업당 비용 계산에 부합한다.
Fable은 경쟁 모델이 아니라 상한선에 가깝다. Anthropic의 11월 Fable 5.2 스레드는 Fable과 Mythos를 가장 야심 찬 개방형 기술 작업용으로, Opus 5.5를 대부분의 코딩 및 지식 업무에 가장 강한 데일리 드라이버로 설명한다(@claudeai). 구독 환경에서는 차이가 더 선명하다. 일반 Pro/Team 좌석은 Fable 사용을 크레딧으로 청구하는 경우가 많으므로, 가벼운 Fable 사용도 ‘더 좋은 모델’이라는 충동을 크레딧 청구서로 바꿀 수 있다.
5시간 쿼터를 지키는 방법
공식 벤치마크가 건너뛰고 사용자 제보가 집중하는 부분이다. 가장 구체적인 불만은 성능이 아니라 쿼터 소모다.
"Opus 5.5 limits are getting DESTROYED tonight !! Multiple people report 5-hour quotas burning out in ONLY 15-30 minutes on normal sessions. Weekly limits are draining WAY faster" — @TekonBurns, Claude Code 세션 소모를 전하며
일부 사용자는 이 변화를 갑작스러운 초기 혜택 종료로 표현한다. @kgauravnm은 게으른 동작과 빠른 주간 소모를 언급하며 "the Claude Opus 5.5 honeymoon phase is officially over"라고 썼다. @ps_ios_dev 같은 Team 좌석 사용자도 무료 주간 초기화 뒤 Medium 사용량이 빠르게 달린다고 전했다. 다만 한 가지 단서는 남긴다. @sonuv_dev의 67,000개 메시지 Claude Code 로그 분석에서는 도구 호출, 실패율, 불만 비율이 대체로 평평했고, "basically zero evidence of a nerf"라는 결론이 나왔다. 즉 고통의 일부는 비밀스러운 성능 하향보다, 기본 사용량 증가와 더 비싼 추론에서 왔을 수 있다. 한계 상황에서는 모델 선택도 중요하다. @mohitsharmadl은 Fable 5.2 Medium이 Opus 5.5 High로 해결하지 못한 버그를 처리한 사례를 보고했다. 따라서 모든 작업에 Opus를 쓰면 잘못된 상한선에 쿼터를 낭비할 수도 있다.
공식 가이드와 사용자 경험을 함께 반영한 쿼터 운영법은 다음과 같다.
- 기본값은 Opus 5.5 Medium으로 둔다. High는 습관적 성격 설정이 아니라 원인을 확인한 뒤 올리는 단계로 취급한다.
- 하위 작업별로 모델을 쪼갠다. 검색과 분류는 Haiku, 범위가 정해진 초안과 다듬기는 Sonnet, 판단·감사·최종 승인에는 Opus를 쓴다.
- Sonnet을 Medium 이상에 습관적으로 고정하지 않는다. 비용 교차점을 따져 보고, 대신 Opus Low/Medium으로 옮긴다.
- 같은 긴 컨텍스트를 매번 붙여넣기보다 파일을 첨부하고 저장소를 연결한다. 긴 컨텍스트를 재전송하면 매 턴 토큰이 추가돼 측정 사용량이 늘어난다.
- 레이트 리밋 초기화는 실험에 소진하지 말고 실제 마감 주간을 위해 아껴 둔다.
- Fable은 장기 실행, 멀티 에이전트, 개방형 기술 작업처럼 명확히 이기는 좁은 영역에만 쓰고, 좌석에서 크레딧 청구가 되는지 먼저 확인한다.
FAQ: 데일리 드라이버로 쓰기 전 자주 묻는 질문
Claude Opus 5.5는 데일리 드라이버로 충분한가?
판단력과 검토 가능성이 중요한 리서치, 분석, 글쓰기 업무라면 그렇다. Hayz Labs는 에이전트와 WebDev에서 1위, 글쓰기에서는 최고 점수로 평가했고, Anthropic이 인용한 기업 검증도 같은 방향을 보인다. 다만 대량 처리용으로는 더 저렴한 모델을 함께 연결해 두는 것이 좋다.
일상 업무에서는 Opus 5.5가 Sonnet 5.5보다 나은가?
모호하거나 결과의 영향이 큰 업무라면 그렇다. 반면 명확하고 범위가 제한된 대량 작업은 Sonnet Low 또는 Medium이 더 빠르다. Anthropic은 Sonnet을 Fast, Opus를 Moderate로 평가한다(claude.com). 토큰 가격도 대략 절반이다. 문제는 Sonnet을 기본적으로 Extra High나 Max로 돌리는 경우이며, 그러면 비용 절감 효과가 사라진다.
Fable 5.2 대신 Opus 5.5를 써야 하는 때는 언제인가?
대부분의 지식 업무와 일반적인 코딩 작업에는 Opus를 쓴다. Opus High에서도 막히는 개방형, 장기 실행형, 강한 에이전트 중심의 기술 프로젝트라면 Fable로 올린다. 다만 일반 Pro/Team 좌석에서는 Fable이 크레딧으로 청구되는 경우가 많으므로, 먼저 플랜 과금 방식을 확인해야 한다.
100만 토큰 컨텍스트는 긴 문서에서 안정적으로 작동하나?
파일을 첨부한 감사형 작업에서는 Anthropic이 출시한 Opus 구성 중 가장 강력한 선택지이며, 출처 기반 보고서 18건 중 16건을 통과한 결과도 있다. 다만 매우 긴 작업은 여전히 구독 쿼터를 빠르게 소모한다. 모든 작업을 최대 컨텍스트에서 돌리기보다 검색은 Haiku, 판단은 Opus로 나누는 편이 낫다.
계속 지켜볼 트레이드오프
Medium 노력 수준의 Opus 5.5는 지식 노동용 기본값으로 적절하다. 남은 의문은 사용자가 보고한 10월 말 쿼터 경직이 새 표준이 될지다. 그렇게 된다면 출시 메시지가 암시한 것보다 매주 더 많은 업무를 Sonnet으로 처리하게 될 수 있다.
관련 글: Claude Opus 5.5 가격 리뷰, Claude Opus 5.5 High 리뷰, Claude Opus 5.5 vs GPT-6.1 Sol.