 AIREITER
하루 종일 코딩 에이전트를 돌린다면 Gemini 4 Hydrogen과 Claude Sonnet 5.5의 차이는 결국 두 가지로 좁혀집니다. 입력과 출력 토큰을 50 대 50으로 사용하는 기준에서 Hydrogen은 100만 토큰당 $4.50로 Sonnet 5.5의 $6.00보다 약 25% 저렴합니다. 반면 Sonnet 5.5는 사람의 개입 없이 터미널과 컴퓨터 사용 작업을 더 많이 끝냅니다. 에이전트의 실제 작업 비용은 가격표나 벤치마크 순위만으로 판단하기 어렵습니다.
Gemini 4 Hydrogen과 Claude Sonnet 5.5 모두 빠른 코딩과 에이전트 루프를 겨냥한 100만 토큰 컨텍스트를 제공합니다. Hydrogen은 여기에 조절 가능한 사고 수준 네 가지를 더했습니다.
내일부터 Sonnet 5.5 대신 Hydrogen을 쓰면 무엇이 달라질까?
하루 200개의 에이전트 작업을 처리하는 팀이라면 교체 효과를 비용과 개입 빈도에서 바로 체감하게 됩니다. Hydrogen은 토큰 단가가 낮고, LLM Leaderboard의 독립 속도 샘플에서는 Sonnet 5.5의 초당 약 144토큰보다 빠른 초당 약 198토큰을 생성했습니다. 빠른 초안 작성, 병렬 파일 읽기, 신속한 수정에 적합한 ‘대량 실행기’ 유형입니다.
Sonnet 5.5는 ‘신중한 완성자’에 가깝습니다. Google의 출시 비교표에서는 아래 표에 정리한 터미널 및 컴퓨터 사용 중심 벤치마크 세 가지(Terminal-Bench 4.1, OSWorld 2.1, Terminal-Bench-Science)에서 Sonnet 5.5가 앞섰습니다. 명령어 실패 후 복구하거나 작업이 멈추는 상황은 바로 이런 작업에서 발생합니다.
출시 주간의 Reddit 논의에서도 작업 단위로 비슷한 평가가 나왔습니다.
“hydrogen is alright but honestly i don't feel it's better than sonnet 5.5.” — r/GeminiAI의 u/FewKey5274
다만 이 글에는 통제된 코딩 벤치마크가 없습니다. 개별 작업에서의 승리가 전체 워크플로의 에이전트 성능으로 이어진다고 단정하지 말라는 경고로 받아들이는 편이 좋습니다. 마이그레이션 전에 동일한 워크플로에서 두 모델을 직접 테스트하세요.
청구 금액은 $4.50 대 $6.00가 끝이 아니다
공식 API 요금 자체는 단순합니다. Google의 발표에 따르면 Hydrogen은 전체 컨텍스트 구간에서 입력 100만 토큰당 $1.50, 출력 100만 토큰당 $7.50를 일괄 적용합니다. Sonnet 5.5는 Anthropic의 가격표와 OpenRouter의 비교표 기준으로 입력 100만 토큰당 $2.00, 출력 100만 토큰당 $10.00입니다.
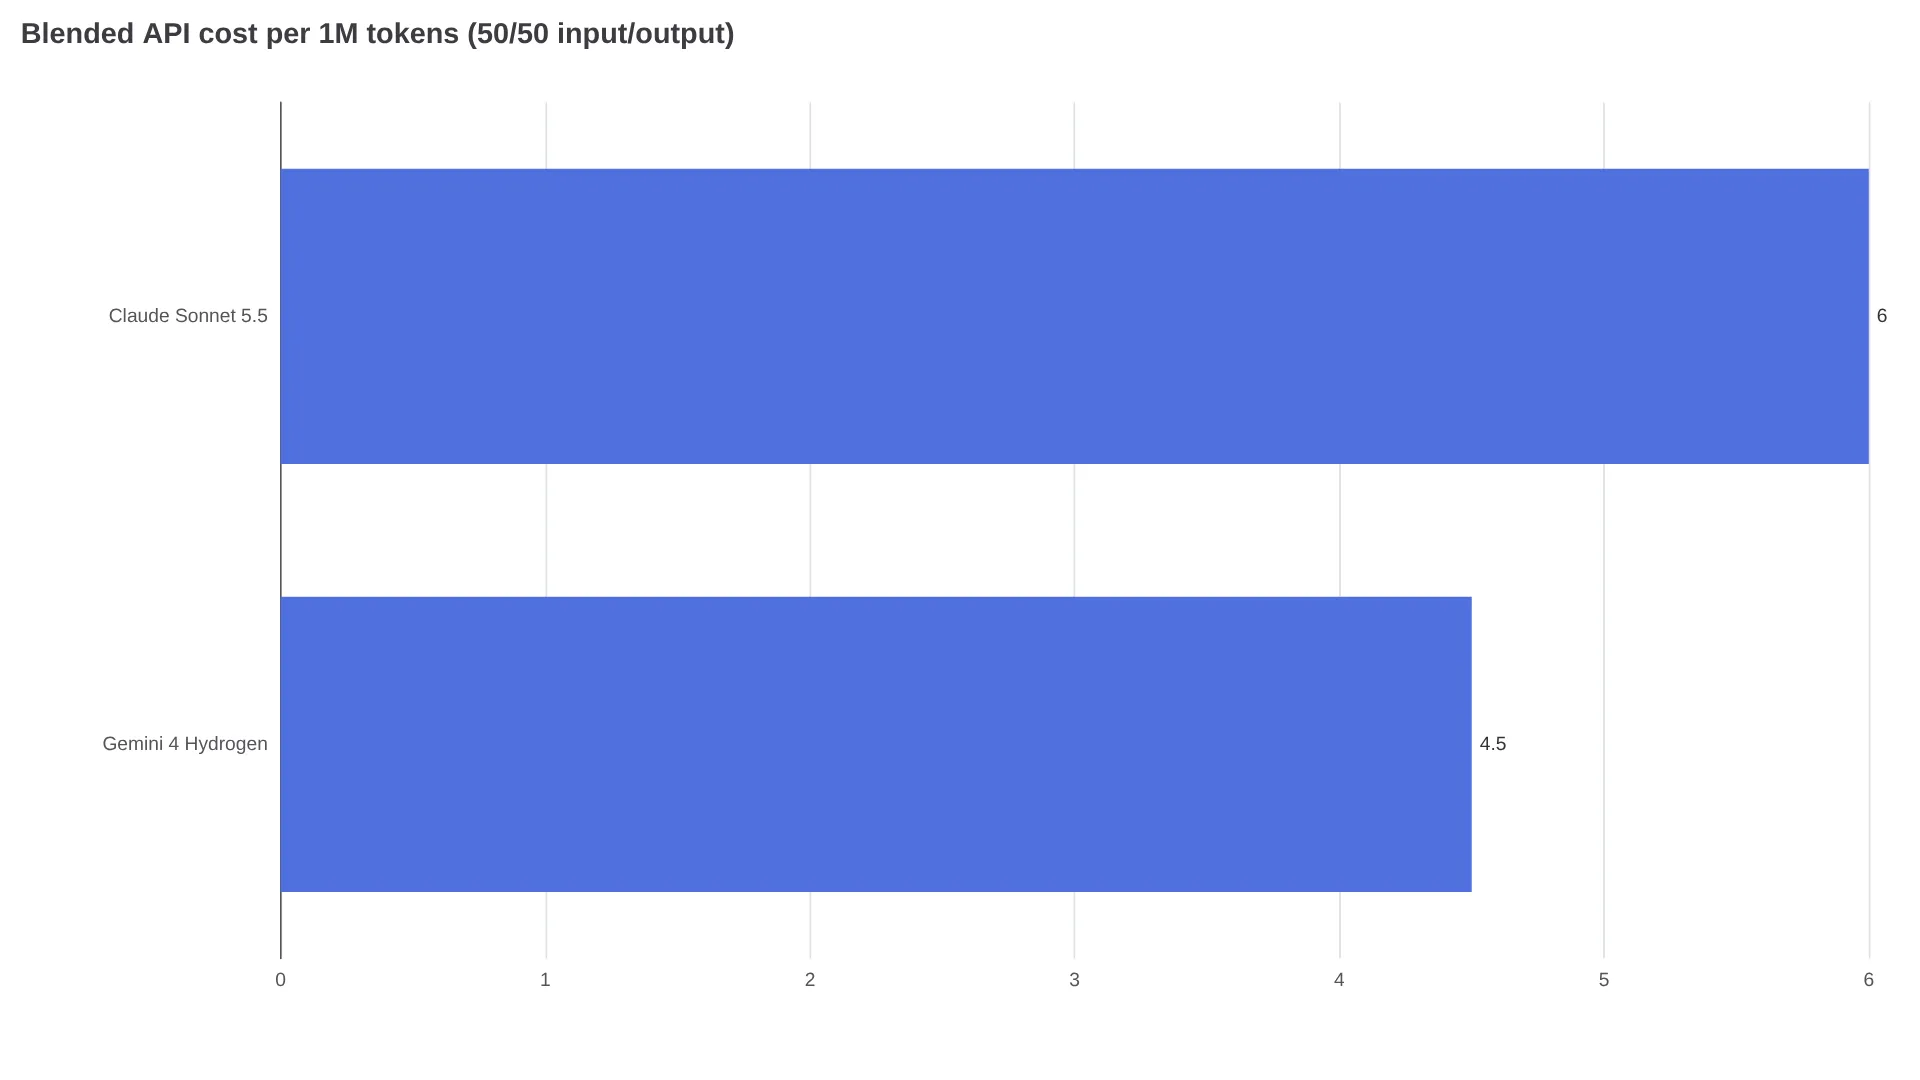
입력 500K와 출력 500K를 합산하는 50 대 50 계산에서는 Hydrogen이 100만 토큰당 $4.50, Sonnet 5.5가 $6.00입니다. 25% 차이는 분명하지만, 실제로 그 차이를 유지할 수 있는지는 다음 세 가지에 달려 있습니다.
- 출력 중심 에이전트일수록 격차가 커집니다. 긴 추론 과정을 포함한 에이전트 루프는 출력 토큰 비중이 커지는 경향이 있습니다. 이때 Hydrogen의 출력 100만 토큰당 $2.50 할인 효과가 가장 크게 나타납니다.
- 캐시와 배치 요금은 계산에서 제외했습니다. Anthropic의 프롬프트 캐시 읽기와 Batch API 할인은 실제 청구액을 몇 퍼센트씩 바꿀 수 있습니다. LLM Leaderboard는 Hydrogen 속도 샘플에서 명시적인 캐싱을 지원하지 않았다고 밝혔습니다.
- 예시로 계산하면 차이가 선명해집니다. 한 에이전트 턴이 평균 입력 10K, 출력 3K 토큰을 사용하고 하루 1,000턴을 처리한다고 가정해 보겠습니다. 하루 입력 10M 토큰과 출력 3M 토큰이 발생하며, 정가 기준 Hydrogen은 약 $37.50/일, Sonnet 5.5는 $50.00/일입니다. 재시도 비용을 제외하면 22일 근무 기준 동시 실행 에이전트 하나당 월 약 $275 차이입니다.
실제 승자를 가르는 것은 재시도입니다. 작업 하나를 완료하는 비용은 성공률을 반영한 시도당 토큰 비용에 사람의 수정 시간을 더한 값입니다. 단순한 예로 Hydrogen의 하루 비용 $37.50에서 첫 시도 성공률이 80%라면, 토큰 비용만으로 완료 작업 1,000개당 약 $46.90가 듭니다. Sonnet은 하루 $50.00에 첫 시도 성공률 95%일 때 약 $52.60입니다. 성공률이 달라지면 격차는 빠르게 줄어듭니다. 어느 회사의 표를 믿기보다 2주 동안 첫 시도 머지율을 추적하는 편이 정확합니다.
벤치마크는 승자보다 작업 유형에 따라 갈린다
Google의 출시 비교표와 DeepMind 모델 카드에는 Hydrogen, Sonnet 5.5, GPT-6.1 Terra의 10개 평가 결과가 담겨 있습니다. Hydrogen은 Sonnet 5.5를 상대로 10개 중 7개에서 앞섰고, 나머지 3개는 Sonnet 5.5가 우세했습니다. 공급업체 행은 각 진영의 자체 하네스를 사용했으며, 독립 평가 행은 LLM Leaderboard의 재실행 결과입니다.
| 작업 유형 | 벤치마크 | Gemini 4 Hydrogen | Claude Sonnet 5.5 |
|---|---|---|---|
| 저장소 코딩 | SWE-sweep (공급업체) | 13.5% | 3.1% |
| 저장소 코딩 | Terminal-Bench 4.1, 부정행위 보정 (공급업체) | 57.0% | 63.9% |
| 지식 자동화 | Agents' Last Exam v1.1 (공급업체, 하네스 영향 큼) | 71.6% | 60.4% |
| 지식 자동화 | AutomationBench-AA (공급업체) | 76.1% | 71.8% |
| 지식 자동화 | Vending-Bench 2 최종 잔액 (공급업체) | $14,549 | $11,165 |
| 컴퓨터 사용 | OSWorld 2.1 오프라인 하위 세트 (공급업체) | 77.6% | 83.9% |
| 멀티모달 | MKA Climb WSR (공급업체; 독립 평가 49.52%) | 53.4% | 52.0% |
| 멀티모달 | Chartography (출처 혼합) | 66.6% | 61.6% |
| 과학 | Terminal-Bench-Science 0.1 (공급업체; 독립 평가 49.52%) | 51.4% | 59.9% |
| 추론 | HLE-Diamond (독립 평가 xhigh) | 58.8% | 53.3% |
에이전트의 성패는 도구 호출에서 갈린다
벤치마크는 답변을 평가하지만, 에이전트는 도구 호출로 움직입니다. 파일을 묶어서 읽고, 적절한 함수를 호출하고, 검색 결과가 없거나 명령어가 실패했을 때 복구하는 능력이 핵심입니다.
Google은 Hydrogen이 파일과 검색 결과를 순차적으로 확인하는 대신 병렬로 묶어 처리하며, 관련 없는 파일까지 다시 작성하지 않고 저장소의 필요한 부분만 수정한다고 설명합니다. 출시 게시물에 소개된 파트너 보고서는 Gemini 3.8 Flash보다 그래프 및 SQL 작업이 2배에서 2.8배 빠르고 토큰 사용량은 12%에서 23% 적었다고 전합니다. 기본 고도 추론에서는 완료 속도가 2.5배 빨라졌다는 내용도 있습니다. 다만 이는 공급업체가 선택한 파트너 수치로, 방향성을 보여줄 뿐 보장된 결과는 아닙니다.
반대편에는 하네스 성숙도 문제가 있습니다. Claude Code와 Antigravity 비교 스레드에서 사용자들은 Antigravity의 가동 시간 문제와 SSH, 재사용 가능한 훅, 스킬, 서브에이전트 같은 워크플로 구성 요소의 부재를 지적했습니다. 출시 주간 사용자들의 인식일 뿐 통제된 측정 결과는 아니며, 모델 가중치가 아니라 하네스에 관한 평가입니다.
프로덕션 에이전트를 옮기기 전에 세 가지를 확인하세요. MCP 서버 수가 늘어난 환경에서 병렬 도구 호출이 안정적인지, bash나 브라우저 단계가 실패한 뒤 얼마나 잘 복구하는지, 권한 경계를 어떻게 처리하는지입니다. Google의 내부 평가에서는 에이전트의 과도한 개입이 최대 81% 줄고, 불충분한 서비스가 79% 줄었으며, 에이전트 정직성 평가에서 96.7%를 기록했다고 주장합니다. 차단된 작업과 막다른 검색을 포함한 50개 작업의 카나리 테스트로 직접 확인하세요.
사고 수준은 high가 기본, xhigh는 선택적으로
Hydrogen은 low, medium, high, xhigh 네 가지 수준을 제공하며 기본값은 high입니다. Google의 사고 수준 표에 따르면 Artificial Analysis Intelligence Index v5.0.1 점수는 low에서 xhigh로 갈수록 27 / 41 / 51 / 54로 올라가며, 기본값인 high(51)는 Argon(50)을 근소하게 앞섭니다. 같은 표의 Terminal-Bench 4.0에서는 high가 54.0%로 xhigh의 53.5%보다 높았습니다. 반면 AutomationBench-AA는 60.5%에서 76.1%로, HLE-Diamond은 32.2%에서 58.8%로 꾸준히 상승합니다.
에이전트 루프에서는 high로 시작하고, 추론이 병목인 개별 작업에만 xhigh를 적용하는 방식이 적절합니다. 분석, 종합, 여러 문서를 다루는 조사 작업이 대표적입니다. 이후 토큰 증가량을 확인하세요. DeepMind 모델 카드에 따르면 Hydrogen은 사고 수준이 높아질수록 더 많은 토큰을 사용할 수 있습니다. 지식 기준일은 2026년 3월이므로 최신 정보가 필요한 작업에는 어느 쪽이든 검색이나 검색 기반 데이터 제공이 필요합니다.
마이그레이션 전에 반드시 확인할 하네스 문제
DeepMind 모델 카드에 따르면 Hydrogen은 입력 1,048,576토큰 컨텍스트와 동기식 출력 최대 64K를 제공하며, 백그라운드 장기 디코딩에서는 최대 1M까지 지원합니다. Anthropic 문서 기준 Sonnet 5.5는 입력 1M, 출력 최대 128K를 제공합니다. 표면적인 컨텍스트 크기는 비슷해 보여도 대규모 코드베이스 작업에서는 압축 방식이 결과를 좌우합니다. 사양표에 적힌 크기보다 50턴 뒤에 얼마나 많은 정보가 남는지를 확인해야 합니다.
| Gemini 4 Hydrogen | Claude Sonnet 5.5 | |
|---|---|---|
| 컨텍스트 / 출력 한도 | 입력 1,048,576토큰; 동기식 출력 64K (백그라운드 디코딩 1M) | 입력 1,000,000토큰; 출력 128K |
| 실행 환경 | Gemini API, AI Studio, Antigravity, Gemini 앱, Google 기준 | Claude API, Bedrock, Vertex AI, Microsoft Foundry, Anthropic 기준 |
Antigravity와 Claude Code 비교 스레드에서는 모델 품질보다 하네스 안정성이 더 큰 마이그레이션 위험으로 언급됩니다. 사용자들은 압축 후 정보 보존, 쿼터 유지, 가동 시간에 의문을 제기했습니다. 두 하네스에서 동일한 저장소, 동일한 커밋, 동일한 프롬프트, 동일한 승인 테스트를 실행한 뒤 구독 기간 내 완료 작업 수와 첫 시도 머지율을 비교하세요.
60초 만에 고르기: 에이전트 유형 세 가지
모든 에이전트에 통하는 단 하나의 승자는 없습니다. 위 벤치마크 분할을 바탕으로 한 편집상 판단이며 실제 측정 시험 결과는 아니지만, 병렬·반복 실행은 Hydrogen에, 복구가 중요하고 장기적으로 이어지는 작업은 Sonnet 5.5에 배정하는 구성이 합리적입니다. 플래너와 실행기를 한 공급업체 제품으로 통일하면 인증과 컨텍스트 압축을 일관되게 유지할 수 있습니다. Claude 플래너와 Hydrogen 워커를 섞는 방식은 단일 공급업체 기준선을 먼저 측정한 뒤 시험해 볼 가치가 있습니다.
| 에이전트 유형 | 추천 | 이유 (근거 수준) |
|---|---|---|
| 대규모 실행기: 일괄 수정, 보일러플레이트, 데이터 가공, 멀티모달 분류 | high 설정의 Hydrogen | AutomationBench, Agents' Last Exam, Vending-Bench의 공급업체 벤치마크 우위; 독립 속도 샘플에서 약 198 대 약 144 tok/s |
| 장기 작업 완성기: 터미널 중심 디버깅, OS/브라우저 자동화, 과학 도구 | Sonnet 5.5 | Terminal-Bench 4.1, OSWorld 2.1, Terminal-Bench-Science에서 공급업체 벤치마크 우위; Claude Code의 훅과 서브에이전트 생태계에 대한 평가 |
| 리서치 종합기: 긴 문서, 차트, 오디오/비디오, Sheets 중심 분석 | high 설정의 Hydrogen, 가장 어려운 단계에는 xhigh | HLE-Diamond, Chartography, MKA에서 공급업체 우위; 다만 독립 MKA 재실행 결과는 49.52%로 더 낮았다는 점에 유의 |
Hydrogen이 정말 Sonnet 5.5보다 빠를까?
LLM Leaderboard 샘플에서는 처리량이 Hydrogen에 유리합니다(초당 약 198토큰 대 144토큰). 하지만 OpenRouter의 실시간 p50 피드에서는 Sonnet 5.5가 지연 시간에서 앞섭니다(중앙값 2.08초 대 6.92초). 공급업체, 지역, 부하가 다르기 때문입니다. 실제로 사용할 공급업체 환경에서 두 모델을 측정하세요.
Claude Code 안에서 Hydrogen이 Sonnet 5.5를 대체할 수 있을까?
모델 ID만 바꿔서는 어렵습니다. Sonnet 5.5는 Claude Code에서 기본적으로 실행되며, 팀들은 훅, 스킬, 서브에이전트에 의존합니다. Hydrogen은 Gemini API, AI Studio, Antigravity, Gemini 앱을 통해 실행됩니다. 따라서 대체하려면 하네스 자체를 마이그레이션해야 합니다.