 AIREITER
リアルタイム音声AIはすでに珍しくない。しかしByteDanceが2026年8月5日に公開したSeedRealtimeのポイントは、単に音声をリアルタイムで扱うことではない。音声・映像・テキストを単一のエンドツーエンドモデルで統合し、誰がいつ話すべきかを外部モジュールに任せず判断する、音声・映像フルデュプレックスLLMだ。開発者にとっての注意点は、発表時点では一般向けAPIも価格情報もなく、ByteDance自社プロダクト内で提供されていることにある。
SeedRealtimeとは何か
ByteDanceのSeedチームが開発したSeedRealtimeは、音声、映像、テキストを単一アーキテクチャへ統合したモデルだ。データを複数の処理段階へ受け渡すのではなく、連続するマルチモーダルストリームを対象に、認識、理解、判断、応答を一体で処理する。
ByteDanceはその特徴を「見て、聞いて、同時に話す」と表現する。聞こえる情報と見える情報を組み合わせ、リアルタイムの対話応答に反映するという位置付けだ。SeedRealtimeはSeedモデル群の一つで、Doubaoを支えるLLMファミリーのSeed2.1、動画生成のSeedance、画像生成のSeedream、音声生成のSeed Audio 1.0、ロボティクス向けのSeed GR-RLと並ぶ。
単純な分類には収まりにくいモデルでもある。音声を生成するだけでなく理解もするためTTSモデルではなく、会話のために視覚を使うため単なる視覚モデルでもない。既存のリアルタイム音声ボットの延長線上にあるものとも言い切れない。
SeedRealtimeの核は「フルデュプレックス」
フルデュプレックスとは、相手の話を聞きながら同時に応答できることを指す。実際の会話のように、誰が話しているか、どのタイミングで口を挟むべきかを継続的に捉える仕組みだ。SeedRealtimeは、音、映像、時間的な流れ、表現を単一のエンドツーエンドモデルに統合することで、モジュールを後付けせずにこれを実現するとしている。
リアルタイムAIの対話には、従来大きく2つの方式があった。カスケード型は、ASR(音声認識)からLLMまたはVLM、そしてTTS(音声合成)へと順番に処理をつなぐ。モジュールごとに検証しやすい反面、受け渡しのたびに遅延と情報損失が生じる。話し方の調子、発話の重なり、アクセント、視覚的文脈は、ASRの段階で失われやすい。エンドツーエンド型の音声モデルはこうした受け渡しを省き、より自然な応答を目指す。ただし多くは、発話ターンを判定する外部のVAD(音声活動検出)に依存しており、実質的には「質問して回答を待つ」半二重の対話にとどまる。
SeedRealtimeでは、認識、理解、意思決定、表現を一つのモデルに収め、連続する音声・映像ストリーム上で並列に実行する。ターンの判定を行う外部VADは用いない。
| 方式 | 仕組み | デュプレックス | ターン判定 | 主な弱点 |
|---|---|---|---|---|
| カスケード型(ASR + LLM/VLM + TTS) | モジュールを順番に連結 | 半二重 | 固定的な終端判定 | 受け渡しごとの遅延と情報損失 |
| エンドツーエンド + 外部VAD | 単一モデルに外部ターン検出器を組み合わせる | 半二重 | 外部VAD | 依然として一問一答になりやすい |
| SeedRealtime | 音声・映像を統合したエンドツーエンドモデル | 全二重(同社の主張) | モデル内部でマルチモーダルに判定 | 最新モデルであり、性能はベンダーの説明に基づく |
特に難しいのは映像だ。音声のような自然な切れ目がないため、モデルは常に、どの物体に注目するか、誰の声を重視するか、今が発話すべき瞬間かを判断し続けなければならない。その際、周囲の雑音には反応しないことも求められる。
ByteDanceが示す3つの能力
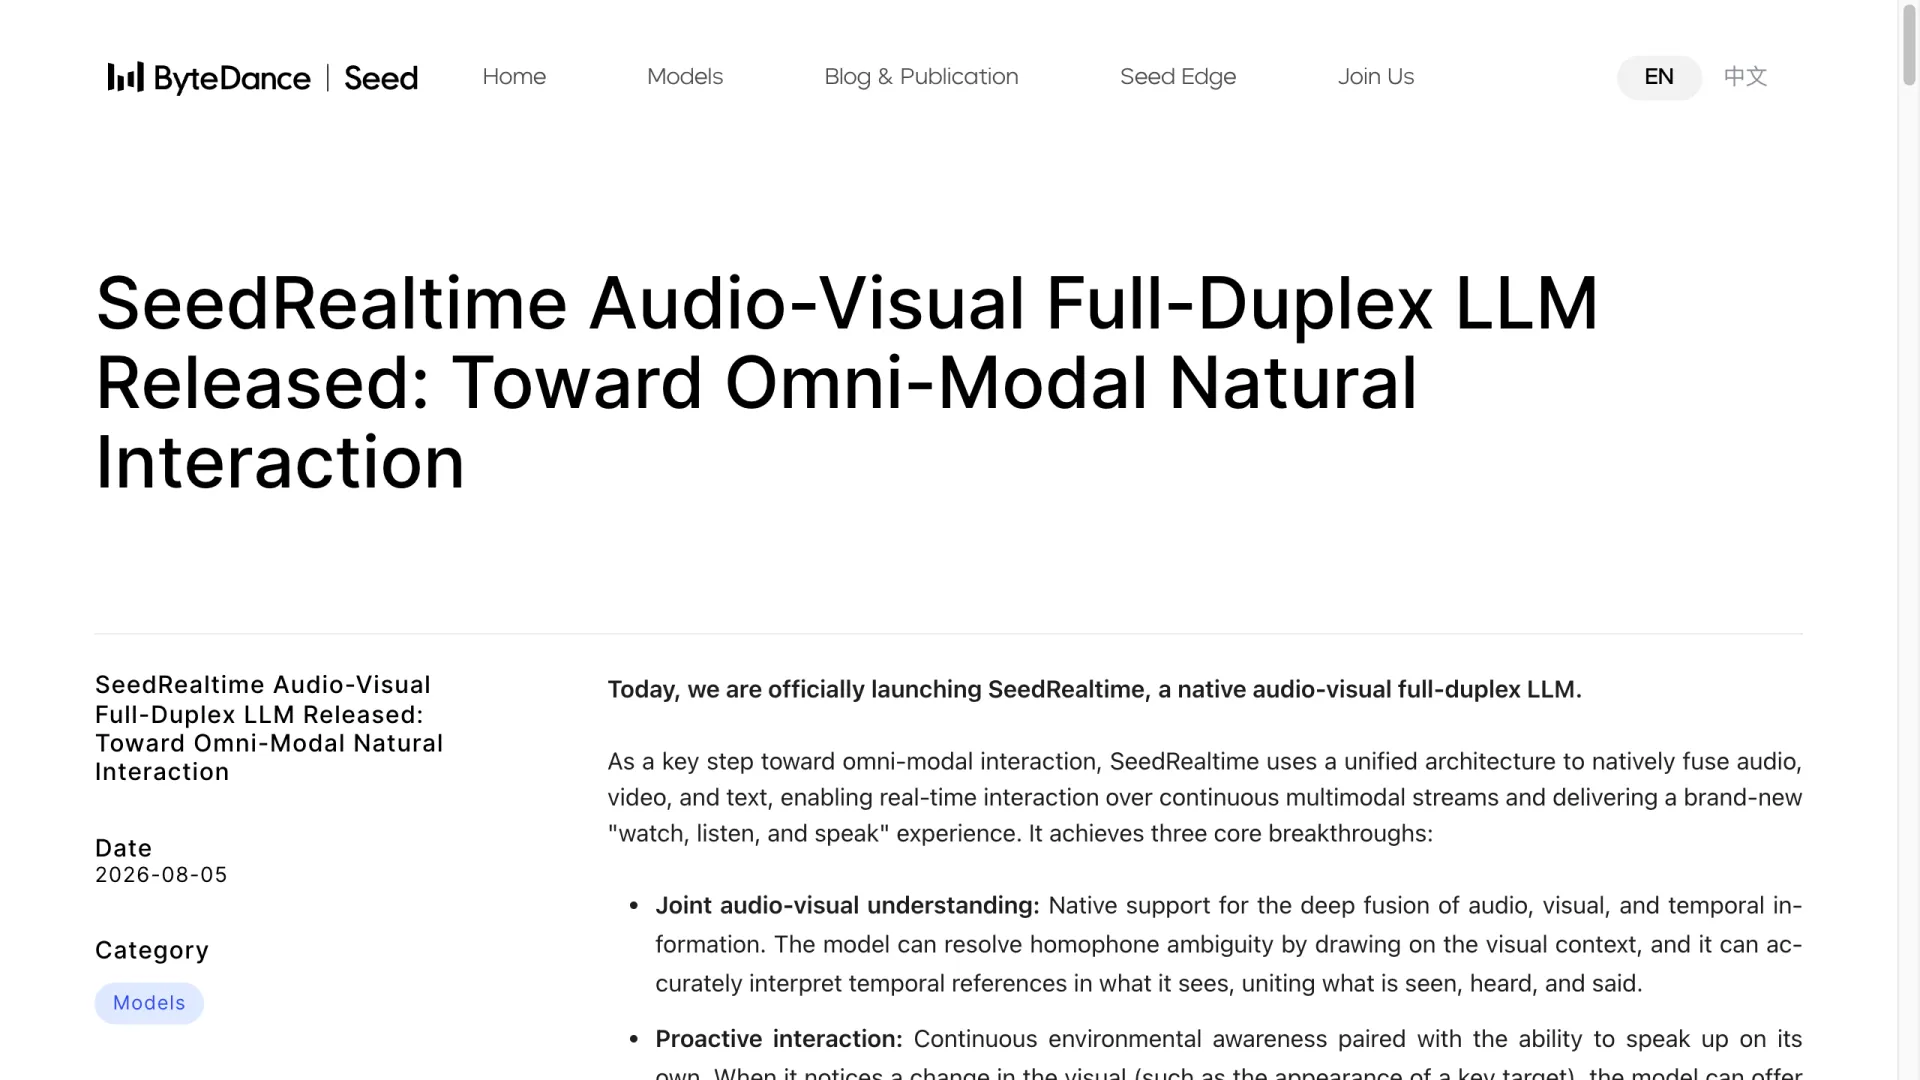
ByteDanceはSeedRealtimeの挙動を、「音声と映像を組み合わせた理解」「能動的な対話」「自然な会話タイミング」という3つの能力に整理している。ベンチマークの数値ではなく、具体的な利用シーンでそれぞれを提示した。
音声と映像を合わせて状況を理解する
モデルは目の前の状況を使って、曖昧な発話の意味を特定する。たとえばユーザーが「これをどうやるの?」と尋ねたとき、画面、ジェスチャー、視線、それまでの操作を組み合わせ、「これ」が何を指すかを判断する。
ByteDanceのデモでは、夕食の場でユーザーが4人の友人を一人ずつ紹介すると、SeedRealtimeが名前と顔を対応付ける。その後、旅行先を相談するグループ対話でも、各人の声と本人を結び付けたまま処理する。条件は、ビーチに行きたい人、暑さが苦手な人、シーフードアレルギーの人がいるというものだ。四川料理店では、カメラに映した中国語だけのメニューを読み取り、英語で料理を勧め、「魚香肉絲」に魚が入っていない理由も説明する。
状況に応じて自ら話しかける
SeedRealtimeは質問を待つだけでなく、場面が変化したときに自ら発話する。博物館を巡るユーザーが「青銅製の虎が鹿を食べる台座を見つけたら教えて」と頼むと、カメラ映像を監視し、その展示品が現れた時点で通知と作品の解説を行う。
コーヒー豆をそのままポルタフィルターへ入れようとする様子を見れば、先に細かい粉へ挽くよう促す。抽出後には、クレマの色を根拠に、次回は抽出時間を2〜3秒短くするよう提案する。検索や予約といったツール呼び出しも、別工程として扱うのではなく、こうした応答に組み込まれる。
会話の間を自然に扱う
SeedRealtimeはマルチモーダルな文脈から、話すべきとき、待つべきとき、黙っているべきときを決め、誤作動を抑えるという。混雑した北京の空港では、同行者が何気なく口にした「Old Li's flight」という言葉には反応しない。一方で質問されると、すでに画面から消えた出発案内板の情報を思い出し、荷物受取所の場所についてはオンラインで調べる。自宅では、親が背景で電話していても、それに引きずられず、子どもの英語発音を直すことに集中する。
ByteDanceのエンドツーエンドの人間評価によれば、カスケード型モデルと比べ、SeedRealtimeは音声・映像会話のテンポに関する問題をおよそ半減させたという。具体的には、文の途中での遮り、間の後の鈍い応答、ノイズによる誤反応が減少し、1ターンを滑らかに完結できる割合も高かったとする。ただし、これは独立ベンチマークではなく、ベンダー自身による評価だ。
GPT-4o Realtime、Gemini Live、カスケード型との違い
実用面で気になるのは、すでに開発者が利用できるリアルタイムシステムと何が違うのか、という点だ。率直に言えば、既存の「リアルタイム」APIの多くは音声が中心である。SeedRealtimeが差別化要素として掲げるのは、音声と映像を統合して扱い、フルデュプレックスで対話することだ。
OpenAIのRealtime APIと、Googleの一般ユーザー向け機能Gemini Live、および開発者向けのLive APIは、いずれも低遅延のリアルタイム対話インターフェースだ。ただし中心は音声入力と音声出力であり、視覚情報は別の形で扱われ、ターン判定も終端判定やVADに依存する。これに対してSeedRealtimeは、ネイティブな音声・映像統合、モデル内部で行うフルデュプレックスのタイミング判断、能動的な働きかけ、会話に組み込まれたツール利用を組み合わせるものとして位置付けられている。
| モデル | ネイティブ対応モダリティ | デュプレックス | ターン判定 | 能動動作 / ツール利用 | 公開API |
|---|---|---|---|---|---|
| SeedRealtime | 音声 + 映像 + テキスト(統合) | 全二重(同社の主張) | モデル内部、マルチモーダル | あり、会話に統合 | なし(発表時) |
| GPT-4o Realtime API | 音声 + テキスト | リアルタイム、VAD管理 | 外部の終端判定 | 関数ツール経由 | あり |
| Gemini Live / Live API | 音声 + テキスト(一般向けアプリではカメラ対応) | リアルタイム、VAD管理 | 外部の終端判定 | 限定的 | あり(Live API、音声) |
| カスケード型スタック | テキスト(音声はASR/TTS経由) | 半二重 | 固定 | 独自実装 | 自前構築 |
SeedRealtimeの利点は、ByteDance自身のデモと評価に基づくものだ。GPT-4o RealtimeやGemini Liveとの直接比較は公開されていない。上の比較は計測済みの優劣ではなく、アーキテクチャ上の位置付けとして捉えるべきだろう。
開発者はSeedRealtimeを使えるのか
2026年8月5日の発表時点で、SeedRealtimeは開発者向けAPIとして利用できない。ByteDanceは「fully rolled out」としているが、これは誰でも呼び出せる公開エンドポイントを意味するのではなく、自社プロダクト内への展開を指す。
発表時点でSeedRealtimeには公開API、料金ページ、開発者ドキュメントがない。ByteDanceの商用API部門は、Doubaoモデル群を提供するVolcengine(火山引擎)だ。ここではSeed 2.1 Pro、Turbo LLM、Seed-ASR、Seed-TTSなどを扱うが、SeedRealtimeは発表時点の一覧には含まれていない。サードパーティーの中継サービスにも、これに相当するリアルタイム音声・映像モデルはない。
現時点でリアルタイムエンドポイントを必要とするチームにとって、現実的な選択肢は音声中心のOpenAI Realtime API、Google Live API、あるいは自前で構築するカスケード型スタックとなる。SeedRealtimeは、利用できる製品というより注目すべきアーキテクチャだ。ByteDanceはVolcengineまたはBytePlusでのリアルタイムAPI提供日を明らかにしていない。
FAQ
SeedRealtimeは一般公開されている?
2026年8月5日の発表時点でByteDance自社プロダクトには展開されているが、登録して利用できるSeedRealtimeという名称の一般向けアプリやエンドポイントは存在しない。
SeedRealtimeにAPIはある?
発表時点ではない。ByteDanceはAPIアクセス、価格、開発者ドキュメントを公開していない。将来的にはVolcengineのDoubao API群で提供される可能性が考えられるが、現時点の一覧にSeedRealtimeはない。
SeedRealtimeはGPT-4o Realtimeとどう違う?
GPT-4oのRealtime APIは、音声入力・音声出力を中心とする。SeedRealtimeは、音声と映像を単一のフルデュプレックスモデルで統合し、自ら会話のタイミングを判断して能動的に動くことを特徴としている。両者を独立機関が直接比較した結果はまだない。
SeedRealtimeは無料?
発表時点では価格が設定された単独製品やAPIがないため、無料か有料かという区分はまだ当てはまらない。ByteDanceプロダクト内の機能として提供されている。
AIモデルにおける「フルデュプレックス」とは?
相手の話を聞きながら同時に応答し、会話の状態を継続的に捉えられることを意味する。質問と回答を一問一答で固定するのではなく、いつ話すか、いつ待つかをモデル自身が判断する。
関連記事
- OpenAI Realtime API pricing — 開発者が現在利用できるリアルタイム音声エンドポイントの料金解説
- Qwen Audio 3 Realtime — 比較対象となるもう一つのリアルタイム音声モデル