 AIREITER
結論から言えば、英語または中国語の短尺音声を作るなら、Seed Audio 1.0は今すぐ試す価値があります。ただし、現時点では公式APIではなくサードパーティのゲートウェイ経由が現実的です。ByteDanceのこのモデルは、プロンプトひとつから会話、BGM、効果音を含む音声シーン全体を生成します。複数話者の会話と音楽ミックスを最初からまとめて出力できる点が、単機能のTTSや音楽生成ツールとの大きな違いです。一方で、1回の出力は最長2分、対応言語は英語と中国語のみ、公式APIは招待制かつ価格未公表という3つの制約があります。
Seed Audio 1.0は何を作れるモデルか
一般的な音声ツールは、音声合成、音楽生成、効果音生成のいずれかに特化しています。これに対してSeed Audio 1.0(正式名称:Doubao-Seed-Audio 1.0)は、3つの要素を同じタイムライン上で一度に生成するモデルです。たとえば「深夜のコンビニを舞台にしたサスペンス調のラジオドラマ」と指定すると、セリフ、環境音、BGMをすでにミックスした完成音声として返します。
動作モードは3種類です。Text-to-audio(T2A)は文章による説明からシーンを作成します。Text-and-audio-to-audio(TA2A)は、参照クリップとテキストを組み合わせ、声やスタイルを誘導する方式です。単純にクリアなナレーションが必要な場合には、通常のTTSも使えます。どのモードを選ぶかは、入力する素材によって決まります。
ひとつ整理しておきたいのは、これが音声クローンツールなのかという点です。Seed Audio 1.0は、1つの声で複数の役を演じさせたり、参照クリップの声色を模したりできます。しかし、出力は特定の実在人物のアイデンティティに紐付くものではなく、合成された音声です。特定人物を同意なく複製するクローンではなく、ゼロショットのボイススタイリングとして捉えるべきでしょう。基盤にはByteDanceの先行研究であるSeed-TTSとSeed-Musicがあり、表現力のある音声と音楽生成が同一モデルに統合されている理由でもあります。
導入前に確認したい仕様と制限
まず、自分の用途がハードな制約の範囲に収まるかを確認してください。以下はfalとEvoLinkのモデル一覧を照合して整理した、実用上重要な仕様です。
| 項目 | 仕様 |
|---|---|
| 1回の生成での最大出力 | 120秒(2分) |
| テキストプロンプトの上限 | 約1,500~2,000文字(情報源に差異あり。コンソールで要確認) |
| 参照音声 | 最大3クリップ、各30秒以下 |
| 対応言語 | 英語と中国語のみ |
| 出力形式 | WAV、MP3、PCM、OGG Opus |
| サンプルレート | 48K / 24K / 16K / 8K |
| 調整項目 | 速度、ピッチ、音量(SSML非対応) |
| 課金モデル | 出力時間ベース |
最も影響が大きいのは、2分という上限です。ポッドキャスト1本や長尺ナレーションを作るには、台本を分割してからセグメントをつなぐ必要があり、チャンク間で声色や雰囲気がぶれるリスクがあります。falのモデルノートでは、1回の生成時間を10分程度まで引き上げ、明示的な長さ指定と対応言語の拡大を行うアップデートが予定されています。長尺制作が主業務なら、その更新を待つ意味はあります。
料金:公式価格はまだ出ていない
公式料金はまだ公開されていません。2026年7月時点で、VolcengineはSeed Audio 1.0の秒単位料金を発表していません。Volcano Arkでは依然として招待制で、公式価格は通常、一般提供開始時に提示されます。falやEvoLinkといったゲートウェイも固定料金を明記しておらず、生成時間に応じて課金されます。つまり、費用は「生成秒数 × 単価」で決まり、リトライ分も課金対象です。出回っているトークンベースの料金情報は無視して構いません。時間ベースの音声モデルには、トークン課金は適合しません。
今すぐ使うためのアクセス方法
利用経路は2つありますが、実際の使い勝手は大きく異なります。
公式の経路はVolcano Arkです。Seed Audio 1.0は招待制のため、申請してアクセス許可を待ち、ByteDanceのコンソールから利用します。一般提供と公式価格が始まれば、ここが一次情報の基準になります。
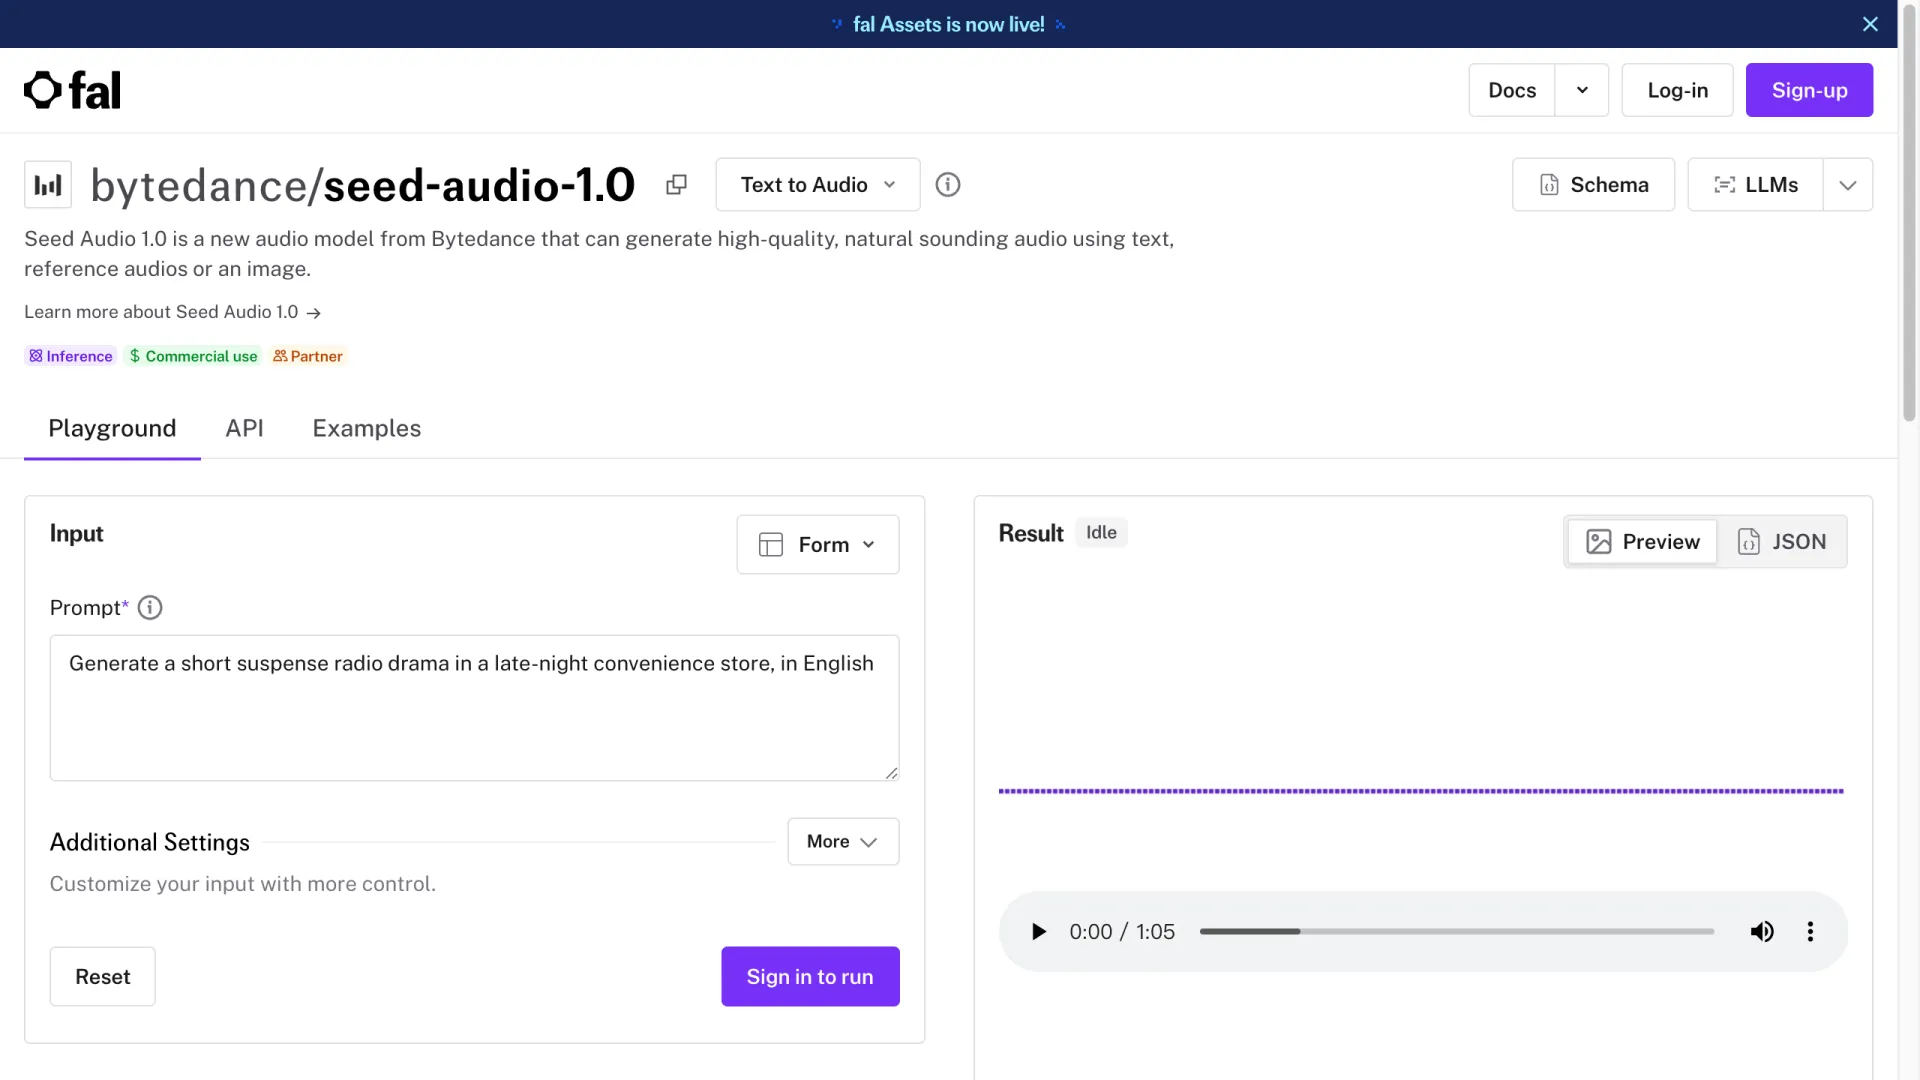
すぐ試すなら、サードパーティのゲートウェイが実用的です。falは、bytedance/seed-audio-1.0としてこのモデルをホストしており、ホワイトリストは不要です。通常のAPIキーでエンドポイントを呼び出せます。EvoLinkも同様のアクセスを提供しています。招待を待たずに今このモデルを生成で使うなら、多くの人にとってこの方法になります。
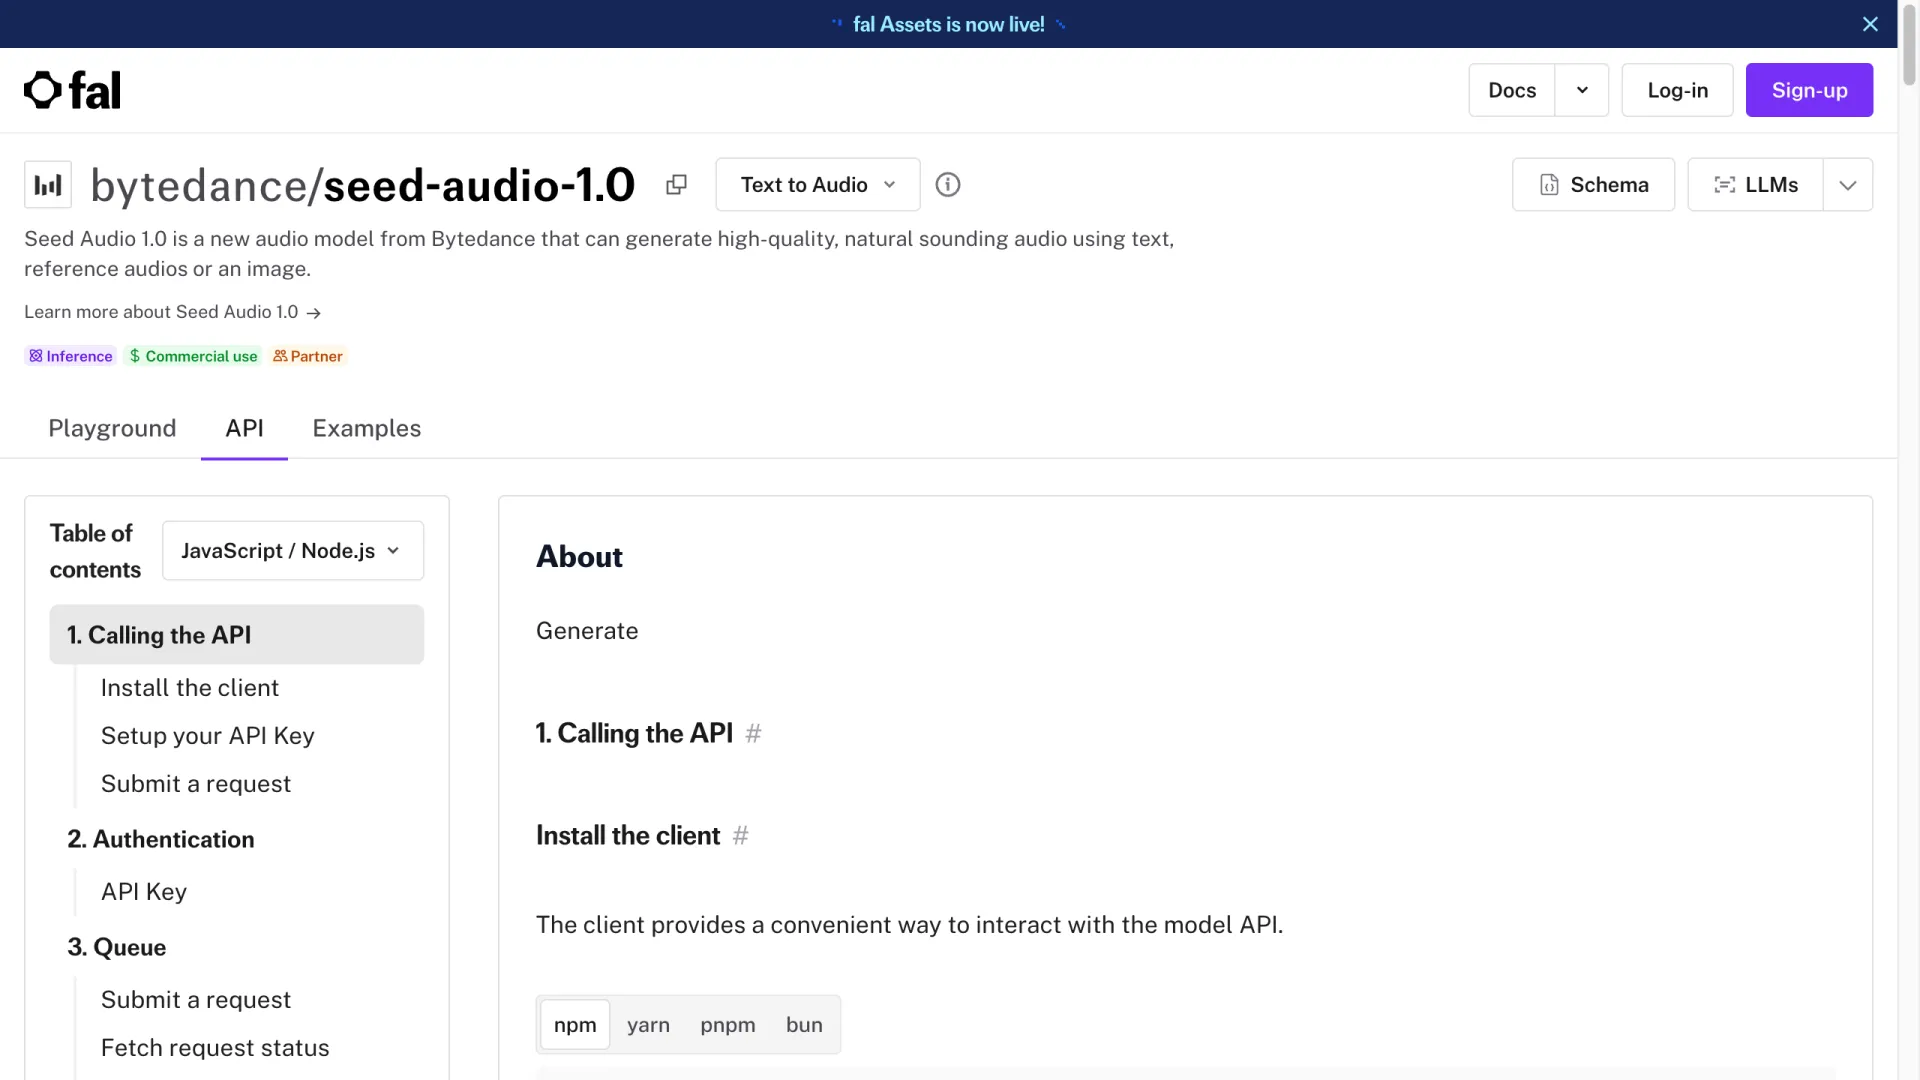
呼び出し方は標準的なキューベースAPIです。クライアントをインストールし、キーを設定してプロンプトを送信し、結果をポーリングします。これまでにホスト型の生成モデルを統合した経験があれば、新たに覚えることはほとんどありません。開発者体験については、fal.ai reviewでより詳しく解説しています。
最初のテストには、会話、環境音、テンポをまとめて試せる短い複数話者シーンが向いています。たとえば「深夜のコンビニを舞台にした30秒のサスペンス・ラジオドラマ、英語」です。まずは30秒未満に収めておくと、モデルのプロンプト解釈を把握する段階で失敗してもコストを小さく抑えられます。
Seed Audio 1.0とElevenLabs、Stable Audio、AudioCraftの違い
比較すべきなのは、クリップ単位の品質だけではありません。それぞれのツールが何のために設計されているかです。
| ツール | 主な強み | シーンミックス | 対応言語 | 音声コントロール |
|---|---|---|---|---|
| Seed Audio 1.0 | 音声シーン全体(会話 + 音楽 + 効果音) | 対応、1回の生成で完結 | 英語、中国語 | ゼロショットスタイリング |
| ElevenLabs | 音声合成と音声クローン | 音声のみ | 30以上 | 最も強力なクローン機能 |
| Stable Audio | 音楽・サウンド生成 | 単一トラック | N/A(音楽) | プロンプトベース |
| AudioCraft | オープンソースの音楽・効果音 | 単一トラック | N/A(音楽) | プロンプトベース |
純粋な音声品質、あるいは多数の言語にわたる精密な音声クローンが必要なら、依然としてElevenLabsが優位です。単体の音楽を作るなら、Stable AudioやMetaのAudioCraftがその用途に適しています。Seed Audio 1.0の強みは、会話・音楽・効果音を編集可能で一貫したシーンとして統合できることです。この比較対象の中で、それを単一の呼び出しで行えるツールはほかにありません。
強みと、割り切るべき弱点
強み:複数話者の会話と、音楽・効果音を1回でミックスできることが最大の魅力です。falの利用ガイドには、クリップの延長、特定区間のインペインティング、テイクの接続といった編集ワークフローも記載されています。単発の生成器ではなく、制作ツールとして使える要素があります。
弱点:2分の上限があるため、長尺コンテンツには接続作業が必要です。英語と中国語だけという制限は、グローバルな音声制作の大半を対象外にします。オフライン生成モデルなので、リアルタイム音声エージェントには向きません。公式アクセスもまだ招待制です。
現時点で使う価値はあるか
英語または中国語の短尺コンテンツ、たとえば吹き替え、オーディオブックの一部、短編動画のサウンドトラック、試作段階の音声ドラマを作るなら、ゲートウェイ経由でSeed Audio 1.0を試す価値があります。会話・音楽・効果音を自分でレイヤーする手作業を、省けるからです。
リアルタイムの対話、非対応言語、あるいは長時間途切れない音声が必要なら、待つべきです。一般提供開始と予定されている生成時間の更新が、判断を変えるでしょう。ライブ用途には、その間Qwen Audio 3のようなリアルタイムモデルのほうが適しています。その他のユーザーにとって今は、全面移行ではなく「ゲートウェイで試し、既存スタックは動かし続ける」段階です。
FAQ
Seed Audio 1.0は無料ですか?
いいえ。公式の無料枠はありません。Volcano Ark APIは招待制で、アクセス権を得た後は出力時間に応じて課金されます。サードパーティのゲートウェイは、それぞれ独自の従量料金を設定しています。
Seed Audio 1.0で自分の声をクローンできますか?
参照クリップのスタイルを模倣したり、複数の役をひとつの声で演じたりすることは可能です。ただし、特定の実在人物に固定されたクローンではなく、合成音声を出力します。人物のアイデンティティをそのまま複製するツールとして扱うべきではありません。
Seed Audio 1.0は何語に対応していますか?
提供開始時点では英語と中国語のみです。falのモデルノートによると、予定されているアップデートで、より広い多言語対応がロードマップに入っています。
生成できる音声の長さは?
現時点では1回の生成につき最長120秒です。予定されているアップデートでは、明示的な長さ指定とともに、1回の生成時間が10分程度まで引き上げられます。
公式のSeed Audio 1.0 APIはありますか?
はい。VolcengineのVolcano Arkで提供されていますが、現時点では招待制です。ホワイトリストなしで利用するなら、bytedance/seed-audio-1.0をホストしているfalのようなゲートウェイを使えます。
Seed AudioとSeed Musicはどう違いますか?
Seed-MusicはByteDanceが先に公開した音楽中心の研究です。Seed Audio 1.0は、その音楽生成能力に音声と効果音を組み合わせ、ひとつのシーン生成モデルにまとめたものです。