 AIREITER
Qwen Audio 3.0 Realtimeは、話しかければすぐ応答を音声で返せる、Qwenのリアルタイム音声機能だ。体感は電話に近く、会話を止めずにやり取りできるレイテンシを目指している。Alibabaのプラットフォームでは、Qwen3-Omni / Qwen3.5-Omni Realtime APIとして提供され、モデルIDにはqwen3-omni-flash-realtimeなどを使う。テキスト読み上げだけならQwen-TTS-Realtime、文字起こしだけならqwen3-asr-flashを選べる。ホスト型のOmni Realtimeモデルは100超の言語を認識し、割り込み可能なフルデュプレックス会話に対応する。会話1分あたりのコストも1セントのごく一部だ。
まず試すなら、WebSocket経由のqwen3-omni-flash-realtimeが最短ルートになる。本記事では各モデルの役割、仕様、料金、OpenAI RealtimeやGemini Liveとの違い、導入方法をまとめる。仕様、価格、モデルIDは主にAlibabaのModel Studio Realtime documentationおよびQwen3-Omni model cardの一次情報へリンクしている。この分野は更新が速いため、数値に差異がある場合はリンク先を確認してほしい。
Qwenの音声モデル名を整理する
Qwenの音声系モデルには世代ごとの違いがある。系譜を押さえると、用途に合うモデルを選びやすい。
Qwen-Audio(2023年)とQwen2-Audioは、音声を理解するためのモデルだった。音声を入力してテキストを返す用途であり、音声で話し返す機能は持たない。- 現行世代では、音声機能がomniモデルへ統合されている。
Qwen3-OmniとQwen3.5-Omniは、テキスト、画像、音声、動画を受け取り、テキストと自然な音声の両方を生成できる。 - リアルタイム機能は提供形態の違いだ。同じOmniモデルをRealtime API経由で呼び出し、モデルIDの末尾には
-realtimeが付く。
つまり、「Qwen Audio 3.0 Realtime」という表記が指すのは、リアルタイムで利用するQwen3-Omniファミリーだ。本記事で扱うのもこのスタックである。
Qwenのリアルタイム音声は3層で考える
単一モデルとしてではなく、音声パイプラインとして捉えると分かりやすい。実運用の音声アプリでは通常、次の3種類のQwenモデルに触れる。3つを組み合わせてもよいし、それぞれ単独でも使える。
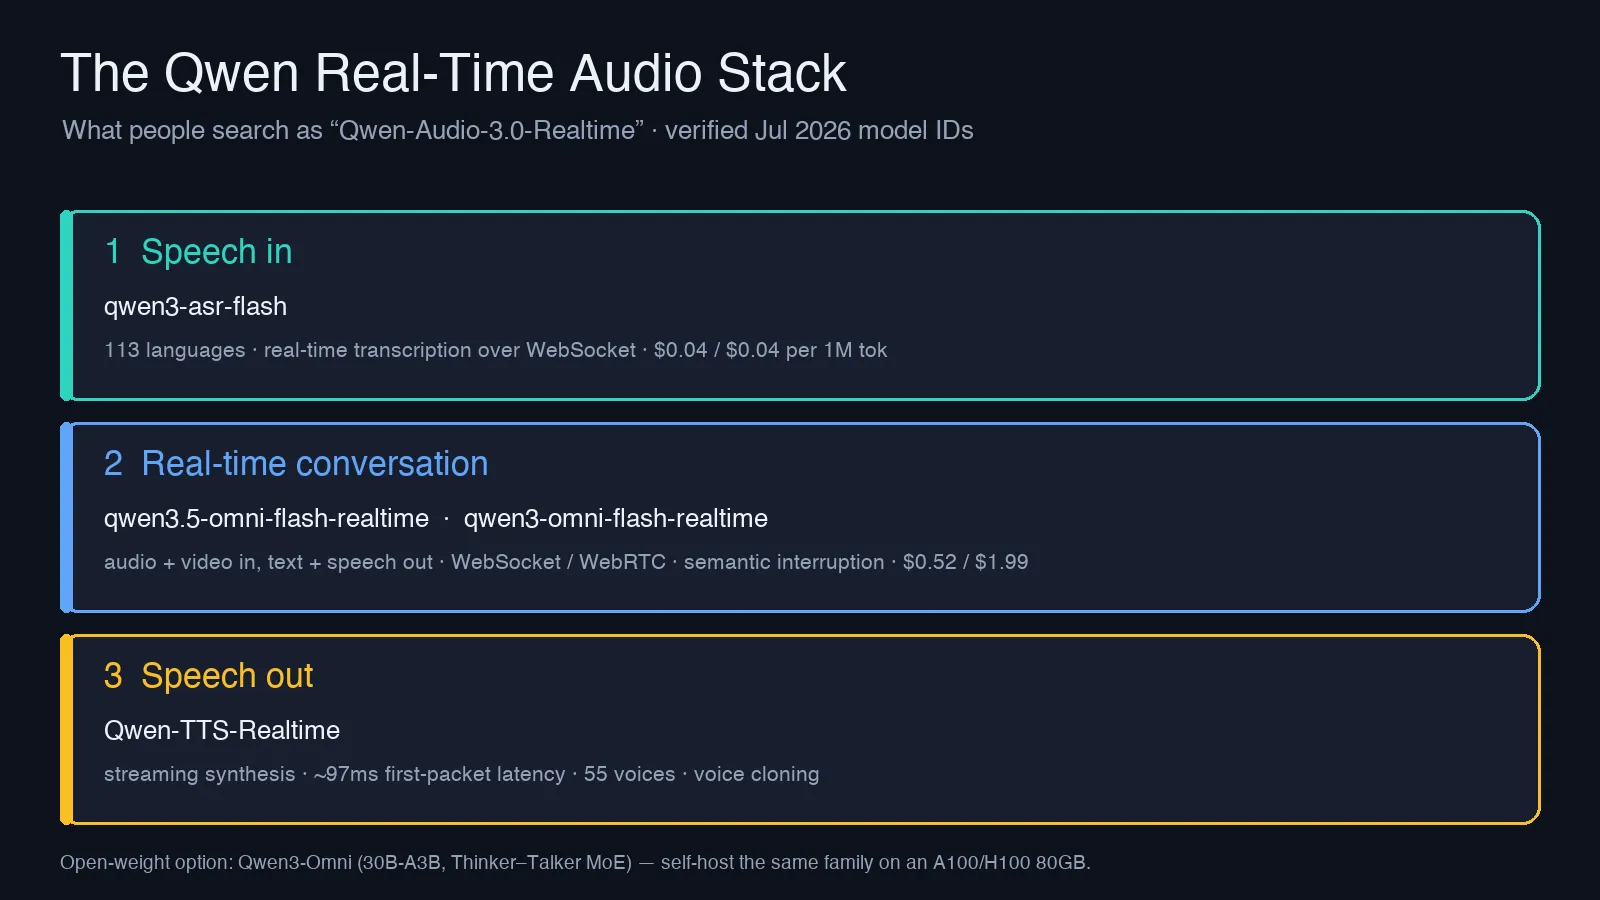
- 音声入力:
qwen3-asr-flash。WebSocketでストリーミングする音声認識モデル。ライブ字幕や音声エージェントのフロントエンド向けに最適化されており、非常に広い言語範囲を文字起こしできる。低コストな文字起こし処理の主力として使える。 - リアルタイム会話:
qwen3.5-omni-flash-realtime、qwen3-omni-flash-realtime、qwen3.5-omni-plus-realtime。中核となる層だ。音声と動画フレームを入力し、テキストと合成音声を出力する。リクエストごとに接続を張り直すのではなく、ターンをまたいで維持される永続接続を使う。 - 音声出力:
Qwen-TTS-Realtime。テキストを音声化するだけでよい場合に使う専用のストリーミングTTSモデル。たとえば、テキストLLMが生成した回答を読み上げる用途に向く。
中央の層にOmni Realtimeモデルを使うなら、音声入力から音声出力までを一貫して処理できるため、ASRとTTSを別々に呼ぶ必要はないことが多い。個別モデルは、独自のSTTとQwen TTSを組み合わせるような構成に向けた選択肢だ。
実装前に確認したい主要スペック
以下はマーケティング資料ではなく、Model Studio Realtime documentationに記載された数値だ。
| 項目 | Qwen Realtime API(Omniファミリー) |
|---|---|
| 音声入力 | PCM、16 kHz |
| 音声出力 | PCM、24 kHz |
| その他の入力 | 画像/動画フレーム(JPG、最大1080p、エンコード後256 KB) |
| 音声認識 | 113言語・方言(ホスト型API) |
| 音声生成 | 36言語・方言 |
| 音声 | 合計55種類(多言語47種類、方言8種類)。3.5モデルではボイスクローニングにも対応 |
| 接続 | WebSocket(Bearer認証、手動またはサーバー側VAD)およびWebRTC(SDPネゴシエーション) |
| セッション上限 | WebSocketで120分 |
| 追加機能 | 意味的な割り込み判定、function calling、自律的なWeb検索、音量/速度/感情の音声制御 |
特に重要なのは、意味的な割り込み判定だ。ユーザーが話を遮ろうとしているのか、それとも「うんうん」と相づちを打っているだけなのかをモデルが判断する。自然な音声エージェントと、すぐ話を止めてしまう煩わしいエージェントを分ける機能である。WebRTC対応もブラウザ実装では重要だ。エコーキャンセルやジッター処理を任せられる。なお、113言語という認識対応数はホスト型APIの数値であり、後述するオープンウェイト版の対象言語はこれより狭い。
レイテンシについては、専用ストリーミング経路のQwen-TTS-Realtimeが、Qwen3-TTS streaming docsで初回パケット約97 msを目標値としている。音声が即座に返ってくるように感じられるかを左右する数値だ。ただし、これは応答全体ではなく、最初の音声チャンクが届くまでの時間である。会話全体では、Thinker–Talker設計がストリーミングを前提としている。Qwen3-Omni technical reportでは、レイテンシ最小化を狙うマルチコードブック設計が説明されており、コミュニティテストではフルデュプレックスかつ割り込み可能なターンで、音声から音声までの応答が250 ms未満とされている。実測値はリージョン、ネットワーク、負荷に左右されるため、単一の見出し数字を信じるより、自分のトラフィックで測定するべきだ。
Qwenリアルタイム音声の料金
Qwenのホスト型リアルタイム料金は、クローズドなリアルタイムAPIより大幅に低い。以下はPortkey's DashScope model directoryに掲載されている100万トークンあたりの入力/出力単価だ。これはAlibabaの料金を反映する第三者アグリゲーターなので、導入を決める前にModel Studio consoleで現行価格を必ず確認してほしい。
| モデル | 入力/100万トークン | 出力/100万トークン |
|---|---|---|
qwen-omni-turbo-realtime | $0.27 | $1.07 |
qwen3-omni-flash-realtime | $0.52 | $1.99 |
qwen3-asr-flash(文字起こし) | $0.04 | $0.04 |
1通話あたりに換算するとどうなるか。 音声はトークン数が増えやすく、1分の音声あたり約427トークンとされる。ユーザーが5分話し、モデルも5分応答する、合計10分の音声会話を考えよう。qwen3-omni-flash-realtimeなら、入力約2,135トークン、出力約2,135トークンとなる。料金はおよそ入力$0.001+出力$0.004、つまり10分通話で約0.5セントだ。規模が大きくなってもリアルタイム音声は安価だが、意外に効くのは出力側の発話時間である。音声応答は入力のおよそ4倍の単価になる。
予算を組む前に、さらに2点を確認しておきたい。
- 無料枠はあるが、リージョンに依存する。 Singapore(国際)エンドポイントでは、入力100万トークンと出力100万トークンを90日間無料で提供していた。USエンドポイントにはこの枠がなかった。無料枠は変更されるため、前提にする前に対象リージョンのModel Studio consoleで最新の内容を確認したい。
qwen3.5-omni層は固定単価ではなく、リクエストサイズ別の料金帯を使う。 そのため、大きなコンテキストを含む1リクエストと、小さなリクエストを複数回送るケースでは、料金帯が変わる可能性がある。実際のトラフィック形状で検証してから決めるべきだ。
OpenAI Realtime・Gemini Liveと比べると
2026年半ば時点で、汎用フロンティアLLMベンダーが提供する主要なリアルタイム音声対話の選択肢は、OpenAIのRealtime API、GoogleのGemini Live、そしてQwenのOmni Realtimeファミリーだ。ElevenLabs、Deepgram、Cartesia、Humeのような音声特化ベンダーもTTSやSTTでは強力に競合しているが、ここではフルマルチモーダルモデルによる音声対話のルートに絞る。競合の価格は毎月変わり得るため、単価の羅列ではなく、選定の考え方を整理する。
- コスト。 上記の通話あたりの料金を見る限り、Qwenのリアルタイム料金はホスト型フロンティアモデルの中でも低価格帯に入る。対照として、OpenAI Realtimeの音声は入力1分あたり約$0.06、出力1分あたり約$0.24だった(料金の内訳はこちら)。この前提なら、
qwen3-omni-flash-realtimeで約0.5セントの10分通話は、OpenAIでは$1.50に近づく。いずれも価格は変わるため、差額を前提にする前に双方の最新料金を確認すべきだが、開きは大きい。また、3者の中でQwenだけがオープンウェイト版を提供しており、自前ホストすれば限界費用をほぼゼロへ近づけられる。 - オープン性。 OpenAI RealtimeとGemini Liveは、クローズドAPIのみで提供される。Qwen3-Omniはオープンウェイトで公開されているため、別モデルの振る舞いに合わせてアプリを書き直すことなく、ホスト型から自前ホストへ移行できる。
- 品質。 第三者の報道では、最上位の
qwen3.5-omni-plusが、一部の音声理解ベンチマークでGemini 3.1 Proに並ぶ、または上回るとされている。ただし、個別ベンチマークはあくまで検証の出発点であり、自分の音声データで試す必要がある。 - エコシステム。 現時点ではOpenAIとGoogleのほうが、ツール、SDK、コミュニティの実装例で先行している。Qwenのドキュメントも十分に整っているが、生のWebSocket/WebRTC仕様を直接扱う場面は多くなる。
実務的な結論は明快だ。コスト、あるいは将来的な自前ホストの選択肢を重視するなら、Qwenが最有力になる。成熟したSDK体験を優先し、その対価を払えるなら、OpenAIとGoogleは依然として完成度でリードしている。クローズドな代替案の詳細な費用比較は、後述の関連リンクを参照してほしい。
用途別:選ぶべきモデル
| 利用シーン | 選択肢 |
|---|---|
| 最安のホスト型フル音声対話 | qwen3-omni-flash-realtime |
| 最高のホスト型品質、長いセッション、ボイスクローニング | qwen3.5-omni-plus-realtime |
| 文字起こしだけが必要 | qwen3-asr-flash |
| テキスト読み上げだけが必要 | Qwen-TTS-Realtime |
| データを自社ハードウェアから出せない | オープンウェイトのQwen3-Omni(30B-A3B)を自前ホスト |
3.5層では、軽量なqwen3-omni-flashの8ターンに対し、ボイスクローニングに加え、より長いコンテキストと対話上限を利用できる。上限は最大100ターン、保持音声は600秒だ。プロトタイプではFlashから始め、明確な制約に当たった時点でPlusへ移るのがよい。
利用を始める方法
ホスト型を直接使う場合。 Alibaba Cloud Model StudioでAPIキーを発行し、Bearer認証付きWebSocket接続を開く。ブラウザアプリでは、SDP POSTでWebRTCをネゴシエートしてもよい。PCM音声をストリーミング送信し、PCM音声とテキストを受信する。ソケットを直接管理したくない場合は、DashScope Python SDKがRealtimeインターフェースをラップしている。最小限の接続例は次のとおりだ。エラーハンドリングは省略している。
import os, json, base64, websocket

MODEL = "qwen3-omni-flash-realtime"
url = f"wss://dashscope-intl.aliyuncs.com/api-ws/v1/realtime?model={MODEL}"
ws = websocket.create_connection(
    url, header=[f"Authorization: Bearer {os.environ['DASHSCOPE_API_KEY']}"]
)

# 1. セッションを設定する:音声、出力形式、サーバー側のターン検出
ws.send(json.dumps({
    "type": "session.update",
    "session": {
        "voice": "Cherry",
        "output_audio_format": "pcm24",
        "turn_detection": {"type": "server_vad"},
    },
}))

# 2. マイク音声をbase64エンコードしたPCM 16 kHzフレームとして送信する
ws.send(json.dumps({
    "type": "input_audio_buffer.append",
    "audio": base64.b64encode(pcm_frame).decode(),
}))

# 3. イベントを受信する。response.audio.deltaには再生するPCM 24 kHzが入る
while True:
    event = json.loads(ws.recv())
    if event["type"] == "response.audio.delta":
        play(base64.b64decode(event["audio"]))
サーバー側VADを使うと、ユーザーが話し終えたタイミングをモデルが判断する。ターンの境界を自分で制御したい場合は手動方式に切り替える。イベントフローはOpenAI Realtimeの形にかなり近いため、既存のRealtimeクライアントコードも小さな変更で移植しやすい。SingaporeとUSのデプロイではフィールド名、音声リスト、リージョン別エンドポイントホストに違いがあり、APIも更新される。リリース前にRealtime docsで正確な内容を確認してほしい。
自前ホストする場合。 オープンウェイトのQwen3-Omniは、Thinker–Talker型のMixture-of-Experts設計を採用する。総パラメータ数は30B、アクティブなのは約3Bだ。Alibabaは通常のTransformersよりvLLMの利用を推奨している。完全な30BモデルをBF16で推論するには、third-party deployment guidesによると、最低でも80GBカード1枚(A100またはH100)が必要になる。RTX 4090のような24 GBカードではフルウェイトを収められないが、量子化ビルドなら必要条件は下がる。
注意点は、リアルタイム配信がバッチ推論より難しいことだ。自前ホストの報告では、同時負荷で停止しないようKVキャッシュに上限を設ける必要があり、単一GPUのトークン処理速度はホスト型APIに及ばないとされる。一方、ストリーミングに最適化した配信スタックは差をかなり縮められる。Red Hat AIとvLLMに取り組むエンジニアは、パイプライン段階をオーバーラップさせることで、3秒のクリップの音声生成を約8秒から約0.5秒へ短縮できたと報告している。これは実際の改善だが、そのぶん追加のエンジニアリングを要する。自前ホストではトークン単価をなくせる一方、GPU費用と運用コストが加わる。プロトタイプよりも、高く安定した利用量があるケースで採算が合う。
現在、リアルタイムOmni音声を使う正規ルートはDashScopeエンドポイントだ。すでに複数プロバイダーを1つのゲートウェイで扱っているなら、その前段にアグリゲーターを置くこともできる。ただし、多くの中継サービスはテキスト・画像モデルだけを扱い、リアルタイム音声層を扱っていない。利用前に対象のQwenリアルタイムモデルIDがカタログにあるか確認したい。
実装前に知っておくべき制約
- セッションの上限は120分。 サポート窓口や長時間の個別指導など、それ以上の接続ではソケットをまたいでコンテキストを引き継ぐ再接続ロジックが必要になる。
- 無料枠と提供状況はリージョンで変わる。 最初に登録したエンドポイントではなく、実際にデプロイするエンドポイントでテストするべきだ。
- ホスト型とオープンウェイト版は同一ではない。 ホスト型APIは113言語の認識と36言語の生成を案内している。一方、オープンウェイトのQwen3-Omni releaseは対象が狭く、音声入力19言語、音声出力10言語だ。特定言語への対応が要件なら、実際に出荷するバリアントで確認する必要がある。
- リアルタイムの費用はリクエスト数ではなく会話時間に比例する。 音声はトークン数が多いため、よく話すユーザーほどコストが高くなる。請求額は呼び出し回数ではなく、会話時間を基準に見積もるべきだ。
よくある質問
Qwen 3は音声に対応していますか?
はい。Qwen3-Omniモデルはネイティブなマルチモーダルモデルで、音声、テキスト、画像、動画を入力として受け取り、リアルタイムのテキストまたは音声で応答できます。
Qwenは音声を理解するだけでなく、生成もできますか?
はい。テキストのみを出力した初代Qwen-Audioとは異なり、Omni RealtimeモデルとQwen-TTS-Realtimeは話し言葉の音声を生成できます。3.5層ではボイスクローニングも可能です。
Qwenのリアルタイム音声は無料ですか?
無料トライアル枠があります。過去には国際(Singapore)エンドポイントで、入力100万トークンと出力100万トークンを90日間利用できました。それを超えるとトークン課金です。完全なオープンウェイト版Qwen3-Omniは、自分でGPUを用意すれば無料で実行できます。
Qwenの音声モデルをローカルで動かすには?
オープンウェイトのQwen3-Omni(30B-A3B)をダウンロードし、vLLMで配信する。フルモデルをBF16で動かすには、およそ80GBのカード(A100またはH100)が必要だ。小型のコンシューマー向けGPUで扱えるのは量子化ビルドであり、フルウェイトではない。
関連資料
一次情報:
代替サービスの料金: