 AIREITER
100万トークンのコンテキストと$0のエンドポイント。Nemotron 3 Ultra APIは、何も考えず標準採用できそうに見えます。しかし実際には、無料ルートは評価用途に向く一方、本番運用ではプロバイダーの安定性、データの扱い、有料フォールバックの有無が成否を分けます。
Nemotron 3 Ultra APIは使う価値があるのか
長時間動作するテキストエージェント、大規模ドキュメントの分析、非常に長いコンテキストを活かせるコーディングワークフローなら、Nemotron 3 Ultra APIを試す価値があります。一方、低遅延の定型チャット、ログが残る無料エンドポイントに機密プロンプトを送る用途、フォールバックなしの本番サービスには向きません。
NVIDIAはNemotron 3 Ultraを2026年6月4日にリリースしました。公式モデルカードでは、NVFP4チェックポイントをバージョン1.0 GAと位置付け、OpenMDW 1.1のもとで商用・非商用利用を許可しています。
| 判断材料 | 確認できる値 | 意味するところ |
|---|---|---|
| モデル規模 | 合計550B、アクティブ55B | スパース計算でも全ウェイトが小さくなるわけではない |
| 最大コンテキスト | 最大100万トークン | 利用するルートによってプロバイダー側の上限は低くなる可能性がある |
| モダリティ | テキスト入力・出力 | 画像や動画の理解には対応しない |
| 公式NVFP4 SWE-Bench Verified | 69.7 | コーディングエージェントの評価に関係する指標 |
| 公式NVFP4 RULER 1M | 94.0 | 長文コンテキスト用途を裏付ける結果 |
| OpenRouterの無料料金 | 入力$0、出力$0 | 試用には向くが、SLAではない |
| OpenRouter無料版の可用性スナップショット | 3日間の成功率84.07% | 接続できても、常に使えるとは限らなかった |
| 公式セルフホスト最低構成 | B200クラス4枚、またはH100 8枚 | 一般的なワークステーションでの構成ではない |
上記のベンチマーク値はNVIDIAのモデルカードに記載されたもので、一次情報として扱うべき結果です。OpenRouterの可用性は動的なプロバイダー測定値であり、恒久的な保証ではありません。
5分で無料のNemotron 3 Ultra APIを呼び出す
最短ルートは、OpenAI互換のチャットコンプリートエンドポイントと、正確なモデルID nvidia/nemotron-3-ultra-550b-a55b:freeを使う方法です。OpenRouterでキーを作成し、環境変数に保存したら、長文ジョブを実行する前に小さなテストを送っておきましょう。
- OpenRouterでAPIキーを作成する。
OPENROUTER_API_KEYとしてエクスポートする。- 無料モデルIDを指定して
/api/v1/chat/completionsを呼び出す。 - 評価中はHTTPステータス、レイテンシ、空レスポンスを記録する。
- 本番で使う前に、有料ルートまたは別モデルを追加する。
curl https://openrouter.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nvidia/nemotron-3-ultra-550b-a55b:free",
    "messages": [
      {
        "role": "user",
        "content": "Return three risks in this migration plan as a numbered list."
      }
    ],
    "max_tokens": 500
}'OpenAIのPythonクライアントでも、base_urlとmodelを変更すれば同じルートを利用できます。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["OPENROUTER_API_KEY"],
    base_url="https://openrouter.ai/api/v1",
)

response = client.chat.completions.create(
    model="nvidia/nemotron-3-ultra-550b-a55b:free",
    messages=[
        {
            "role": "user",
            "content": "Inspect this plan and list the three highest-impact risks.",
        }
    ],
    max_tokens=500,
)

print(response.choices[0].message.content)
無料ルートで保証されること、されないこと
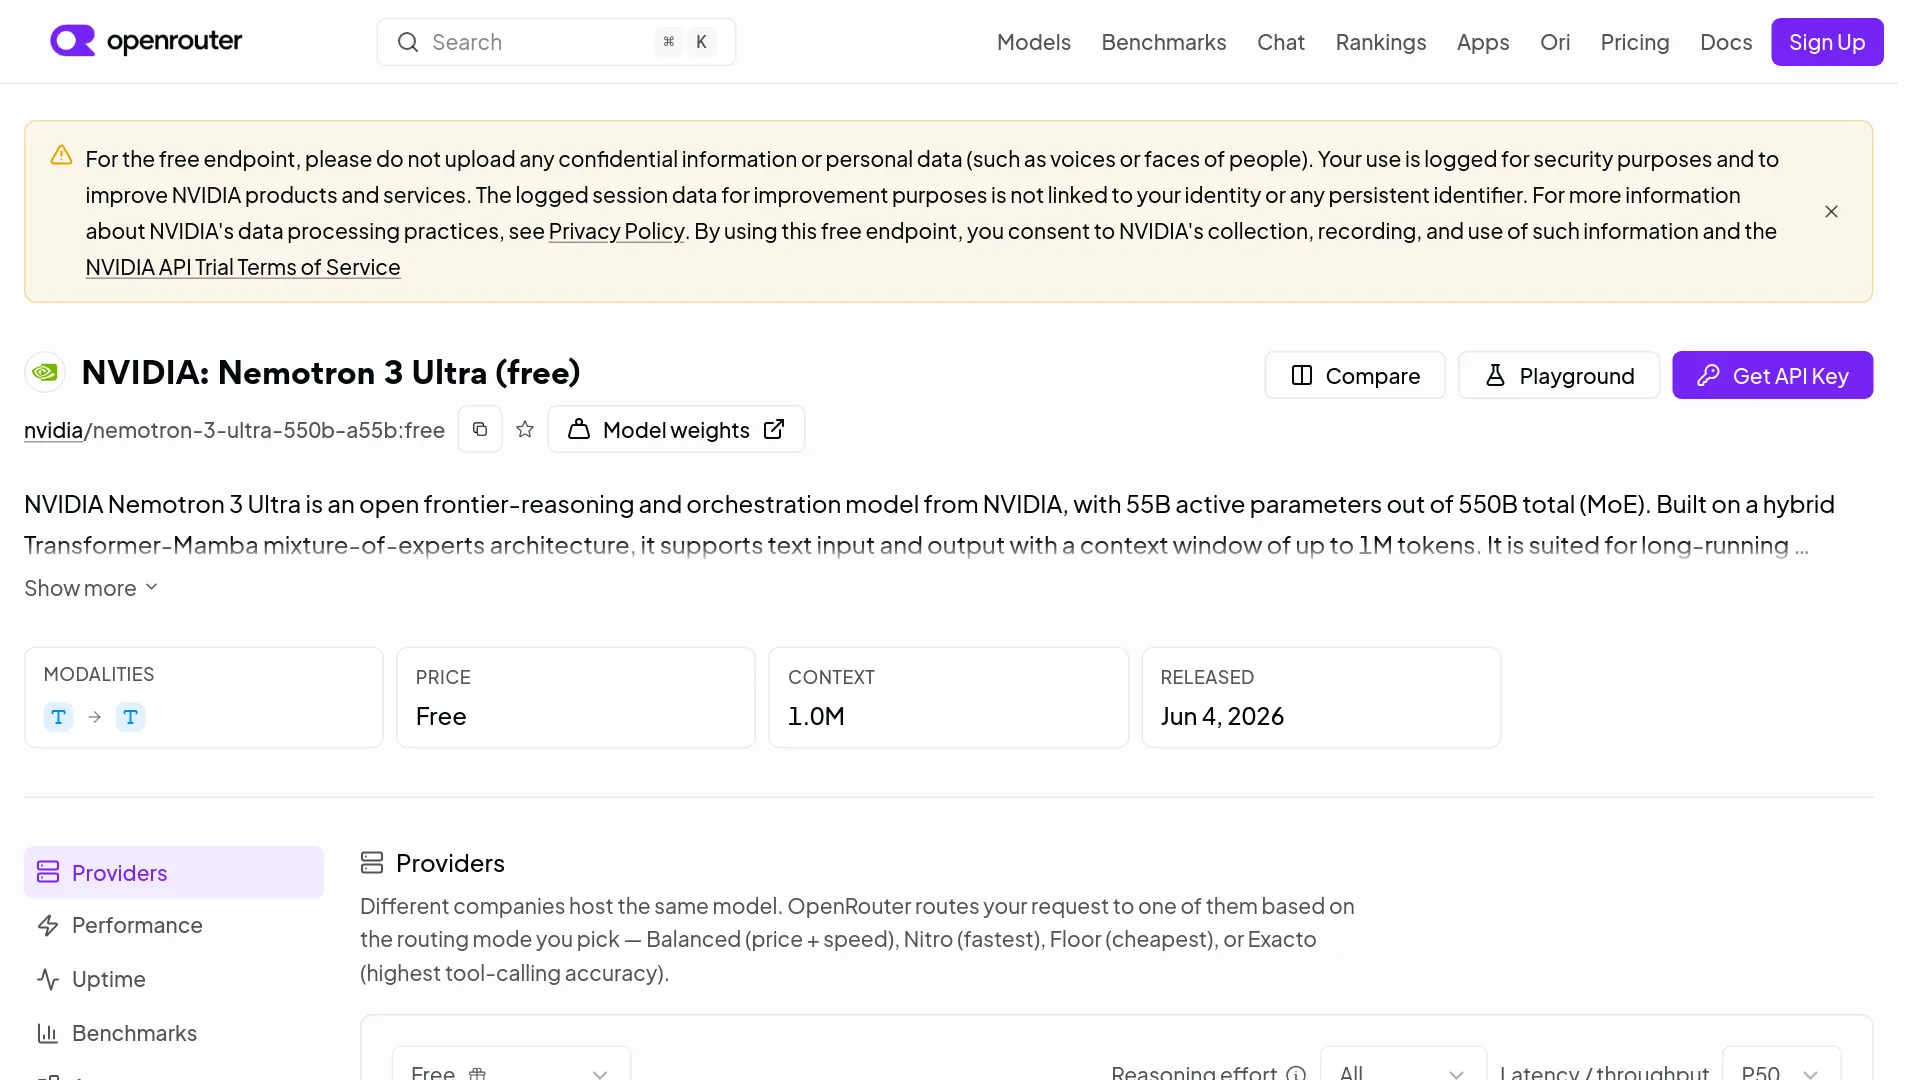
無料のNemotron 3 Ultraルートは、無制限のキャパシティも本番向けの可用性も保証しません。OpenRouterの掲載ページでは無料エンドポイントにレート制限があると説明されていますが、モデルページに具体的な割り当て量は公開されていません。9月19日のスナップショットでは、3日間の到達率は100%だった一方、エラーと空レスポンスを失敗として数えた成功ベースの可用性は84.07%でした。
このスナップショットでOpenRouterが表示していたのは、100万トークンのコンテキスト、最大65,536トークンの生成、ツール呼び出し、中央値2.28秒のレイテンシ、中央値毎秒29トークンのスループットです。
プロバイダーによる機能差にも注意が必要です。OpenRouterの無料版はtoolsとtool_choiceに対応していましたが、response_formatは強制しません。Segmindの有料ルートでは、入力100万トークンあたり$0.625、出力100万トークンあたり$2.75でJSON Schema出力を利用できると案内しています。厳密なJSONに依存するコードは、ベースモデルの仕様から対応可否を推測せず、実際に選んだプロバイダーで検証してください。
機密情報や個人データを、OpenRouterの無料ルートに送ってはいけません。掲載ページには、セキュリティ目的で利用状況を記録し、NVIDIAの製品やサービス改善に使う可能性があると記載されています。429、タイムアウト、空レスポンスが返った場合は、上限を設けた指数バックオフを使い、その後は有料ルートへ切り替えます。エージェントのアクションを無期限にリトライする設計は避けてください。
550B-A55Bが実運用で意味すること
550B-A55Bという表記は、Nemotron 3 Ultraが合計5500億のパラメーターを保持し、各トークンの処理で約550億をアクティブ化することを示します。NVIDIAは、LatentMoEルーティング、Mamba-2、選択的アテンション層、Multi-Token Predictionを組み合わせています。スパースなアクティベーションによってトークンごとの計算量は抑えられますが、全ウェイトは保存、分散、またはオフロードしなければなりません。A55Bだからといって、55Bモデル相当の構成で動くわけではありません。
NVIDIAの研究リリースでは、最大100万トークンのコンテキストと、入力8,000トークン・出力64,000トークンという特殊なワークロードでスループットを比較しています。NVIDIAは、GLM-5.1-754B-A40Bの5.9倍、Kimi-K2.6-1T-A32Bの4.8倍、Qwen-3.5-397B-17Bの1.6倍のスループットを主張しています。ただし、ページには絶対的なスループット値やハードウェアの詳細がないため、この倍率をそのままAPIのレイテンシ予測に置き換えることはできません。
実際のデプロイ構成を考えるなら、公式のBF16/NVFP4比較表のほうが参考になります。
| ベンチマーク | BF16 | NVFP4 | 実務上の読み方 |
|---|---|---|---|
| SWE-Bench Verified | 71.9 | 69.7 | このコーディングテストでは量子化により2.2ポイント低下 |
| Terminal Bench 2.1 | 56.4 | 53.9 | ターミナルを使うエージェント作業でも低下 |
| TauBench V3平均 | 70.9 | 70.3 | ツール利用の平均値は近い水準を維持 |
| GPQA、ツールなし | 87.0 | 87.9 | NVFP4が一律に弱いわけではない |
| RULER 1M | 94.7 | 94.0 | 長文コンテキスト検索の性能は近い |
| OmniScience非ハルシネーション | 78.7 | 75.5 | 事実性の検証は依然として重要 |
差の出方はタスク次第です。非ハルシネーションではNVFP4が3.2ポイント下がる一方、GPQAでは0.9ポイント上がっています。
パラメーター数ではなくタスクで選ぶ
Nemotron 3 UltraをDeepSeek V4、GLM 5.2、Qwen 3.8 Maxと比較するなら、モデルサイズではなく、実際に投入するワークロードで見るべきです。このガイドで集めた同一ハーネスの結果から、どのタスクでも勝つモデルを示すことはできません。根拠のある比較には、検証可能な制約を含むテスト計画が必要です。
| タスク | まず試すモデル | 選定前に確認する根拠とテスト |
|---|---|---|
| 100万トークン規模の検索・ドキュメント統合 | Nemotron 3 Ultra | 公式NVFP4 RULER 1Mは94.0。実際のプロンプト長で検索精度とプリフィルレイテンシを測定する |
| 長時間動作するコーディングエージェント | Nemotron 3 UltraまたはDeepSeek V4 | NemotronはSWE-Bench Verifiedで69.7、Terminal Bench 2.1で53.9。1つのハーネスでリポジトリ作業の成功率とツール呼び出しの妥当性を比較する |
| 構造化出力の自動化 | GLM 5.2、Qwen 3.8 Max、またはスキーマ対応のNemotronプロバイダー | OpenRouter無料版はresponse_formatを強制しない。実際に使うルートでスキーマ準拠率とリトライ回数を測定する |
| 大量の短いリクエスト | DeepSeek V4、GLM 5.2、またはQwen 3.8 Max | 成功タスクあたりのコストとp95レイテンシを比較する。Ultraの規模が自動的に有利になるわけではない |
| NVIDIAハードウェアでのオープンウェイト運用 | Nemotron 3 Ultra | 対象タスクでBF16とNVFP4を比較し、継続稼働時の利用率を計算する |
DeepSeek V4とGLM 5.2にはAIReiter上の専用APIがあり、Qwen 3.8 Maxはホスト型チャットモデルとして利用できます。比較候補として、DeepSeek V4 Pro API guide、GLM 5.2 API review、Qwen 3.8 Max API pricingも参照してください。これらは評価の選択肢であり、どのタスクでも特定のモデルが勝つという主張ではありません。
Nemotron 3 Ultraはローカルで動かせるのか
Nemotron 3 Ultraはセルフホストできます。ただし、ここでいう「ローカル」はノートPCではなく、データセンター向けハードウェアまたはDGX Stationです。NVIDIAが通常のデプロイ経路で最低構成として挙げているのは、GB200 4枚、B200 4枚、GB300 4枚、B300 4枚、またはH100 8枚です。
NVIDIAのモデルカードにある公式vLLMの例では、4-wayのテンソル並列とエキスパート並列、FP8 KVキャッシュ、チャンク化プリフィル、MTP投機的デコーディングを使います。標準例のデフォルトは262,144トークンで、1,048,576トークンを有効にするには明示的なオーバーライドが必要です。つまり、最大コンテキストの数字がそのまま標準サービング設定になるわけではありません。
NVIDIAは、特別な単一DGX Station構成も説明しています。この構成では、1基の統合GB300 GPU上でNVFP4チェックポイントを動かし、最大150 GiBのCPU共有メモリを利用可能にしてエキスパートウェイトをオフロードします。この手順にはvLLM 0.22.0、Blackwell専用のNVFP4バックエンド、DGX Stationのメモリアーキテクチャが必要で、一般的なGPU 1枚のPCにそのまま適用できるものではありません。
| デプロイ方法 | 選ぶ場面 | 主な制約 |
|---|---|---|
| OpenRouter無料API | プロンプトやツール動作を評価するとき | レート制限、ログ保存、変動する可用性 |
| 有料ホスト型API | ハードウェア投資を正当化できる利用量に達する前にリリースするとき | プロバイダーごとの料金、精度、コンテキスト、機能差 |
| B200クラス4枚 / H100 8枚でのセルフホスト | 継続的な処理量、データ管理、モデルのカスタマイズが重要なとき | 初期投資と分散推論の運用 |
| オフロードを使うGB300搭載DGX Station 1台 | 該当する共有メモリ構成を持つシステムを所有しているとき | オフロードによるレイテンシとハードウェア依存 |
Nemotron 3 Ultra API FAQ
Nemotron 3 Ultra APIは無料ですか?
はい。OpenRouterではnvidia/nemotron-3-ultra-550b-a55b:freeを、入力・出力トークンともに$0で掲載しています。ただし、エンドポイントにはレート制限があり、利用状況も記録されます。
Nemotron 3 Ultraは本当に100万トークンに対応していますか?
NVIDIAが指定する最大値は100万トークンです。ただし、プロバイダーのルートではデフォルト上限が低い場合があります。NVIDIAのvLLM例も、オペレーターが1,048,576トークンを有効にしない限り、デフォルトは262,144トークンです。
APIはツールと構造化JSONに対応していますか?
モデル自体はツールに対応していますが、強制力はプロバイダー次第です。OpenRouter無料版ではresponse_formatが強制されない一方、Segmindは厳密なJSON Schemaを案内しています。
Nemotron 3 Ultraを商用利用できますか?
NVIDIAは、OpenMDW 1.1のリリースが商用・非商用利用を許可すると説明しています。再配布やデプロイ時の義務については、公式モデルカードにリンクされたライセンス条項を確認してください。
推論をオフにできますか?
NVIDIAのAPIドキュメントでは、enable_thinking=True/Falseが公開されています。ホスト型プロバイダーではこの制御方法が異なる可能性があるため、選択したルートで受け付けるパラメーターとトークンの計上方法を確認してください。
550B-A55Bは、密な55Bモデルと同じ意味ですか?
いいえ。1トークンあたり約55Bのパラメーターがアクティブになりますが、550Bすべてのパラメーターを保存、分散、またはオフロードする必要があります。
ベンチマークの優勝トロフィーではなく、デプロイの判断材料
最初の一手としては、機密性のないプロンプトと小規模な評価セットで、無料のNemotron 3 Ultra APIを試すのがよいでしょう。失敗率、スキーマ強制、キャパシティの予測可能性が重要になったら有料エンドポイントへ移行します。セルフホストは、測定した利用率、プライバシー、カスタマイズのいずれかが、少なくとも現行の高メモリGPU 4枚、または公式に記載されたDGX Station構成を正当化できる場合に限るべきです。
| テスト後の結果 | 次に取るべき対応 |
|---|---|
| 品質は高いが、無料リクエストが失敗またはキュー待ちになる | 有料のNemotronルートとリトライポリシーを追加する |
| 長文コンテキスト検索が差別化要因になっている | 実際に使う最大サイズのドキュメントでテストし、プリフィル時間を測る |
| JSONエラーが大半を占める | スキーマ強制に対応するプロバイダーを使うか、GLM/Qwenのルートと比較する |
| 短いタスクのコストやレイテンシが支配的 | 小型モデルを優先し、Ultraはエスカレーション用に残す |
| データをネットワーク外へ出せない | 採用を決める前に、公式のマルチGPU構成を予算化する |