 AIREITER
GLM-5.2は、どの接続先でも一見するとOpenAI形式のリクエストを受け付ける。しかし、その裏側の挙動まで同じとは限らない。6月16日のローンチ以降、コストを抑えたいコーディング用途やエージェント用途では有力な選択肢になっている。ただし本番に組み込むなら、ツール呼び出しの意味論、リトライの連鎖、キャッシュ課金という3つの失敗パターンを、利用側で吸収する必要がある。100万トークンあたり入力$1.40、出力$4.40という表示価格自体は事実だが、タスク完了までに実際いくらかかるかは別問題だ。本レビューでは、その差を中心に見ていく。
OpenAI互換でできること、できないこと
公式のGLM-5.2ドキュメントでは、ベースURLをhttps://api.z.ai/api/paas/v4/、モデルIDをglm-5.2に指定すれば、OpenAI Python SDKを利用できるとしている。基本的なチャット統合なら、実際に数行の変更で済む。ただし互換なのは主にリクエスト形式であり、レスポンスの意味論、OpenAIの任意制御フィールド、そして新しいResponses APIの領域まで保証されるわけではない。
| ドキュメント上の仕様 | 内容 |
|---|---|
| モダリティ | テキスト入力・テキスト出力(画像非対応) |
| コンテキストウィンドウ | 100万トークン |
| 最大出力 | 128Kトークン |
| ドキュメント記載の機能 | Thinking mode、ストリーミング、function call、コンテキストキャッシュ、構造化出力、MCP |
| 従量課金エンドポイント | https://api.z.ai/api/paas/v4/ |
| Coding Planエンドポイント | https://api.z.ai/api/coding/paas/v4 |
| Anthropic互換エンドポイント | https://api.z.ai/api/anthropic |
| 公式SDK | zai-sdk(Python)、Java、OpenAI SDK |
最初の境界線は、Z.aiにはResponses APIが存在しない点だ。「CodexはResponses API形式しかサポートしておらず、Z.aiでは利用できない」とu/quinncomは述べており、ZenMuxを変換レイヤーとして経由する利用者もいる。もう一つはClaude Code経由の利用だ。Anthropic互換エンドポイントで動作する一方、@armor_rustの設定メモでは2つの注意点が挙げられている。API_KEYではなくAUTH_TOKENを使うこと。前者では信頼確認が表示され、1度拒否すると恒久的に拒否される可能性がある。また、サブスクリプションと従量課金ではベースURLも異なる。手順全体はClaude Codeの設定ガイドで解説している。
ある開発者の表現が端的だ。「API互換性はリクエスト形式まで。ツール呼び出しは依然としてプロバイダーごとの評価が必要」——@sebuzdugan。
ツール呼び出しは短距離なら通るが、長いループでは崩れる
短く制御されたツールループでは、GLM-5.2 APIはドキュメントどおりの結果を返す。一方、長時間稼働するエージェントループでは、呼び出しシーケンスが壊れ、利用側の上限に達するまでループし続けるという報告がある。両方とも事実であり、リスクは構築するループの種類によって大きく変わる。
Z.aiのドキュメントと、GLM52.aiがDockerで実施した27リクエストのテストスイートによる仕様は次のとおりだ。関数定義は最大128個、名前は^[a-zA-Z0-9_-]+$に一致する64文字以内、パラメーターはJSON Schema、返されるargumentsはアプリケーション側で検証が必要なJSON文字列。そして明記されているtool_choiceは"auto"のみである。このテストスイートではCoding Planルートで27件中27件が成功した。ツールと引数の完全一致は4件中4件、ツールを使わない正しい判断は3件中3件、2件の注文を2つのトップレベル呼び出しで処理するケースは4件中4件で、レイテンシー中央値は5.3秒だった。
問題になるのは、OpenAIユーザーが当然使えると考えがちなフィールドだ。GLM52.aiが矛盾する条件を送ると、エンドポイントはHTTP 200を返しながら、その指定を無視した。
| 送信したOpenAI形式の制御 | 観測された挙動 |
|---|---|
tool_choice: "required" + 「ツールは一切使わない」 | 停止し、呼び出し数は0 |
| 強制する関数オブジェクト + 「このツールは絶対に使わない」 | 停止し、呼び出し数は0 |
parallel_tool_calls: false + 2件の注文を含むプロンプト | それでも2件の呼び出しを返した |
strict: true | 1度は受理されたが、スキーマ強制の証拠はない |
HTTPで受理されたことは、期待した挙動が契約されていることを意味しない。そして、その継ぎ目が表面化するのは長いループだ。
約40億トークンをこのモデルに通した開発者は、こう率直に述べている。「40億トークン使った段階でGLM 5.2最大の問題は、visionがないこと、ツール呼び出しの混乱、そしてツール呼び出し破損による死のスパイラルだった」——@RasputinKaiser。また、最初のツール呼び出しのarguments内に、2つ目のツール呼び出しをエンコードしたという未返信の報告も1件ある。単発の事例ではあるが、クライアント側のループ防御が対象とすべき失敗クラスそのものだ。
実際に機能する防御策は、オーケストレーションをモデルに任せすぎないことだ。ある開発者はNVIDIA NIMを利用し、tool_call: falseに設定して、ループ全体をエージェントフレームワークに管理させている。上限付きの参照ループでは、モデルステップを4回まで、1ターンあたりの呼び出しを最大4回までに制限し、実行前にすべてのarguments JSONを検証している。
ストリーミングとレイテンシー:表に出にくい実測値
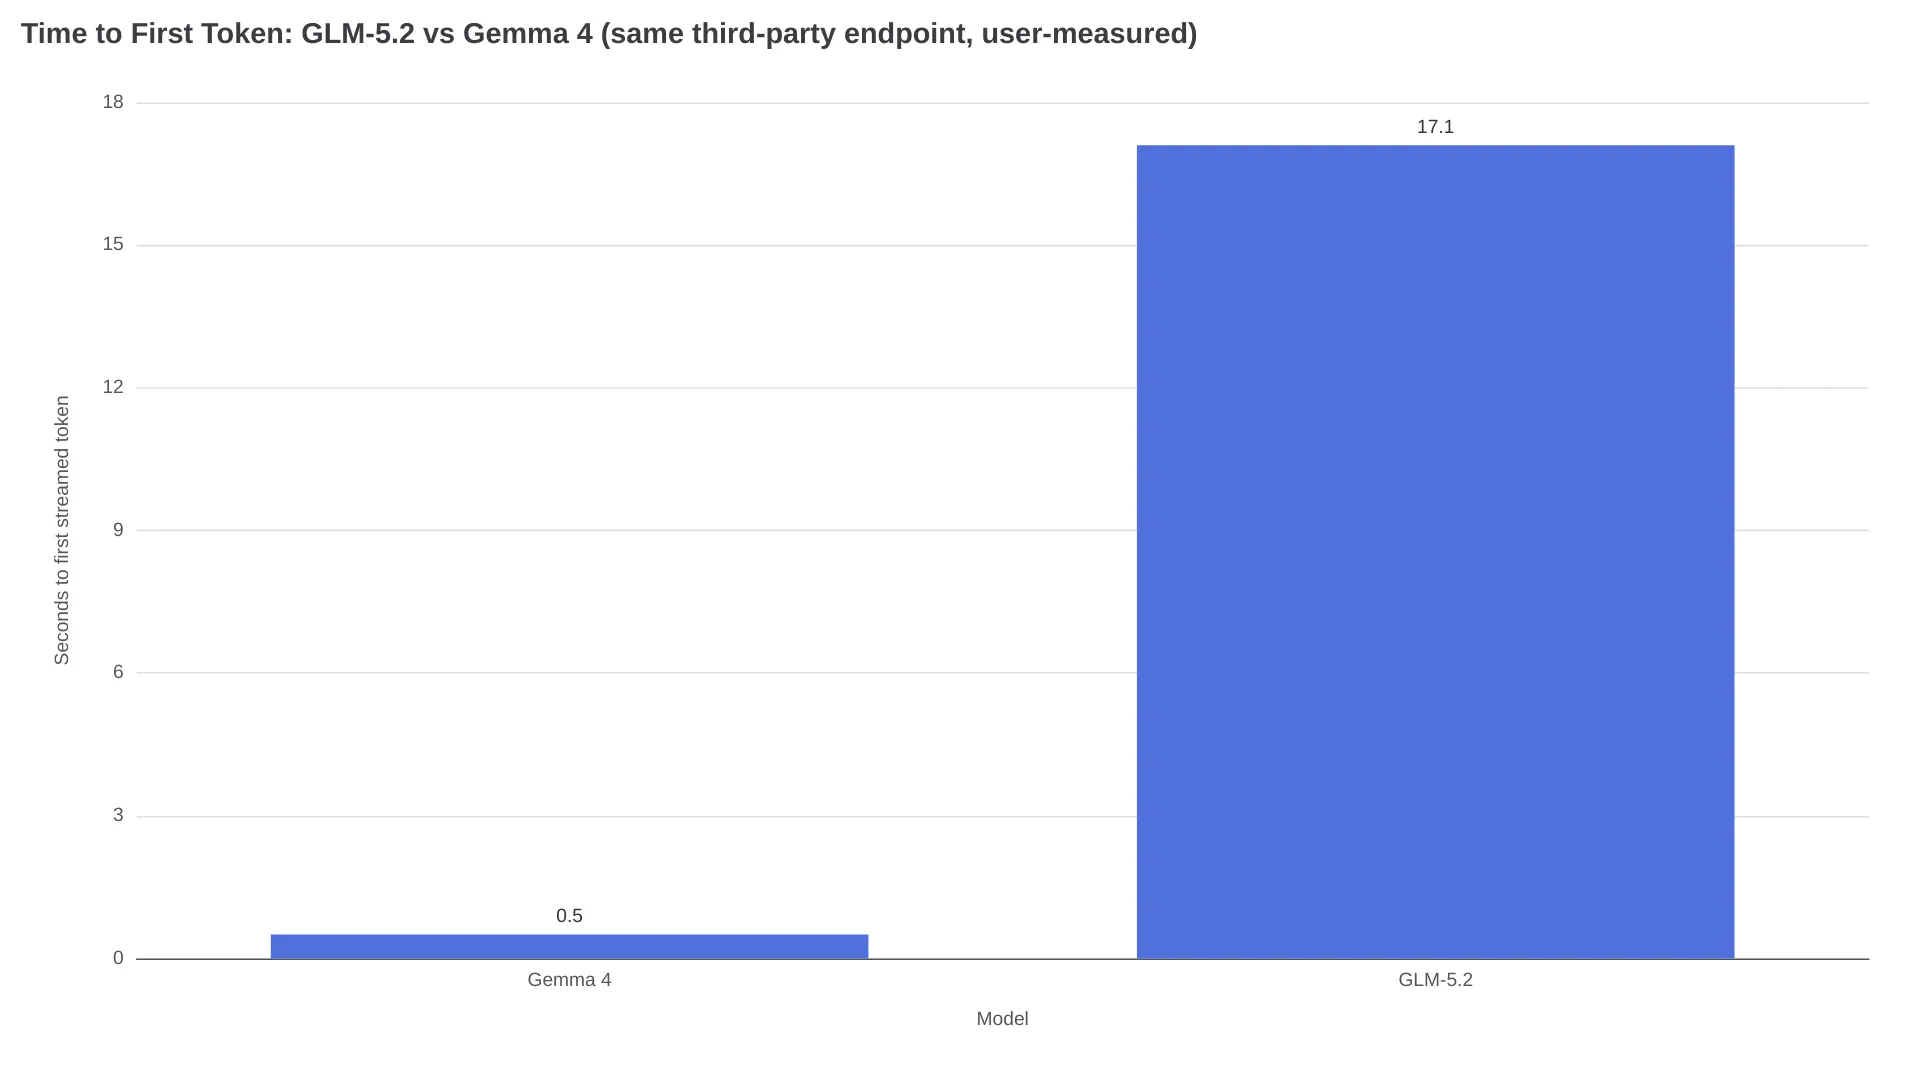
APIの計測値で最も弱いのは、最初のトークンが返るまでの時間だ。Sarvam上でのエンドポイント比較では、GLM-5.2のストリーミング速度は148トークン/秒で、Gemma 4の260トークン/秒に届かなかった。さらにtime-to-first-tokenは17.1秒で、Gemma 4の0.5秒に対して大きく遅い。「生成開始が33倍早い」と@noctus91は表現している。
公称スループットにも同じ問題がある。
「GLM 5.2を提供するプロバイダーはどこも200 tok/s以上をうたっている。しかし実際に使うと50 tok/sしか出ない」——@tomgreenwald。同氏はこれを「プロバイダー版benchmaxxing」と呼んでいる。
サブスクリプションルートでは、ほかにも2つの失敗パターンが報告されている。1つは、セッション途中でストリームが落ちること。「ストリーミングが……止まった」として、GLM Pro Coding Planの利用者は最終的に利用を断念した。もう1つは、規模に伴う劣化だ。「コンテキストが300kを超えるとモデルが遅くなる」と@mosh_Ontongは報告する。対照的に、DataLLM Labが自社ゲートウェイで実行した9タスクのベンチマークでは、完了タスクあたりの平均は12.3秒だった。レイテンシーの大部分を左右するのは、モデルそのものよりエンドポイントである。
レート制限と429:リトライ前提で設計する
Z.aiのモデルドキュメントにはレート制限の一覧表がなく、開発者は429を受けながら実測で上限を知ることになる。Coding Planルートでは、コミュニティの報告を見る限り、リトライは例外処理ではなく通常運転だ。以下のスレッドは発生率を示すものではないが、失敗パターンには一貫した傾向が見られる。
- 「今、coding max planでほぼ2リクエストに1回、429/529が出る。同時実行はしていない……」——u/A-B-user
- 「そう、ほぼすべてのリクエストがリトライされる。でも結果はとても良い」——u/hyeluoh
- 「glm52を同時実行1で使えば、非常に遅いがエラーなしで問題なく動く」——u/evia89
エラーはクライアントにも依存する。同じAPIキーでもZCodeでは動く一方、OpenClawでは429になるケースがあり、別のユーザーはこれを「混みすぎ」メッセージだと説明している。サブスクリプション層ではさらに事情が複雑になる。中国のユーザーからは、Coding Planが5.2のワークロードをGLM-5.3へ自動切り替えするという報告がある。GLM-5.3はクォータ消費が速い。また、サードパーティのCoding Plan販売者が数回の呼び出し後にレート制限するという声もある。
実装面で有効な対策は、ジッターを加えた指数バックオフ、書き込み操作に対する冪等性キー、リクエスト単位ではなくタスク単位のリトライ予算、そして自動で切り替えられるconcurrency=1の縮退モードだ。OpenRouterの429対策ガイドにあるリトライパターンは、ここでもそのまま適用できる。
Z.aiが答えていないキャッシュ課金の問題
コンテキストキャッシュはドキュメントに記載されている。7月13日にプロバイダーのページを確認した時点では、キャッシュ済み入力は100万トークンあたり約$0.26、通常入力は$1.40と表示されていた。ただし未解決なのは、一部ルートで繰り返し送信したコンテキストまで通常入力として請求されるという不満だ。長いシステムプロンプトを再送するエージェントループでは、これがタスクコストを大きく押し上げる。確認したコミュニティスレッドでは、APIに関する不満の中で最も反応を集めていた。
「GLM 5.2ではキャッシュトークンが正常に機能していない。繰り返したコンテキストがキャッシュトークンではなく通常入力として計上されている」——@Da7_Tech。同氏はこれを「深刻な請求・キャッシュ計上の問題」と呼んでいる。
そのスレッドでは、Claude Opus 4.8なら150万トークン未満で完了した同一タスクが、GLM-5.2では5時間クォータを100%使い切り、5300万トークン後も未完了だった。一方でアプリ自身のカウンターは約167万トークンを示していた。
2か月後も、同じ開発者は「キャッシュヒットが使用量に計上されているようだ、という不満を多くのユーザーが訴えている。自分の環境でも起きるなら、プランの価値は崩壊する」と要約していた。これらのスレッドでは、8月下旬まで公式の回答は確認できなかった。
修正済みだと確認できるまでは、キャッシュ入力価格は自分の請求データで検証すべきベストケースとして扱うべきだ。各レスポンスのusageオブジェクトからcached_tokensを記録し、週次で請求額と照合したい。
Reasoning effort:同じ設定を指す3つの名前
公式APIでは、thinking.typeでenabled/disabledを指定し、さらにreasoning_effortとしてhighとmaxを使える。ドキュメント内のサンプルでもreasoning_effort: "max"が使われている。Z.aiのローンチ案内では、maxは能力を最大化し、highは性能とトークン効率のバランスを取るものと説明され、コード用途にはmaxが推奨されていた。
統合時には2つのポイントがある。第一に、コーディングルートのデフォルトはmaxだ。「デフォルトがmaxなので、下げたい場合を除き設定する必要はない」——r/ZaiGLM。Reasoningトークンは出力トークンと同じ料金で計上されるため、このデフォルトは気づかないうちに支出を増やす。Coding Plansでは、プランの計上方式を調べたユーザーによると、平日北京時間14:00〜18:00の間はmax-effort呼び出しが3倍のクォータを消費する。これに5時間枠と週次クレジットが重なる。
第二に、その設定がバックエンドまで届かない場合がある。OpenCodeのユーザーは、カスタムプロバイダーでは「現状reasoning effortを調整できない」と報告している。また、一部クライアントは同じ設定を第3の名称であるxhighとして表示するが、そもそも転送していない可能性がある(r/opencodeCLI)。冗長さもこの設定に連動する。日次で比較している開発者は、ある競合モデルについて「Opus-4.8やGLM-5.2ほど冗長ではない」と述べている。
同じモデル名でも別物になる:エンドポイントの差
glm-5.2というモデル文字列は、実態として大きく異なるデプロイメントを指し得る。8月初旬にエンドポイント精度の結果が話題になった際、Z.aiのリードはコミュニティに対し、「追加の参照点として公式GLM-5.2 APIもテストしてほしい。100%を上回るかもしれない」と呼びかけた——@ZixuanLi_。同氏が参照点として挙げたのは、レポートで計測されていたサードパーティエンドポイントではなく、公式APIだった。
実際の差は、推論が途中で途切れるほど低い出力トークン上限、ローンチ直後だけ高く後から落ちるスループット、ホストごとに違うコンテキスト上限として現れる。たとえばTogether AIのGLM-5.2は256Kで提供される。一方、公式APIはドキュメント上100万、7月に比較したアグリゲーターもフルウィンドウを提供していた。
価格差は挙動差以上に大きい。Z.aiの入力$1.40・出力$4.40という表示価格に対し、7月のプロバイダー比較ではOpenRouterは$0.42/$1.32を掲載していた。キャッシュ入力料金もFireworksの$0.14から$0.26まで幅がある。まずワークロードに合うエンドポイントを選び、そのまったく同じエンドポイントで再テストすること。あるルートでの挙動テスト合格は、別のルートには持ち込めない。
本番投入前に行う30分の事前テスト
ここまで挙げた失敗パターンは、いずれも本番ワークロードを任せる前の30分で検出できる。実際に出荷する予定のエンドポイント、モデル文字列、SDKを対象に、以下を実行してほしい。
- ツール制御の矛盾テスト。
tool_choice: "required"と「ツールを使わない」という指示を同時に送り、さらにparallel_tool_calls: falseと2件の注文を含むプロンプトを送る。どちらも無視される前提で確認する。オーケストレーションがいずれかに依存しているなら、この時点で止めるべきだ。 - リトライ耐久テスト。想定する同時実行数で50リクエストを投げ、429/529率とリトライ成功率を記録する。リトライがリクエストの約3分の1を超えるなら、保守的な運用基準として、同時実行数を1に落として再計測する。
- キャッシュ課金の確認。同一の10Kトークンのプレフィックスを5回再送し、usageレスポンスの
cached_tokensを合計する。ダッシュボードで入力として課金された量と照合する。ここに不一致があれば、コストモデルは成立しない。 - 実コンテキストサイズでのレイテンシー耐久テスト。1Kトークンのスモークテストではなく、実際に想定するコンテキストサイズで、最初のトークンまでの時間とストリーム途中の停止を測定する。300K超での遅延は、そうしなければ見えない。
- ルートの選定。Coding Planは対話型コーディングツール向けに作られている。プランの計上方式をまとめた投稿では、Webサイト、ボット、SaaSトラフィックの提供にはライセンスされていないとされる。プロダクトのバックエンドには従量課金APIを使うべきだ。
解消しないトレードオフもある。GLM-5.2は、市場でも特に安価な高性能コーディングトークンを提供している。その代わりに必要になるのが、フロンティアAPIならトークン単価へ織り込まれているラッパー側のエンジニアリングだ。
GLM-5.2 APIレビュー:よくある質問
GLM-5.2でOpenAI SDKは使える?
使える。chat completionsでは、base_urlをhttps://api.z.ai/api/paas/v4/、モデルをglm-5.2に指定すればよい。ただしResponses APIは存在しないため、OpenAIの新しいAPI面とCodexには変換レイヤーが必要になる。
GLM-5.2 APIはストリーミング、function calling、構造化出力に対応している?
いずれも対応機能として記載されている。コンテキストキャッシュとMCPも同様だ。ただし注意すべきは挙動面である。ストリーミングの安定性はエンドポイントごとに異なり、OpenAIのツール制御フィールド(auto以外のtool_choice、parallel_tool_calls、strict)は守られない。
使うべきモデル文字列とベースURLは?
公式の従量課金ルートでは、https://api.z.ai/api/paas/v4/に対してglm-5.2を使う。Coding Planは異なるベースURLを使用する。OpenRouterではモデル名がz-ai/glm-5.2となっている。
GLM-5.2が遅い、または異様に冗長なのはなぜ?
コーディングルートではreasoning effortがmaxでデフォルト設定され、出力トークンとして課金される。またコミュニティの報告では、持続スループットは公称の200 tok/s超ではなく50 tok/s付近にとどまる。レイテンシーと冗長さは、モデル固有の限界より先に、設定とエンドポイントの影響を疑うべきだ。
GLM Coding Planを自分のアプリのAPIとして使える?
使えない。プランの計上方式をまとめた投稿によれば、このサブスクリプションは対話型コーディングツール用であり、Webサイト、ボット、SaaS製品への提供は対象外だ。北京時間のピーク帯におけるクォータ倍率を考えても、安定したトラフィックには向かない。
100万トークンのコンテキストウィンドウは、すべてのプロバイダーで利用できる?
利用できない。公式APIと大半のアグリゲーターは100万トークンに対応するが、Together AIではGLM-5.2が256Kに制限されている。リポジトリ規模のワークフローでは、アーキテクチャまで変わり得る差だ。
関連記事
- GLM-5.2レビュー:話題から2か月後の評価 — モデル品質、ベンチマーク、向いている利用者
- GLM 5.2 API:最安の利用方法、価格、無料キー — プロバイダー別価格の完全比較
- GLM-5.2 vs GLM-5.3 — 8月の後継モデルは判断を変えるのか