 AIREITER
推論性能のピークを追うモデルではない。Nemotron 3.5 Lightningは、AIエージェントが繰り返し行うツール呼び出し、検証、整形といった実行処理を、より速く低コストで回すためのモデルだ。NVIDIAのベンチマークではQwen 3.6 35B-A3Bに12項目中11項目で後れを取る一方、トークン生成は最大4倍高速とされる。総パラメータ数は30Bだが、各トークンで有効になるのは3Bのみ。なお、フル精度のBF16ウェイトには80 GB GPUが必要で、NVIDIAは本番用途にNVFP4チェックポイントを推奨している。
Nemotron 3.5 Lightningの構成と30Bモデルとしての特徴
Nemotron 3.5 Lightningは、Mamba-2の状態空間レイヤー、MoEルーティング、選択的なAttentionレイヤーを組み合わせたハイブリッドアーキテクチャを採用する。NVIDIAではこの構成をnemotron_hと呼んでいる。Mamba-2レイヤーによって長文コンテキスト時のAttentionに伴うメモリおよび計算負荷を抑え、純粋なAttentionモデルなら直面する二次的なコスト増を避けながら、最大100万トークンのコンテキストウィンドウを実現した。ただしモデルカードによれば、単体のH100 80GBでは実用上256Kまでに制限される。
| 仕様 | 内容 |
|---|---|
| 総パラメータ数 | 30B |
| トークンあたりのアクティブパラメータ数 | 3B |
| アーキテクチャ | Mamba-2 + MoE + Attentionのハイブリッド |
| コンテキスト長 | 最大100万トークン(単体H100では256K) |
| 精度オプション | BF16、NVFP4 |
| ライセンス | OpenMDW v1.1(商用利用可) |
| 対応言語 | 英語、スペイン語、フランス語、ドイツ語、イタリア語、日本語、コーディング |
| 事前学習コーパス | 20T+トークン |
| 推論モード | チャットテンプレートのenable_thinkingで切り替え可能 |
| 推奨サンプリング設定 | Temperature 1.0、top-p 0.95 |
NVIDIAはLightningをNemotron 3ファミリーで最小のモデルとして位置付け、エージェントハーネスの挙動に特化して学習させている。対象はツール呼び出し、出力の検証、結果の整形、サブエージェントへの委譲だ。複雑な計画はNemotron 3 Ultraのような最先端の推論モデルに任せ、プレミアムモデルのトークン予算を消費しがちな定型実行処理をLightningが引き受ける、という役割分担になる。
ベンチマークで見える得意分野と弱点
HuggingFaceのモデルカードには、LightningとQwen 3.6 35B-A3B、Gemma 4 26B-A4B、Nemotron 3 Nano/Super、GPT-OSS 20Bを比較したベンチマークが14行掲載されている。判断材料として重要な10項目を以下にまとめた。
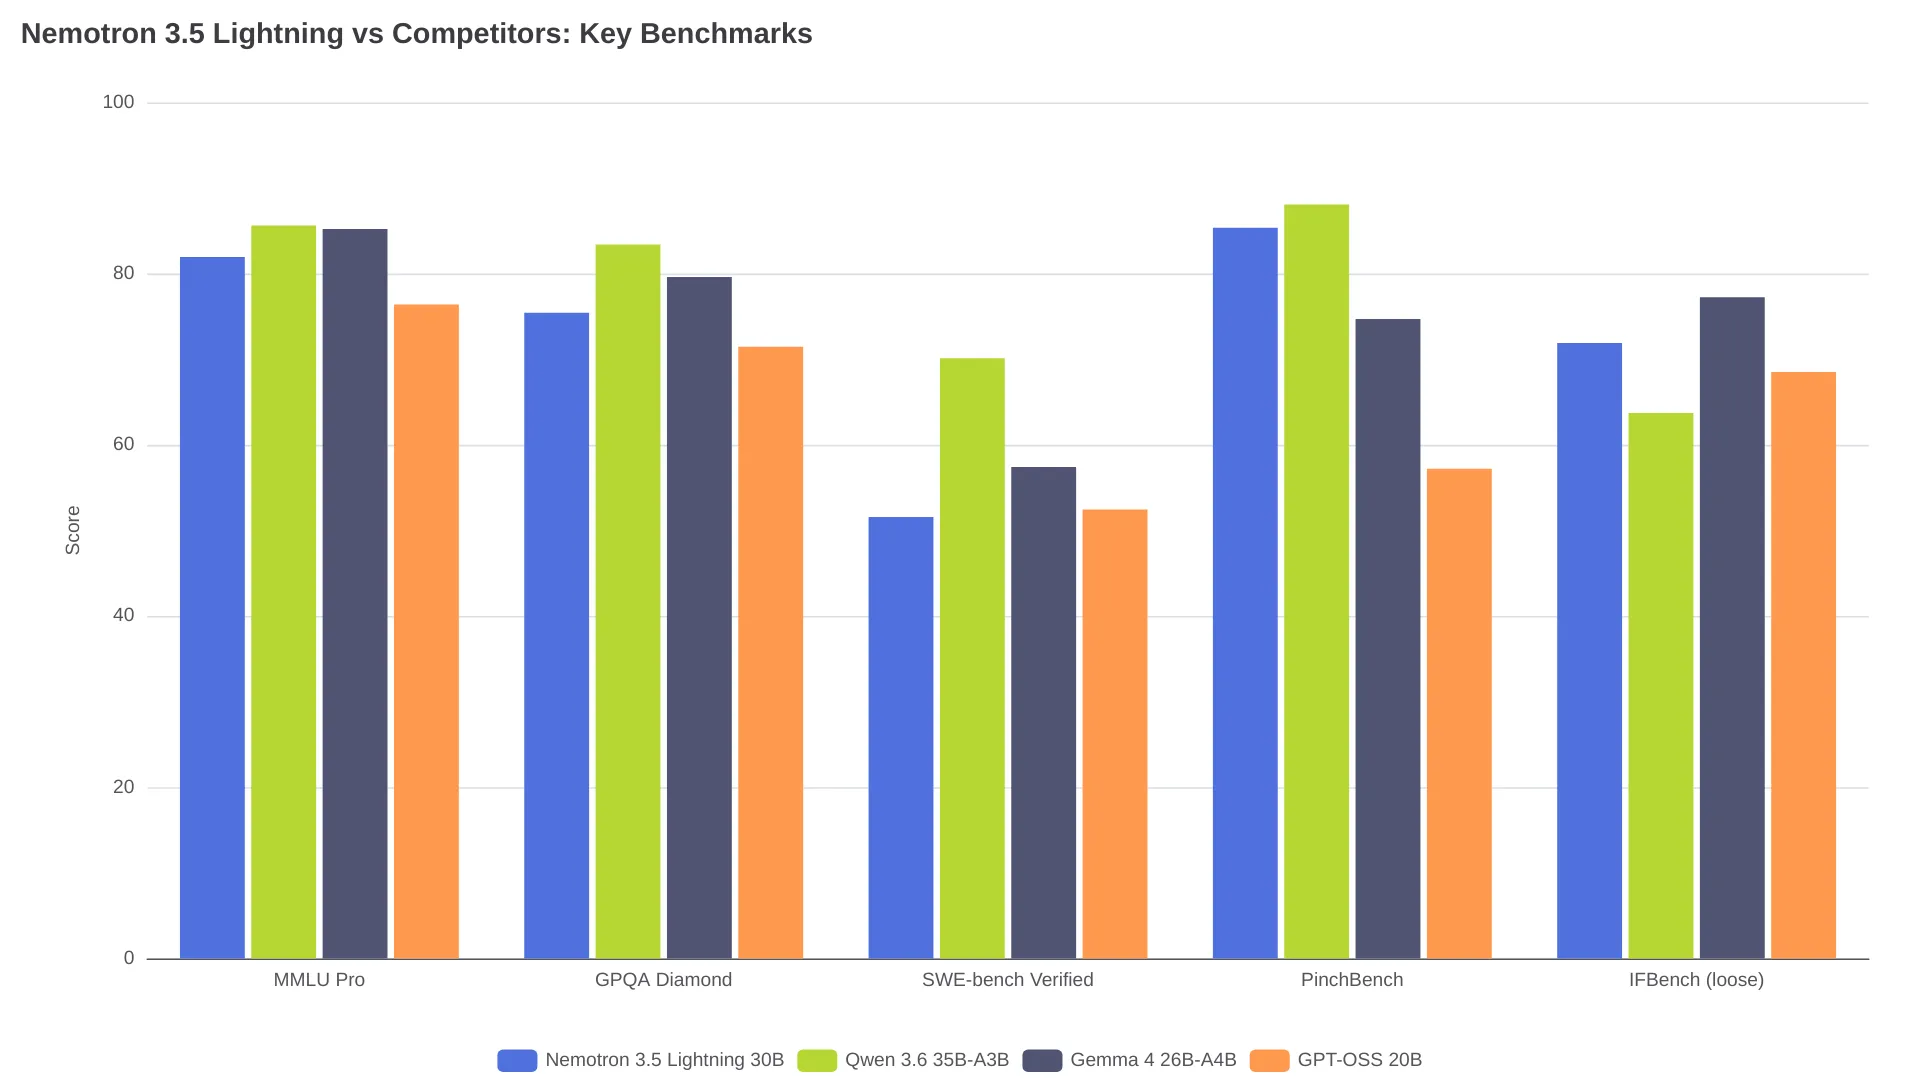
| ベンチマーク | Nemotron 3.5 Lightning | Qwen 3.6 35B-A3B | Gemma 4 26B-A4B | GPT-OSS 20B |
|---|---|---|---|---|
| MMLU Pro | 81.94 | 85.63 | 85.20 | 76.40 |
| GPQA Diamond(ツールなし) | 75.44 | 83.40 | 79.61 | 71.46 |
| SWE-bench Verified | 51.56 | 70.12 | 57.40 | 52.44 |
| SWE-bench Multilingual | 39.33 | 63.40 | 43.40 | 41.93 |
| Terminal-Bench 2.1 | 24.58 | 44.38 | 37.22 | 15.17 |
| PinchBench | 85.37 | 88.07 | 74.70 | 57.20 |
| BrowseComp | 36.97 | 48.74 | 26.30 | - |
| IFBench(loose) | 71.88 | 63.71 | 77.25 | 68.50 |
| AA-LCR | 52.00 | 61.06 | 57.56 | 32.88 |
| SciCode | 32.60 | 35.33 | 40.28 | 38.63 |
比較可能な12項目のうち、LightningがQwen 3.6 35B-A3Bを上回ったのは11項目ではなく1項目だけだ。その例外がIFBench(指示追従、looseモード)で、Lightningは71.88、Qwenは63.71。Lightningが8ポイント上回る。この傾向は、同モデルのエージェント実行向けという設計とも一致する。ツール呼び出しの書式や出力検証では、生の推論力以上に指示を正確に守ることが重要になるためだ。
差が出るのは速度面である。NVIDIAのPinchBench評価では、10,000件のエージェントタスクをH100 GPU時間で計測している。Lightningは精度86%で約16.5 GPU時間で完了した。対してQwen 3.6 35Bは精度87%で23.5〜24 GPU時間、Gemma 4 26Bは精度73%で25〜26 GPU時間だった。
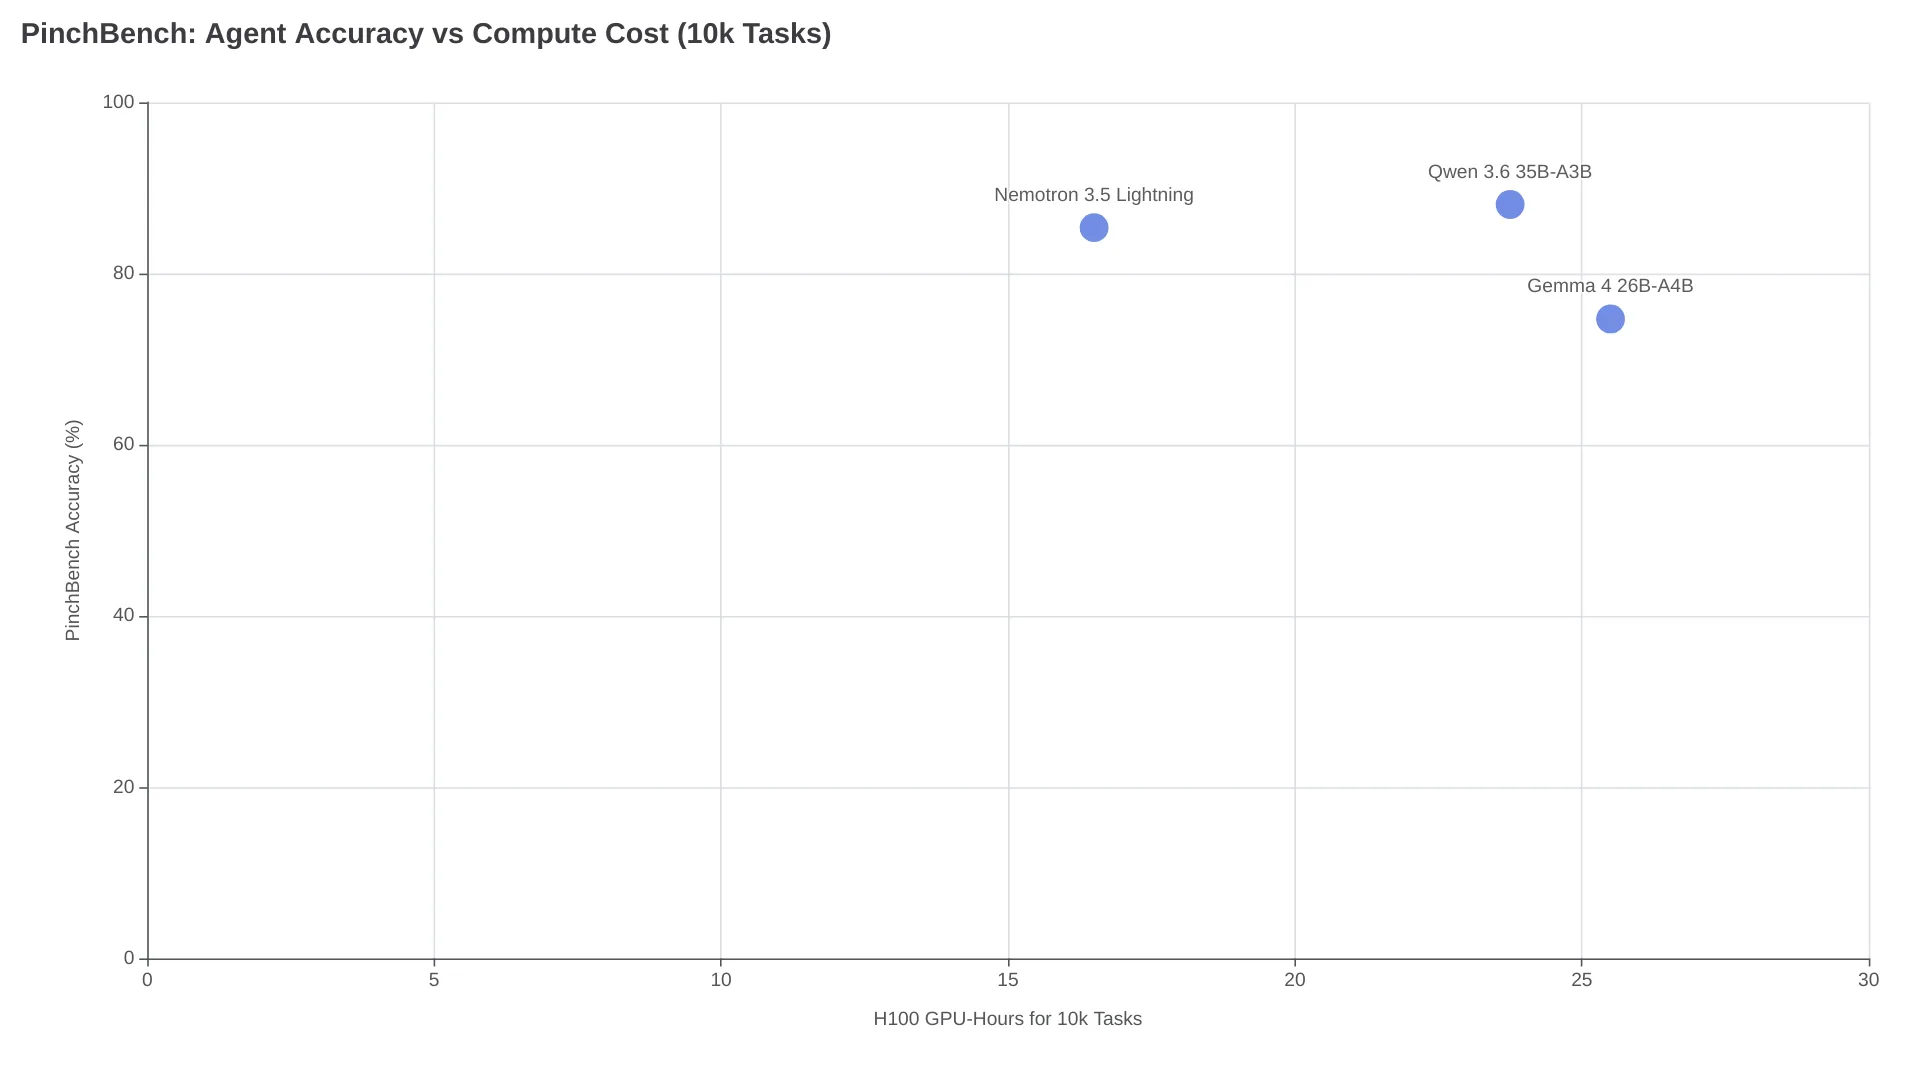
ほぼ同等の精度で、必要な計算量はおよそ30%少ない。GPU時間課金で10,000ステップのエージェント処理を回すなら、この差は無視できない。NVIDIAはArtificial Analysis leaderboardにおいても、Lightningが約670出力トークン/秒、Intelligence Indexでは約23〜24ポイントに達すると報告している。総パラメータ数40B未満のオープンウェイトモデルでは、パレートフロンティアに位置するという評価だ。
r/LocalLLaMAのコミュニティテストでも、速度面では似た結果が報告されている。DGX Sparkのユーザーは、NVFP4チェックポイントでターゲットモデル単独なら78.5トークン/秒、投機的デコーディングありでは90.7トークン/秒だったとしている。別のメインの議論スレッドでは、品質は「Gemma 4 26Bと31Bの間だが、26B寄り」と評価された。Gemma 31Bより約2倍高速な一方、多くのthinkingトークンを生成するため、実運用では速度メリットが相殺される場合もあるという。初期のGGUF Q4変換では約25 GBのファイルサイズと未使用テンソルの警告が報告されており、Mamba-2ハイブリッドアーキテクチャはGGUF系ツールでまだ完全に対応されていない可能性がある。
必要なGPUとローカル導入の選択肢
フル精度の参照ウェイトであるBF16チェックポイントは、単一GPUで動かす場合にH100 80GB 1枚、またはA100 80GB 1枚が必要となる。分割されたsafetensorsファイルのサイズは65.8 GBだ。NVIDIAは本番推論向けに、別途提供するNVFP4リリースを明示的に推奨している。
| チェックポイント | ファイルサイズ(概算) | 最低GPU要件 | 主な用途 |
|---|---|---|---|
| BF16 | 65.8 GB | H100/A100 80GB 1枚 | ファインチューニング、研究、量子化モデルの作成 |
| NVFP4 | ~16 GB | RTX 5090、DGX Spark、Jetson(Blackwell/Hopper/Ampere) | 本番推論、エージェント導入 |
| GGUF Q4 | ~25 GB | 16 GB+ VRAM(コミュニティ作成) | llama.cpp、Ollama、LM Studio |
NVIDIAはDay-0サポートに向け、4つのローカルサービングプロジェクトと協力した。対応先はvLLM、SGLang、Ollama、llama.cppであり、LM StudioとUnslothの名前も挙げられている。投機的デコーディングは次の3方式をサポートする。
- DSpark - DGX Sparkおよび低並行度のデータセンター推論向けに推奨
- DFlash - ワークロードに応じて選べる代替ドラフトモデル
- MTP(Multi-Token Prediction) - モデルに組み込み済みで、中〜高並行度に最適
ローカルハードウェアを用意せずに使うなら、LightningはNIMマイクロサービスとしてbuild.nvidia.comで、またOpenRouterでも利用できる。NVFP4チェックポイントはGeForce RTX 5090、DGX Spark、OEM GB10システム、NVIDIA Jetsonで動作する。
Lightningが生きるエージェントのルーティング設計
NVIDIAのオープンソースルーティングライブラリNeMo Switchyardは、精度、速度、コストに基づいて、エージェントワークフローの各ステップを最適なモデルへ振り分ける。計画は最先端の推論モデルへ、実行はLightningへ回す設計だ。NVIDIAの社内ベンチマークでは、Switchyardにより「最先端レベル」のタスク完了率を維持しつつ、Opus 4.8単独利用時のおよそ3分の1までコストを削減できたとしている。Lightningへ振り分けられる実行タスクには、git pull、ツール出力の検証、結果の整形、定型的なAPI呼び出しが含まれる。
実際の活用例もある。CodeRabbitはRedditで公開した実運用事例で、ターゲットSFTとRLVR(検証可能な報酬を用いる強化学習)により、コードレビューのルーティング用途へNemotron 3.5 Lightningをポストトレーニングしたと報告している。凍結された1,000タスクの評価ではベースラインを上回り、学習コストは$100未満だった。NVIDIAはNeMo AutomodelおよびNeMo Megatron Bridge(LoRA/SFT)、NeMo RLおよびNeMo Gym(強化学習)、さらにNemotron-RL Agentic Terminal Pivotというオープンデータセットで、このワークフローを支援している。
エージェントパイプラインを構築するチームにとっての実践的な問いはこうだ。エージェント処理の大半を3BのアクティブパラメータコストでこなせるようLightningをファインチューニングし、本当に必要な少数のステップだけを最先端モデルに任せられるだろうか。
Nemotron 3.5 Lightningを選ぶべきケース
| ユースケース | 推奨 | 理由 |
|---|---|---|
| 大規模なエージェントルーティング(ツール呼び出し、検証、整形) | Lightning NVFP4 | アクティブパラメータ3B、トークン速度4倍、近い精度で計算量約30%削減 |
| 汎用的なコーディング支援 | Qwen 3.6 35B-A3B | SWE-bench Verifiedで70.12対51.56、19ポイント差 |
| 複雑な推論・計画 | Nemotron 3 Ultraまたは最先端モデル | Lightningは明確に計画用モデルではない |
| コンシューマーハードウェアでの単一GPUローカルチャット | RTX 5090上のLightning NVFP4 | 動作するが、GGUF変換はまだ不安定。vLLM/SGLangのほうが信頼性は高い |
| 限定的なエージェントタスク向けのファインチューニング | Lightning BF16 | アクティブパラメータ3Bにより学習コストを抑えられ、OpenMDW v1.1で商用利用可能 |
| 大規模な指示追従処理 | Lightning | IFBenchは71.88対Qwenの63.71で、8ポイント上回る |
Lightningは、大量の実行処理において最高精度と速度を交換するモデルだ。セッションあたり数百のエージェントステップを処理するなら、30%の計算量削減は積み重なる。ただし、同モデルのリリースは2026年8月11日であり、エコシステムの成熟はまだ途上にある。Mamba-2ハイブリッドアーキテクチャのため、GGUFベースのツールでは完全にサポートされていない可能性がある。現時点で最も安全な導入パスは、NVIDIAハードウェア上でvLLMまたはSGLangとNVFP4チェックポイントを組み合わせる方法だ。Apple Silicon環境、あるいはGGUF専用の環境では、コミュニティによる変換が安定するのを待ちたい。
よくある質問
Nemotron 3.5 Lightningはコンシューマー向けハードウェアで動かせる?
NVIDIAがコンシューマー向けハードウェアでサポートしているのはNVFP4チェックポイントのみだ。BF16ウェイトには80GB GPU(H100またはA100)が必要になる。NVFP4はGeForce RTX 5090、DGX Spark、NVIDIA Jetsonで動作する。16 GB+ VRAMのシステム向けにはllama.cppやOllama用のコミュニティ製GGUF Q4変換もあるが、初期ビルドではMamba-2ハイブリッドアーキテクチャに関する未使用テンソルの問題が報告されている。
Nemotron 3.5 LightningとQwen 3.6 35Bの違いは?
公開された12の比較可能なベンチマークのうち11項目では、Qwen 3.6 35B-A3BがLightningを上回る。差が大きいのはSWE-bench VerifiedとTerminal-Benchだ。一方でLightningはIFBenchの指示追従で優位に立ち、エージェントワークロードでは近い精度で約30%高速にタスクを完了する。汎用モデルとしてはQwen、エージェント実行の高速化を重視するならLightningが適している。
Nemotron 3.5 Lightningはコーディングに向いている?
純粋なコーディングベンチマークで見れば、答えはノーだ。SWE-bench Verifiedは51.56で、Qwen 3.6の70.12を下回る。ただしCodeRabbitは、$100未満でLightningをコードレビュールーティング用にファインチューニングし、ベースラインを上回った。モデルはカスタマイズを前提に設計されており、コードベース固有の規約を学習させれば、定型的なコードタスクをアクティブパラメータ3Bのコストで処理できる。
Nemotron 3.5 Lightningのライセンスは?
モデルはOpenMDW v1.1(Open Model Data Weight)で公開されている。NVIDIAはこれを「可能な限り寛容に」公開したものと説明している。ウェイト、学習データ、レシピを含め、商用利用が許可される。ライセンスの完全な条件はHuggingFaceのモデルカードで確認できる。