 AIREITER
テキスト、画像、音声を扱えるモデルが6種類そろい、いずれも約20億パラメーター。それでもLiquid AIの料金ページには、2026年10月27日時点でLFM3の料金が見当たらない。現状のLFM3は、安価なエッジ向けモデルなのか、それともダウンロードして自前運用するためのリリースなのか。この料金の空白が、その判断を分ける。
LFM3をひと言でいえば:API料金未掲載の2B級スペシャリスト6モデル
LFM3は、Liquid AIがデバイス上の用途別インテリジェンス向けに展開する第3世代の基盤モデルファミリーだ。単一のチェックポイントではない。22兆トークンで事前学習したLFM3-1.7B-Baseを共通バックボーンとし、LFM3-1.7B、LFM3-VL-2B、LFM3-Audio-2B、LFM3-Omni-2B、d1-2B、d1-Omni-2Bの6モデルで構成される(発表)。
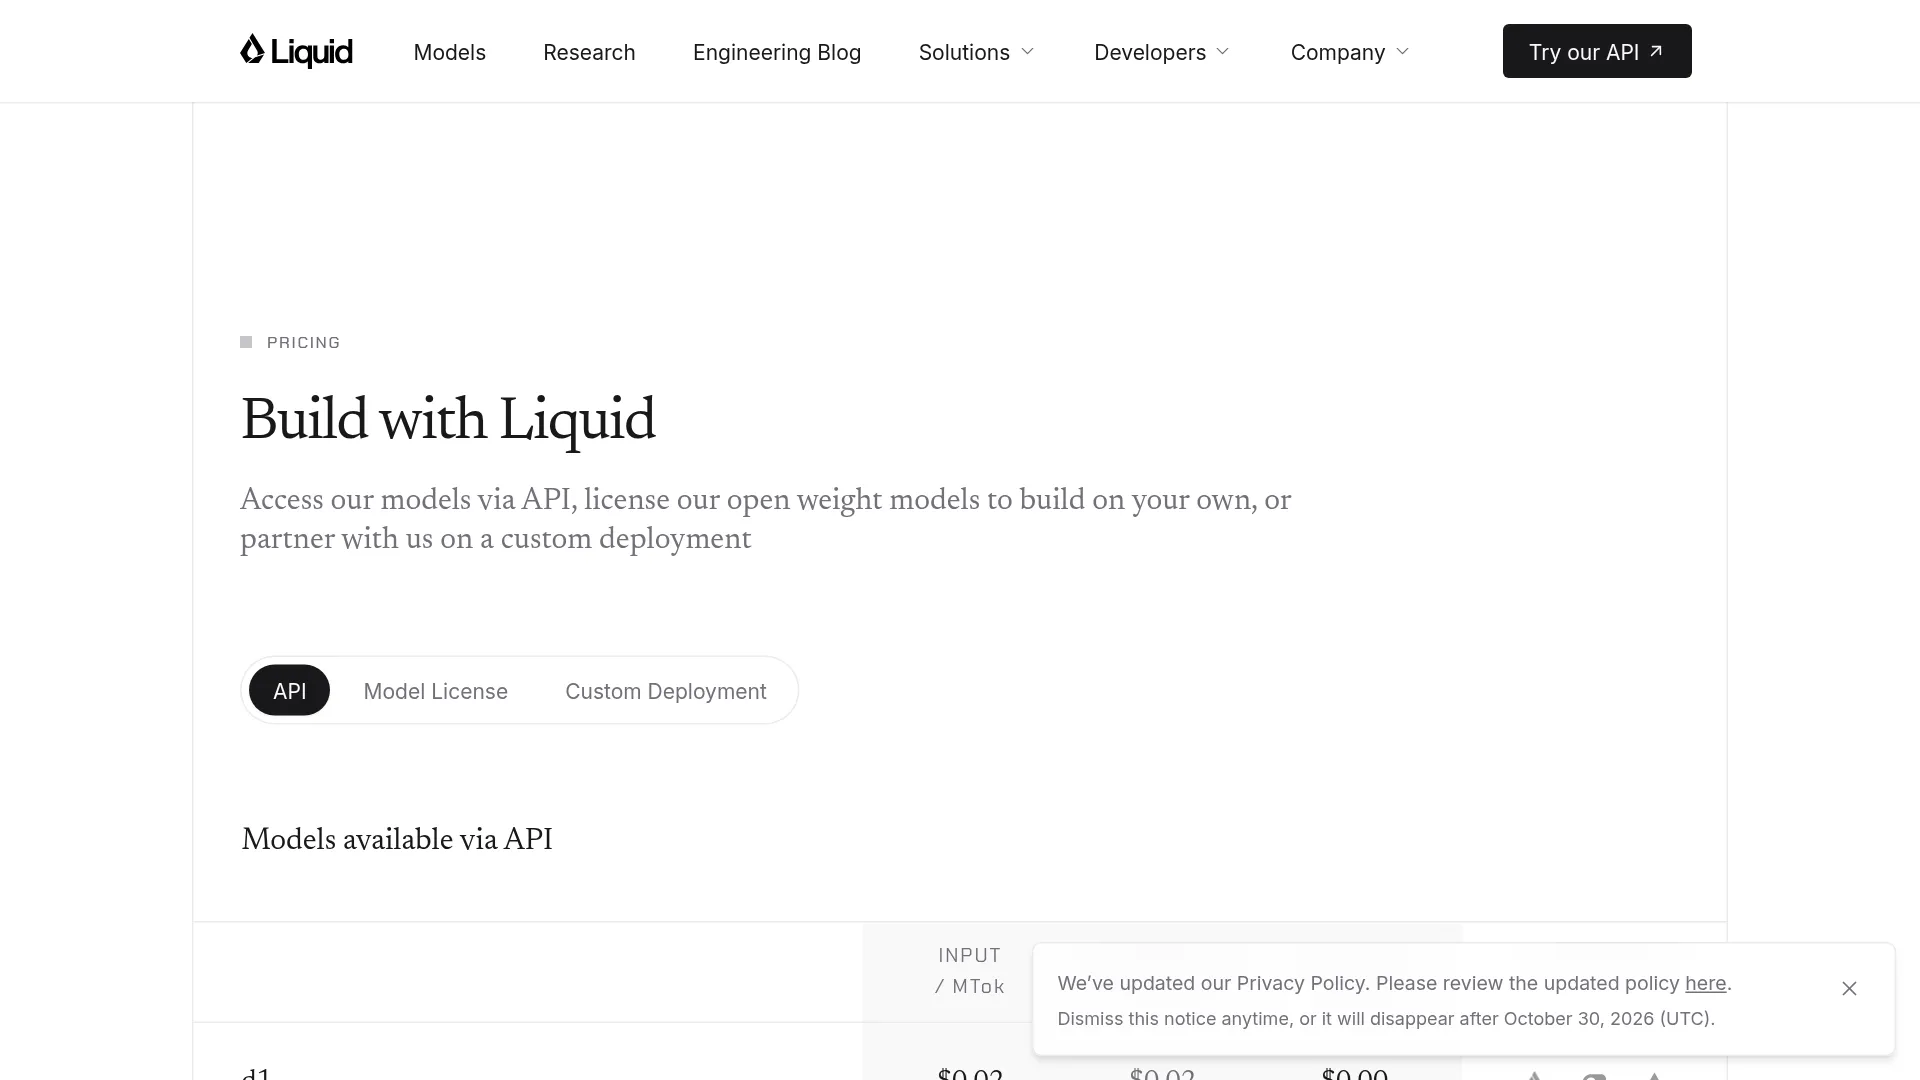
2026年10月27日にLiquid AIの料金ページを確認したが、LFM3の項目はなかった。掲載されているのは、下表のd1、d1-ultra、LFM2.5の料金だけだ。LFM3の発表では、重みをHugging Face、Liquid Playground、Liquid APIから利用できるとしているものの、現時点で直接確認できるのは前者2つ。新規組織には、Liquid Consoleで使える2ドル分の無料クレジットが付与される(料金ページ)。
6モデルの違いと、用途ごとの選び方
6つのLFM3チェックポイントは共通のバックボーンを使うが、受け付ける入力と返す出力はそれぞれ異なる。
| モデル | おおよそのサイズ | 入力 | 出力 | 向いている用途 |
|---|---|---|---|---|
| LFM3-1.7B | 1.7B | テキスト | テキスト | ローカルエージェント、ツール呼び出し、構造化出力 |
| LFM3-VL-2B | 1.9B | テキスト、画像、動画 | テキスト | 画像・動画の理解、ビジュアルエージェント |
| LFM3-Audio-2B | 2B | テキスト、音声 | テキスト、音声 | 音声チャット、認識、合成、18言語の翻訳 |
| LFM3-Omni-2B | 2B | テキスト、画像、動画、音声 | テキスト、音声 | 統合型マルチモーダルアシスタント |
| d1-2B | 2B | テキスト、画像、動画 | 確率校正済みの回答 | 分類、抽出、単一パスの判断 |
| d1-Omni-2B | 2B | テキスト、画像、動画、音声 | 確率校正済みの回答 | 信頼度スコア付きのマルチモーダルセンシング |
LFM3-1.7Bは256Kトークンのコンテキストウィンドウを備え、24層のトライハイブリッド構成を採用する。内訳は、ゲート付き短畳み込み層が13層、256トークンのウィンドウを持つスライディングウィンドウ・アテンション層が5層、グローバル・アテンション層が6層だ(発表)。最後の35億トークンにわたる中間学習では、エージェントの軌跡とツール呼び出しを追加。LiquidがこのテキストモデルをHermes Agent、Pi、OpenClawのようなハーネス向けと位置付ける理由はここにある(発表)。LFM3-VL-2Bは、Liquidにとって動画入力に対応する初のビジョンモデル。LFM3-Omni-2Bは、音声トラックと映像フレームを同時に扱う初のOmniモデルだ(発表)。
判断モデルは、ほかのモデルとは仕組みが違う。d1-2Bとd1-Omni-2Bは自己回帰生成を行わず、1回のフォワードパスで確率付きの校正済み回答を返す(発表)。ベンダー公称の判断レイテンシは、d1-2BでNVIDIA H100が5.7ms、AMD MI325Xが3.8ms。10秒の音声クリップを入力するd1-Omni-2Bでは、それぞれ12.4msと8.2msになる(発表)。
Liquidの主張と、こちらで確認できた範囲
Liquid AIが示すベンチマーク値は、あくまでベンダー公称値だ。独立した検証が出るまでは、公式の主張として見るべきだろう。以下の数値はすべてLiquidの発表に基づく。
| モデル | ベンダー公称の指標 | LFM3の数値 | 従来モデル/競合モデルの数値 |
|---|---|---|---|
| LFM3-1.7B | WebArena-Verified | 38.42 | 3.02(LFM2.5-2.6B) |
| LFM3-1.7B | サイズ/速度 | LFM2-1.2B比でパラメーター35%減、8K時のパラメーターあたり速度は約25%向上 | — |
| LFM3-VL-2B | 62 vision平均/エンコーダー | 平均71.4、エンコーダー164M、FLOPsは2.2分の1 | 平均57.6、Qwen3.5-2Bとエンコーダー性能が同等と主張 |
| LFM3-Audio-2B | UTMOSv2/レイテンシ | 3.83、初回トークンまで最短50ms、M4 Max CPUでリアルタイム比87倍 | 3.22(LFM2.5-Audio-1.5B) |
| d1-2B | ImajevBench | 75.5 | 64.0(d1-3B) |
直接確認できたのは、Hugging FaceのLiquidAI LFM3コレクションに6モデルすべてが並び、量子化版、MLX版、ONNX版が用意されていること。また、LM Studioのカタログでも、デスクトップ向けのLFM3派生モデルがすでに表示される。スコアは方向性を示すものとして扱いたい。平均値だけでは、OCR、グラウンディング、動画の各分野での差は見えない。4ビットで1GBという数字も、KVキャッシュとアプリのオーバーヘッドを含んでいない。
「今の時代、こんなに速くものを作れるようになっているのはすごい。」— @Nklockiewicz氏。MLX/ExecuTorchを使い、機内モードのiPhoneでLFM3を40 tok/sで実行(出典)
「速度と知能の面では、たいていサイズ以上の力を発揮する。ただ、私の経験では、まだ『実際の仕事』を任せられるほど賢くはない。」— u/spaceman_氏、r/LocalLLaMA(出典)
導入前に確認したい、年商1000万ドルのライセンス条件
Liquid AIのオープンウェイトライセンスは、企業の年間売上が1000万ドルを超えるまで無料で利用できる(料金ページ)。開発者、研究者、非営利団体、年間売上1000万ドル未満の企業は、オープンなLFMモデルをダウンロードし、実行、ファインチューニング、商用環境への導入まで行える。ファインチューニングの成果を非公開にすることも、モバイル、エッジ、オンプレミスに展開することも可能で、コピーレフトの義務はない(料金ページ)。
年商1000万ドルを超える企業は、有償のエンタープライズライセンスが必要になる。料金は導入規模に応じて営業経由で決まる。研究、教育、非営利目的の利用は、売上上限なしで無料のままだ(料金ページ)。LFM Open Licenseでは、この金額を境に無料の商用利用許諾が終了する。商用アプリに重みを組み込む前に、帰属表示、再配布、輸出に関する条件を法務担当者と確認しておきたい。
ローカル実行の現実:1GBで足りるのは重みだけ
LFM3-1.7Bは4ビット化すると約1GBだが、この数字に含まれるのは重みだけ(発表)。実際に動かすプロセスでは、ランタイム、長いコンテキスト用のKVキャッシュ、ビジョンや音声のエンコーダーも読み込む。特に動画フレームや音声クリップを処理するVL版とOmni版では、1GBに加えて余裕のあるRAMを見積もる必要がある。
まずはLFM3-1.7Bから始め、必要な場合だけVL、Audio、Omniを追加するのがよい。ベンチマーク前には、各モデルカードに記載された追加依存関係も確認したい。LFM3では、Ollama、LM Studio、llama.cpp、MLX、ONNXの利用方法がHugging FaceコレクションとLM Studioカタログに掲載されている。
モデルカードの例でtrust_remote_code=Trueが必要な場合は、コミットハッシュを固定し、リポジトリのコードを確認するか、最初は隔離環境で実行したい。このフラグを有効にすると、リポジトリに含まれるコードが実行されるためだ。Liquidは発表で音声対応言語を18言語としているが、言語ごとの品質表は示していない。日本語を含む英語以外の出力は、自分のデータで確認する必要がある。
現時点のAPI利用:接続先と料金の考え方
LFM3のAPI対応は発表されているものの、Liquidの公開料金ページに専用料金は掲載されていない。APIの接続先として案内されているのは、Liquid Console、OpenRouter、Vercel AI Gatewayだ(料金ページ)。
| 10月27日時点で掲載されているAPIモデル | 入力/MTok | キャッシュ入力/MTok | 出力/MTok |
|---|---|---|---|
| d1 | $0.02 | $0.02 | $0.00 |
| d1-ultra | $0.042 | $0.042 | $0.00 |
| LFM2.5-24B-A2B | $0.05 | $0.025 | $0.70 |
| LFM3-1.7B / VL / Audio / Omniのテキスト料金 | 未掲載 | 未掲載 | 未掲載 |
現時点での料金面の答えは、この「未掲載」に尽きる。LFM3を使うなら、当面はトークン単価ではなく、自前計算資源とエンジニアリングコストで予算を組むべきだ。もし現在LFM3のトークン料金を提示するプロバイダーがあれば、掲載済みのd1とLFM2.5を基準に比較し、Liquid Consoleへのプロキシなのか、独自の重みを提供しているのかを確認したい。掲載料金上、d1は100万トークンあたりの出力が$0.00なので、大量の検査パイプラインでは有力な選択肢になり得る。
LFM3 FAQ
LFM3のAPI料金はいくらですか?
2026年10月27日時点で、Liquid AIはLFM3のトークン単価を個別に掲載していない。公開ページにあるのは、d1、d1-ultra、LFM2.5-24B-A2Bの料金だけだ。
LFM3は商用利用が無料ですか?
LFM Open Licenseでは、年間売上1000万ドル未満の企業は商用環境で無料利用できる。それを超える企業には、有償のエンタープライズライセンスが必要になる。
LFM3はスマートフォンやノートPCで動きますか?
テキスト版なら、4ビットで約1GBに加えてランタイム分を見積もれば動かせる。Ollama、LM Studio、llama.cpp、MLX、ONNXに対応する。VL、Audio、Omniはエンコーダーとメディア処理のため、より多くのメモリが必要だ。
エッジエージェントには、LFM3とQwenやGemmaのどちらが向いていますか?
今回確認したローンチ時点の結果には、独立した比較は見当たらなかった。Qwen3.5-2BやQwen2.5-Omni-7Bを上回るというLiquidの主張はベンダー公称値なので(発表)、乗り換える前に自分のハーネスでLFM3、Gemma、Qwenを比較したい。
LFM3はGPU 1枚でファインチューニングできますか?
LiquidはSFT、DPO、GRPO、継続事前学習向けのノートブックを用意しており、すべてのモデルを単一GPUでファインチューニングできるとしている(発表)。ただし、必要なVRAM容量やデータセット規模は公開していない。
安価なプライベート特化モデルか、ハーネスが必要な小型汎用モデルか
データをデバイス外に出せない、メディアをローカルに置きたい、あるいは大量の判断処理でクラウドのトークン料金が重くなる。LFM3は、そうしたケースに合う。一方で、幅広い知識、長い創造的推論、ハーネスの調整なしでの安定した品質を求める用途では力不足だ。まず1種類をダウンロードし、自分のプロンプトとハードウェアで測定する。判断材料にすべきなのは、ローンチ時のグラフではなく、その結果だ。