 AIREITER
有料プランにおけるナレッジワークの標準モデルとして、AnthropicはClaude Opus 5.5を前面に出している。この判断自体にはおおむね納得できる。とはいえ、実際の利用者から最も多く聞かれるのは別の話だ。Pro、Max、Teamでは、想像以上の速さでクォータが減っていく。
Claude 5.5ファミリーの最初のモデルとして、Opus 5.5は2026年9月22日に登場した。Anthropicによれば、多くの用途でClaude Fable 5.1級の性能を持ちながら、Opus 5より実行コストを40%抑えられるという(anthropic.com)。同社は2026年11月12日のデイリードライバー向けガイドで、その位置付けを明確にした。リサーチ、分析、執筆、レポート、スプレッドシート、プレゼンテーションでは、まずOpus 5.5をMedium Effortで使い、必要になったときだけ上げるという方針だ(claude.com)。本稿は公式ガイダンス、第三者ベンチマーク、ユーザーのクォータ報告をもとにしたレビューであり、筆者による一次ラボテストではない。
結論:Opus 5.5を標準にして、EffortはMedium固定でよい
通常はOpus 5.5を選んだままでいい。日々のナレッジワークならEffortはMediumで運用する。モデルを切り替える前にまずEffortを上げ、判断の質より処理速度や件数を優先したい場合はSonnet 5.5またはHaiku 5.5へ落とす。
これはブランドへの忠誠心ではなく、単純に効率の話だ。Anthropicのコーディング・ナレッジワーク評価では、MediumのOpus 5.5がHighのOpus 5に並ぶか上回った。さらにAnthropicのデイリードライバーガイドで紹介されているFactoryの結果では、MediumはHighのOpus 5と同等の結果を出しつつ、出力トークンを20〜25%削減したという。ClaudeアプリとClaude CodeではMediumが初期設定でもあるため、多くの契約者は設定に触れなくてもこの挙動を利用できる。
ただし、サブスクリプション利用ではAPIの単価表よりクォータが制約になる。API料金は入力100万トークンあたり$4、出力100万トークンあたり$20で、Opus 5の$5/$25から下がった。キャッシュ読み取りは100万トークンあたり$0.20だ。しかしAnthropicのデイリードライバーガイドが説明するように、高価格帯モデルほどサブスクリプション上の利用枠を速く消費する。実際、負荷の高いセッションでは5時間枠が15〜30分で尽き、週次制限も9月の好調な時期よりかなり早く減る、という報告が出ている。
11月の標準モデル切り替えでPro・Max・Teamは何が変わったのか
契約者にとって重要なのは、新しい標準モデル下でのクォータの仕組みだ。以下で触れる10月下旬の急速な消費報告があったにもかかわらず、Anthropicはローンチ時にPro、Max、Team、シート制Enterpriseプランの5時間利用上限を増やし、保存可能なレート制限リセットも提供すると発表した(anthropic.com)。一方、同社のガイドでは、Proと標準のTeam、シート制Enterpriseでは、ローンチ施策以外の通常枠にFable 5.2は原則含まれないとしている。Fableは利用クレジットを消費するため、通常業務はOpus、Fableは従量枠の例外として考えるべきだ。
日常使いの評価が強い領域:リサーチ、分析、執筆
数字をすべて検証しても崩れないリサーチメモ
厳しい試験になるのは、決算リリースを意図的に見つけにくくした企業業績レポートだ。数字や引用を一つでも捏造すれば、そのレポートは失格になる。Opus 5.5はEffort設定をまたいで18件中16件のレポートを通過した。Anthropicによれば、Fable 5.1もOpus 5も、同じ基準を一度も通過していない(claude.com)。Anthropicのローンチ記事で紹介されたWalleye Capitalの外部検証も興味深い。Opus 5.5は最低Effortでテスト群の大半を解き、より高いEffortでは評価器自身の指示にあった1件ずれのインデックスエラーまで見つけた。Walleyeによれば、これを発見したモデルは過去のテストにはなかったという。
日常業務では、成果物と参照ソースを明確にしたうえでオープンなリサーチを任せ、文章表現より数値を重点的に監査する使い方が向く。
スプレッドシート、M&A計算、密度の高いグラフ分析
2社のHRソフトウェア企業による架空の合併案件では、Opus 5とOpus 5.5のどちらもExcelモデルと経営層向けプレゼンテーションを作成し、同じディール判断に到達した。Opus 5.5は93分に対して63分で完了し、作成コストは報告ベースで50%低く、より網羅的なモデルを出力し、軽微なエラーも少なかった(claude.com)。より広い金融ワークフローでは、HebbiaはOpus 5.5の条件カバレッジを86.6%と報告しており、Opus 5の60.3%を上回る。Rogoも、BigFinance BenchでHighのOpus 5を約60%少ない出力トークンで上回ったとしている。いずれもAnthropicのローンチ記事で紹介された結果だ。
ビジョン性能も同じ文脈で重要だ。Anthropicは、密度の高い文書、グラフの数値、スクリーンショット、図解において、Opus 5.5を最も優れたOpusのビジョンモデルと位置付ける。最低EffortのOpus 5.5でも、最高EffortのOpus 5より高い精度で密なグラフを読めたという(claude.com)。公開されているChartographyスコアは、最高評価設定でツールなし64.4%(claude.com)、ローンチ時のスコアカードではツールあり89.0%だ。GDPval-AAのプロフェッショナルワークEloも1846で、Fable 5.1の1735、Opus 5の1708を上回っている(anthropic.com)。
実務では、完成済みのスプレッドシートやスライドデッキを最初から直接依頼する。数値を文字起こしするよりグラフ画像を添付し、最初のメッセージで完了条件も指定しておくとよい。
アウトラインではなく、完成文書やデッキを作らせる
執筆面での強みは、単に「文章がうまい」という話ではない。指示追従と検証しやすさにある。Anthropicによれば、Opus 5.5は論点を逸らさず、結論を先に示し、専門用語を抑え、指定したスタイルルールに従う。また、何を行い、何を見つけ、追加でどの入力が必要かも説明する。第三者の評価もおおむね同じ方向だ。Hayz LabsはOpus 5.5のライティングを100、コーディングを100、リサーチを94と評価し、10月時点のArenaではWebDevとエージェントで1位、クリエイティブライティングで2位としている。
率直に言えば、厳密な社内文体への合わせ込みには、まだ反復が必要になる。
Effort設定こそが実質的な価格表
eeselのEffort解説によると、Opus 5.5にはLow、Medium、High、Very High/Extra High、Maxの5段階がある。さらにHayz Labsによれば、思考処理は無効化できない。トークン単価そのものより、この設定ダイヤルの方が請求額を大きく左右する。
eeselがまとめたArtificial Analysisの数値では、同じ難しいタスクでもLowは約$0.55、Mediumは$1.34、Maxは$5.98となる。Intelligence Indexはそれぞれ約42、51、58だ。Maxでは出力トークンが約119,000に達することがあり、出力100万トークンあたり$20という料金では、ここがコストの中心になる。Hayz Labsのパレート分析でも近い傾向が見える。14日間のエージェントタスクでは中央値が約$1.61で、メイン表の中央値は$1.76、Highは約$1.82だった。
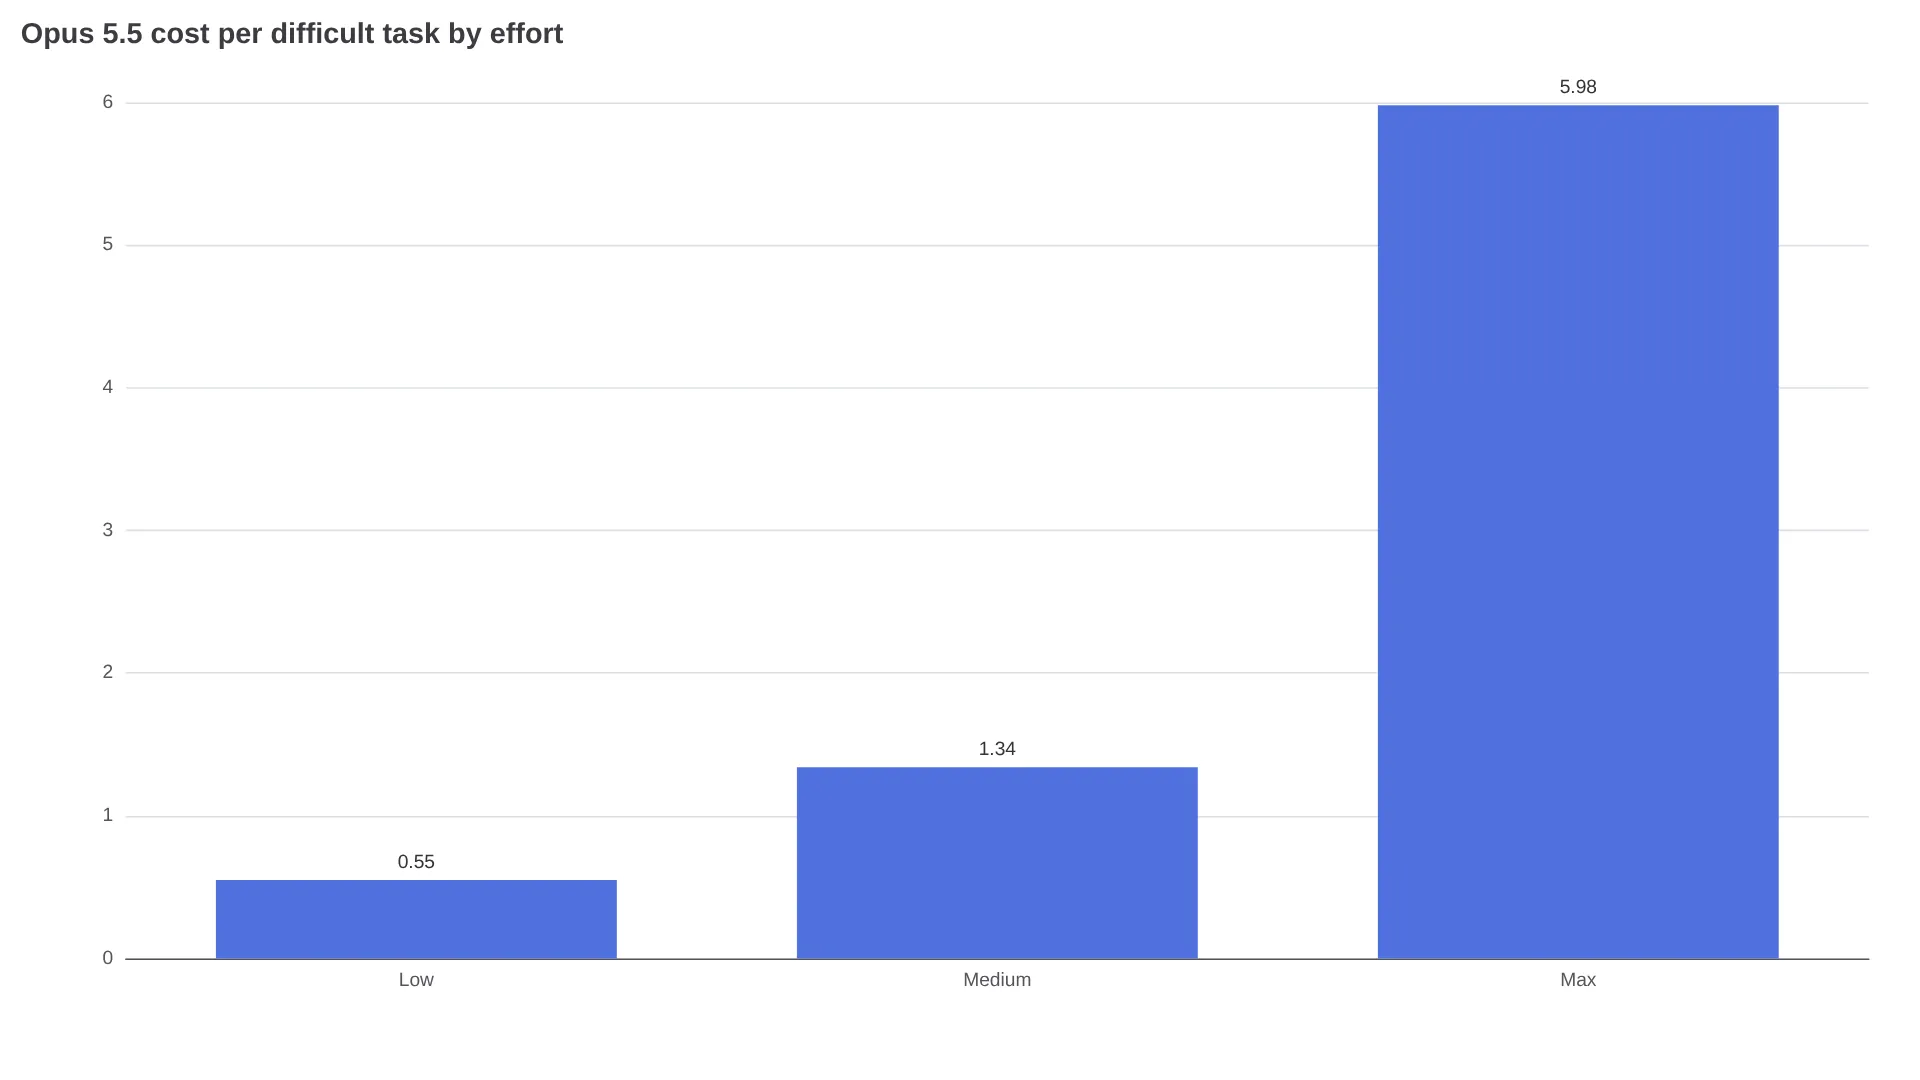
Effortを上げれば時間もコストも増えるが、結果が常に改善するわけではない。Anthropic自身も、「think hard」のような文言は外すよう勧めている。推論はすでに有効であり、深さはEffort設定とタスク内容で決まる。Mediumで明確に行き詰まった場合にだけ、一段上げればよい。
eeselの仕様表によれば、コンテキストウィンドウは100万トークン、出力は最大128,000トークン(Batchでは300,000)で、ネイティブビジョンにも対応する。eeselの価格レビューでは、長文コンテキストに追加料金はないとされている。長い文書を監査するワークフローでは、これは重要な点だ。
Haiku・Sonnet・Opus・Fableの使い分け方
Anthropicの11月ガイドと第三者のコスト分析は、同じ結論に行き着く。モデルを替える前に、まずEffortを調整することだ。以下の価格はAnthropicのデイリードライバーガイドの価格表に基づく。
| モデル | API料金/100万トークン(入力/出力) | 向いている用途 | 切り替える目安 |
|---|---|---|---|
| Haiku 5.5 | 100Kトークンまで$0.10 / $0.50 | 素早い検索、要約、分類、件数の多い限定的な作業 | 分析が長引く、または判断の重みが増すとき |
| Sonnet 5.5 | $2 / $10 | 要件が明確なタスク、文書の磨き込み、定義済みブリーフからのスライド作成 | Extra HighやMaxを日常的に使うようになったとき |
| Opus 5.5 | $4 / $20 | 大半のリサーチ、分析、金融業務、完成文書の作成 | Highで正当に再試行してもMediumが行き詰まるとき |
| Fable 5.2 | $8 / $40 | 長時間動くサブエージェントチームを使う、自由度の高い技術作業、科学、コーディング、金融 | 通常のナレッジワークでは、たいてい過剰 |
覚えておきたい分岐点はここだ。Sonnet 5.5をExtra HighやMaxまで押し上げると、タスクあたりのコストはOpus 5.5にほぼ近づく一方、判断力ではなお及ばない。コーディングプランの利用者からも同じ報告がある。SonnetをMediumより上に常用せず、代わりにOpus 5.5をLowで使うという方法だ(例:@cupid25157)。これは公式の「モデルより先にEffortを調整する」段階的な考え方と、タスク単価の計算にも合致する。
Fableは競合ではなく、上限の選択肢だ。Anthropicの11月のFable 5.2スレッドでは、FableとMythosを最も野心的で自由度の高い技術作業向け、Opus 5.5を大半のコーディング・ナレッジワーク向けの最強デイリードライバーとして位置付けている(@claudeai)。サブスクリプションでは違いがさらに明確になる。標準のPro/TeamシートではFableがクレジット請求になることが多く、軽い気持ちで「より良いモデル」を選ぶとクレジット料金につながりかねない。
5時間枠がすぐ尽きる理由と、クォータを守る運用法
公式ベンチマークではあまり扱われず、ユーザー報告で繰り返し話題になるのがここだ。問題として挙がるのは性能ではなく、具体的なクォータ消費量である。
「今夜はOpus 5.5の上限が完全に破壊されている!! 通常のセッションなのに、複数の人が5時間クォータをわずか15〜30分で使い切ったと報告している。週次上限の減り方もはるかに速い」 — Claude Codeセッションでの消費を報告した@TekonBurns
一部の利用者は、この変化をハネムーン期間の突然の終了と表現する。@kgauravnmは、挙動が怠慢になり週次枠の消費も速いとして、「Claude Opus 5.5のハネムーン期間は正式に終わった」と書いている。@ps_ios_devのようなTeamシート利用者からは、無料の週次リセット後でさえMedium Effortの利用量が「猛烈に」進むという声もある。ただし、留保すべき材料もある。@sonuv_devによる67,000メッセージ分のClaude Codeログ分析では、ツール呼び出し、失敗率、苦情率はおおむね横ばいで、「弱体化を示す証拠はほぼゼロ」とされた。少なくとも痛みの一部は、隠れた性能低下ではなく、標準利用量の増加と高価な推論によるものかもしれない。また、上限付近ではモデル選択も効く。@mohitsharmadlは、Fable 5.2のMediumでは解消できたバグをOpus 5.5のHighでは解決できなかったケースを報告している。つまり、何でもOpusに任せると、適切でない上限にクォータを使うことになる。
公式ガイダンスとユーザーの実践を踏まえた、クォータ運用の基本は次のとおりだ。
- まずはすべてOpus 5.5のMediumを標準にする。Highは性格設定ではなく、問題を確認した後の引き上げとして扱う。
- サブタスクごとに分ける。検索と分類はHaiku、要件が明確な下書きと磨き込みはSonnet、判断・監査・最終承認はOpusに任せる。
- SonnetをMediumより上で習慣的に使わない。分岐コストを見積もり、代わりにOpusのLow/Mediumへ移す。
- 同じ長いコンテキストを何度も貼り直すより、ファイル添付やリポジトリ接続を使う。長いコンテキストを毎ターン再送するとトークンが増え、計測上の利用量も増加する。
- 保存できるレート制限リセットは、実験で使い切らず、本当に締め切りがある週まで残す。
- Fableは、長期実行・マルチエージェント・自由度の高い技術作業という、勝てる狭い領域に限る。利用前に、そのシートでクレジット請求になるかも確認する。
FAQ:日常使いで気になるポイント
Claude Opus 5.5は日常的に使うモデルとして十分か?
判断力と検証可能性が重要なリサーチ、分析、執筆には十分だ。Hayz LabsはエージェントとWebDevで1位、ライティングでは最高評価としており、Anthropicが紹介する企業検証も同じ方向を示す。ただし、大量処理用には安価なモデルも併用しておきたい。
日常業務ではOpus 5.5の方がSonnet 5.5より優れている?
曖昧さがある仕事、あるいは結果の重要度が高い仕事なら、答えはYesだ。要件が明確で範囲の狭い大量タスクなら、LowまたはMediumのSonnetの方が速い。AnthropicはSonnetをFast、OpusをModerateと評価しており(claude.com)、トークン単価もおよそ半分だ。避けるべきなのは、SonnetをExtra HighやMaxで初期設定のように使うこと。節約分が消えてしまう。
Fable 5.2ではなくOpus 5.5を使うのはどんなとき?
大半のナレッジワークと標準的なコーディングにはOpusを使う。HighのOpusでも止まる、自由度が高く長期実行になる技術プロジェクトや、エージェント性が強い案件でFableへ上げる。標準のPro/TeamシートではFableがクレジット請求になることが多いため、先にプラン上の課金も確認したい。
100万トークンのコンテキストは長文でも安定して使える?
ファイル添付を使った監査型の作業では、Anthropicが提供してきたOpus構成の中で最も強力だ。根拠付きレポート18件中16件を通過した結果もある。ただし、非常に長いジョブではサブスクリプションのクォータを速く消費する。最大コンテキストですべてを処理するのではなく、検索はHaiku、判断はOpusに分けるのがよい。
注視すべきトレードオフ
Medium EffortのOpus 5.5は、ナレッジワークの標準として妥当だ。一方で、10月下旬に報告されたクォータの厳しさが新しい通常状態なのかは、まだ見極める必要がある。そうであれば、ローンチ時のメッセージが示唆したよりも、週の多くをSonnetで回すことになる。
関連記事:Claude Opus 5.5の価格レビュー、Claude Opus 5.5 Highレビュー、Claude Opus 5.5 vs GPT-6.1 Sol。