 AIREITER
コーディングエージェントを一日中動かすなら、Gemini 4 HydrogenとClaude Sonnet 5.5の違いは単純な料金比較では決まりません。入力と出力を50/50で混ぜた場合、Hydrogenは1Mトークンあたり$4.50で、Sonnet 5.5の$6.00より約25%安くなります。一方で、ターミナル操作やコンピューター操作のタスクを、人の手をあまり借りずに完了できるのはSonnet 5.5です。エージェントの実コストを知るには、料金表やベンチマークの順位ではなく、タスクを完了するまでのコストを見る必要があります。
Gemini 4 HydrogenとClaude Sonnet 5.5はいずれも、素早いコーディングやエージェントループ向けに1Mトークンのコンテキストをうたっています。Hydrogenには、推論の深さを4段階で調整できる機能もあります。
明日からSonnet 5.5をHydrogenに替えると、何が変わるのか
1日に200件のエージェントタスクを処理するチームなら、乗り換えの影響は請求額と、人の介入が必要になる頻度の2カ所に表れます。Hydrogenはトークン単価が低く、LLM Leaderboardの独立した速度サンプルでも、Sonnet 5.5の約144トークン/秒に対して約198トークン/秒を記録しています。大量処理向けの実行役として、下書きの生成、ファイルの並列読み込み、軽微な修正を素早くこなすタイプです。
Sonnet 5.5は、最後まで慎重に仕上げるタイプです。Googleの発表時の比較表では、ターミナル利用とコンピューター操作に重点を置いた3つのベンチマーク(Terminal-Bench 4.1、OSWorld 2.1、Terminal-Bench-Science)でSonnet 5.5が上回っています。詳しい数値は下の表にまとめました。いずれも、コマンドの失敗から復旧できるか、そこで処理が止まるかが結果を左右するタスクです。
ローンチ直後のRedditの議論でも、タスク単位では同じ傾向が見えます。
「hydrogenは悪くない。でも正直、sonnet 5.5より優れているとは感じない」 — r/GeminiAIのu/FewKey5274
ただし、このスレッドには統制されたコーディングベンチマークはありません。単発タスクでの勝敗が、そのまま実運用のハーネス全体の性能につながるとは限らない、という注意材料として読むべきです。移行前に、同じワークフローで両方を試してください。
$4.50対$6.00の混合料金だけでは、実際の請求額は読めない
公式APIの料金体系自体はシンプルです。Googleの発表によると、Hydrogenは入力が1Mトークンあたり$1.50、出力が1Mトークンあたり$7.50で、コンテキストウィンドウ全体を通じて一律です。Sonnet 5.5は、Anthropicの料金表とOpenRouterの比較によると、入力が1Mトークンあたり$2.00、出力が1Mトークンあたり$10.00です。
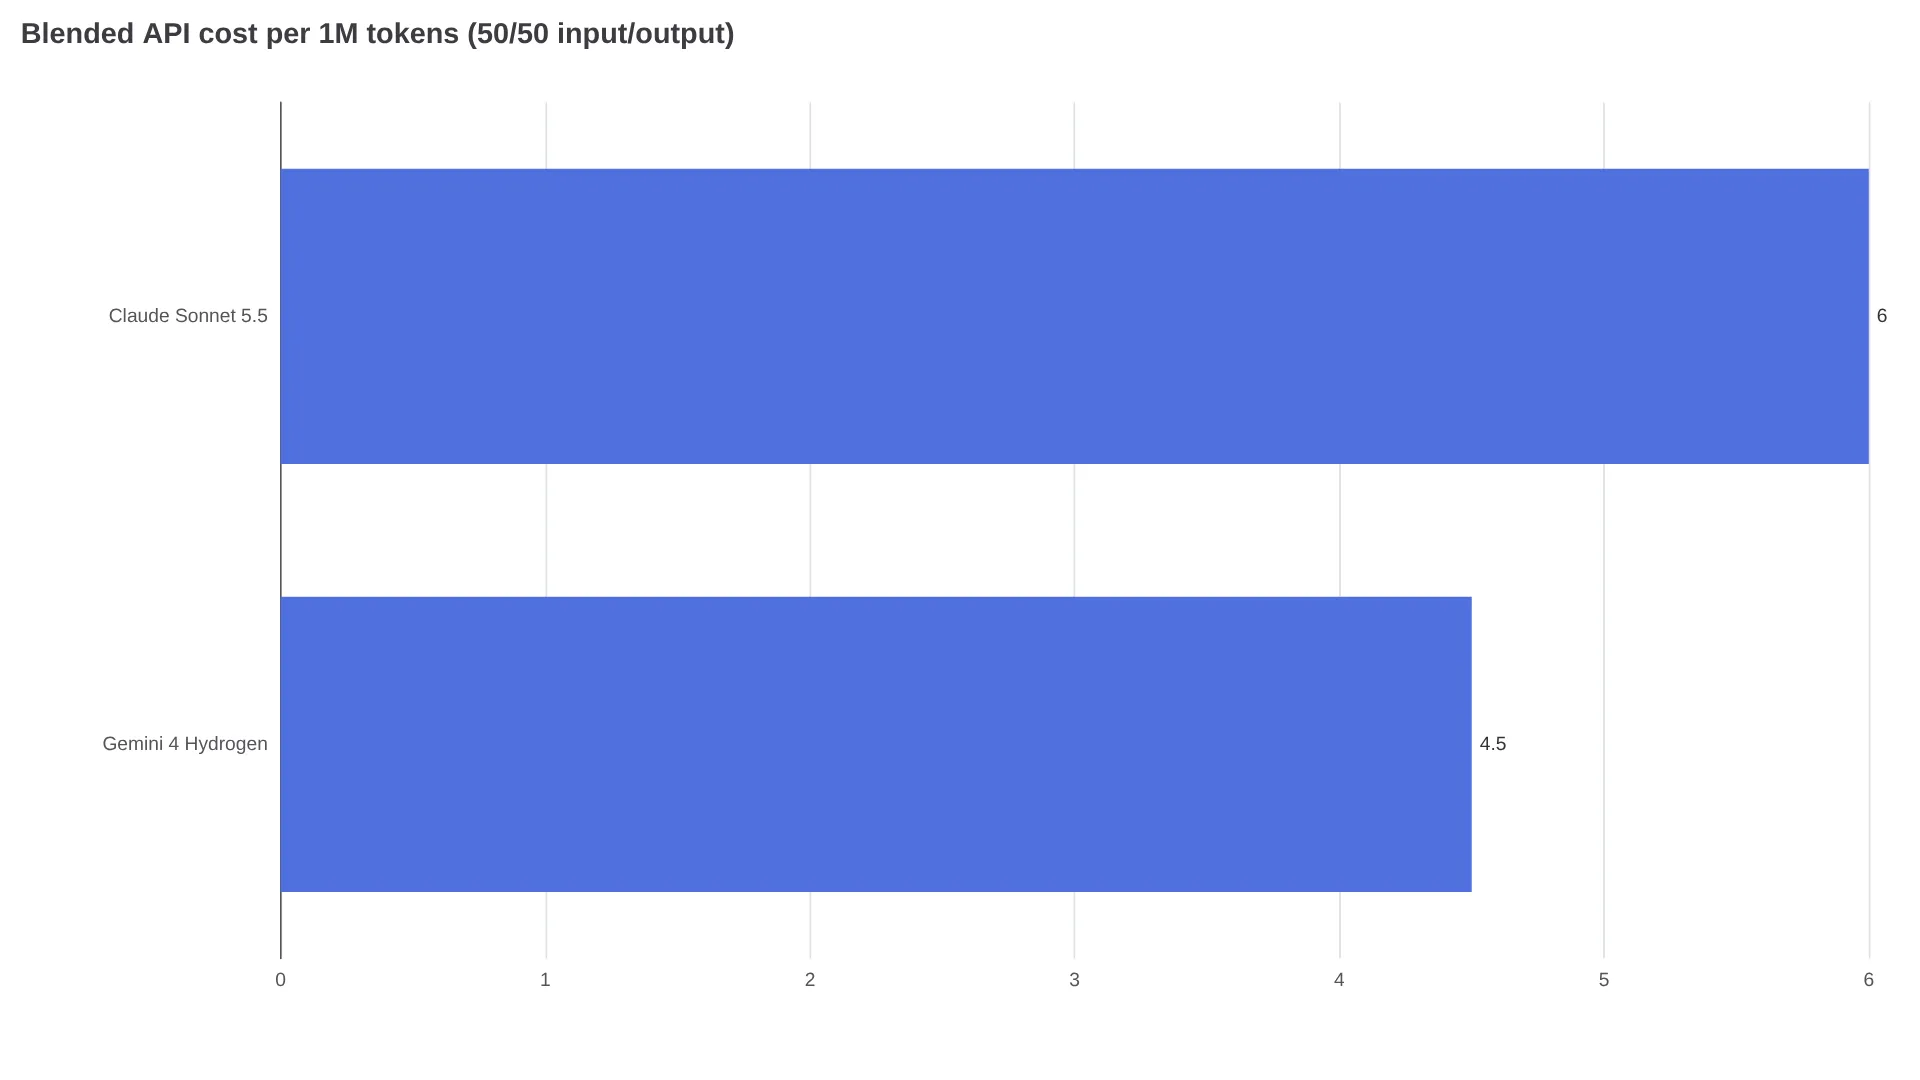
入力500Kトークンと出力500Kトークンを合わせる50/50の計算では、Hydrogenが1Mトークンあたり$4.50、Sonnet 5.5が$6.00です。この25%の差は確かにあります。ただし、最終的に差額を維持できるかは、次の3点で決まります。
- 出力の多いエージェントほど差が広がる。長い推論トレースを含むエージェントループは出力側に偏りやすく、Hydrogenの出力1Mトークンあたり$2.50の割引が効きます。
- キャッシュとバッチ料金は含めていない。Anthropicのプロンプトキャッシュ読み取りやBatch APIの割引によって、実際の請求額は数%動く可能性があります。LLM Leaderboardも、Hydrogenの速度サンプルでは明示的なキャッシュを利用できなかったと説明しています。
- 具体例で考えると差が見えやすい。1回のエージェントターンが平均で入力10Kトークン、出力3Kトークン、1日1,000ターンだとします。入力10Mトークンと出力3Mトークンになるため、定価ベースではHydrogenが約$37.50/日、Sonnet 5.5が$50.00/日です。22営業日で計算すると、リトライを除いて、同時稼働するエージェント1つあたり月に約$275の差になります。
本当の勝敗を決めるのはリトライです。タスク完了あたりのコストは、1回の試行にかかるトークン費用を成功率で割ったものに、人による修正時間を加えて考える必要があります。あくまで例ですが、Hydrogenの1日$37.50を初回成功率80%で運用すると、トークン費用だけで1,000件の完了タスクあたり約$46.90です。一方、Sonnet 5.5は1日$50.00、成功率95%なら約$52.60になります。成功率が違えば差はすぐ縮まるため、どちらのベンダーの表を信じるより、2週間にわたって初回マージ率を記録するほうが確実です。
ベンチマークは勝者ではなく、仕事の種類ごとに分かれる
Googleの発表時の比較表は、DeepMindのモデルカードにも掲載されており、10種類の評価でHydrogen、Sonnet 5.5、GPT-6.1 Terraを比較しています。Sonnet 5.5との比較では、Hydrogenが10項目中7項目でリードし、残り3項目はSonnet 5.5が上回りました。ベンダーによる項目は各社独自のハーネスを使用し、独立評価の項目はLLM Leaderboardによる再実行です。
| 仕事の種類 | ベンチマーク | Gemini 4 Hydrogen | Claude Sonnet 5.5 |
|---|---|---|---|
| リポジトリのコーディング | SWE-sweep(ベンダー) | 13.5% | 3.1% |
| リポジトリのコーディング | Terminal-Bench 4.1、チート調整済み(ベンダー) | 57.0% | 63.9% |
| ナレッジ自動化 | Agents' Last Exam v1.1(ベンダー、ハーネス依存) | 71.6% | 60.4% |
| ナレッジ自動化 | AutomationBench-AA(ベンダー) | 76.1% | 71.8% |
| ナレッジ自動化 | Vending-Bench 2 最終残高(ベンダー) | $14,549 | $11,165 |
| コンピューター操作 | OSWorld 2.1 オフラインサブセット(ベンダー) | 77.6% | 83.9% |
| マルチモーダル | MKA Climb WSR(ベンダー、独立評価は49.52%) | 53.4% | 52.0% |
| マルチモーダル | Chartography(出典混在) | 66.6% | 61.6% |
| 科学 | Terminal-Bench-Science 0.1(ベンダー、独立評価は49.52%) | 51.4% | 59.9% |
| 推論 | HLE-Diamond(独立、xhigh) | 58.8% | 53.3% |
エージェントの成否を分けるのはツール呼び出し
ベンチマークが採点するのは回答です。しかしエージェントの実力が出るのは、ツール呼び出しの部分です。読み取りをまとめて処理できるか、正しい関数を呼べるか、検索結果が空だったりコマンドが失敗したりしたときに復旧できるかが重要になります。
Googleによると、Hydrogenはファイルや検索結果を順番に確認するのではなく、並列にまとめて読み込みます。また、関係のないファイルを書き換えず、対象を絞ってリポジトリを修正します。発表記事に掲載されたパートナーの報告では、Gemini 3.8 Flashと比べてグラフ処理やSQL処理が2倍から2.8倍速く、トークン使用量も12%から23%少なかったとされています。デフォルトの高推論設定では、完了までの時間が2.5倍速くなったという報告もあります。ただし、いずれもベンダーが選んだパートナーの数値であり、保証値ではありません。
一方で、ハーネスの成熟度には注意が必要です。Claude CodeとAntigravityの比較スレッドでは、Antigravityの稼働率や、SSH、再利用可能なフック、スキル、サブエージェントといったワークフロー機能の不足を指摘する声が出ています。これはローンチ直後のユーザーの印象であり、統制された測定結果ではありません。また、問題になっているのはモデルの重みではなく、ハーネス側です。
本番エージェントを移行する前に、少なくとも3点を確認してください。利用中のMCPサーバー数で並列ツール呼び出しが安定するか、bashやブラウザ操作の失敗からどの程度復旧できるか、権限の境界をどう扱うかです。Googleの社内評価では、エージェントの過剰な行動が最大81%減り、サービス不足が79%減少し、エージェント誠実性の評価で96.7%の正直さを達成したとしています。ブロックされた操作や行き止まりの検索を含む50タスクのカナリアテストで、自分の環境でも確かめてください。
推論レベルはまずhigh。xhighは難しいタスクに絞る
Hydrogenにはlow、medium、high、xhighの4段階があり、デフォルトはhighです。Googleの推論レベル比較表では、Artificial Analysis Intelligence Index v5.0.1のスコアがlowからxhighにかけて27 / 41 / 51 / 54となっています。デフォルトのhigh(51)はArgon(50)をわずかに上回ります。Terminal-Bench 4.0では、同じ表でhighが54.0%、xhighが53.5%となり、highのほうが高い結果でした。一方、AutomationBench-AAは60.5%から76.1%、HLE-Diamondは32.2%から58.8%へと、設定を上げるほど伸びています。
エージェントループでは、まずhighから始めるのが基本です。分析、統合、複数文書の調査など、推論がボトルネックになるタスクだけをxhighに上げ、その際のトークン増加量を確認しましょう。DeepMindのモデルカードによると、Hydrogenは推論レベルを高くするほど多くのトークンを消費する可能性があります。また、知識カットオフは2026年3月なので、最新情報が必要な処理では、どちらにしても検索などの取得処理が必要です。
移行前に確認すべき、本当の問題はハーネス
DeepMindのモデルカードによると、Hydrogenは入力1,048,576トークン、同期出力64Kトークンのコンテキストを提供し、バックグラウンドの長時間デコードでは最大1Mトークンまで対応します。一方、Anthropicのドキュメントでは、Sonnet 5.5は入力1Mトークン、出力最大128Kトークンです。表面上のコンテキストサイズは近く見えますが、大規模コードベースではコンパクションの挙動が結果を左右します。仕様表の数字ではなく、50ターン後にどれだけの情報が残っているかを確認してください。
| Gemini 4 Hydrogen | Claude Sonnet 5.5 | |
|---|---|---|
| コンテキスト / 出力上限 | 入力1,048,576トークン、同期出力64K(バックグラウンドデコード1M) | 入力1,000,000トークン、出力128K |
| 利用できる環境 | Gemini API、AI Studio、Antigravity、Geminiアプリ(Googleによる) | Claude API、Bedrock、Vertex AI、Microsoft Foundry(Anthropicによる) |
AntigravityとClaude Codeの比較スレッドでは、モデルの品質以上に、ハーネスの安定性が移行時のリスクとして語られています。コンパクション後の情報保持、クォータの継続性、稼働率に対する疑問です。同じリポジトリ、同じコミット、同じプロンプト、同じ受け入れテストを両方のハーネスで実行し、サブスクリプション期間内に完了できたタスク数と初回マージ率を比べてください。
60秒で選ぶ、3種類のエージェント
すべてのエージェントに通用する勝者はいません。ここまでのベンチマークの分かれ方から判断すると(実測ではなく、編集部としての見解です)、並列で繰り返し処理する仕事はHydrogen、復旧性能や長時間の連続処理が重要な仕事はSonnet 5.5に振り分けるのが妥当です。プランナーと実行役を同じベンダーでそろえると、認証やコンパクションの挙動を統一できます。ClaudeのプランナーとHydrogenのワーカーを組み合わせる方法は、まず単一ベンダー構成の基準値を測ってから試すべきです。
| エージェントのタイプ | 選ぶモデル | 理由(根拠のレベル) |
|---|---|---|
| 大量処理の実行役:一括修正、定型コード、データ処理、マルチモーダルの振り分け | high設定のHydrogen | AutomationBench、Agents' Last Exam、Vending-Benchのベンダーベンチマークで優位。独立した速度サンプルでも約198対約144トークン/秒 |
| 長時間処理の完遂役:ターミナル中心のデバッグ、OS/ブラウザ自動化、科学系ツール | Sonnet 5.5 | Terminal-Bench 4.1、OSWorld 2.1、Terminal-Bench-Scienceのベンダーベンチマークで優位。Claude Codeのフックやサブエージェントに対するエコシステム面の評価 |
| 調査・統合役:長文書、グラフ、音声・動画、Sheets中心の分析 | high設定のHydrogen。最も難しい処理だけxhigh | HLE-Diamond、Chartography、MKAでベンダー評価が優位。ただし、MKAの独立再実行では49.52%と低い結果 |
Hydrogenは本当にSonnet 5.5より速いのか
LLM LeaderboardのサンプルではスループットはHydrogenが優位です(約198対144トークン/秒)。ただし、OpenRouterのリアルタイムp50フィードでは、レイテンシはSonnet 5.5が上回っています(中央値2.08秒対6.92秒)。プロバイダー、リージョン、負荷条件が異なるためです。最終的には、自分が使うプロバイダーで両方を測定してください。
Claude Code内のSonnet 5.5をHydrogenに置き換えられるか
モデルIDを差し替えるだけではできません。Sonnet 5.5はClaude Codeでネイティブに動作し、チームはフック、スキル、サブエージェントなどを利用しています。一方、HydrogenはGemini API、AI Studio、Antigravity、Geminiアプリを通じて動作します。置き換えるには、ハーネスそのものの移行が必要です。