 AIREITER
Hyra 2.0 di Tencent non punta a dare una risposta e archiviare il lavoro fatto. È un sistema di agenti per la ricerca che costruisce modelli scientifici, strumenti e workflow riutilizzabili. Il limite principale è nella disponibilità: l'agente resta interno a Tencent, mentre solo una parte dei risultati è pubblica.
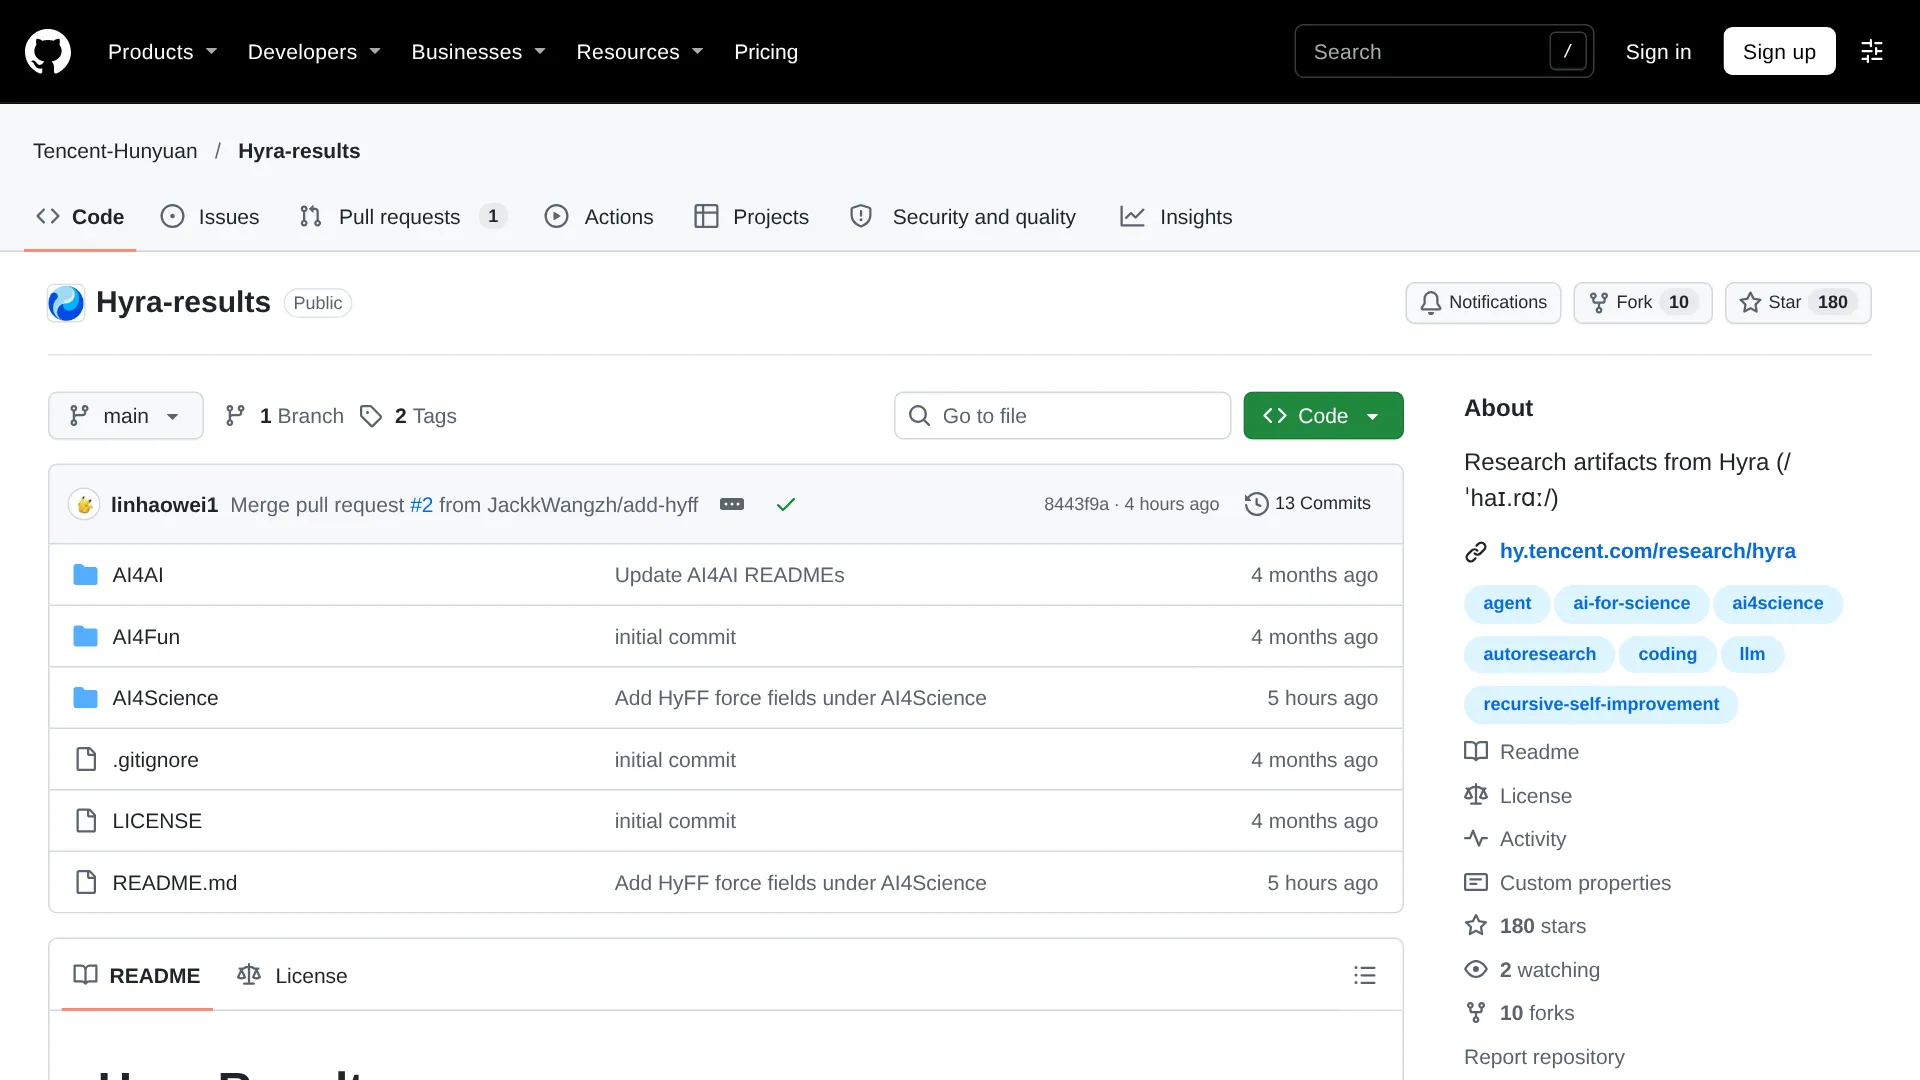
Il repository Hyra-results distingue chiaramente gli artefatti scaricabili dalle affermazioni presenti solo negli annunci. È una separazione che guida tutta questa analisi.
Hyra 2.0: cos'è davvero e cosa non è
Hyra 2.0, abbreviazione di Hunyuan Research Agent 2.0, è il sistema gerarchico di Tencent Hunyuan per automatizzare ricerca scientifica e ingegneria. Tencent lo presenta come un'infrastruttura capace di sviluppare modelli scientifici riutilizzabili, pipeline di validazione e workflow articolati, non come l'ennesimo modello conversazionale Hunyuan per uso generale.
Nell'annuncio ufficiale su X del 2 novembre 2026, Tencent definisce Hyra 2.0 «la prossima evoluzione di Hunyuan Research Agent», orientata al passaggio «dalla risoluzione dei problemi alla costruzione di strumenti, modelli e workflow riutilizzabili». Il repository pubblico Hyra-results raccoglie risultati e modelli addestrati selezionati, non l'intero sistema di orchestrazione; né l'annuncio né il repository indicano una demo pubblica, un pacchetto installabile, un'API, prezzi o quote. Si può pensare a Hyra 2.0 come al laboratorio, mentre i modelli proteici HyInv e HyPLM-Flash rilasciati sono alcuni dei campioni usciti da quel laboratorio.
Come Hyra 2.0 porta avanti progetti di ricerca per settimane
Per sostenere ricerche di lunga durata, Hyra 2.0 usa tre livelli di agenti, storage persistente e una fase di revisione indipendente. Il resoconto del lancio di IT之家, che cita l'account WeChat ufficiale di Tencent Hunyuan, descrive la divisione Overall, Mission e Worker progettata per mantenere in corso gli esperimenti per giorni o settimane senza perdere il contesto.
Gli agenti Overall dialogano con i ricercatori umani, allineano gli obiettivi e assegnano i budget di calcolo. Gli agenti Mission gestiscono ciascuno una direzione di ricerca, scelgono i percorsi sperimentali e rispondono delle conclusioni. Gli agenti Worker leggono il codice, eseguono esperimenti reali, analizzano gli errori e possono contestare il giudizio di un agente Mission; più Worker possono operare in parallelo su modelli di base diversi.
Alla base ci sono tre meccanismi di persistenza:
- Stato del progetto registra il punto raggiunto da un programma di ricerca, così le attività resistono alle interruzioni nelle code persistenti.
- Memoria stratificata degli agenti separa le osservazioni di breve durata dalle evidenze a più lungo termine, invece di riversare tutto in un'unica finestra di contesto.
- Books condivisi archiviano conoscenze classificate per grado di evidenza — osservazioni da una sola esecuzione, risultati riprodotti e convenzioni confermate da umani — mentre i metodi dimostrati trasferibili vengono estratti come piccole skill riutilizzabili nelle esecuzioni successive.
Il progetto aggiunge due ulteriori protezioni. Ogni conclusione viene accompagnata da log concreti e versioni del codice, mentre un Worker separato riesamina l'affermazione partendo da zero prima che arrivi alle persone. I lavori di calcolo più grandi richiedono comunque l'approvazione umana e il sistema si collega alle normali infrastrutture di laboratorio, incluse messaggistica aziendale, piattaforme di invio job e repository di codice, secondo l'analisi tecnica di Eyerys.
Questa verifica ha un costo. Secondo la stima di un professionista, i Worker che ispezionano le sessioni degli altri potrebbero far salire sensibilmente il costo in token (@d6355v). Tencent non ha pubblicato budget di token, costi di calcolo, tassi di errore o dati sulla frequenza con cui la revisione indipendente intercetta problemi: per ora, quindi, va considerata un'architettura pensata per l'affidabilità su orizzonti lunghi, con costi operativi non divulgati.
Cosa ha rilasciato concretamente Hyra 2.0
Le evidenze pubbliche su Hyra 2.0 rientrano in due categorie: artefatti scaricabili con pesi e codice, e risultati comunicati da Tencent che attendono ancora una riproduzione esterna. La tabella collega ogni voce alla relativa fonte verificabile.
| Artefatto | Cos'è | Dato principale | Stato dell'evidenza |
|---|---|---|---|
| HyInv | Modello di inverse folding proteico da 1,96M parametri, pesi da 7,8 MB, CLI + API Python | Generazione ~57x più veloce di ProteinMPNN; 25 ms contro ~1 s su proteine da 148 residui (1x GPU H20), secondo la recensione di TSN | Artefatto ispezionabile (MIT); benchmark eseguibile; risultato principale non ancora riprodotto in modo indipendente |
| HyPLM-Flash | Modello linguistico proteico mascherato da 650M parametri, pesi da 2,6 GB, motore INT8 | ~130.000 residui/sec su 1x H20; inferenza più veloce nel test Tencent su 12 modelli/35 task, rango medio 3°; Spearman ProteinGym 0,409, a pari livello della classe ESM-2 650M, secondo la recensione di TSN | Artefatto ispezionabile (MIT); richiede GPU CUDA; le due valutazioni coprono numeri diversi di modelli e task |
| HyFF | 5 campi di forza ML (Presto, Vivace, Moderato, Andante, Largo), da 2,3M a 1,2B parametri, 83 elementi | Errore energetico di Largo pari a 0,364 meV/atomo contro 0,380 di DPA4-Pro, a 9,7x la velocità; Andante raggiunge 29x la velocità di UMA-S-1.2 su MD da 2.586 atomi, 1x H20 | Artefatto ispezionabile (Apache-2.0) con pacchetto hyff; le velocità si riferiscono a un singolo carico di lavoro su H20 |
| Congettura di Petty dim-5 | Artefatto di prova: ogni spazio normato reale 5-D contiene 6 punti equidistanti (miglior risultato precedente: dim 4, Makeev 2005), secondo l'indice del repository | Risolve il caso della dimensione 5 | Paper ispezionabile; nessuna peer review su rivista riportata |
| Azione circolare di Yau | Controesempio dichiarato: varietà chiusa 7-dimensionale, curvatura sezionale positiva, nessuna azione circolare efficace, secondo l'indice del repository | Risolve il caso senza restrizioni; il caso semplicemente connesso resta aperto | Paper ispezionabile; nessuna peer review su rivista riportata |
| HyQEC | Codice di correzione degli errori quantistici derivato dal filone qLDPC Challenge, secondo Prompt Blueprints | Efficienza di codifica ~48% superiore al precedente leader | Annunciato; artefatto completo in attesa su GitHub |
| XiangShan RISC-V | Ottimizzazione di processore open source, secondo Prompt Blueprints | +5,79% di punteggio per GHz, incremento d'area minimo; corretti bug multi-core | Annunciato; nome del benchmark e baseline non divulgati |
| Mano robotica | Mano a cinque dita con lunghezze delle dita graduate, secondo Eyerys | +28,6% nella velocità di rotazione degli oggetti in simulazione a budget fisso | Annunciato; finora solo in simulazione |
Rispetto a Hyra 1.0, il cambio di approccio è netto: dalle risposte agli asset. Hyra 1.0 ha dimostrato che il ciclo poteva funzionare: la sua voce sums_diffs ha migliorato una costante di combinatoria da 1,14489 a 1,21079, e Tencent le attribuisce progressi su un problema di combinatoria additiva aperto da 50 anni. L'analisi del lancio di Prompt Blueprints rileva che Hyra 2.0 conserva quel motore iterativo, ma aggiunge gerarchia, progetti persistenti ed estrazione di skill per rendere riutilizzabile ogni successo.
Cosa si può usare oggi e cosa resta dentro Tencent
I prodotti di Hyra 2.0 si possono eseguire, ma l'orchestratore non dispone di un'installazione pubblica. Il repository Hyra-results usa licenza Apache-2.0 e ogni cartella dei risultati punta a includere gli artefatti finali insieme agli script di riproduzione. Il punto di partenza è questo:
git clone https://github.com/Tencent-Hunyuan/Hyra-results.git
ls AI4Science/hyinv
Poi si può scegliere uno di questi percorsi:
- HyInv (il più semplice da avviare): aprire
AI4Science/hyinvper pesi, codice di inferenza e report tecnico. Il percorso di riferimento gira su CPU e GPU; il percorso BF16 accelerato è validato solo su GPU di classe Hopper. - HyPLM-Flash (richiede CUDA): aprire
AI4Science/hyplm_flash, quindi eseguireweights/download.shper scaricare, unire e verificare i pesi da 2,6 GB. Serve una GPU di classe H20/H100; INT8 va usato per l'estrazione delle rappresentazioni e BF16 per la regressione delle varianti a grana fine. - HyFF (per le velocità dichiarate serve una H20): usare la sezione HyFF per i cinque modelli di campo di forza, da 9 MB a 4,8 GB ciascuno, e il pacchetto
hyff, che supporta dinamica molecolare a struttura singola, in batch e NVE/NVT/NPT.
Resta chiuso l'orchestratore Overall/Mission/Worker, insieme a prompt, scheduler, valutatori e archivio Books/skill. Le soglie di approvazione umana per i job di calcolo più grandi indicano inoltre che il sistema non è pienamente autonomo nell'allocazione delle risorse. In sintesi: non c'è un agente da installare; l'artefatto più immediato da provare richiede un download di 7,8 MB e, come osserva TSN, impostare un confronto diretto tra HyInv e ProteinMPNN su backbone identici è poco costoso.
I numeri principali reggono alla verifica?
TSN ha riportato che tutte le metriche prestazionali provengono da Tencent o dalla documentazione dei suoi modelli e che, al 2 novembre 2026, non risultava pubblicata alcuna riproduzione indipendente. Ogni numero va quindi letto insieme al suo denominatore.
Primo: velocità non significa qualità. Il 57x di HyInv confronta il throughput di generazione su una Nvidia H20 — circa 25 ms contro circa 1 s su 148 residui, 54 ms contro 2,6 s su 402 residui — e non il successo in laboratorio. La somiglianza strutturale viene valutata rispetto a strutture predette, e non è riportata alcuna validazione wet-lab:
57x rispetto a ProteinMPNN e ~2.500 design/sec indicano throughput, non qualità del design. Quello che vorrei vedere dopo: RMSD di autoconsistenza e recupero della sequenza... L'inverse folding raramente è il collo di bottiglia; di solito lo è il passaggio di refolding successivo.
Secondo: le dichiarazioni di efficienza richiedono hardware e perimetro. Il «più veloce tra 12» di HyPLM-Flash descrive la valutazione Tencent su blog con 12 modelli e 35 task; la valutazione comparabile nel repository copre invece 28 checkpoint e 32 task, con Spearman zero-shot su ProteinGym di 0,409, statisticamente alla pari con ESM-2 650M, ESM C 600M ed E1-600M. Le velocità 29x e 9,7x di HyFF sono legate a un sistema da 2.586 atomi su una H20, mentre l'errore sulle forze di Andante, 7,65 meV/Å, è leggermente peggiore di quello di UMA-S-1.2, 7,55 meV/Å: più velocità a precisione quasi equivalente, non un dominio totale.
Terzo: il riuso, che è l'intera tesi della versione 2.0, deve ancora essere dimostrato. I materiali di lancio non spiegano come una skill generata venga validata prima del riuso, chi la approvi o se il riuso sia stato misurato tra progetti:
Costruire strumenti riutilizzabili invece di risposte una tantum è la direzione giusta. La maggior parte delle esecuzioni degli agenti butta via tutto ciò che ha imparato quando il task termina. Sono curioso di capire come Hyra stabilisca che uno strumento è abbastanza valido da essere conservato e riutilizzato.
Un secondo professionista ha posto la stessa domanda sulla validazione dal punto di vista human-in-the-loop (@ModelPlaneHQ). Nei materiali di lancio Tencent e nelle recensioni di terze parti linkate sopra non compare alcun benchmark diretto contro concorrenti come AI Co-Scientist di Google o Sakana AI Scientist; oggi, quindi, qualsiasi classifica si baserebbe sui numeri forniti da Tencent. Davanti a un modello costruito da agenti, conviene invece porre quattro domande: su quale hardware, con quale impostazione di qualità, riprodotto da chi e riutilizzato dove?
FAQ
Hyra 2.0 è open source e si può provare?
Il framework è chiuso, gli artefatti sono aperti. Non esistono demo pubbliche, API o installazioni dell'agente. HyInv e HyPLM-Flash usano pacchetti di modelli con licenza MIT, mentre HyFF ricade nei termini Apache-2.0 del repository; è bene controllare README e licenza di ogni cartella.
In cosa Hyra 2.0 differisce da Hyra 1.0?
Hyra 1.0 era focalizzato sulla risoluzione iterativa dei problemi, incluso un risultato di combinatoria rimasto aperto a lungo. Hyra 2.0 introduce la gerarchia Overall/Mission/Worker, stato persistente dei progetti, conoscenza nei Books, estrazione delle skill e l'obiettivo esplicito di produrre modelli e workflow riutilizzabili.
I risultati matematici hanno ricevuto peer review?
Non come pubblicazioni su rivista. I paper sulla dimensione 5 di Petty e sul controesempio di Yau sono pubblici e ispezionabili; inoltre, l'indice del repository registra formalizzazioni Lean 4 per tre precedenti risultati a nucleo finito: Beurling-Ahlfors, Hadamard parziale e commutatore. Tutti vanno considerati affermazioni in attesa di revisione da parte di esperti.
Quale hardware serve per riprodurre i modelli proteici?
Il percorso di riferimento di HyInv funziona su CPU e GPU, con un download da 7,8 MB. HyPLM-Flash richiede una GPU CUDA, con una H20/H100 consigliata, per il suo motore INT8 da 2,6 GB; le prestazioni di HyFF presuppongono invece una H20.
Come valutare Hyra 2.0 senza sovrastimarne i risultati
Hyra 2.0 scommette sull'idea che l'unità del progresso scientifico debba essere lo strumento, non la risposta: skill riutilizzabili che si accumulano in quella che Tencent descrive come una rendita composta dell'intelligenza (智能复利). Il lancio mostra modelli e strumenti attribuiti al sistema; resta però da misurare se questi strumenti accelerino davvero e ripetutamente la ricerca successiva. Serviranno tasso di riuso, costo della validazione e riproduzioni indipendenti, affiancati ai record di velocità.