 AIREITER
Lanciato il 5 agosto 2026, SeedRealtime di ByteDance è un LLM nativo audio-visivo full-duplex. Il punto non è semplicemente la voce in tempo reale, ormai proposta da diversi sistemi: qui audio e video vengono elaborati insieme da un solo modello end-to-end, senza un modulo esterno incaricato di stabilire chi debba parlare. Per gli sviluppatori c'è però un limite importante: al lancio non esistono API pubbliche né prezzi, e il modello è integrato nei prodotti di ByteDance.
Cos'è SeedRealtime e dove si colloca
Sviluppato dal team Seed di ByteDance, riunisce audio, video e testo in un'unica architettura. Anziché passare i dati attraverso una sequenza di stadi distinti, percepisce, comprende, decide e risponde su flussi multimodali continui.
ByteDance lo sintetizza con l'idea di «guardare, ascoltare e parlare contemporaneamente»: ogni risposta nasce dall'interpretazione congiunta di ciò che il sistema sente e vede in tempo reale. SeedRealtime fa parte della gamma di modelli Seed, insieme a Seed2.1, la famiglia LLM che alimenta Doubao, Seedance per la generazione video, Seedream per le immagini, Seed Audio 1.0 per l'audio e Seed GR-RL per la robotica.
Non rientra nelle categorie tradizionali: non è un modello TTS, perché oltre a generare voce la comprende; non è un modello di visione, perché usa ciò che vede al servizio della conversazione; e non è soltanto un altro assistente vocale in tempo reale.
Perché il full-duplex è l'elemento decisivo
Per full-duplex si intende la capacità di ascoltare e rispondere nello stesso momento, modellando continuamente chi sta parlando e quando sia opportuno intervenire, come accade in una conversazione reale. Secondo ByteDance, SeedRealtime ci riesce integrando suono, visione, tempi espressivi e risposta in un singolo modello end-to-end, invece di assemblare moduli separati.
L'interazione AI in tempo reale si è finora mossa tra due approcci. I sistemi a cascata collegano ASR, cioè speech-to-text, a un LLM o VLM e quindi al TTS; sono modulari e più facili da analizzare, ma ogni passaggio introduce latenza e perdita di informazioni. Tono, sovrapposizioni vocali, accento e contesto visivo tendono inoltre a scomparire già nella fase ASR. I modelli vocali end-to-end eliminano questi passaggi e risultano più naturali, ma nella maggior parte dei casi si affidano ancora a un voice-activity detector esterno, il VAD, per stabilire i turni: di fatto restano half-duplex, una domanda e una risposta alla volta.
SeedRealtime concentra percezione, comprensione, decisione ed espressione in un unico modello, eseguendole in parallelo su flussi audio-visivi continui e senza un VAD esterno che decida i turni di parola.
| Approccio | Come funziona | Duplex | Gestione dei turni | Limite principale |
|---|---|---|---|---|
| A cascata (ASR + LLM/VLM + TTS) | Moduli concatenati in sequenza | Half | Endpointing fisso | Latenza e perdita di informazioni a ogni passaggio |
| End-to-end + VAD esterno | Un solo modello con rilevatore di turni esterno | Half | VAD esterno | Resta un modello domanda-risposta |
| SeedRealtime | Modello end-to-end audio-visivo unificato | Full (dichiarato) | Interna e multimodale | È il più recente; le capacità sono descritte dal fornitore |
La difficoltà sta nel fatto che il video, a differenza del parlato, non presenta pause naturali. Il modello deve scegliere di continuo quale oggetto seguire, quale voce sia rilevante e se sia il momento di intervenire, senza reagire al rumore di fondo.
Le tre capacità mostrate da ByteDance
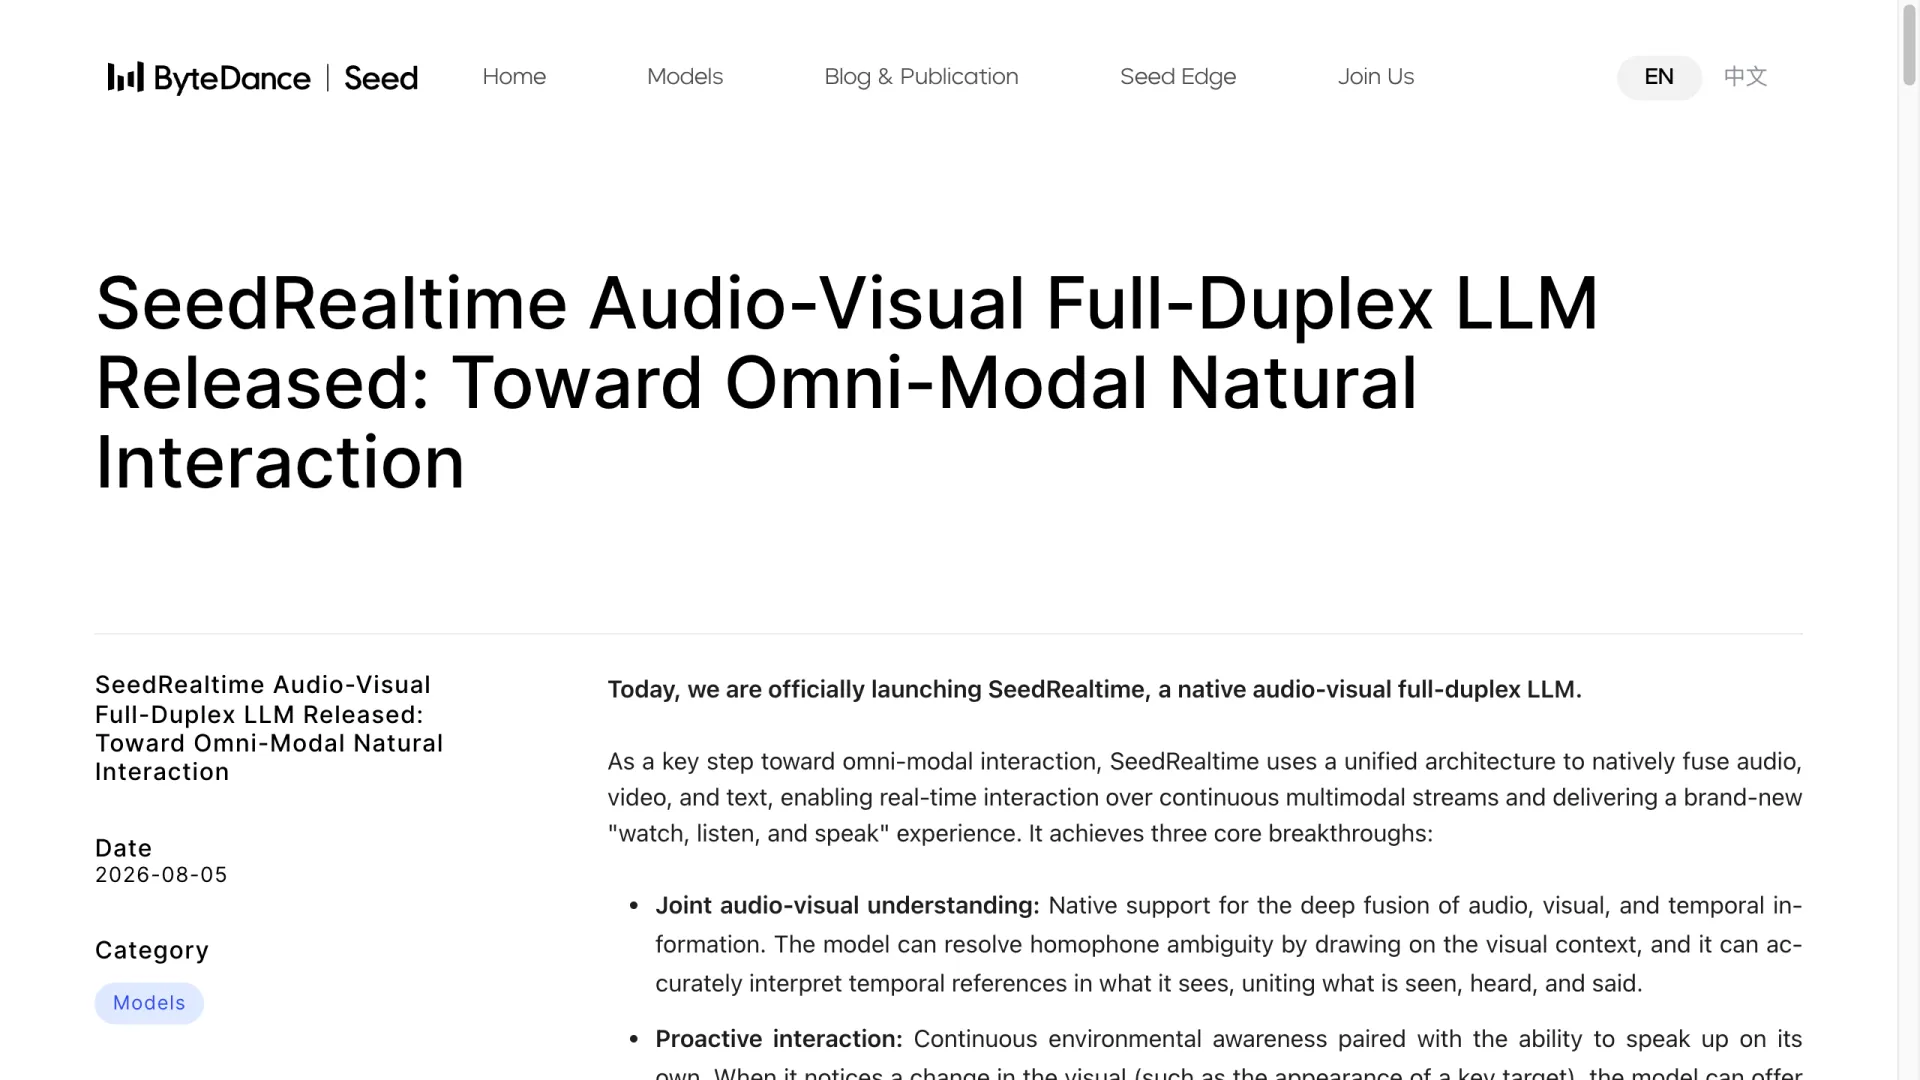
ByteDance organizza il comportamento di SeedRealtime in tre aree: comprensione audio-visiva congiunta, interazione proattiva e gestione naturale dei tempi conversazionali. Per illustrarle usa scenari concreti, non tabelle di benchmark.
Comprensione congiunta di audio e video
Il modello usa la scena inquadrata per risolvere le ambiguità nel parlato. Se qualcuno chiede «come faccio a fare questo?», SeedRealtime combina schermata, gesti, direzione dello sguardo e azioni precedenti per capire a cosa si riferisca quel «questo».
In una demo di ByteDance, un utente presenta a cena quattro amici, uno alla volta. SeedRealtime associa i nomi ai volti e continua poi a collegare ogni voce alla rispettiva identità mentre il gruppo organizza un viaggio tra preferenze contrastanti: uno vuole il mare, uno non sopporta il caldo e uno è allergico ai frutti di mare. In un ristorante del Sichuan legge con la fotocamera un menu solo in cinese, consiglia piatti in inglese e spiega perché il «fish-fragrant pork» non contiene pesce.
Interazione proattiva
Quando cambia la scena, il modello può intervenire senza attendere una domanda. Durante una visita al museo, un utente dice: «ricordamelo quando vedi il supporto di bronzo con una tigre che divora un cervo». SeedRealtime segue il feed della fotocamera finché non compare il reperto, quindi fornisce il promemoria e un contesto sull'opera.
Vedendo qualcuno versare chicchi di caffè interi direttamente nel portafiltro, interviene suggerendo di macinarli prima fino a ottenere una polvere fine. Dopo l'estrazione, in base al colore della crema, propone di accorciare la successiva estrazione di due o tre secondi. Chiamate a strumenti, come ricerche e prenotazioni, vengono integrate nelle risposte anziché gestite in un passaggio separato.
Tempi di conversazione più naturali
SeedRealtime sceglie quando parlare, fare una pausa o restare in silenzio usando il contesto multimodale, e cerca di evitare attivazioni errate. In un affollato aeroporto di Pechino ignora il riferimento casuale di un accompagnatore al «volo del vecchio Li», ma se interrogato recupera informazioni sul tabellone partenze già scomparse dallo schermo, poi cerca online il nastro di riconsegna bagagli. A casa, con un genitore impegnato in una telefonata sullo sfondo, resta concentrato sulla correzione della pronuncia inglese di un bambino.
Nella sua valutazione umana end-to-end, ByteDance riferisce che SeedRealtime dimezza circa i problemi di ritmo nelle conversazioni audio-visive rispetto ai modelli a cascata: meno interruzioni a metà frase, meno risposte lente dopo le pause e meno falsi trigger dovuti al rumore, oltre a una percentuale più alta di turni completati in modo fluido e completo. Si tratta di valutazioni eseguite dal fornitore, non di benchmark indipendenti.
SeedRealtime a confronto con GPT-4o Realtime, Gemini Live e stack a cascata
La domanda pratica è in cosa SeedRealtime differisca dai sistemi in tempo reale già accessibili agli sviluppatori. La risposta più corretta è che la maggior parte delle API «realtime» esistenti ruota attorno all'audio, mentre l'elemento distintivo dichiarato da SeedRealtime è l'elaborazione congiunta di audio e video in full-duplex.
La Realtime API di OpenAI e Gemini Live di Google, funzione consumer con la relativa Live API per sviluppatori, offrono conversazioni a bassa latenza in tempo reale, ma sono incentrate sull'audio, con parlato in ingresso e in uscita. La visione viene gestita separatamente e l'alternanza dei turni dipende ancora da endpointing o VAD. Il posizionamento di SeedRealtime è dato dalla combinazione di fusione nativa audio-visiva, tempi full-duplex decisi all'interno del modello, interventi proattivi e uso degli strumenti integrato nella conversazione.
| Modello | Modalità native | Duplex | Gestione dei turni | Proattività / uso strumenti | API pubblica |
|---|---|---|---|---|---|
| SeedRealtime | Audio + video + testo (integrati) | Full (dichiarato) | Interna e multimodale | Sì, integrato | No (al lancio) |
| GPT-4o Realtime API | Audio + testo | Tempo reale, gestito da VAD | Endpointing esterno | Tramite function tools | Sì |
| Gemini Live / Live API | Audio + testo (fotocamera nell'app consumer) | Tempo reale, gestito da VAD | Endpointing esterno | Limitato | Sì (Live API, audio) |
| Stack a cascata | Testo (audio tramite ASR/TTS) | Half | Fissa | Personalizzabile | Da costruire |
I vantaggi attribuiti a SeedRealtime derivano dalle demo e dalle valutazioni di ByteDance; non è stato pubblicato alcun confronto diretto con GPT-4o realtime o Gemini Live. La tabella va quindi letta come posizionamento architetturale, non come prova di una superiorità misurata.
SeedRealtime è già utilizzabile dagli sviluppatori?
Al lancio del 5 agosto 2026, SeedRealtime non è disponibile tramite API per sviluppatori. ByteDance afferma che è «fully rolled out», ma si riferisce alla distribuzione nei prodotti dell'azienda, non a un endpoint aperto e accessibile a chiunque.
Al lancio non sono disponibili API pubbliche, una pagina prezzi o documentazione per sviluppatori. Il ramo commerciale delle API di ByteDance è Volcengine (火山引擎), che ospita la famiglia Doubao: gli LLM Seed 2.1 Pro e Turbo, Seed-ASR, Seed-TTS e altri modelli. SeedRealtime non compare nell'elenco al lancio, e i relay di terze parti non offrono un'alternativa audio-visiva in tempo reale.
Per i team che oggi hanno bisogno di un endpoint realtime, le opzioni concrete nel breve periodo restano incentrate sull'audio: la Realtime API di OpenAI, la Live API di Google oppure uno stack a cascata sviluppato internamente. SeedRealtime resta invece un'architettura da osservare. ByteDance non ha indicato una data per un'API realtime su Volcengine o BytePlus.
FAQ
SeedRealtime è disponibile al pubblico?
Dal lancio del 5 agosto 2026 è distribuito nei prodotti di ByteDance, ma non esiste un'app pubblica o un endpoint chiamato SeedRealtime a cui sia possibile registrarsi.
SeedRealtime ha un'API?
Non al lancio. ByteDance non ha rilasciato accesso API, prezzi o documentazione per sviluppatori; una futura collocazione plausibile è la famiglia di API Doubao su Volcengine, che però non elenca ancora SeedRealtime.
In cosa SeedRealtime è diverso da GPT-4o realtime?
La Realtime API di GPT-4o è incentrata sull'audio: parlato in ingresso e parlato in uscita. SeedRealtime dichiara invece di elaborare congiuntamente audio e video in un unico modello full-duplex, che decide autonomamente anche i propri tempi e interviene in modo proattivo. Non esiste ancora un confronto indipendente diretto.
SeedRealtime è gratuito?
Al lancio non esiste un prodotto autonomo o un'API con un prezzo, quindi la distinzione tra gratuito e a pagamento non si applica ancora: è una capacità integrata nei prodotti di ByteDance.
Cosa significa «full-duplex» per un modello AI?
Significa che il modello può ascoltare e rispondere contemporaneamente, modellando in modo continuo lo stato della conversazione e decidendo autonomamente quando parlare o fare una pausa, senza limitarsi a turni rigidi di domanda e risposta.
Letture correlate
- Prezzi della OpenAI Realtime API — l'endpoint audio in tempo reale che gli sviluppatori possono già chiamare oggi
- Qwen Audio 3 Realtime — un altro modello vocale in tempo reale da confrontare