 AIREITER
Agosto 2026 ha cambiato i termini del confronto fra Qwen 3.8 e Kimi K3. Ora che i pesi di entrambe le famiglie sono scaricabili e i rispettivi modelli di punta sono disponibili in generale, la scelta dipende soprattutto dallo scenario di deployment: Kimi K3 conserva il miglior curriculum verificato nel coding agentico, Qwen 3.8 Max è più conveniente per token e il Qwen 27B con licenza Apache-2.0 funziona su una singola GPU consumer. C'è però un distinguo importante: il flagship “open” di Kimi è un checkpoint riportato da 1,56 TB. Avere pesi aperti non equivale automaticamente a poter fare self-hosting in modo pratico.
Cosa hanno rilasciato davvero Qwen 3.8 e Kimi K3
Kimi K3 (Moonshot AI) è arrivato il 16 luglio 2026 come unico modello di punta: un MoE da 2,8 trilioni di parametri, con 104B attivi per token, Kimi Delta Attention e Gated MLA, finestra di contesto da 1.048.576 token e supporto nativo alla visione. I pesi e il report tecnico sono seguiti il 27 luglio sotto la licenza proprietaria Kimi K3 License: le condizioni riassunte nel confronto di Emergent impongono vincoli ai rivenditori commerciali su larga scala e ai prodotti con oltre 100 milioni di utenti mensili.
Alibaba ha risposto con una famiglia di modelli, non con un solo modello. Qwen 3.8 Max è stato presentato in anteprima il 19 luglio, è entrato in disponibilità generale su QwenCloud il 3 agosto con 2,4T parametri totali e circa 95B attivi, mentre i pesi sono comparsi su Hugging Face intorno al 12 agosto come Qwen/Qwen3.8-2.4T-A95B, con licenza proprietaria qwen3.8-max. Pochi giorni dopo è arrivato Qwen/Qwen3.8-27B: un modello vision-language denso da 27B, rilasciato sotto Apache-2.0, con contesto nativo da 262K ed estendibile a 1M tramite YaRN (datato 13–14 agosto da Yotta Labs).
| Kimi K3 | Qwen 3.8 Max | Qwen3.8-27B | |
|---|---|---|---|
| Parametri totali / attivi | 2.8T / 104B | 2.4T / ~95B | 27B denso |
| Contesto | 1.048.576 | 1M (input massimo 991,8K) | 262K nativo, 1M via YaRN |
| Licenza | Kimi K3 License (proprietaria) | Licenza proprietaria qwen3.8-max | Apache-2.0 |
| Pesi disponibili dal | 27 luglio 2026 | ~12 agosto 2026 | ~13–14 agosto 2026 |
| Input visivo | Testo + immagini (formalmente) | Testo, immagini, video via API | Testo, immagini, video |
Moonshot avrebbe inoltre sospeso le nuove sottoscrizioni consumer entro 48 ore dal lancio di K3, perché la domanda aveva superato la capacità GPU. Un dettaglio da tenere presente prima di basare un prodotto su un unico provider.
Benchmark: chi ha misurato cosa
Entrambi i vendor pubblicano tabelle di benchmark imponenti, ma usano harness diversi. La model card di Kimi avverte che i punteggi dei concorrenti provengono da agent harness differenti e, in alcune righe, da hardware H20 anziché H100. I risultati condivisi qui sotto vanno quindi letti come dati dichiarati dai vendor, non come valori sottoposti ad audit.
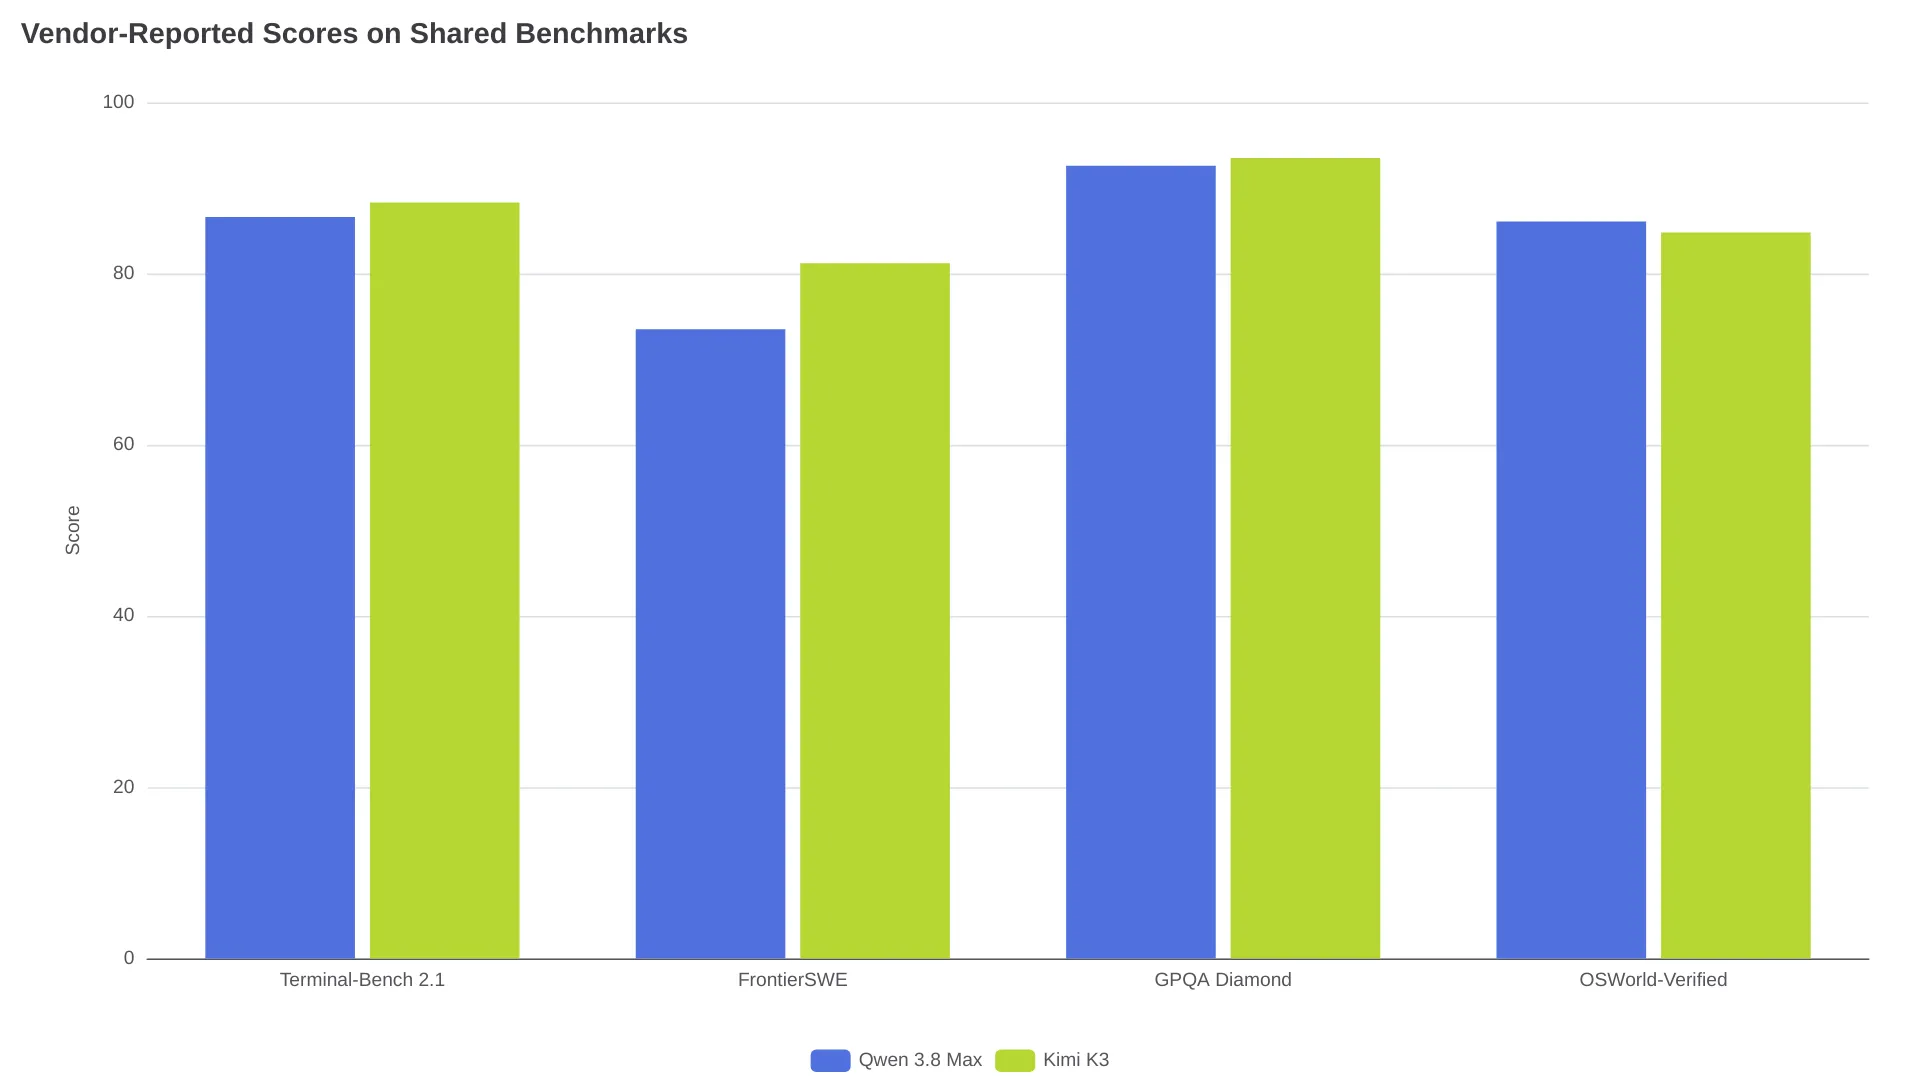
Nelle righe condivise, Kimi K3 è avanti negli ambiti che contano per il coding agentico: secondo la sua model card, FrontierSWE 81.2 contro 73.5 e Terminal-Bench 2.1 a 88.3 contro 86.6 (sul lato Qwen: la model card del modello 2.4T). I materiali di lancio Qwen indicano OSWorld-Verified a 86.1 contro l'84.8 riportato nella card di K3, mentre la card Qwen presenta alcuni picchi su singola riga — PaperBench 93.0, IFBench 82.8, SWE-bench Pro 67.7. K3, dal canto suo, dichiara SWE-Marathon 42.0, BrowseComp 91.2 e MCPMark-Verified 94.5 in test che Qwen non riporta.
Per ora, il quadro indipendente è sbilanciato. Il monitoraggio di Emergent attribuisce a Kimi K3 un Artificial Analysis Intelligence Index di 57 al lancio e di 60 nella versione attuale dell'indice, dietro Claude Fable 5 e GPT-5.6 Sol; il confronto di Orcarouter aggiunge un primo posto in Frontend Code Arena con 1.679 Elo. Qwen 3.8 Max non era stato indicizzato in modo indipendente al lancio; il tracker di cheapestinference.com riportava 53 come valore dell'indice Artificial Analysis, mentre i post della community che parlano di un aggiornamento a 56 restano non verificati.
L'unico confronto diretto sullo stesso task, l'analisi architetturale StackPerf di TrilogyAI (documentata da Orcarouter), ha assegnato 83/100 a K3 e 80/100 a Qwen sull'endpoint preview. Qwen ha registrato 354 citazioni del repository contro le 274 di Kimi, 22 richieste gateway contro 53 e nessuna tool call fallita, contro le due di Kimi.
C'è poi la riga che le tabelle condivise non mostrano: nella model card di Qwen, il 27B ottiene OSWorld-Verified 84.3, contro l'84.8 di K3. Un modello denso da 27B rimane a mezzo punto da un flagship da 2,8T nell'uso del computer. Non è nella stessa categoria di K3 per il coding — Terminal-Bench 73.0 contro 88.3 — ma LiveCodeBench v6 a 90.3 e SWE-bench Pro a 61.7 ne fanno un vero modello da lavoro. Un confronto pratico su r/AISEOInsider arriva alla stessa conclusione dei dati: Qwen vince più spesso nelle build one-shot, Kimi prende vantaggio quando aumentano contesto e profondità delle revisioni.
Costi API: la soglia dei $15 in output e il costo del reasoning
I prezzi di listino puntano tutti nella stessa direzione. La spesa reale ancora di più, perché entrambi i modelli ragionano di default — K3 con reasoning_effort: max, Qwen con xhigh — e i token di reasoning vengono fatturati come output.
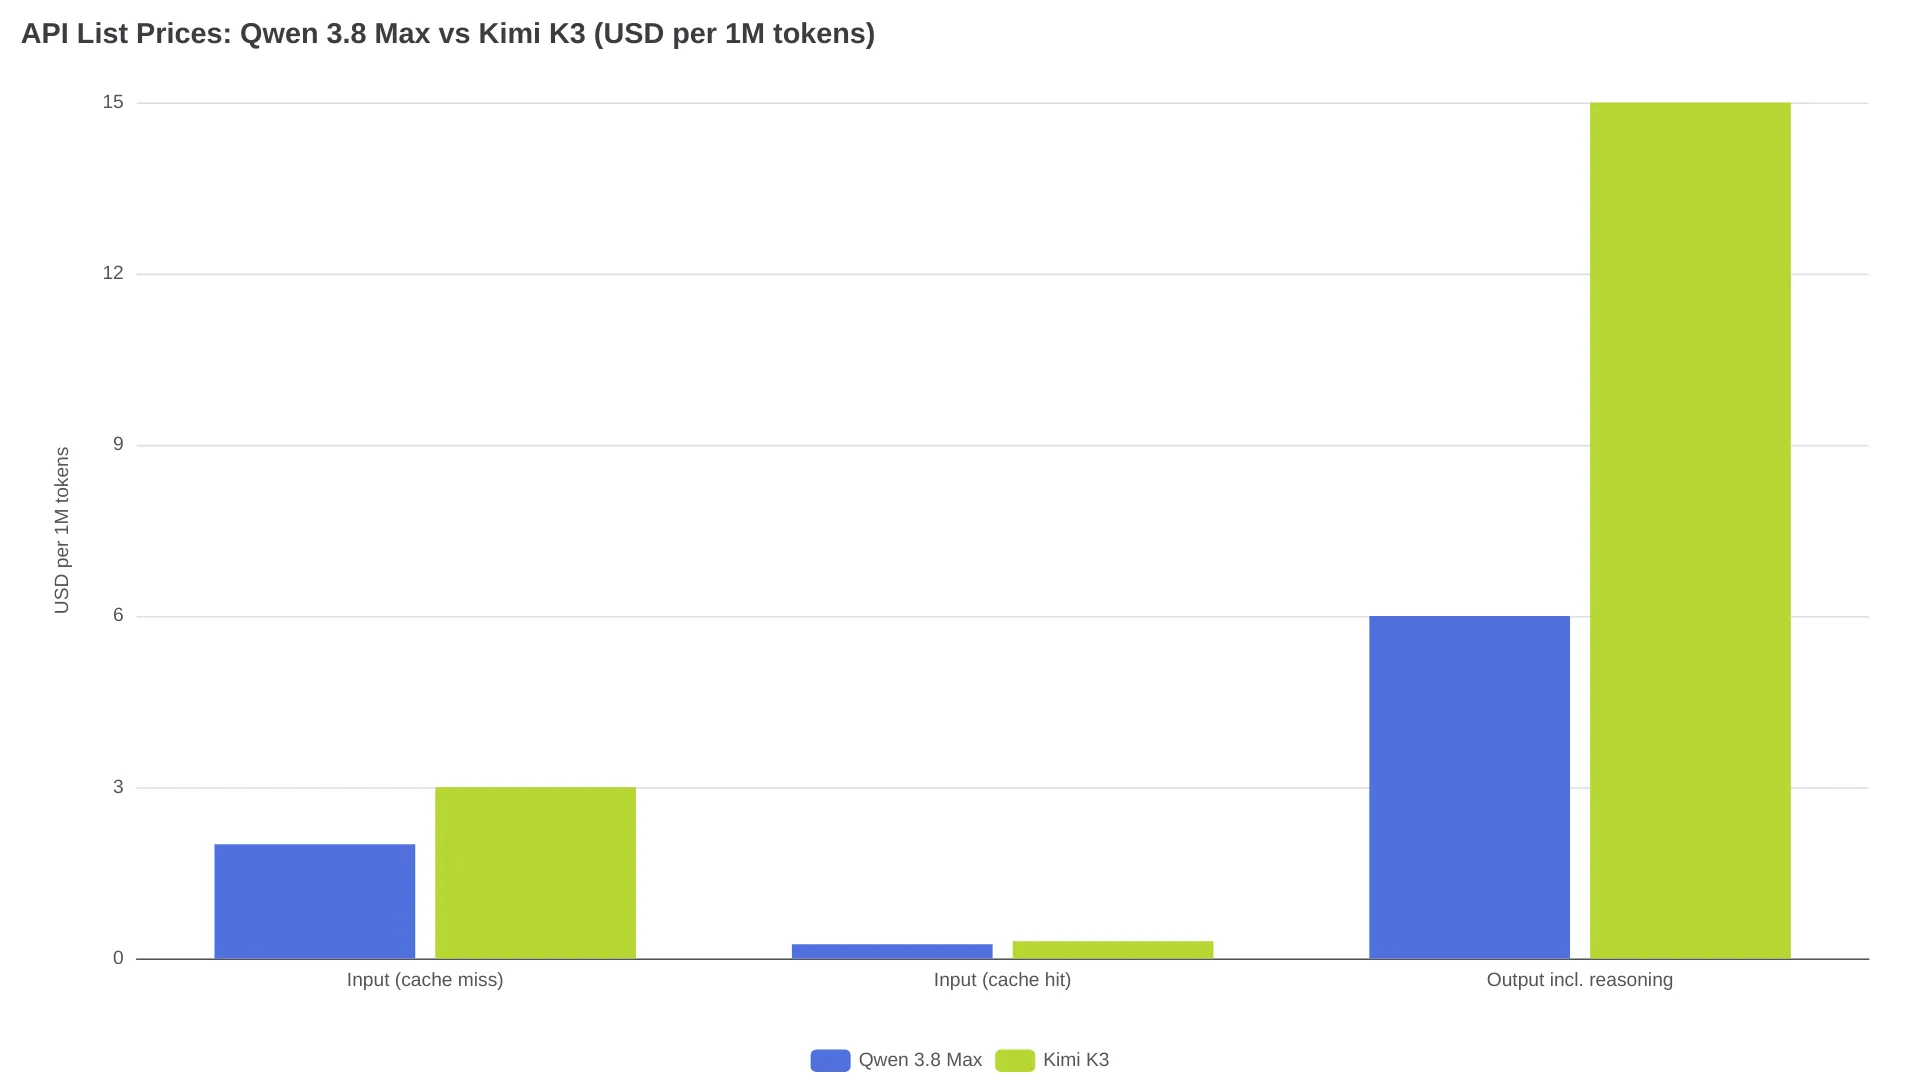
| Per 1M token | Qwen 3.8 Max (QwenCloud) | Kimi K3 (Moonshot) |
|---|---|---|
| Input (cache miss) | $2.00 | $3.00 |
| Input (cache hit) | $0.25 | $0.30 |
| Output, reasoning incluso | $6.00 | $15.00 |
| Creazione / lettura cache esplicita | $2.50 / $0.17 | — |
Due sessioni calcolate sui prezzi di listino di agosto 2026:
| Sessione | Qwen 3.8 Max | Kimi K3 | Differenza |
|---|---|---|---|
| Coding agentico: 500K input (60% in cache), 40K output | $0.72 | $1.29 | 1.8× |
| Pipeline documentale a contesto nuovo: 2M input, 100K output | $4.60 | $7.50 | 1.6× |
Da questi conti emerge una regola di routing: inviate un task a K3 solo se il suo tasso di accettazione sul vostro carico di lavoro supera quello di Qwen di oltre il divario di costo token di circa 1.8×. Moonshot stessa propone l'alternativa economica, Kimi K2.7 Code, a $0.95 per input e $4.00 per output su 256K di contesto: perciò il percorso più economico per il coding nella famiglia Kimi non è K3. Se oggi state instradando su K3, qui è elencato il suo endpoint API alle tariffe pubblicate da Moonshot; i meccanismi tariffari di entrambe le piattaforme sono analizzati nel dettaglio nell'analisi dei prezzi Qwen3.8-Max e nella guida ai prezzi di Kimi K3.
Self-hosting: 1,56 TB contro una RTX 4090
Qui le due storie dei pesi aperti divergono di circa due ordini di grandezza.
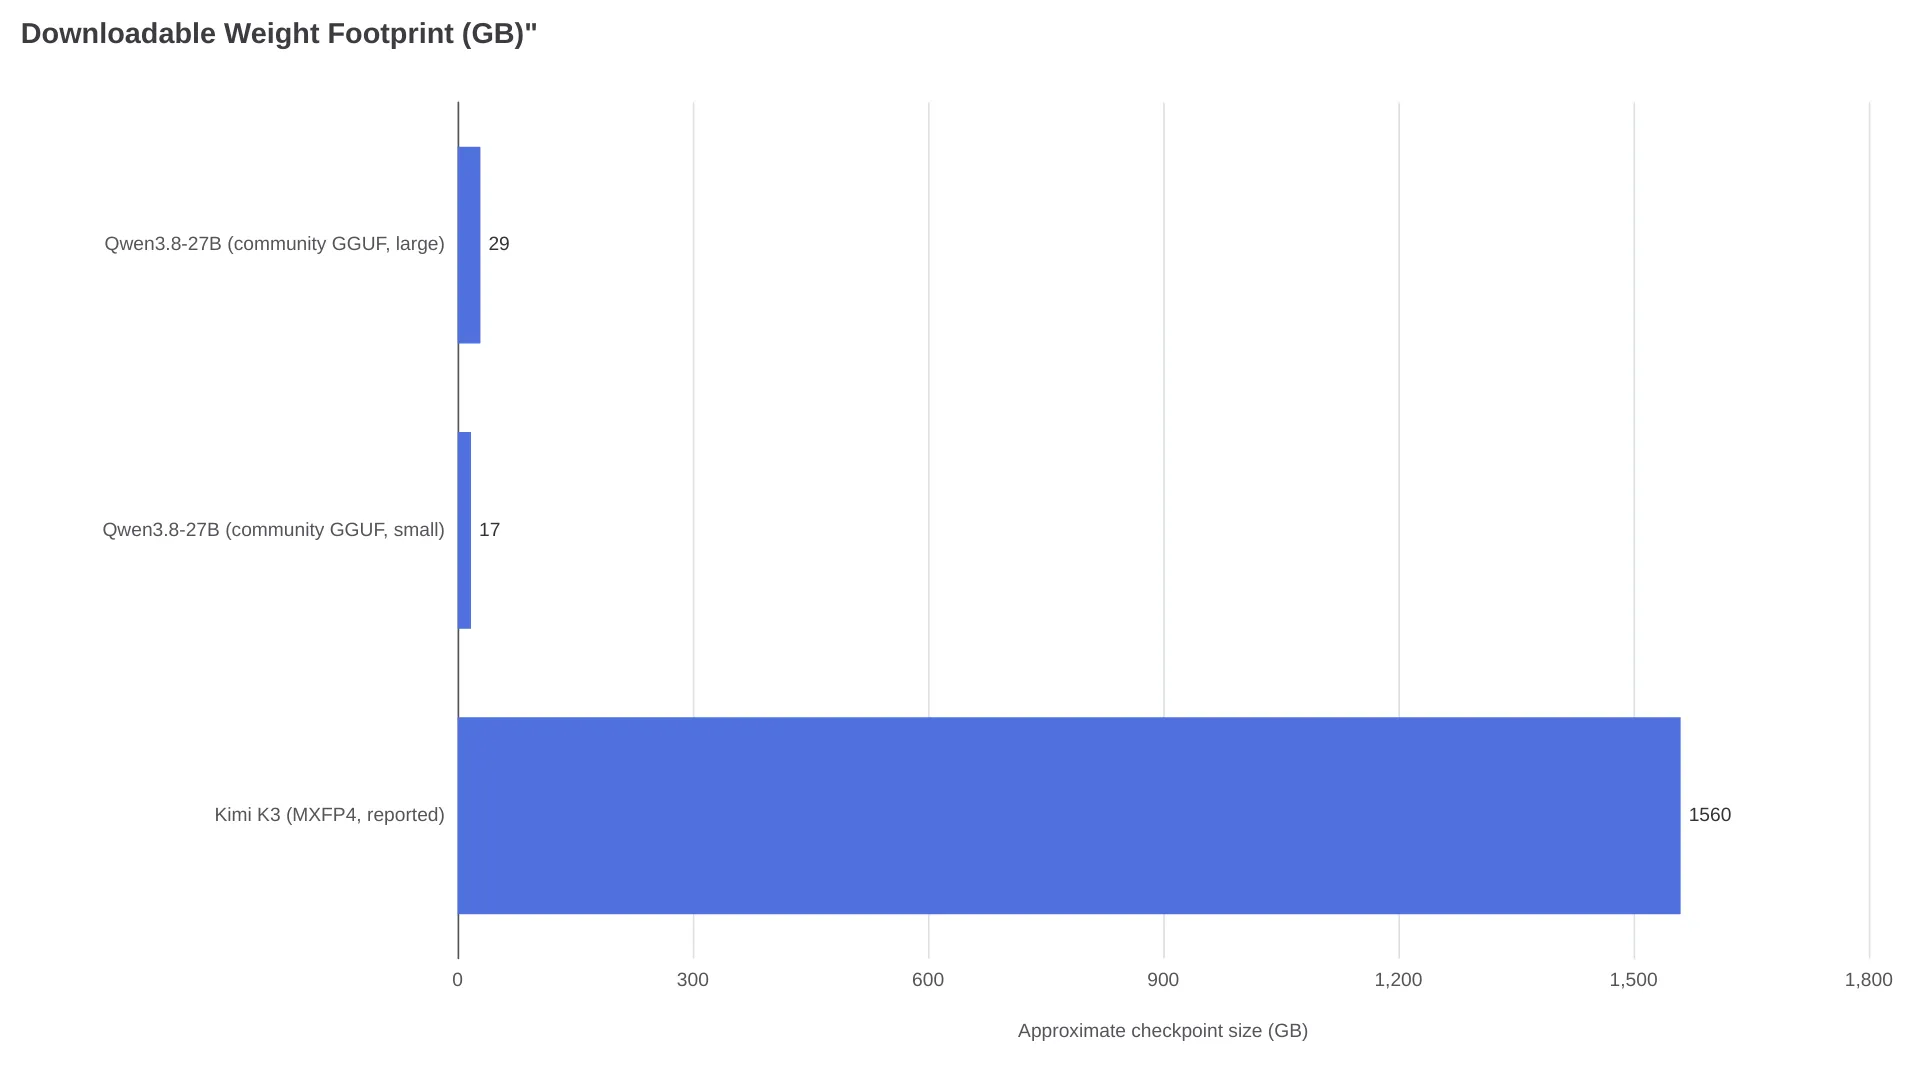
K3 viene distribuito con pesi MXFP4 quantization-aware (model card), ma un checkpoint riportato a 1,56 TB è un progetto da cluster: la stessa fonte consiglia vLLM su 64 o più acceleratori. È una voce di costo concreta, anche se noleggiabile, prima ancora di servire un singolo token; in aggiunta restano le condizioni della licenza per l'uso su larga scala.
Il 27B racconta l'esatto opposto. Le build GGUF della community vanno da circa 8,5 GB a 28,9 GB, le build dinamiche GGUF e NVFP4 di Unsloth richiedono circa 17 GB come minimo, ed esiste una variante FP8 ufficiale per il deployment server. Può quindi funzionare sull'hardware che molti hanno già in casa:
"Qwen3.8-27B a 160K di contesto su UNA SOLA RTX 4090 — 47–57 tok/s, offload GPU completo" — post di deployment su r/Qwen_AI
I pesi Max stanno nel mezzo: Qwen3.8-2.4T-A95B e la sua variante FP8 sono scaricabili con la licenza proprietaria qwen3.8-max, ma l'artefatto open è solo testuale e il thinking non può essere disabilitato. Input visivo, modalità senza thinking e contesto predefinito da 1M appartengono al livello API di QwenCloud, non al checkpoint. Per sapere esattamente cosa il 27B può e non può fare a ogni quantizzazione, la guida sul campo a Qwen3.8-27B include runtime e tabelle VRAM; il rilascio dei pesi di K3 è trattato nell'approfondimento sui pesi aperti di Kimi K3.
Dettagli di integrazione che decidono un progetto agentico
Tre comportamenti evidenziati nelle model card possono costarvi una giornata di debugging se li scoprite direttamente in produzione.
| Modello | Comportamento / limite | Conseguenza nell'implementazione |
|---|---|---|
| Kimi K3 | Thinking sempre attivo; i client multi-turn e tool-use devono reinviare l'intero messaggio precedente dell'assistente, inclusi reasoning_content e tool_calls (card) | Se si elimina la traccia di reasoning, i loop degli agenti degradano; se la si conserva, la spesa cresce con la lunghezza del loop |
| Qwen3.8-27B | preserve_thinking attivo di default; reasoning_effort può scendere a medium/low; oltre 262K YaRN usa uno scaling statico (card) | La disattivazione per singola richiesta è supportata; la card avverte che uno sforzo minore non riduce sempre il tempo end-to-end, perché i retry possono erodere il risparmio; attivate YaRN solo per i job lunghi |
| Limiti di Qwen 3.8 Max e K3 | Max: 991,8K input / 131,07K output (QwenCloud); K3: 1.048.576 input / 131K output predefinito, in aumento verso 1M | Nessuno dei due “contesti da 1M” garantisce 1M di output utile; un needle test di terze parti ha trovato 18/18 fatti a 248K e non ha testato oltre |
FAQ
Qwen 3.8 è migliore di Kimi K3 per il coding?
In base alle evidenze disponibili, no. Kimi K3 guida nelle righe di coding agentico più rilevanti — FrontierSWE 81.2 contro 73.5 e Terminal-Bench 2.1 a 88.3 contro 86.6 — ed è l'unico dei due con punteggi su indici indipendenti. Qwen 3.8 Max è vicino nel lavoro da terminale, costa meno per token e nelle sessioni modellate; il 27B appartiene invece a una categoria di pesi completamente diversa.
Quale costa meno, Qwen 3.8 o Kimi K3?
Qwen 3.8 Max su ogni voce di listino: $2 contro $3 per l'input, $6 contro $15 per l'output. Poiché entrambi fatturano il reasoning attivo di default come output, lo svantaggio di Kimi cresce con la difficoltà del task: circa 1.8× in una sessione agentica con cache, secondo i calcoli sopra.
Si possono fare self-hosting? Con quali licenze?
Sì, tutti e tre i checkpoint sono scaricabili. Qwen3.8-27B è Apache-2.0 e, quantizzato, entra in una singola GPU da 24 GB; Kimi K3 richiede hardware da cluster per il suo checkpoint MXFP4 da ~1,56 TB e usa la Kimi K3 License proprietaria; i pesi Qwen3.8-Max sono pubblici come Qwen3.8-2.4T-A95B sotto la licenza proprietaria qwen3.8-max.
La finestra di contesto da 1M è reale per entrambi?
All'incirca. Kimi K3 specifica 1.048.576 token; Qwen 3.8 Max elenca 1M con un massimo di 991,8K in input; il 27B è nativo fino a 262.144 e raggiunge 1M solo tramite scaling YaRN, che sacrifica qualità sul contesto breve. La verifica indipendente esiste soltanto al livello di 248K.
La scelta consigliata e cosa potrebbe cambiarla
| Scenario | Scelta | Perché |
|---|---|---|
| Agenti di coding via API, priorità alla qualità | Kimi K3 | FrontierSWE 81.2, Terminal-Bench 88.3, AA verificato 60 |
| Lavoro API in cui il budget conta, documenti/visione intensivi | Qwen 3.8 Max | $6 contro $15 in output, OSWorld 86.1, cache esplicita a $0.17/lettura |
| Self-hosting sull'hardware già disponibile | Qwen3.8-27B | Apache-2.0, quantizzazioni ~17–29 GB, 160K di contesto su una RTX 4090 |
| Self-hosting di un flagship frontier | Kimi K3 | L'unico checkpoint open qui con punteggi indipendenti di classe frontier — preventivate un cluster |
Due elementi potrebbero ribaltare in parte questa tabella: una valutazione indipendente di Qwen 3.8 Max, dato tracker-riportato a 53 contro il 60 verificato di K3 e basato su evidenze limitate, e la pubblicazione dei termini della licenza proprietaria qwen3.8-max. Finché non arriverà uno dei due, il confronto Qwen 3.8 Max vs Kimi K3 sulle API approfondisce lo scenario esclusivamente API.
Approfondimenti correlati: Qwen3.8-27B: cosa è confermato e cosa fa davvero con 17GB · Pesi aperti di Kimi K3 · Qwen 3.8 Max vs Kimi K3: edizione API