 AIREITER
Con 1.595 Elo, GLM-5.2 è al secondo posto nella Code Arena Frontend board di Arena e su FrontierSWE dista appena un punto da Claude Opus 4.8. Eppure molti sviluppatori stanno cercando di sostituirlo. Il problema, di rado, è la qualità del modello: dal lancio di giugno 2026, nelle discussioni degli sviluppatori tornano sempre gli stessi tre ostacoli. Le quote dei piani coding finiscono nel mezzo di un task, nelle ore di punta arrivano errori e, nei loop agentici lunghi, il consumo di token rende poco rappresentativo il prezzo di listino di $1.40/$4.40. La migliore alternativa a GLM-5.2 dipende quindi dal problema che si vuole risolvere.
Le scelte rapide: quale alternativa a GLM-5.2 scegliere
Ecco cinque risposte sintetiche; più sotto trovi dati e motivazioni:
- Quote che si bruciano / costo per loop agentico: DeepSeek V4 Flash, a $0.14/M in input, $0.28/M in output e con 1M di contesto.
- Loop degli agenti poco affidabili: Kimi K2.7 Code, a $0.95/M in input e $4.00/M in output.
- Massime prestazioni sui task più difficili: Claude Opus 4.8, con il doppio del punteggio di GLM-5.2 su SWE-Marathon, ai prezzi di un modello chiuso.
- Self-hosting o controllo dei dati: Qwen3-Coder (Apache 2.0), oppure gli stessi pesi MIT di GLM-5.2 se si dispone di 372–475 GB di RAM per una build a 4 bit.
- Nessun problema, vuoi solo una versione più recente: GLM-5.3, allo stesso prezzo di $1.40/$4.40, confermato da Z.ai il giorno del lancio.
GLM-5.2: punti di forza e costo operativo
La documentazione ufficiale di Z.ai descrive GLM-5.2 come il flagship solo testuale con finestra di contesto da 1M token, output massimo da 128K e prezzi API di $1.40/M per l'input, $4.40/M per l'output e $0.26/M per l'input in cache. I pesi sono rilasciati con licenza MIT il 16 giugno 2026, dopo un rollout del 13 giugno che inizialmente riservava il modello al GLM Coding Plan. Nella model card: 81.0 su Terminal-Bench 2.1 contro 85.0 di Opus 4.8, 62.1 su SWE-bench Pro contro 69.2 e 74.4 su FrontierSWE contro 75.1.
Sono numeri da frontiera dei modelli chiusi, ma a prezzi da open weights. Il punto critico, secondo gli utenti, è l'operatività. Intorno al lancio della 5.2, il piano Pro del Coding Plan è passato da meno di $35 a $65 al mese, aumento documentato da @bridgemindai nel giorno in cui è avvenuto. Le quote incluse nel piano raccolgono però critiche ancora maggiori del prezzo:
"GLM 5.2 ti esaurisce il limite settimanale in un giorno." — u/intl_spy, r/opencode
"Mi piace GLM-5.2, ma santo cielo, macina token." — @atomtanstudio
Uno sviluppatore che usa agenti auto-evolutivi con GLM-5.2 per lavoro reale ha riferito di aver consumato oltre $500 in un solo weekend. Cambiando modello durante un'esecuzione, ha osservato, si perde la KV cache e occorre pagare di nuovo per lo stesso contesto (@Xianbao_QIAN). Un altro sviluppatore ha sintetizzato così il limite dell'intera proposta di valore:
"GLM 5.2 è ottimo, ma il mio abbonamento Codex da $200 al mese mi dà comunque più utilizzo di quanto ottenga con $200 di API GLM 5.2. È un eccellente modello complementare... ma non un sostituto." — @mweinbach
A questo si aggiungono i problemi di capacità nelle ore di punta: @gengdaJ, abbonato al piano sin da GLM-4.5, racconta di server serali che "esplodono" e della necessità di ripiegare su modelli più vecchi. È questa la ragione per cui le persone che apprezzano GLM-5.2 cercano comunque "alternative a GLM-5.2".
Alternative a confronto: prezzi e problemi che risolvono
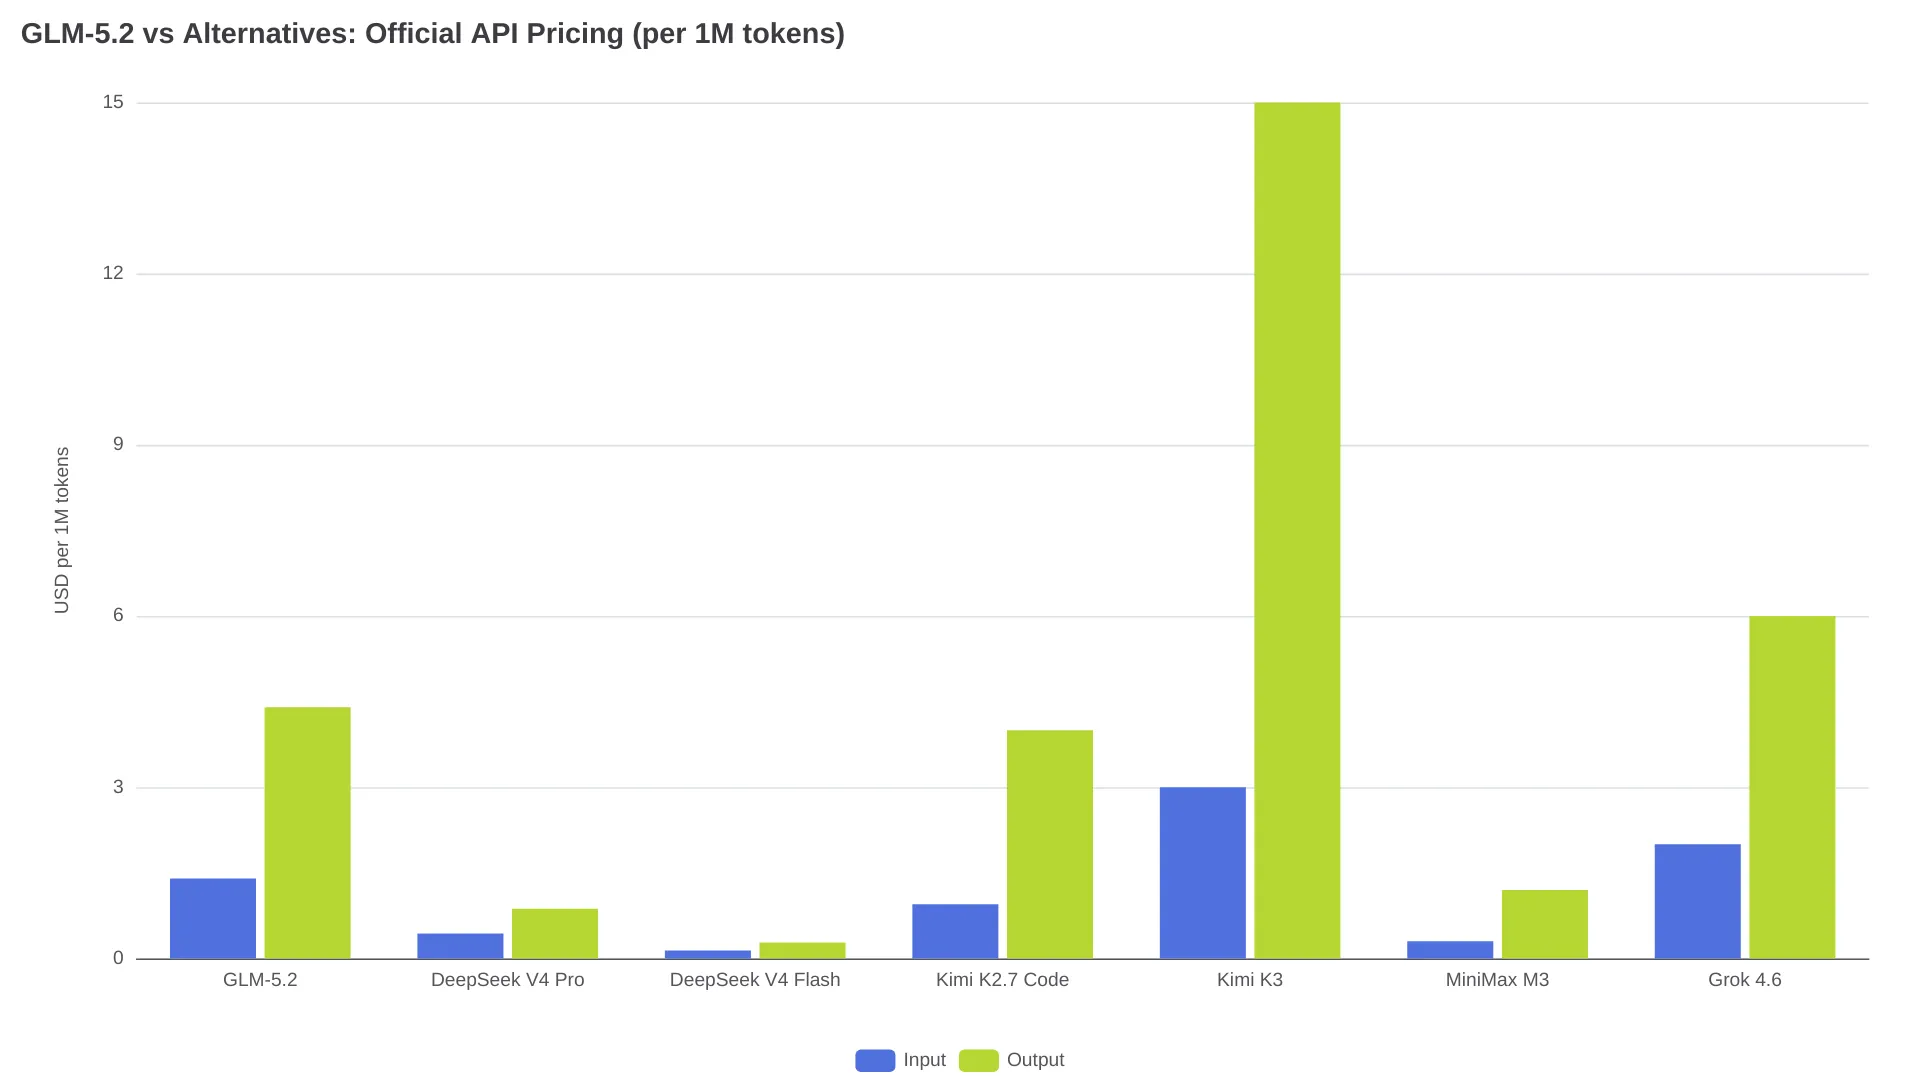
Tutti i prezzi riportati sotto provengono dalle pagine ufficiali dei fornitori e sono stati rilevati nell'agosto 2026. I prezzi di Kimi K3 e MiniMax M3 si riferiscono all'input senza cache; le rispettive tariffe con cache hit sono molto più basse.
| Modello | Contesto | Pesi / licenza | Prezzo API ($/1M, in / out) | Passa a questo se… |
|---|---|---|---|---|
| GLM-5.2 (riferimento) | 1M | MIT | $1.40 / $4.40 | — |
| DeepSeek V4 Pro | 1M | Open (MIT, secondo Layer3 Labs) | $0.435 / $0.87 | Vuoi ragionamento complesso più economico con lo stesso contesto |
| DeepSeek V4 Flash | 1M | Open | $0.14 / $0.28 | Il problema è interamente il consumo della quota |
| Kimi K2.7 Code | 256K | Open (MIT modificata) | $0.95 / $4.00 | L'affidabilità dei loop agentici conta più della dimensione del contesto |
| Kimi K3 | 1M | Closed | $3.00 / $15.00 | Ti serve la stabilità di Kimi e 1M di contesto |
| MiniMax M3 | 1M | Closed | $0.30 / $1.20* | Input multimodale o carichi elevati sensibili al prezzo |
| Qwen3.8 Max / Qwen3-Coder | 1M | Apache 2.0 | Pesi gratuiti; hosting variabile | L'obiettivo è il self-hosting o il fine-tuning |
| Grok 4.6 | 500K | Closed | $2.00 / $6.00 | Vuoi velocità e un contesto ampio ma gestibile |
Oltre a questi sette modelli, più avanti trovi due percorsi di upgrade: Claude Opus 4.8 per i team che continuano a fallire sui task più difficili e GLM-5.3 per aggiornare restando nella stessa famiglia e allo stesso prezzo.
\* Il livello di MiniMax M3 si applica agli input ≤512K token; oltre questa soglia il prezzo raddoppia. GLM-5.3 ha lo stesso identico prezzo di GLM-5.2 secondo l'annuncio di lancio di Z.ai, perciò è escluso dal confronto sui costi.
Quale modello scegliere, problema per problema
Quota esaurita: instrada i loop su DeepSeek V4 Flash
I numeri parlano chiaro. Per input senza cache, GLM-5.2 costa $1.40/M contro i $0.14/M di DeepSeek V4 Flash: 10 volte tanto. In output, $4.40 contro $0.28 significa una differenza di 15.7 volte. Nella fase esecutiva di un loop agentico — modifiche ai file, correzioni dei test, boilerplate — questo divario si somma a ogni turno. DeepSeek offre inoltre lo stesso contesto da 1M token, con output massimo da 384K. V4 Pro, a $0.435/$0.87, conserva gran parte del risparmio e punta ai run di ragionamento più complessi; il nostro confronto GLM-5.2 vs DeepSeek V4 Pro spiega dove prevale ciascuno, mentre il testa a testa con V4 Flash è dedicato alla fascia più economica.
Tra gli abbonati a OpenCode Go emerge uno schema ricorrente: non sostituire GLM-5.2, ma affiancargli un modello meno caro. GLM-5.2 resta per pianificazione e revisione, l'altro gestisce il lavoro ripetitivo. "Uso OpenCode Go GLM 5.2 solo per pianificare", scrive u/narkeeso; nello stesso ecosistema, u/Endoky consiglia di "usare GLM 5.2 solo come modello di escalation o per la pianificazione".
Loop agentici instabili: Kimi K2.7 Code
Quando il limite è il servizio, non le capacità, Kimi è l'alternativa citata nelle discussioni esaminate. La sintesi di un utente, pubblicata originariamente in cinese, è netta:
"Le capacità del modello sono più o meno equivalenti, ma l'impossibilità di erogarlo stabilmente è il motivo per cui ho scelto Kimi invece di GLM." — @wonjder
Kimi K2.7 Code è la scelta specializzata nel coding: $0.95/M in input, $4.00/M in output e $0.19/M sui cache hit, con un contesto da 262.144 token. È un quarto della finestra di GLM-5.2, ed è qui che sta il vero compromesso. Accetta input di testo, immagini e video, colmando anche il vuoto multimodale lasciato da GLM-5.2, che è solo testuale. Se 256K non bastano a contenere il repository, Kimi K3 offre una finestra da 1M a $3.00/$15.00. I $15 in output sono 3.4 volte la tariffa di GLM-5.2: K3 si acquista per la stabilità, non per risparmiare. Il confronto Kimi K2.7 Code vs GLM-5.2 approfondisce la parte relativa ai benchmark.
Task molto difficili: quando serve Claude Opus 4.8
Su SWE-Marathon — build di compilatori, lavoro sul kernel e job autonomi di più ore — Opus 4.8 ottiene 26.0 contro 13.0 di GLM-5.2; su NL2Repo i punteggi sono 69.7 contro 48.9, secondo la model card di Z.ai. GLM-5.2 rimane il modello open con il ranking più alto su entrambe le classifiche, sempre secondo la stessa model card, ma il divario cresce proprio quando i task si allungano. Opus è closed-source, non può essere eseguito in self-hosting e ha prezzi premium; il confronto GLM-5.2 vs Opus mostra quando quel sovrapprezzo si ripaga.
Self-hosting e controllo dei dati: Qwen3-Coder o gli stessi pesi di GLM
Qwen3-Coder e Qwen3.8 Max sono distribuiti con licenza Apache 2.0, hanno 1M token di contesto e includono varianti compatte pensate per il serving su una sola GPU. Sia Layer3 Labs sia glm5.app li indicano come la scelta per il self-hosting. Per fine-tuning e deployment privati, sono l'opzione pratica tra le alternative qui considerate; il nostro approfondimento sugli open weights di Qwen 3.8 Max copre l'intera famiglia.
L'opzione meno intuitiva è ospitare GLM-5.2 in proprio, dato che la licenza MIT lo permette. I requisiti, però, sono impegnativi: i pesi BF16 occupano 1.51 TB e persino una quantizzazione a 4 bit della release GGUF di Unsloth richiede 372–475 GB di memoria per essere caricata. In pratica, una build a 4 bit richiede un server multi-GPU, il BF16 completo è territorio da cluster e gli strumenti locali sono ancora giovani: llama.cpp ha aggiunto il supporto all'indexer di GLM-5.2 solo il 24 luglio 2026 (PR #25407). Il self-hosting di GLM-5.2 è una scelta di sovranità dei dati, non di praticità; senza un cluster, le varianti compatte di Qwen sono l'alternativa adatta a una workstation.
Multimodalità e throughput economico: MiniMax M3
MiniMax M3 unisce un contesto da 1M all'input multimodale, a $0.30/M in input e $1.20/M in output nel livello ≤512K. Oltre tale soglia entrambi i prezzi raddoppiano, quindi il budget va calcolato di conseguenza. Per i budget di team, i piani token di MiniMax costano $20/$50/$120 al mese e coprono l'offerta M3, M2.7, immagini e voce dell'azienda, con quote misurate su finestre mobili di 5 ore e settimanali.
Priorità alla velocità: Grok 4.6
Grok 4.6 costa $2.00/M in input e $6.00/M in output, con contesto da 500K. La pagina API di xAI rivendica prestazioni leader nel coding e nel tool calling senza pubblicare la tabella dei benchmark, quindi questa rimane una dichiarazione di posizionamento. Il segnale dagli utenti, però, esiste: @bourneliu66 sostiene che, nella sua "big three", Grok abbia preso il posto di GLM perché più forte, veloce ed economico. Prima di accettare questa gerarchia, verificala sul tuo carico di lavoro.
Non c'è nulla che non vada: vuoi soltanto l'ultimo GLM, GLM-5.3
GLM-5.3 è arrivato nell'API il 18 agosto 2026 a lo stesso prezzo di GLM-5.2, secondo l'annuncio di Z.ai. Se stai valutando alternative per timore di restare indietro, non per un problema concreto, il confronto GLM-5.2 vs GLM-5.3 spiega cosa è realmente cambiato.
La strategia a due livelli: tenere GLM-5.2, ma ridimensionarne il ruolo
Nelle discussioni citate sopra, l'approdo più comune non è una migrazione completa. GLM-5.2 viene spostato al ruolo di pianificatore o revisore, mentre l'esecuzione passa a un modello più economico. È coerente con il profilo del modello: Z.ai lo posiziona per il lavoro di engineering agent a lunga esecuzione, ma nella fascia economica è anche il più caro per token.
Due aspetti determinano se questa divisione funziona. Il primo è la perdita della KV cache: un cambio di modello o di provider durante il run, anche usando lo stesso modello, obbliga a pagare nuovamente il contesto. Il secondo è la variabilità tra provider: gli utenti di r/opencodeCLI riportano notevoli differenze di velocità tra Fireworks, NeuralWatt e OpenCode Go pur servendo lo stesso modello.
Un singolo endpoint compatibile con OpenAI risolve la metà operativa del problema: conserva la stessa struttura di richiesta della API GLM-5.2 per entrambe le fasi, permette di reindirizzare le richieste quando un provider degrada e concentra la fatturazione. Non rende però gratuito il contesto: il riuso della cache non passa tra modelli o provider, ed è il costo alla base del resoconto da $500 nel weekend. Per questo il routing va effettuato ai confini del task, non a esecuzione iniziata. Se la tua configurazione divisa opera dentro Claude Code, la nostra guida a GLM-5.2 in Claude Code tratta la parte relativa all'harness.
Tabella decisionale in 30 secondi
| Il tuo problema | Scelta | A cosa rinunci |
|---|---|---|
| La quota settimanale finisce in un giorno | DeepSeek V4 Flash | Parte della rifinitura nel coding agentico di GLM |
| I loop degli agenti si interrompono per errori del provider | Kimi K2.7 Code | Contesto da 1M, sostituito da 256K |
| I task più duri e di più ore falliscono | Claude Opus 4.8 | Open weights, prezzi bassi e self-hosting |
| Servono i pesi sul proprio hardware | Qwen3-Coder | Il coding frontend di GLM, leader per Elo |
| Consuma troppi token nel lavoro generico | MiniMax M3 | Oltre 512K in input, i prezzi raddoppiano |
| Vincoli normativi o di procurement | Pesi Qwen o GLM in self-hosting | La comodità di un servizio gestito |
| Vuoi il GLM più recente | GLM-5.3 | Nulla; il prezzo è lo stesso |
FAQ
Qual è la migliore alternativa a GLM-5.2 in assoluto?
DeepSeek V4 Pro è il sostituto più completo: contesto da 1M, open weights e costo per token inferiore di 3-5 volte. Kimi K2.7 Code è preferibile quando, nelle lunghe esecuzioni agentiche, l'affidabilità conta più della differenza nei benchmark.
DeepSeek è migliore di GLM-5.2 per il coding?
Per il ragionamento algoritmico difficile, il confronto di glm5.app colloca DeepSeek V4 Pro davanti; nel lavoro agentico multi-file e di lungo periodo, il contesto da 1M di GLM-5.2 e il suo addestramento sugli agenti a lungo orizzonte, indicato da Z.ai come specializzazione, lo mantengono in vantaggio. In pratica: DeepSeek esegue, GLM pianifica.
Qual è l'alternativa a GLM-5.2 più economica?
DeepSeek V4 Flash, a $0.14/M in input e $0.28/M in output, con input da cache hit a $0.0028/M: praticamente gratuito per contesto ripetuto.
Quali alternative offrono lo stesso contesto da 1M token di GLM-5.2?
DeepSeek V4 Pro e V4 Flash, Kimi K3, MiniMax M3 e Qwen3.8 Max dichiarano tutti finestre da 1M token. Kimi K2.7 Code, con 256K, e Grok 4.6, con 500K, no.
Si può eseguire GLM-5.2 in locale invece di cambiare modello?
Dal punto di vista tecnico sì, poiché esistono pesi MIT, ma una build a 4 bit richiede 372–475 GB di RAM e il supporto in llama.cpp è stato integrato solo il 24 luglio 2026. Per la maggior parte dei team, l'accesso tramite API hosted è l'unica opzione pratica.
Quanto costano al mese in abbonamento le alternative a GLM-5.2?
I piani token di MiniMax costano $20–$120 al mese. Code CLI di Kimi parte da $19 al mese e il Coding Plan di Z.ai da $18 al mese, secondo la copertura prezzi di Digital Applied; il livello Pro di Z.ai è a $65 dopo l'aumento di giugno.