 AIREITER
Una chiamata a gemini-2.5-pro del 2 dicembre non andrà in errore: riceverà una risposta da un modello diverso. Google ha deprecato gemini-2.5-pro e gemini-2.5-flash il 2 novembre 2026 e, dal 1° dicembre 2026, la Gemini Developer API instraderà automaticamente quegli ID verso gemini-3.8-flash e gemini-3.5-flash-lite, applicando le tariffe dei modelli sostitutivi. Il problema è che non si tratta di un semplice cambio di endpoint: cambiano il livello del modello e alcuni parametri dell’API. Continuare a usare la vecchia stringa fino a dicembre è quindi la scelta più rischiosa.
Cosa cambia dal 1° dicembre
Google ha deprecato gemini-2.5-pro e gemini-2.5-flash nella Gemini Developer API. I due identificatori sono già scomparsi dal selettore di Google AI Studio e l’accesso via API è ora limitato agli sviluppatori che avevano già utilizzato ciascun modello. Dal 1° dicembre 2026 le richieste continueranno ad andare a buon fine, ma verranno eseguite da modelli diversi e fatturate con tariffe differenti.
La corrispondenza indicata da Google nella pagina sulle deprecazioni della Gemini API è questa:
| Vecchio ID chiamato | Modello che risponderà dal 1° dicembre 2026 | Fatturazione dal 1° dicembre |
|---|---|---|
gemini-2.5-pro | gemini-3.8-flash | Tariffe di Gemini 3.8 Flash |
gemini-2.5-flash | gemini-3.5-flash-lite | Tariffe di Gemini 3.5 Flash-Lite |
gemini-2.5-flash-lite | invariato, nessun rerouting | invariata |
Google indica il 1° dicembre 2026 come data di instradamento per entrambi gli ID stabili; l’avviso è comparso nel changelog del 2 novembre 2026. Patrick Loeber, membro dello staff di Google DeepMind, ha rilanciato la notizia in un PSA, avvertendo che le integrazioni più avanzate richiedono un intervento seguendo la guida alla migrazione.
L’avviso riguarda esclusivamente la Gemini Developer API e AI Studio. Vertex AI segue un calendario di ritiro separato: Google Cloud indica date a ottobre 2026 per gli stessi nomi di modello, mentre Firebase AI Logic mantiene un proprio elenco dei modelli supportati. Chi usa Vertex dovrebbe quindi controllare la console Cloud, senza dare per scontato che il 1° dicembre valga ovunque.
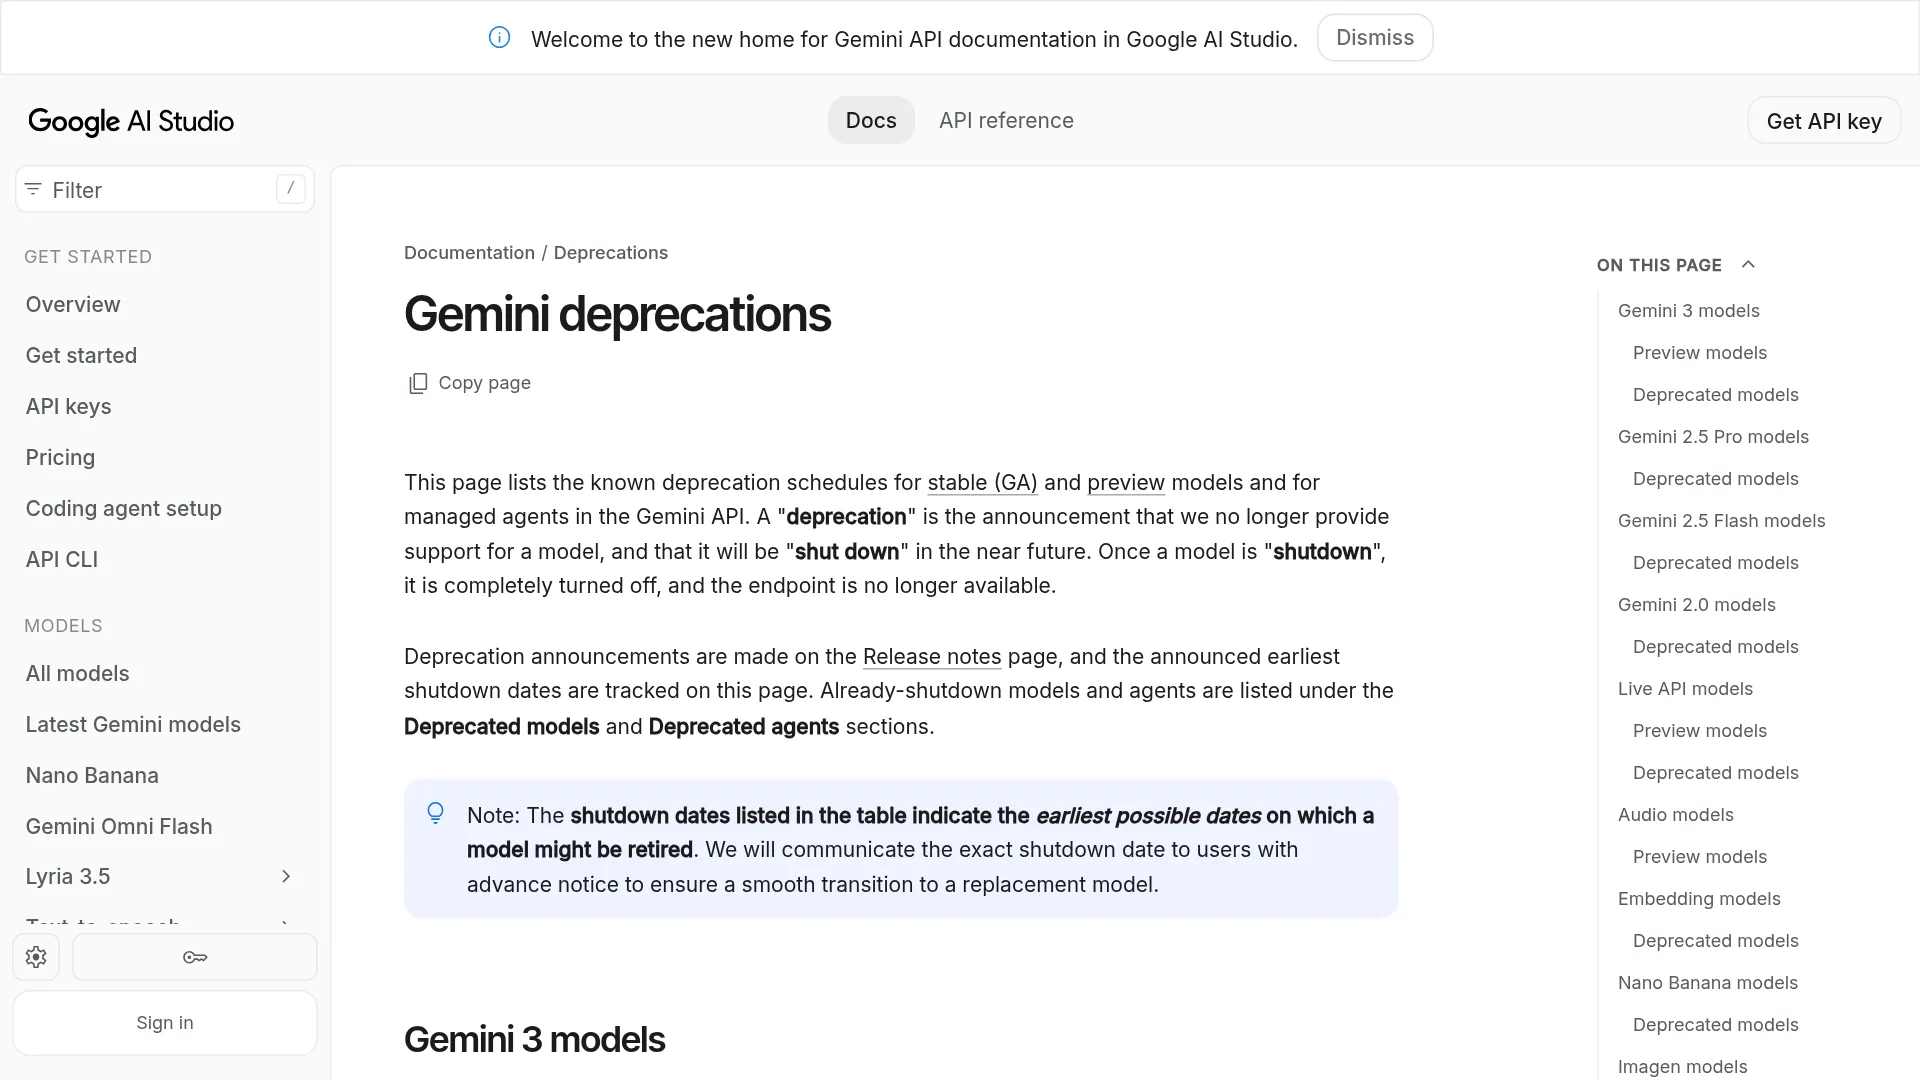
Il 18 settembre Google aveva definito la versione 2.5 «non deprecata», salvo poi annunciarne la deprecazione il 2 novembre. Conviene quindi considerare il 1° dicembre una scadenza effettiva. La sequenza è documentata nella cronologia del changelog.
Quanto costeranno le richieste reindirizzate a dicembre e gennaio
Per il traffico Gemini 2.5 Pro, dicembre porterà una riduzione dei costi, ma a gennaio il prezzo degli input aumenterà. Per Gemini 2.5 Flash, il traffico testuale manterrà lo stesso costo dopo il passaggio, mentre gli input audio diventeranno molto più economici. Le cifre riportate qui sotto sono i prezzi di listino del piano a pagamento per 1 milione di token, tratti dalla pagina dei prezzi della Gemini API e rilevati il 3 novembre 2026. Per il quadro completo dei singoli modelli, si possono consultare anche i prezzi di Gemini 3.8 Flash e Gemini 3.5 Flash-Lite.
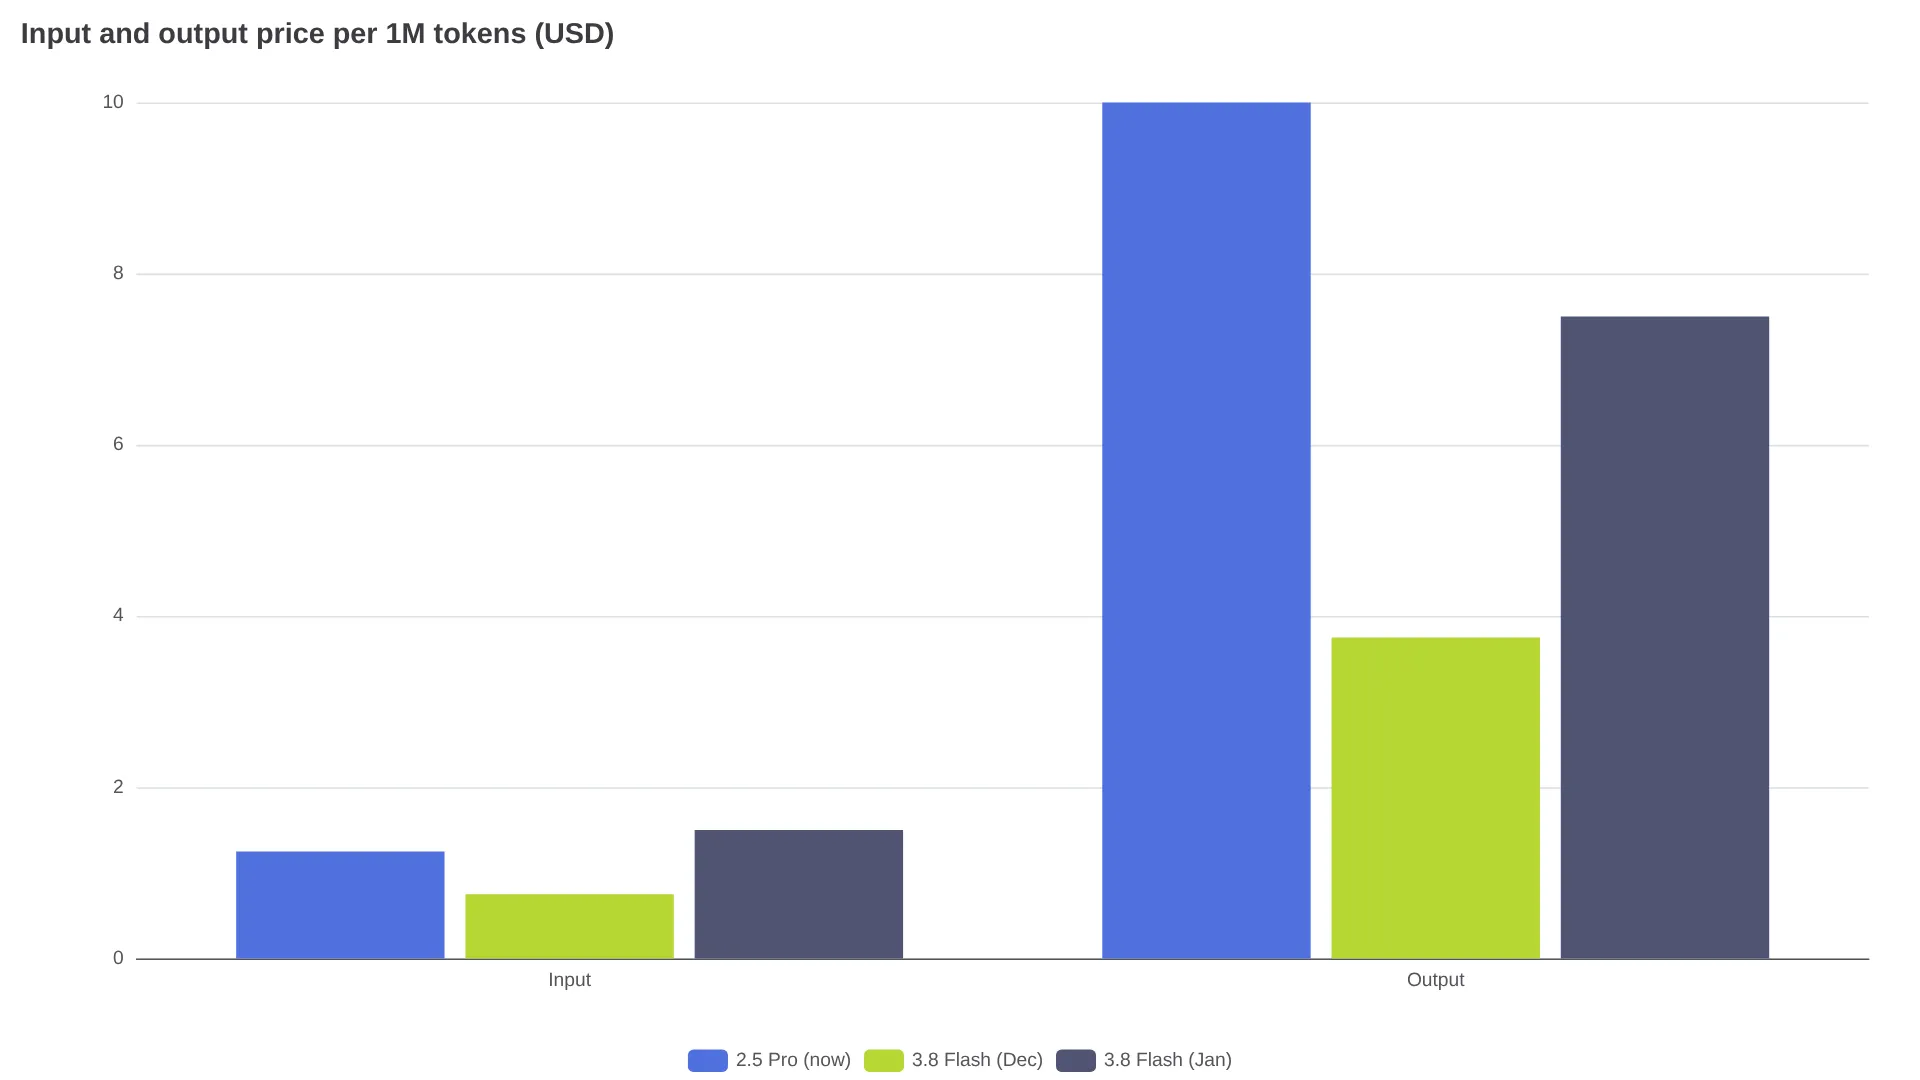
| Modello e periodo | Input / 1M | Output, incluso il thinking / 1M |
|---|---|---|
gemini-2.5-pro, prompt ≤200k token, fino al 30 novembre | $1.25 | $10.00 |
gemini-2.5-pro, prompt >200k token, fino al 30 novembre | $2.50 | $15.00 |
gemini-3.8-flash, 1–31 dicembre 2026 | $0.75 | $3.75 |
gemini-3.8-flash, dal 1° gennaio 2027 | $1.50 | $7.50 |
Gemini 3.8 Flash applica un’unica fascia di prezzo indipendentemente dalla lunghezza del prompt: i carichi con contesto superiore a 200.000 token saranno quindi quelli con il risparmio maggiore. Un prompt con 300.000 token in input e 4.000 in output per un documento lungo costa circa $0.81 con Gemini 2.5 Pro alla tariffa $2.50/$15.00, circa $0.24 con i prezzi di dicembre di Gemini 3.8 Flash a $0.75/$3.75 e circa $0.48 con i prezzi di gennaio a $1.50/$7.50. A gennaio, l’unico scenario che si avvicina alla vecchia spesa è quello delle chat con prompt brevi e molti token in input.
Il passaggio da Flash è più lineare:
| Modello | Input testo/immagini/video | Input audio | Output |
|---|---|---|---|
gemini-2.5-flash fino al 30 novembre | $0.30 | $1.00 | $2.50 |
gemini-3.5-flash-lite dal 1° dicembre | $0.30 | $0.30 | $2.50 |
Cache del contesto, batch e priorità seguono lo stesso schema: le tariffe testuali restano invariate, mentre quelle audio diminuiscono. C’è però un dettaglio importante per i budget: i token di thinking vengono fatturati come output e i modelli sostitutivi possono generare un numero diverso di token di ragionamento nei task lunghi. Non è quindi possibile assumere che il conteggio dell’output resti uguale. Prima di fissare una previsione, confrontate i dati usage_metadata del traffico reale.
Perché la stessa stringa del modello può rompere codice funzionante
Il rerouting automatico mantiene il codice HTTP 200, ma cambia il motore che lavora dietro le quinte. Gemini 3.x applica regole sulle richieste che Gemini 2.5 accettava, perciò dal 1° dicembre il codice potrebbe iniziare a fallire o a produrre risultati diversi anche se il nome del modello non è mai stato toccato.
Gemini 3.x sostituisce thinking_budget con thinking_level. Gemini 3.8 Flash accetta low, medium e high, ma rifiuta minimal; Gemini 3.5 Flash-Lite usa invece minimal come valore predefinito. Inviare entrambi i campi restituisce HTTP 400, mentre condividere una configurazione minimal tra i due modelli sostitutivi rompe il percorso verso 3.8 Flash. Google consiglia minimal per estrazione, routing e classificazione, e medium o high per subagenti, chiamate agli strumenti, esecuzione di codice e ragionamento in più passaggi, così da evitare che gli strumenti vengano interrotti troppo presto.
Cambiano anche i controlli sul sampling e sulla cronologia, come spiega la guida alla migrazione a Gemini 3. Su Gemini 3.x temperature, top_p e top_k al momento vengono ignorati e nelle generazioni future dovrebbero restituire HTTP 400. candidate_count non è supportato. Qualsiasi richiesta il cui ultimo turno non vuoto abbia ruolo model — il classico trucco del prefill che termina con Translation: — restituisce HTTP 400. Google indica invece di usare system_instruction e output strutturati.
Anche le chiamate alle funzioni diventano più rigide. Gemini 3.x valida thought_signature e richiede che ogni FunctionResponse includa l’ID e il nome della chiamata corrispondente. Eliminare la firma o ricostruire il turno del modello senza conservarla può produrre risposte STOP vuote o chiusure MISSING_THOUGHT_SIGNATURE, invece di un errore chiaro. I test di regressione devono quindi verificare il testo della risposta, non solo l’assenza di eccezioni.
Gli utenti hanno segnalato proprio questo comportamento già poche ore dopo l’annuncio:
Google ha appena fissato una data per la fine di Gemini 2.5, ma il dettaglio importante non è la deprecazione: è il rerouting automatico. ... Quindi il vostro codice non riceverà un 404. Inizierà semplicemente a rispondere con un modello diverso. — @VarunChopr17597
Se il vostro agent chiama ancora gemini-2.5-flash, dal 1° dicembre inizierà a funzionare su Gemini 3.5 Flash-Lite, che usa il thinking minimal come impostazione predefinita. — @MarMarLabs
Migrare a novembre: la checklist in 7 passaggi
La strada più sicura consiste nel cambiare esplicitamente gli ID dei modelli e aggiornare i parametri a novembre, quindi eseguire una valutazione affiancata rispetto al modello sostitutivo di dicembre. Affidarsi al router non è una strategia di migrazione.
- Individuate ogni riferimento, inclusi gli alias preview. Cercate nei sorgenti, nelle configurazioni, negli strumenti di valutazione e nella documentazione i due ID interessati, escludendo il modello Lite che non cambia:
grep -rnE 'gemini-2\.5-(pro|flash)([^-]|$)' .
- Sostituite esplicitamente gli ID. In un branch, e non la mattina del 1° dicembre, cambiate
gemini-2.5-proingemini-3.8-flashegemini-2.5-flashingemini-3.5-flash-lite. - Sistemate la configurazione del thinking. Sostituite
thinking_budgetconthinking_level, impostandolo per modello (mediumohighper gli agent su 3.8 Flash;minimal,mediumohighin modo esplicito per i carichi su Flash-Lite), ed evitate di condividereminimalcon 3.8 Flash. - Rimuovete i parametri legacy. Eliminate
temperature,top_p,top_k,candidate_counte i turni finali del modello precompilati prima di eseguire i test. - Aggiornate SDK e integrazione degli strumenti. Passate a un SDK recente, conservate i turni completi del modello inclusi i
thoughtSignature, costruiteFunctionResponsecon ID e nome della chiamata e testate nuovamente da capo le chiamate agli strumenti su più turni. - Ripetete i test di riferimento sul modello sostitutivo. Confrontate qualità, latenza, lunghezza dell’output e conteggio dei token in
usage_metadatausando prompt di produzione: un modello Flash non restituirà necessariamente lo stesso stile di un modello Pro in ogni attività. - Ricalcolate i costi due volte. Mettete a budget dicembre a $0.75/$3.75 per il percorso Pro e da gennaio in poi a $1.50/$7.50, verificando nuovamente le voci audio e cache per il percorso Flash.
I team che usano già Gemini 3.x o gemini-2.5-flash-lite possono saltare questa migrazione. Tutti gli altri dovrebbero completare il passaggio 6 entro il 30 novembre: una suite di test verde il 1° dicembre potrebbe significare soltanto che il router sta rispondendo, non che il comportamento sia rimasto invariato.
Chi sviluppa agent dovrebbe leggere anche l’analisi dei prezzi di Gemini 3.8 Flash per i task degli agent prima di impostare i livelli di thinking per i carichi che fanno largo uso di strumenti.
Domande frequenti
Gemini 2.5 Pro verrà disattivato il 1° dicembre 2026?
No. Google indica il 1° dicembre 2026 come data di rerouting nella Gemini Developer API: le richieste a gemini-2.5-pro verranno indirizzate a gemini-3.8-flash invece di restituire un errore.
Le richieste reindirizzate verranno fatturate ai vecchi o ai nuovi prezzi?
Ai nuovi prezzi. Dopo il 1° dicembre, una richiesta inviata come gemini-2.5-pro verrà fatturata secondo le tariffe di Gemini 3.8 Flash, mentre una richiesta a gemini-2.5-flash userà le tariffe di Gemini 3.5 Flash-Lite.
Devo modificare il codice se il routing è automatico?
Sì. Su Gemini 3.x cambiano la configurazione del thinking, i parametri di sampling, i turni precompilati e la gestione delle chiamate alle funzioni. Il codice invariato potrebbe ricevere parametri ignorati, errori HTTP 400 o un comportamento di ragionamento diverso senza segnalarlo chiaramente.
Il 1° dicembre vale anche per Vertex AI?
No. Il 1° dicembre è la data relativa alla Gemini Developer API. Google Cloud documenta date di ritiro separate, a ottobre 2026, per Gemini 2.5 su Vertex AI e sull’Enterprise Agent Platform.
Gemini 2.5 Flash-Lite è interessato?
No. Google afferma che gemini-2.5-flash-lite non è deprecato e rimarrà disponibile fino a nuovo avviso.
Quale modello sostitutivo scegliere per ogni carico?
La scelta va fatta in base all’attività e poi verificata con una valutazione. Non date per scontato che un modello Flash equivalga al vecchio modello Pro.
| Carico attuale | Destinazione esplicita | Attenzione a |
|---|---|---|
| Prompt Pro generici, coding, documenti lunghi | gemini-3.8-flash con medium+ | Passaggio da Pro a Flash; rivalutare qualità, lunghezza dell’output e prezzo dell’input da gennaio |
| Agent con strumenti | gemini-3.8-flash con medium o high | thought_signature, ID delle risposte e STOP prematuri con minimal |
| Classificazione, estrazione, routing | gemini-3.5-flash-lite con minimal | La scelta più economica; passare a medium se vengono aggiunti strumenti |
| Pipeline di trascrizione audio | gemini-3.5-flash-lite | L’input audio scende da $1.00 a $0.30; ricontrollare le voci della cache |
Cosa fare entro il 30 novembre
Cambiate questa settimana le due stringhe dei modelli, sistemate thinking e gestione degli strumenti e create una nuova baseline sui modelli sostitutivi, finché Gemini 2.5 continua a rispondere. Il rerouting di dicembre terrà in piedi il servizio, ma solo una migrazione completata a novembre manterrà sotto controllo comportamento e costi.