 AIREITER
Per le code di lavoro ordinario in Devin, SWE-2 Flash sembra la scelta predefinita più sensata: 200 token al secondo a un quinto del costo di SWE-2. La situazione cambia però con carichi simili a Terminal-Bench 4.0, dove SWE-2 Flash si ferma al 20,0%, contro il 27,3% di SWE-2 e oltre il 40% dei modelli migliori.
Verdetto: Flash per la routine, SWE-2 per il 10% più difficile
All'interno di Devin, SWE-2 Flash è la scelta predefinita per il lavoro di sviluppo ad alto volume e con poca ambiguità. Il modello sacrifica qualcosa nei benchmark più specifici, ma offre una generazione 3 volte più veloce e una spesa per task sensibilmente inferiore.
| Tipo di task | Assegnalo a | Perché |
|---|---|---|
| Automazioni, code review, piccole funzionalità, aggiornamenti della documentazione | SWE-2 Flash | Cognition indica SWE-2 Flash per il lavoro quotidiano: qui la velocità conta più della pianificazione approfondita |
| Refactoring estesi, repository nuovi, lavoro da terminale simile a Terminal-Bench-4.0 | SWE-2 | SWE-2 supera SWE-2 Flash con il 27,3% contro il 20,0% in Terminal-Bench 4.0 e il 73,0% contro il 60,1% in DeepSWE 1.1 |
| Attività sensibili per la sicurezza o da eseguire on-premise | Attendi | I pesi di SWE-2 Flash non sono pubblici; per ora è stato promesso soltanto un futuro programma di condivisione sicura |
L'accesso gratuito in Devin Desktop e CLI fino al 30 novembre 2026 rende la prova poco costosa. Conviene avviare le nuove code di lavoro ordinario con SWE-2 Flash e misurare il rework prima di adottarlo stabilmente.
Che cos'è davvero SWE-2 Flash: Inkling-Small con una fase di mid-training
SWE-2 Flash è il modello veloce per il coding di Cognition, costruito su Inkling-Small di Thinking Machines. Alla base c'è un modello mixture-of-experts da 276B di parametri totali e 12B attivi, seguito da una nuova fase di mid-training di Cognition prima del reinforcement learning.
Durante il mid-training, Cognition ha scelto le combinazioni di dati usando grafici sull'efficienza dei token, quindi ha addestrato il modello su alcuni trilioni di token in tre fasi, lasciando per ultima la parte di dati più scarsa. La loss sui dati held-out è scesa con un andamento log-lineare stabile. Il successivo reinforcement learning, basato su task sottoposti ad audit, ha portato Terminal-Bench 4.0 dallo 0,9% al 20,0% e FrontierCode 2.0 dal 3,2% al 24,0%, secondo il post di Cognition del 4 novembre 2026. Cognition dichiara inoltre 200 token al secondo per SWE-2 Flash, contro i 60 token al secondo di SWE-2.
"Cognition latest is here, SWE-2 Flash! 276B total and 12B active parameters flash model. I didn't think we will be seeing a flash model for SWE-2, i'm surprised but appreciated. Looks great on benchmark, it's not that far away from 2.8T SWE-2 model." — @ItsmeAjayKV, prima reazione di un utente reale
I benchmark non raccontano tutti la stessa storia: vanno letti per suite
I risultati di SWE-2 Flash cambiano nettamente da una suite all'altra. Il modello si comporta bene nei task software strutturati, ma è sensibilmente più debole nel lavoro da terminale non guidato: una media complessiva rischierebbe quindi di essere fuorviante.
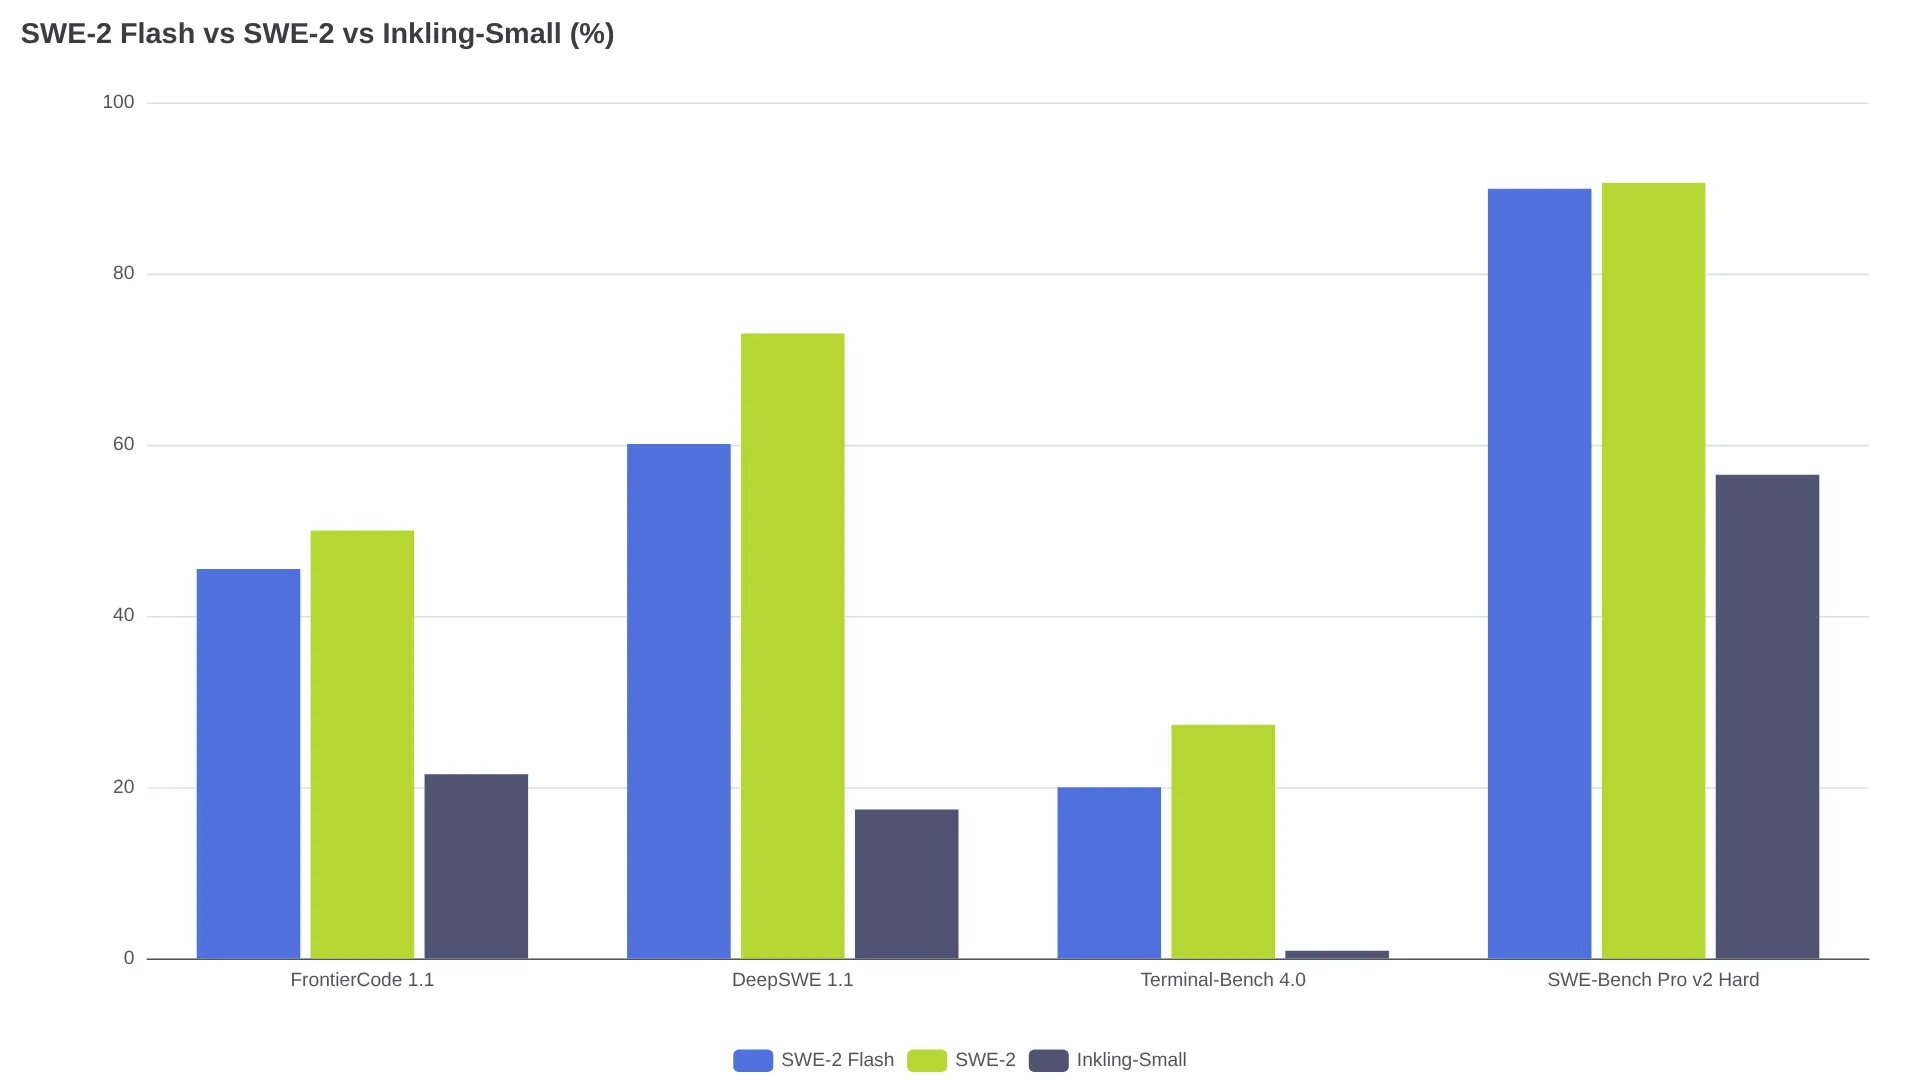
| Benchmark | SWE-2 Flash | SWE-2 (2.8T-A104B) | Inkling-Small | Migliore nella tabella di Cognition |
|---|---|---|---|---|
| FrontierCode 1.1 Main | 45,5% | 50,0% | 21,5% | 50,0% SWE-2 |
| FrontierCode 2.0 | 24,0% | 23,8% | 3,2% | 27,7% Claude Haiku 5.5 |
| DeepSWE 1.1 | 60,1% | 73,0% | 17,4% | 77,0% DeepSeek V4.1 Flash |
| Terminal-Bench 2.1 | 89,2% | 92,8% | 64,7% | 94,4% Claude Haiku 5.5 |
| Terminal-Bench 4.0 | 20,0% | 27,3% | 0,9% | 42,3% DeepSeek V4.1 Flash |
| SWE-Bench Pro v2 Hard | 89,9% | 90,6% | 56,5% | 90,6% SWE-2 |
| SWE-Atlas QA | 50,0% | 56,3% | 27,4% | 71,0% DeepSeek V4.1 Flash |
| ExploitBench | 34,8% | 36,1% | 11,3% | 44,7% GPT-6 Luna |
Il miglioramento ha dei limiti. SWE-2 Flash più che raddoppia il risultato di Inkling-Small in FrontierCode 1.1 Main (45,5% contro 21,5%) e passa dal 56,5% all'89,9% in SWE-Bench Pro v2 Hard, arrivando praticamente al livello di SWE-2, che si ferma al 90,6%.
Flash non risolve i punti deboli di SWE-2. Il buon risultato in SWE-Bench Pro non va estrapolato alle lunghe sessioni da terminale: nella stessa tabella, GLM 5.3 Flash raggiunge il 41,8% in Terminal-Bench 4.0.
La questione dei pesi open va inquadrata. SWE-2 Flash supera Muse Spark Open nella maggior parte delle righe (60,1% contro 60,0% in DeepSWE 1.1, 24,0% contro 6,2% in FrontierCode 2.0), ma DeepSeek V4.1 Flash e GLM 5.3 Flash fanno meglio di SWE-2 Flash in Terminal-Bench 4.0, SWE-Atlas QA e DeepSWE 1.1. Tutti i numeri sono dichiarati dai vendor, ogni modello è stato valutato con la propria configurazione best effort e gli harness non sono uguali tra i diversi vendor.
Cosa significa davvero un quinto del prezzo, se un listino non esiste
Non esiste una tariffa per token perché non esiste un endpoint standalone. L'unico dato economico disponibile è il rapporto sul costo dei task dichiarato da Cognition: ogni rollout di SWE-2 Flash costa un quinto rispetto a SWE-2, includendo modello, harness e stack di serving.
È un rapporto utile, ma incompleto. Cognition non ha mai pubblicato neppure il costo per task di SWE-2; l'analisi di SWE-2 di OrcaRouter ha potuto citare soltanto Fable 5.1 come riferimento, con 3,28 dollari per task FrontierCode a effort medio e 12,83 dollari al livello massimo. I piani Devin indicati erano Free a 0 dollari, Pro a 20 dollari al mese, Max a 200 dollari al mese e Teams a 80 dollari più 40 dollari per postazione: si tratta di abbonamenti, non di token conteggiati a consumo. Un costo per task pari a un quinto non si traduce automaticamente in una fattura Devin più bassa.
La lettura pratica è questa: il periodo gratuito fino al 30 novembre 2026 in Devin Desktop e CLI, disponibile per gli utenti Pro, Max e Teams, è il modo più economico per misurare i consumi reali. Meglio monitorare i task completati ogni settimana e il tasso di rework, non i token. Se SWE-2 Flash chiude i ticket ordinari al primo tentativo a 200 tok/s, il risparmio potrebbe essere persino superiore a quello suggerito dal rapporto 1/5; se invece serve un'escalation a SWE-2, il vantaggio economico scompare.
Chi può usarlo: accesso esclusivo in Devin e un programma per i pesi che non equivale a open weights
Al momento la disponibilità di SWE-2 Flash è limitata. Cognition indica Devin Desktop e Devin CLI come canali attualmente disponibili.
Non esistono un identificativo API pubblico, i pesi su Hugging Face o un percorso per l'uso self-hosted. Cognition giustifica il limite con la gestione del rischio cyber: l'addestramento di SWE-2 Flash ha puntato intenzionalmente sul lavoro di cybersecurity, portando ExploitBench dall'11,3% al 34,8%, e la stessa capacità potrebbe aiutare anche gli attaccanti. La soluzione proposta è un programma per condividere in modo sicuro i pesi con partner industriali e laboratori di ricerca selezionati; i dettagli, spiega Cognition, arriveranno tra poche settimane. Va considerato un piano di accesso controllato, non una promessa di open weights.
Al di fuori di Devin, oggi non è possibile valutare direttamente SWE-2 Flash: non esistono né un endpoint pubblico né un percorso self-hosted.
SWE-2 Flash o SWE-2? Una regola per assegnare ogni task
I volumi vanno a SWE-2 Flash; l'ambiguità va a SWE-2.
Conviene partire con SWE-2 Flash per automazioni, aggiornamenti delle dipendenze, aggiunta di test, risposte alle review, piccole funzionalità con criteri di accettazione chiari e aggiornamenti della documentazione. Sono attività vicine alle suite in cui SWE-2 Flash resta a pochi punti da SWE-2: 24,0% contro 23,8% in FrontierCode 2.0 e 89,9% contro 90,6% in SWE-Bench Pro v2 Hard.
Meglio passare a SWE-2 quando il task richiede pianificazione su più file, lunghe sequenze da terminale o ragionamento vicino all'exploitation. In questi casi i distacchi sono rilevanti: 12,9 punti in DeepSWE 1.1, 6,3 punti in SWE-Atlas QA e 7,3 punti in Terminal-Bench 4.0. La recensione di SWE-2 di HamiRev descrive SWE-2 come un modello ottimizzato per fare meno passaggi e modificare prima il codice rispetto a SWE-1.7: una propensione per i task brevi che SWE-2 Flash porta ancora più avanti.
La strategia più pratica è avviare ogni ticket con SWE-2 Flash, imponendo un limite di due cicli, e passare a SWE-2 se il lavoro si blocca. La valutazione andrà ripetuta dopo il periodo gratuito di novembre, quando la spesa reale in Devin sostituirà il rapporto 1/5. Resta però irrisolto il tema della trasparenza: il programma per la condivisione sicura dei pesi potrebbe abilitare il deployment privato, ma i team soggetti a vincoli normativi non possono pianificare l'adozione di SWE-2 Flash finché non saranno pubblicate condizioni precise.
FAQ su SWE-2 Flash
SWE-2 Flash è disponibile via API?
No, non esiste un'API standalone per SWE-2 Flash. L'accesso avviene tramite Devin Desktop e Devin CLI, gratuitamente per gli utenti Pro, Max e Teams fino al 30 novembre 2026.
SWE-2 Flash ha pesi open?
No. Cognition cita il rischio cyber e promette soltanto un futuro programma di condivisione sicura per partner e laboratori di ricerca selezionati.
Come si confronta SWE-2 Flash con SWE-2?
SWE-2 Flash raggiunge 200 tok/s contro i 60 tok/s di SWE-2 e, secondo il calcolo dei costi per task di Cognition, costa un quinto. SWE-2 resta però avanti in DeepSWE 1.1 (73,0% contro 60,1%) e Terminal-Bench 4.0 (27,3% contro 20,0%).
Qual è la context window di SWE-2 Flash?
Cognition non ha pubblicato le specifiche relative a context window, output massimo o modalità supportate da SWE-2 Flash. Non bisogna quindi dare per scontato che erediti i limiti di Inkling-Small.
Cosa succede dopo il periodo gratuito del 30 novembre?
Cognition non ha indicato come verrà fatturato SWE-2 Flash dopo la promozione. È ragionevole aspettarsi un consumo legato all'abbonamento Devin, anziché un prezzo separato per token.