 AIREITER
Lancé le 5 août 2026, SeedRealtime de ByteDance ne se contente pas de proposer une conversation vocale en temps réel. Ce LLM audio-visuel full-duplex réunit l’audio, la vidéo et le texte dans un modèle de bout en bout, sans module externe chargé de déterminer qui doit prendre la parole. Pour les développeurs, la limite est nette au lancement : pas d’API publique, pas de tarifs, et une intégration réservée aux produits de ByteDance.
SeedRealtime, c’est quoi exactement ?
Conçu par l’équipe Seed de ByteDance, le modèle fusionne l’audio, la vidéo et le texte au sein d’une architecture unique. Il perçoit, interprète, décide et répond à partir de flux multimodaux continus, plutôt que de faire circuler les données entre plusieurs étapes distinctes.
ByteDance résume son fonctionnement par la formule « regarder, écouter et parler en même temps ». Chaque réponse s’appuie ainsi à la fois sur ce que le modèle entend et sur ce qu’il voit. SeedRealtime rejoint la gamme de modèles Seed, aux côtés de Seed2.1 — la famille de LLM qui alimente Doubao —, de Seedance pour la génération vidéo, de Seedream pour l’image, de Seed Audio 1.0 pour l’audio et de Seed GR-RL pour la robotique.
Le modèle échappe aux catégories habituelles : ce n’est ni un simple système de TTS, puisqu’il comprend aussi la parole, ni un modèle de vision classique, puisque sa perception visuelle sert la conversation. Et ce n’est pas non plus un énième assistant vocal temps réel.
Le full-duplex, au cœur de la promesse
Le « full-duplex » désigne la capacité à écouter et répondre simultanément, en suivant continuellement qui parle et à quel moment intervenir, comme dans une conversation humaine. SeedRealtime affirme y parvenir en unifiant son, image, temporalité et expression dans un seul modèle de bout en bout, au lieu d’assembler plusieurs briques.
L’IA conversationnelle temps réel oscille jusqu’ici entre deux approches. Les systèmes en cascade enchaînent un ASR (reconnaissance vocale) avec un LLM ou un VLM, puis un TTS (synthèse vocale). Leur architecture modulaire facilite le débogage, mais chaque passage ajoute de la latence et fait perdre de l’information : ton, chevauchements de parole, accent ou contexte visuel disparaissent souvent dès l’étape ASR. Les modèles vocaux de bout en bout évitent ces transferts et produisent des échanges plus naturels, mais la plupart s’appuient encore sur un détecteur d’activité vocale externe, ou VAD, pour savoir à qui revient le tour de parler. Ils restent donc, dans les faits, semi-duplex : une question, une réponse.
SeedRealtime regroupe perception, compréhension, prise de décision et expression dans un même modèle, exécutées en parallèle sur des flux audio-visuels continus. Aucun VAD externe ne décide des tours de parole.
| Approche | Fonctionnement | Duplex | Gestion des tours de parole | Principale limite |
|---|---|---|---|---|
| En cascade (ASR + LLM/VLM + TTS) | Modules enchaînés séquentiellement | Semi-duplex | Fin de parole fixe | Latence et perte d’information à chaque transfert |
| De bout en bout + VAD externe | Un modèle avec détecteur de tour externe | Semi-duplex | VAD externe | Fonctionne toujours sur le schéma une question, une réponse |
| SeedRealtime | Modèle audio-visuel unifié de bout en bout | Full-duplex (revendiqué) | Interne et multimodale | Très récent ; capacités décrites par l’éditeur |
La vidéo rend l’exercice particulièrement difficile, car elle ne comporte pas de pauses naturelles comme la parole. Le modèle doit décider en permanence quel objet observer, quelle voix compte et s’il est pertinent d’intervenir, sans se laisser déclencher par les bruits de fond.
Les trois usages mis en avant par ByteDance
ByteDance répartit les comportements de SeedRealtime en trois capacités : compréhension conjointe de l’audio et de la vidéo, interaction proactive et rythme conversationnel naturel. L’entreprise les illustre par des scénarios concrets plutôt que par des tableaux de benchmarks.
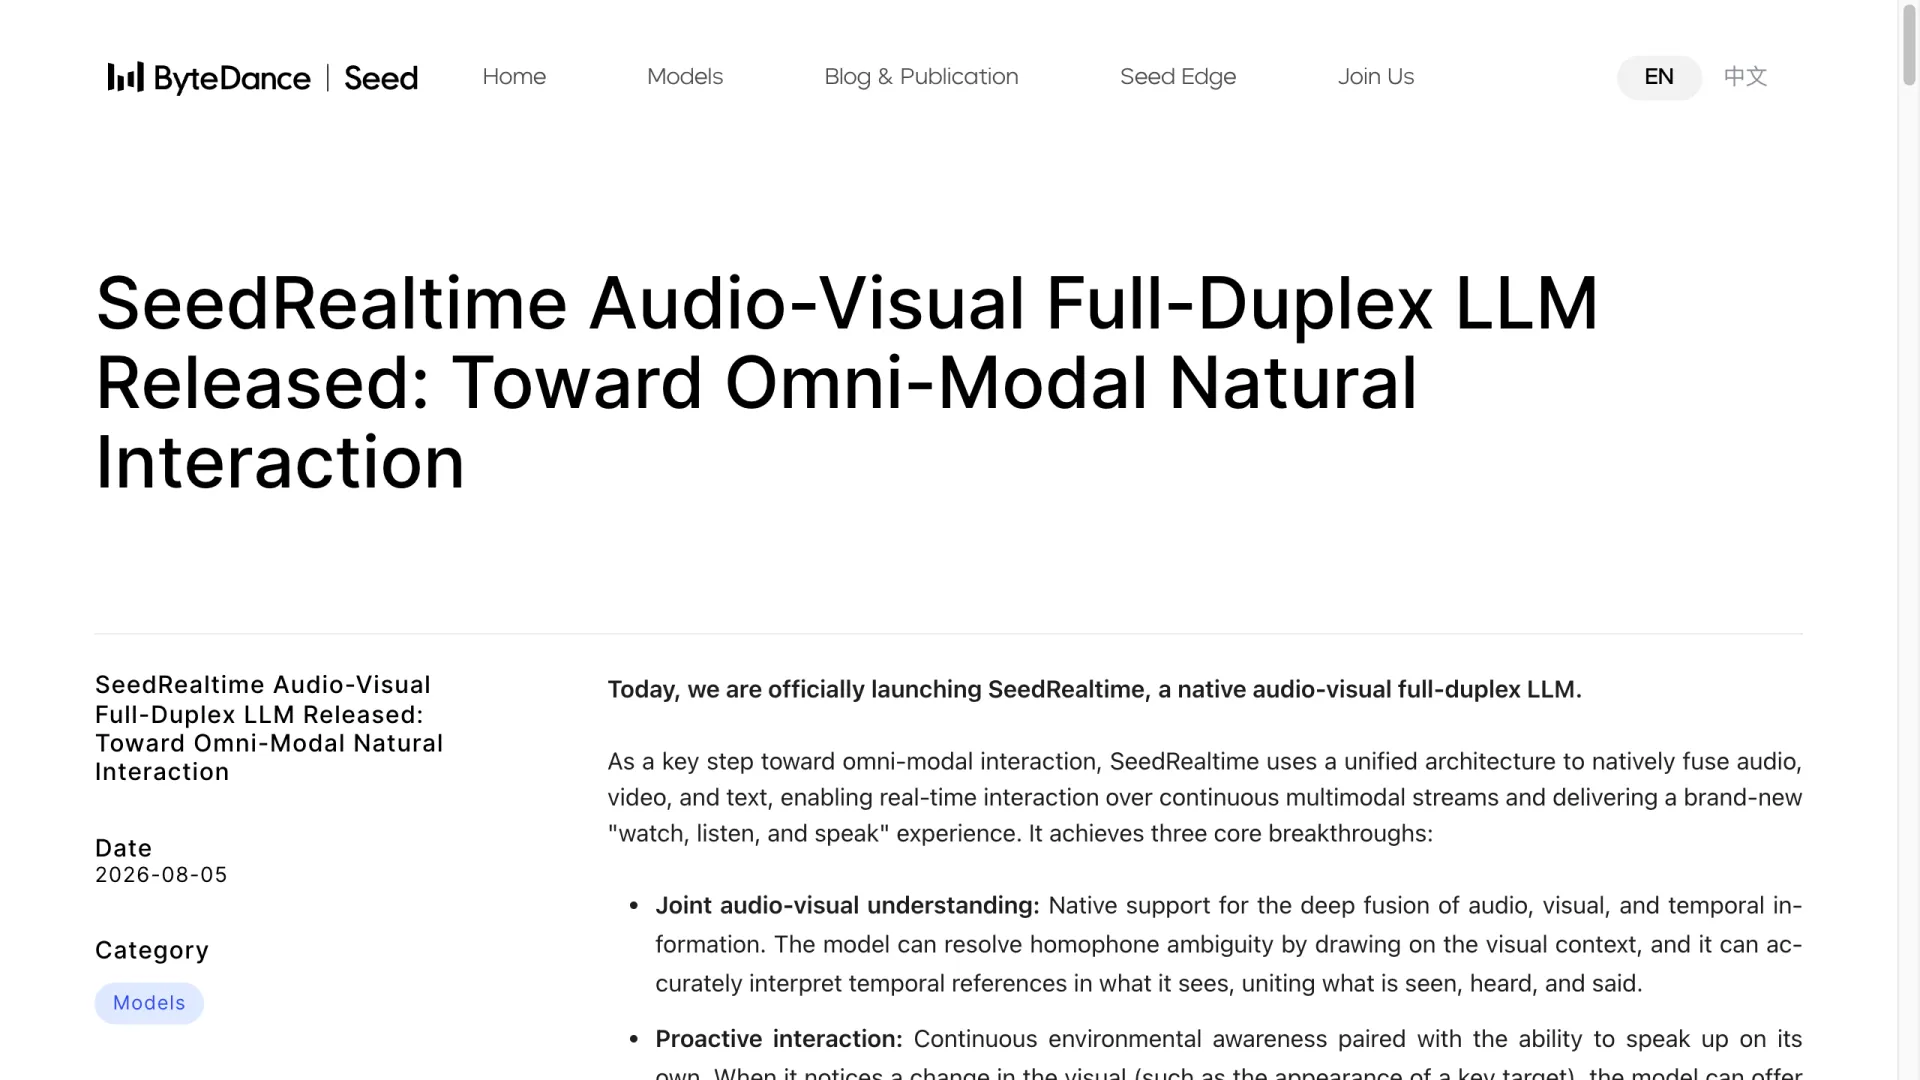
Comprendre simultanément l’audio et la vidéo
Le modèle s’appuie sur la scène en direct pour lever les ambiguïtés de la parole. Si une personne demande « comment faire ça ? », SeedRealtime combine l’écran, les gestes, le regard et les actions précédentes afin d’identifier ce que désigne « ça ».
Dans une démonstration de ByteDance, un utilisateur présente successivement quatre amis lors d’un dîner. SeedRealtime associe les noms aux visages, puis relie chaque voix à la bonne personne tandis que le groupe organise un voyage malgré des préférences incompatibles : l’un veut la plage, l’autre déteste la chaleur, un troisième est allergique aux fruits de mer. Dans un restaurant du Sichuan, il lit à la caméra un menu uniquement en chinois, recommande des plats en anglais et explique pourquoi le « porc parfumé au poisson » ne contient pas de poisson.
Intervenir de manière proactive
Le modèle peut prendre la parole de lui-même lorsqu’un élément de la scène évolue, sans attendre une requête. En visitant un musée, un utilisateur lui demande de le prévenir lorsqu’il verra le support en bronze représentant un tigre dévorant un cerf. SeedRealtime surveille alors le flux de la caméra jusqu’à l’apparition de l’objet, puis fournit le rappel accompagné d’informations sur la pièce.
Lorsqu’il voit une personne verser des grains de café entiers directement dans un porte-filtre, il intervient : il faut d’abord les moudre finement. Après l’extraction, il conseille de raccourcir la prochaine extraction de deux à trois secondes en fonction de la couleur de la crema. Les appels d’outils, comme les recherches ou les réservations, s’intègrent à ces réponses au lieu d’être traités dans une étape séparée.
Un timing conversationnel plus naturel
SeedRealtime choisit de parler, de faire une pause ou de se taire selon le contexte multimodal, tout en évitant les faux déclenchements. Dans un aéroport de Pékin bondé, il ignore la mention désinvolte par un compagnon du « vol du vieux Li ». Mais lorsqu’on l’interroge, il restitue les informations du tableau des départs qui ne sont plus affichées à l’écran, puis consulte Internet pour localiser le carrousel à bagages. À la maison, alors qu’un parent parle au téléphone en arrière-plan, il reste concentré sur la correction de la prononciation anglaise d’un enfant.
L’évaluation humaine de bout en bout menée par ByteDance indique que SeedRealtime réduit environ de moitié les problèmes de rythme des conversations audio-visuelles par rapport aux modèles en cascade : moins d’interruptions au milieu d’une phrase, moins de réponses lentes après une pause et moins de faux déclenchements liés au bruit. Le taux de tours de parole menés à terme de façon fluide et complète augmente également. Il s’agit toutefois d’évaluations réalisées par l’éditeur, et non de benchmarks indépendants.
SeedRealtime face à GPT-4o Realtime, Gemini Live et aux architectures en cascade
La question pratique est de savoir ce qui distingue SeedRealtime des systèmes temps réel déjà accessibles aux développeurs. La réponse la plus honnête est que la majorité des API « realtime » existantes sont centrées sur l’audio, alors que SeedRealtime se différencie par sa promesse de modéliser conjointement l’audio et la vidéo en full-duplex.
La Realtime API d’OpenAI et Gemini Live de Google, une fonction grand public dotée de sa Live API pour les développeurs, proposent des interfaces conversationnelles temps réel à faible latence. Elles restent toutefois centrées sur l’audio — parole entrante, parole sortante —, la vision étant traitée séparément et la prise de tour dépendant encore d’une détection de fin de parole ou d’un VAD. Le positionnement de SeedRealtime repose sur l’ensemble : fusion native audio-vidéo, timing full-duplex décidé au sein du modèle, interventions proactives et usage d’outils intégré à la conversation.
| Modèle | Modalités natives | Duplex | Gestion des tours de parole | Proactivité / usage d’outils | API publique |
|---|---|---|---|---|---|
| SeedRealtime | Audio + vidéo + texte (fusionnés) | Full-duplex (revendiqué) | Interne et multimodale | Oui, intégré | Non (au lancement) |
| GPT-4o Realtime API | Audio + texte | Temps réel, géré par VAD | Détection de fin de parole externe | Via les outils de fonction | Oui |
| Gemini Live / Live API | Audio + texte (caméra dans l’application grand public) | Temps réel, géré par VAD | Détection de fin de parole externe | Limité | Oui (Live API, audio) |
| Architecture en cascade | Texte (audio via ASR/TTS) | Semi-duplex | Fixe | Personnalisé | À construire soi-même |
Les avantages de SeedRealtime reposent sur les démonstrations et évaluations de ByteDance. Aucune comparaison directe publiée ne l’oppose à GPT-4o Realtime ou Gemini Live. Il faut donc lire le tableau ci-dessus comme un positionnement architectural, et non comme une supériorité mesurée.
Les développeurs peuvent-ils déjà utiliser SeedRealtime ?
Au moment de son lancement, le 5 août 2026, SeedRealtime n’est pas disponible sous la forme d’une API pour développeurs. ByteDance indique qu’il est « entièrement déployé », mais cela désigne son intégration dans les produits de l’entreprise, et non un endpoint ouvert accessible à tous.
Au lancement, SeedRealtime ne dispose d’aucune API publique, d’aucune page tarifaire ni de documentation développeur. La branche d’API commerciale de ByteDance est Volcengine (火山引擎), qui héberge la famille Doubao : les LLM Seed 2.1 Pro et Turbo, Seed-ASR, Seed-TTS et d’autres modèles. SeedRealtime n’y figure pas au lancement, et les relais tiers ne proposent pas d’alternative audio-visuelle temps réel équivalente.
Pour les équipes qui ont besoin d’un endpoint temps réel dès aujourd’hui, les options réalistes à court terme restent centrées sur l’audio : Realtime API d’OpenAI, Live API de Google ou une architecture en cascade développée en interne. SeedRealtime est surtout une architecture à surveiller. ByteDance n’a annoncé aucune date pour une API temps réel sur Volcengine ou BytePlus.
FAQ
SeedRealtime est-il accessible au public ?
Il est déployé dans les produits de ByteDance depuis son lancement du 5 août 2026, mais il n’existe pas d’application publique ni d’endpoint appelé SeedRealtime auquel il soit possible de s’inscrire.
SeedRealtime dispose-t-il d’une API ?
Pas au lancement. ByteDance n’a publié ni accès API, ni tarifs, ni documentation développeur. Son futur emplacement le plus probable serait la famille d’API Doubao de Volcengine, qui ne référence pas encore SeedRealtime.
En quoi SeedRealtime diffère-t-il de GPT-4o Realtime ?
La Realtime API de GPT-4o est centrée sur l’audio : parole en entrée, parole en sortie. SeedRealtime affirme modéliser conjointement l’audio et la vidéo dans un unique modèle full-duplex, qui décide aussi de son propre timing et intervient proactivement. Il n’existe pas encore de comparaison indépendante directe.
SeedRealtime est-il gratuit ?
Au lancement, il n’existe ni produit autonome ni API assortie d’un tarif. La question du gratuit ou du payant ne se pose donc pas encore : il s’agit d’une capacité intégrée aux produits de ByteDance.
Que signifie « full-duplex » pour un modèle d’IA ?
Cela signifie que le modèle peut écouter et répondre simultanément, tout en suivant en continu l’état de la conversation. Il décide lui-même quand parler ou se taire, plutôt que de fonctionner selon des tours rigides de type une question, une réponse.
À lire aussi
- Tarifs de l’OpenAI Realtime API — l’endpoint audio temps réel que les développeurs peuvent réellement appeler aujourd’hui
- Qwen Audio 3 Realtime — un autre modèle vocal temps réel à comparer