 AIREITER
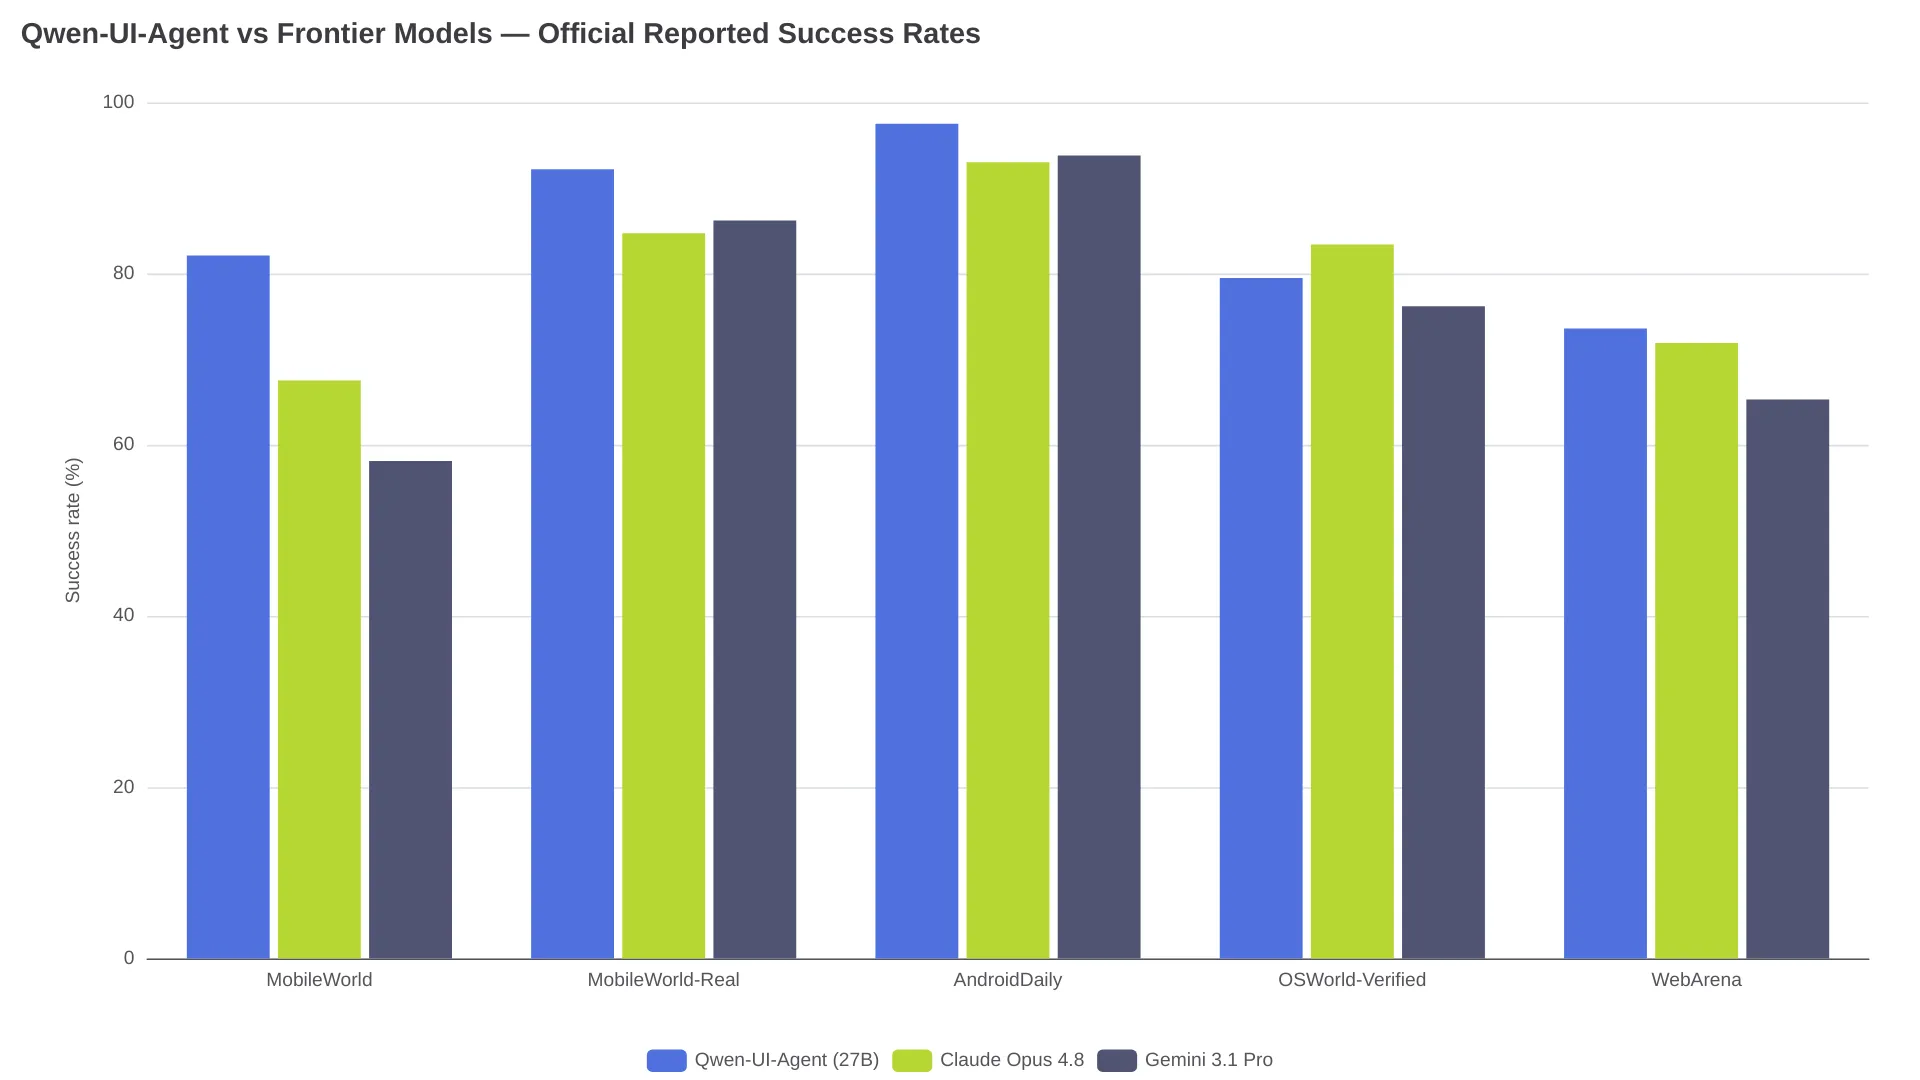
Avec 92.2% sur MobileWorld-Real exécuté sur appareils physiques et 97.5% sur AndroidDaily, Qwen-UI-Agent signe les meilleurs résultats mobiles de ses comparatifs publiés. Mais le modèle 27B à l’origine de ces scores ne dispose ni de poids publics confirmés ni d’API. À ce stade, on peut consulter le rapport technique, voir les démonstrations et télécharger uniquement les prédécesseurs MAI-UI de plus petite taille. C’est tout l’enjeu de cette sortie : des résultats de premier plan, mais un accès très limité. Voici donc l’ensemble des scores officiels, suivi d’un inventaire précis de ce qui est réellement disponible.
Les résultats officiels de Qwen-UI-Agent en un coup d’œil
Qwen-UI-Agent est un agent GUI de fondation publié par l’équipe Tongyi-MAI d’Alibaba dans un rapport technique daté du 30 juillet 2026 (arXiv 2607.28227). Un même modèle couvre les environnements mobiles, l’usage d’ordinateurs, le web et DeepSearch, au moyen d’un espace d’actions unifié pour les opérations GUI, l’exécution CLI et les séquences d’actions groupées. Sur la page de résultats officielle, Qwen-UI-Agent arrive en tête de tous les benchmarks mobiles et de grounding affichés, se classe deuxième sur OSWorld-Verified et troisième sur le test longue durée OSWorld-v2. Le rapport évalue des variantes 27B, 35B-A3B et 4B ; les scores ci-dessous correspondent au modèle phare 27B.
Sur mobile, une avance revendiquée
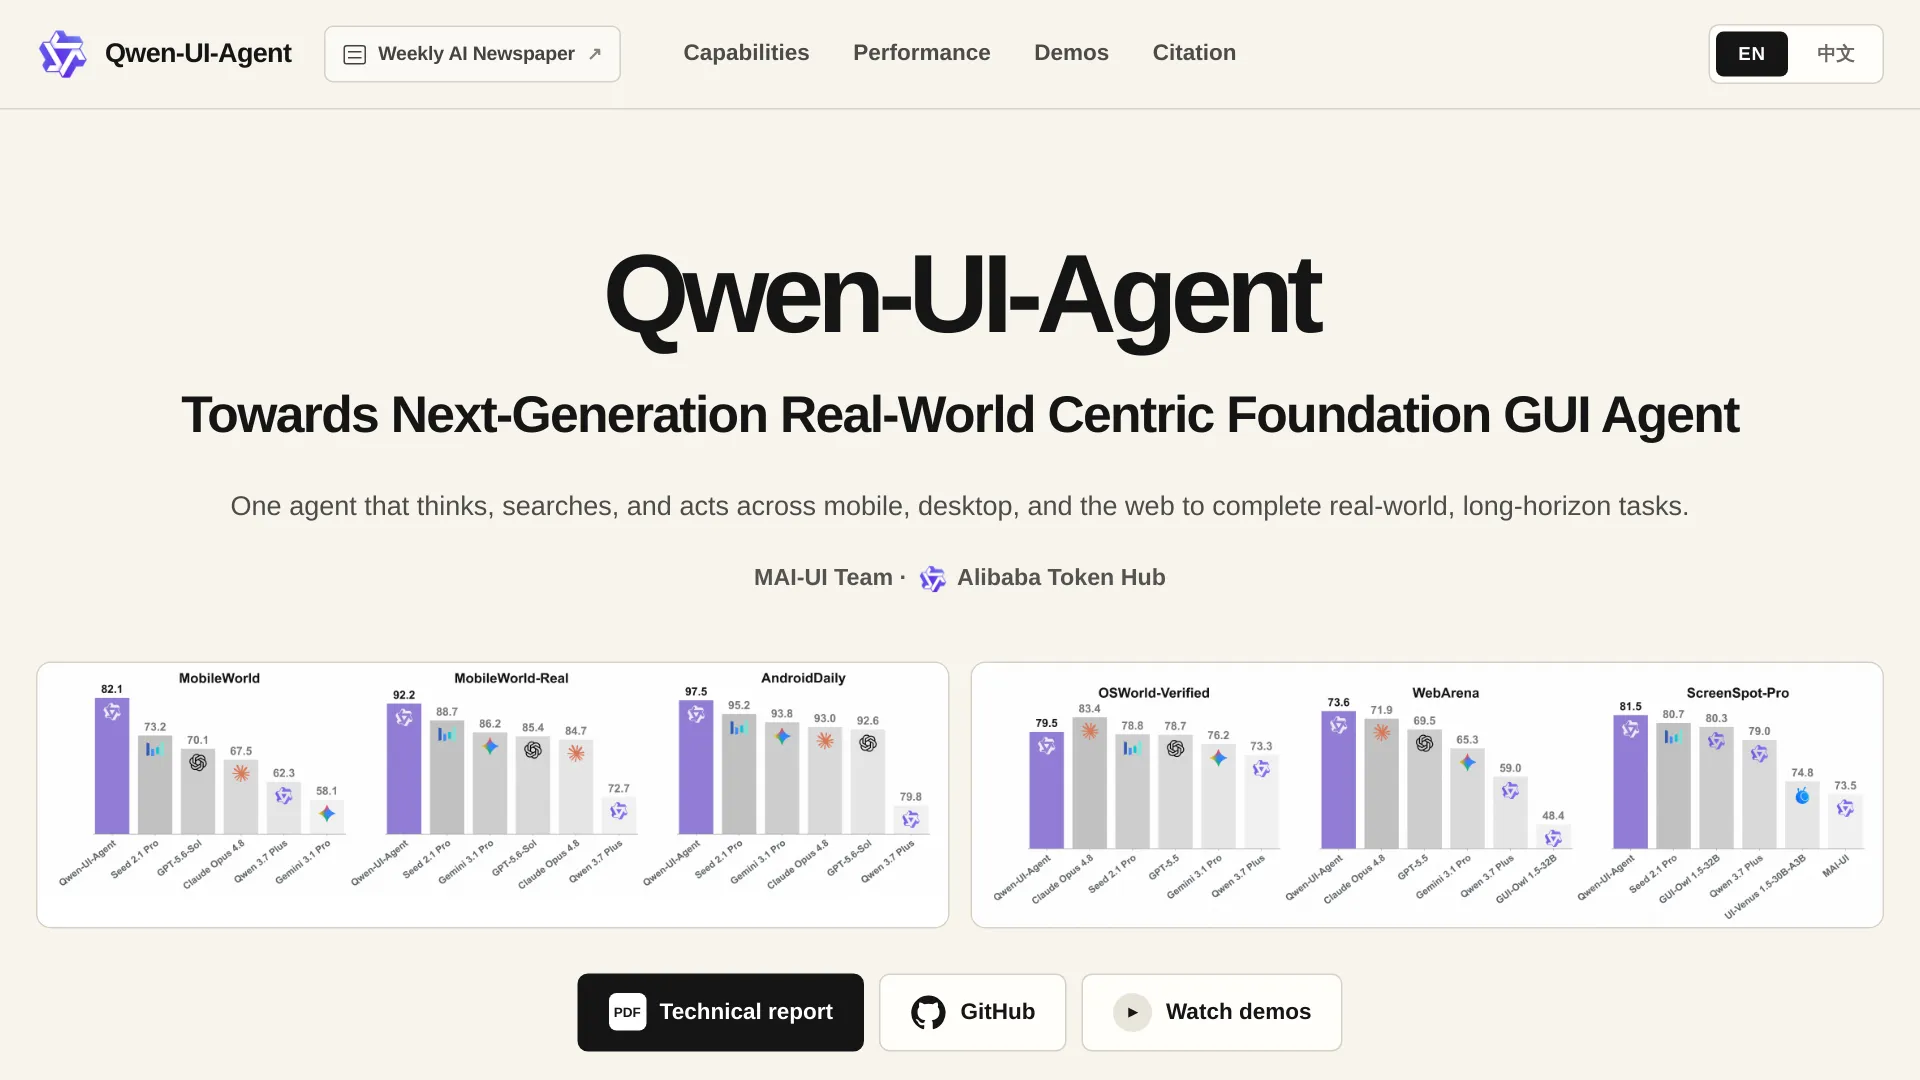
C’est sur mobile que le rapport revendique l’état de l’art, avec un écart difficile à minimiser. Sur la partition GUI-only de MobileWorld, les 82.1% de Qwen-UI-Agent devancent de 8.9 points le modèle généraliste suivant, Seed 2.1 Pro à 73.2%, et de 38.2 points le meilleur agent GUI spécialisé, GUI-Owl-1.5-32B-Instruct à 43.9%.
| Modèle | MobileWorld (GUI-only) | MobileWorld-Real | AndroidDaily |
|---|---|---|---|
| Qwen-UI-Agent (Alibaba) | 82.1 | 92.2 | 97.5 |
| Seed 2.1 Pro (ByteDance) | 73.2 | 88.7 | 95.2 |
| Claude Opus 4.8 (Anthropic) | 67.5 | 84.7 | 93.0 |
| Gemini 3.1 Pro (Google) | 58.1 | 86.2 | 93.8 |
| Qwen 3.7 Plus (Alibaba) | 62.3 | 72.7 | 79.8 |
Les tableaux officiels indiquent GPT-5.6 Sol pour les lignes mobiles (70.1 / 85.4 / 92.6), et GPT-5.5 pour les lignes desktop. Un détail à garder en tête avant de citer un chiffre « GPT » isolé.
MobileWorld-Real est le benchmark phare conçu par les auteurs eux-mêmes : 409 tâches de bout en bout dans 104 applications Android réelles, réparties sur sept domaines d’usage quotidien. Les tests sont menés sur des appareils physiques, avec de vrais comptes et des interruptions du monde réel, puis évalués par un juge à vote majoritaire composé de cinq VLM.
Usage d’ordinateur : solide, mais pas premier
Sur desktop, le terme « compétitif » employé dans le rapport mérite d’être lu avec nuance. Les 79.5% de Qwen-UI-Agent sur OSWorld-Verified le placent au deuxième rang, à 3.9 points de Claude Opus 4.8. Sur OSWorld-v2, orienté tâches longues, le score de 40.0% mesure une progression partielle : le taux de réussite binaire est de 13.9%. Claude Opus 4.8, à 54.8, et GPT-5.5, à 49.5, se situent nettement devant.
| Modèle | OSWorld-Verified | OSWorld-v2 (partiel) | OSWorld-v2 (binaire) |
|---|---|---|---|
| Claude Opus 4.8 | 83.4 | 54.8 | non communiqué |
| Qwen-UI-Agent | 79.5 | 40.0 | 13.9 |
| Seed 2.1 Pro | 78.8 | non communiqué | non communiqué |
| GPT-5.5 | 78.7 | 49.5 | 13.0 |
| MiniMax M3 | non communiqué | 22.3 | non communiqué |
Le gain d’efficacité est toutefois tangible : les actions groupées ramènent la moyenne à 135.8 étapes par tâche, contre 326.7 pour MiniMax M3 et 173.5 pour Qwen 3.7 Plus. Dans le même temps, le modèle conserve plus de 17 points d’avance sur tous les modèles à poids ouverts en progression partielle. Sur OSWorld-v2, les commandes CLI représentent plus de 50% des opérations de l’agent : l’approche hybride GUI+CLI produit ici un effet mesurable.
Web et DeepSearch
Sur WebArena, Qwen-UI-Agent prend la tête avec 73.6%, devant Claude Opus 4.8 à 71.9, GPT-5.5 à 69.5 et Gemini 3.1 Pro à 65.3. Côté recherche, il atteint 64.1 sur BrowseComp, contre 61.0 pour la base Qwen3.5-27B, et 75.0 sur BrowseComp-ZH, contre 62.1. L’entraînement DeepSearch ne semble donc pas améliorer uniquement le pointage à l’écran.
Grounding GUI : carton plein
Le grounding, autrement dit la capacité à cliquer sur le bon pixel à partir d’une instruction visuelle, est le domaine où Qwen-UI-Agent fait carton plein : selon la page de résultats officielle, il arrive premier sur chacun des benchmarks de grounding présentés.
| Benchmark | Qwen-UI-Agent | Meilleur concurrent |
|---|---|---|
| ScreenSpot-Pro (sans zoom) | 76.6 | 72.9 (GUI-Owl-1.5) |
| ScreenSpot-Pro (zoom-in) | 81.5 | 80.7 (Seed 2.1 Pro) |
| SS-V2 | 97.5 | 96.6 (Seed 2.1 Pro / Qwen 3.7 Plus) |
| MM-GUI-L2 | 92.6 | 91.3 (MAI-UI) |
| OSW-G-R | 78.5 | 78.2 (Qwen 3.7 Plus) |
| UI-Vision | 70.0 | 68.0 (Qwen 3.7 Plus) |
Le coût du généraliste reste limité
Les modèles spécialisés GUI perdent souvent leurs compétences de modèles de langage. Qwen-UI-Agent échappe largement à ce travers : il obtient 86.5 sur MMLU-Pro, contre 86.0 pour Qwen3.5-27B, et 90.2 sur IFEval, contre 90.4. Face aux modèles spécialisés, l’écart devient considérable.
| Benchmark | Qwen-UI-Agent | Qwen3.5-27B | UI-Venus 30B-A3B | GUI-Owl 32B | OpenCUA-72B |
|---|---|---|---|---|---|
| Tau2-Bench | 89.9 | 89.2 | 22.7 | 6.1 | 14.4 |
| Terminal-Bench 2.0 | 50.1 | 41.1 | 3.2 | 0.0 | 9.0 |
| BFCL-v4 | 74.2 | 71.3 | 19.8 | 32.7 | 28.3 |
| BrowseComp | 64.1 | 61.0 | non communiqué | non communiqué | non communiqué |
| QwenClawBench | 44.2 | 48.5 | 6.4 | 5.1 | 11.4 |
La seule baisse visible face à son propre modèle de base concerne QwenClawBench, à 44.2 contre 48.5. À noter également : la page officielle précise que ces scores de capacités plus générales ont été reproduits dans l’environnement d’évaluation des auteurs.
Comment Qwen-UI-Agent a été entraîné
D’après le rapport technique, les données d’entraînement de Qwen-UI-Agent proviennent d’une flotte d’appareils réels : plus de 100 téléphones physiques couvrant plus de 150 applications. Cet ensemble alimente une boucle de données pilotée par agent, capable de construire et de diagnostiquer ses propres tâches. Un fine-tuning supervisé est suivi d’un RL multi-étapes sur des trajectoires de plus de 100 tours, déployées dans plus de 10,000 environnements concurrents.
Quelle confiance accorder à ces scores ?
La page officielle apporte elle-même trois réserves importantes, à associer à tout chiffre cité. Premièrement, MobileWorld-Real est un benchmark créé par les auteurs. Deuxièmement, les scores de référence marqués d’un poignard ont été reproduits par les auteurs dans leur propre environnement : le harness, le juge, le simulateur et les sous-ensembles de tâches peuvent différer des évaluations officielles publiées par les autres fournisseurs. Enfin, le 40.0% sur OSWorld-v2 correspond à une progression partielle, et non à un taux de réussite. (Source : les notes de la page de résultats officielle et le rapport technique.)
« Le nouvel agent GUI d’Alibaba gagne sur téléphone et cale sur desktop. » — @Daily_AI_Brief sur X, qui souligne également qu’« Alibaba a évalué toutes les références dans son propre environnement ».
Des lectures indépendantes sur X arrivent à la même conclusion. Une analyse en japonais de @itarutomy relève l’avance sur mobile réel tout en rappelant que les résultats desktop restent une deuxième place. Le fil d’annonce officiel de Pengxiang Li, de Tongyi Lab (@oliverlee1999), constitue la source primaire pour la sortie elle-même. En pratique, MobileWorld-Real doit être considéré comme une affirmation solide qui attend encore une reproduction indépendante ; OSWorld-Verified est une comparaison plus facilement transposable, car ce n’est pas un benchmark introduit par les auteurs.
Comment accéder à Qwen-UI-Agent aujourd’hui
Qwen-UI-Agent est pour l’instant une sortie de recherche : un article, une page de projet et des dépôts de code, mais aucun checkpoint public confirmé pour le modèle lui-même. Voici ce que contient chaque ressource accessible publiquement.
Inventaire des ressources disponibles
| Ressource | Lien | Contenu |
|---|---|---|
| Rapport technique | arxiv.org/abs/2607.28227 | Article complet, soumis le 30 juillet 2026 ; PDF, HTML et source TeX |
| Page du projet | tongyi-mai.github.io/Qwen-UI-Agent | Démonstrations de capacités, graphiques complets des benchmarks, informations de citation |
| Dépôt MAI-UI | github.com/Tongyi-MAI/MAI-UI | Dépôt Apache-2.0, renommé pour Qwen-UI-Agent ; liens vers les checkpoints Hugging Face MAI-UI-8B et MAI-UI-2B publiés en décembre 2025 |
| Dépôt Qwen-UI-Agent | github.com/Tongyi-MAI/Qwen-UI-Agent | Source du site web uniquement ; le dépôt indique ne contenir ni modèle, ni code d’entraînement, ni implémentation d’agent |
Le dépôt MAI-UI est le canal officiel de continuité : il a annoncé Qwen-UI-Agent le 30 juillet 2026 et renvoie actuellement vers les seuls checkpoints téléchargeables de cette lignée.
Ce qu’il en est des poids
Les seuls checkpoints téléchargeables sont MAI-UI-8B et MAI-UI-2B, leurs prédécesseurs de décembre 2025, accessibles via les références Hugging Face du dépôt MAI-UI. Aucun checkpoint Qwen-UI-Agent 27B, 35B-A3B ou 4B n’est confirmé comme public. Cette disponibilité a été vérifiée dans les dépôts officiels et sur la page du projet fin août 2026, sans qu’aucune publication ne soit apparue. Les liens vers les checkpoints MAI-UI ou vers le dépôt de source du site ne doivent donc pas être confondus avec des poids du modèle Qwen-UI-Agent.
Ni API ni auto-hébergement, pour le moment
Aucun endpoint API public, produit hébergé ou package vLLM/Ollama de Qwen-UI-Agent n’apparaît sur les canaux officiels. Les options concrètes sont donc limitées : pour des workflows desktop à mettre en production, les résultats rapportés sur OSWorld favorisent Claude Opus 4.8 ; pour expérimenter avec un agent GUI à poids ouverts, il faut utiliser MAI-UI 2B/8B avec son propre harness — et il s’agit bien de MAI-UI, pas de Qwen-UI-Agent. Consultez les dépôts officiels Tongyi-MAI et les canaux Qwen pour les annonces de sortie. Pour la gamme Qwen généraliste, qui propose bien des API, le catalogue de modèles Qwen d’AIReiter suit les endpoints et tarifs actuels.
La place de Qwen-UI-Agent dans la lignée
Qwen-UI-Agent constitue la troisième génération d’agents GUI d’Alibaba : UI-TARS a ouvert l’approche GUI de Qwen en 2025 ; MAI-UI (arXiv 2512.22047, décembre 2025) a introduit la boucle de données centrée sur le monde réel et publié les poids 2B/8B ; Qwen-UI-Agent porte cette recette à 27B, avec une exécution hybride GUI+CLI. Claude Opus 4.8 domine les deux métriques OSWorld des tableaux ci-dessus.
FAQ sur Qwen-UI-Agent
Qwen-UI-Agent est-il open source ?
Les dépôts de code sont sous licence Apache-2.0 et le rapport est public, mais le modèle lui-même n’est pas confirmé comme étant à poids ouverts. Seuls les checkpoints des prédécesseurs MAI-UI-8B et MAI-UI-2B sont téléchargeables sur Hugging Face depuis décembre 2025. Aucun checkpoint Qwen-UI-Agent 27B, 35B-A3B ou 4B n’avait de sortie publique confirmée au moment de la rédaction.
Peut-on exécuter Qwen-UI-Agent localement aujourd’hui ?
Non. Aucune installation locale vérifiée n’existe : pas de checkpoint, pas de package GGUF ou Ollama, pas de recette vLLM. Les expérimentations locales se limitent à MAI-UI 2B/8B avec votre propre harness.
Existe-t-il une API Qwen-UI-Agent ?
Aucun endpoint public ni produit hébergé n’a été annoncé. Consultez les dépôts GitHub officiels de Tongyi-MAI et les canaux de l’équipe Qwen pour les annonces de sortie.
Comment Qwen-UI-Agent se compare-t-il à Claude Opus 4.8 pour l’usage d’ordinateur ?
Claude Opus 4.8 devance Qwen-UI-Agent sur OSWorld-Verified, 83.4 contre 79.5, et sur la progression partielle OSWorld-v2, 54.8 contre 40.0. À l’inverse, Qwen-UI-Agent est devant sur WebArena, 73.6 contre 71.9, ainsi que sur tous les benchmarks mobiles affichés. Pour le travail desktop longue durée, Claude reste actuellement le meilleur choix ; les chiffres rapportés de Qwen-UI-Agent sont les plus convaincants pour les usages d’abord mobiles.
Qu’est-ce que MobileWorld-Real ?
Il s’agit d’un benchmark Android sur appareils réels créé par les auteurs de Qwen-UI-Agent : 409 tâches réparties sur 104 applications actives dans sept domaines d’usage quotidien, évaluées par un juge à vote majoritaire composé de cinq VLM. Les résultats sont auto-déclarés et attendent une reproduction indépendante.
Ce qui pourrait faire évoluer l’évaluation
Trois signaux changeraient sensiblement cette analyse :
| Signal | Pourquoi c’est important |
|---|---|
| Un checkpoint Qwen-UI-Agent publié via la présence Hugging Face de Tongyi-MAI | Transformerait la sortie de recherche en option exploitable et déclencherait des mesures tierces |
| Une reproduction d’OSWorld-Verified hors du harness d’Alibaba | Permettrait de vérifier si le 79.5% se maintient au-delà de l’environnement des auteurs |
| Une surface produit quelconque : API, intégration à l’application Qwen ou aperçu | Ferait passer la comparaison des tableaux d’article aux arbitrages de production |
D’ici là, le compromis non résolu demeure : les avances sur les usages mobiles dans les comparatifs publiés à ce jour sont auto-déclarées, sur un benchmark construit par cette même équipe.
À lire aussi : le nouveau modèle généraliste phare d’Alibaba et le statut de ses poids ouverts sont détaillés dans Qwen3.8-Max open weights, tandis que les coûts des endpoints sont couverts dans le guide tarifaire de l’API Qwen3.8-Max.