 AIREITER
En août 2026, le match Qwen 3.8 vs Kimi K3 ne se résume plus à désigner un vainqueur. Les poids des deux familles sont téléchargeables et leurs modèles phares sont disponibles en disponibilité générale, mais le choix dépend désormais du mode de déploiement : Kimi K3 conserve le meilleur bilan vérifié pour les agents de code, Qwen 3.8 Max est le moins cher au token, tandis que le Qwen 27B sous Apache-2.0 tient sur un GPU grand public. Le point à ne pas perdre de vue : le modèle phare « ouvert » de Kimi représente un checkpoint annoncé à 1,56 To. Des poids ouverts ne signifient donc pas nécessairement un auto-hébergement accessible.
Ce que Qwen 3.8 et Kimi K3 proposent réellement
Kimi K3 (Moonshot AI) est arrivé le 16 juillet 2026 comme modèle phare unique : un MoE de 2,8 billions de paramètres, dont 104B actifs par token, avec Kimi Delta Attention et Gated MLA, une fenêtre de contexte de 1 048 576 tokens et la vision native. Les poids et le rapport technique ont suivi le 27 juillet sous la licence propriétaire Kimi K3 License. Comme le rappelle le comparatif d’Emergent, ses conditions visent les grands revendeurs commerciaux et les produits dépassant 100 millions d’utilisateurs mensuels.
Alibaba a répondu avec une gamme plutôt qu’un modèle isolé. Qwen 3.8 Max a été présenté le 19 juillet, est devenu disponible en disponibilité générale sur QwenCloud le 3 août avec 2,4T paramètres au total et environ 95B actifs, puis ses poids ont été publiés sur Hugging Face autour du 12 août sous le nom Qwen/Qwen3.8-2.4T-A95B, avec une licence propriétaire qwen3.8-max. Quelques jours plus tard, Qwen/Qwen3.8-27B est arrivé : un modèle vision-langage dense de 27B sous Apache-2.0, avec 262K tokens de contexte natif, extensible à 1M via YaRN (dates des 13 et 14 août selon Yotta Labs).
| Kimi K3 | Qwen 3.8 Max | Qwen3.8-27B | |
|---|---|---|---|
| Paramètres totaux / actifs | 2,8T / 104B | 2,4T / ~95B | 27B dense |
| Contexte | 1 048 576 | 1M (991,8K d’entrée max.) | 262K natif, 1M via YaRN |
| Licence | Kimi K3 License (propriétaire) | Licence propriétaire qwen3.8-max | Apache-2.0 |
| Poids disponibles depuis | 27 juillet 2026 | ~12 août 2026 | ~13–14 août 2026 |
| Entrée vision | Texte + image (officiel) | Texte, image, vidéo via API | Texte, image, vidéo |
Moonshot aurait par ailleurs suspendu les nouvelles souscriptions grand public dans les 48 heures suivant la sortie de K3, la demande ayant dépassé la capacité GPU. Un élément à garder en tête avant de fonder un produit sur un unique fournisseur.
Benchmarks : séparer les mesures des arguments marketing
Les deux éditeurs publient d’impressionnants tableaux de benchmarks, mais les protocoles ne sont pas homogènes. La carte de Kimi précise elle-même que les scores concurrents proviennent de différents harnesses d’agents et, pour certaines lignes, de matériel H20 plutôt que H100. Les résultats communs ci-dessous sont donc déclarés par les éditeurs, non audités.
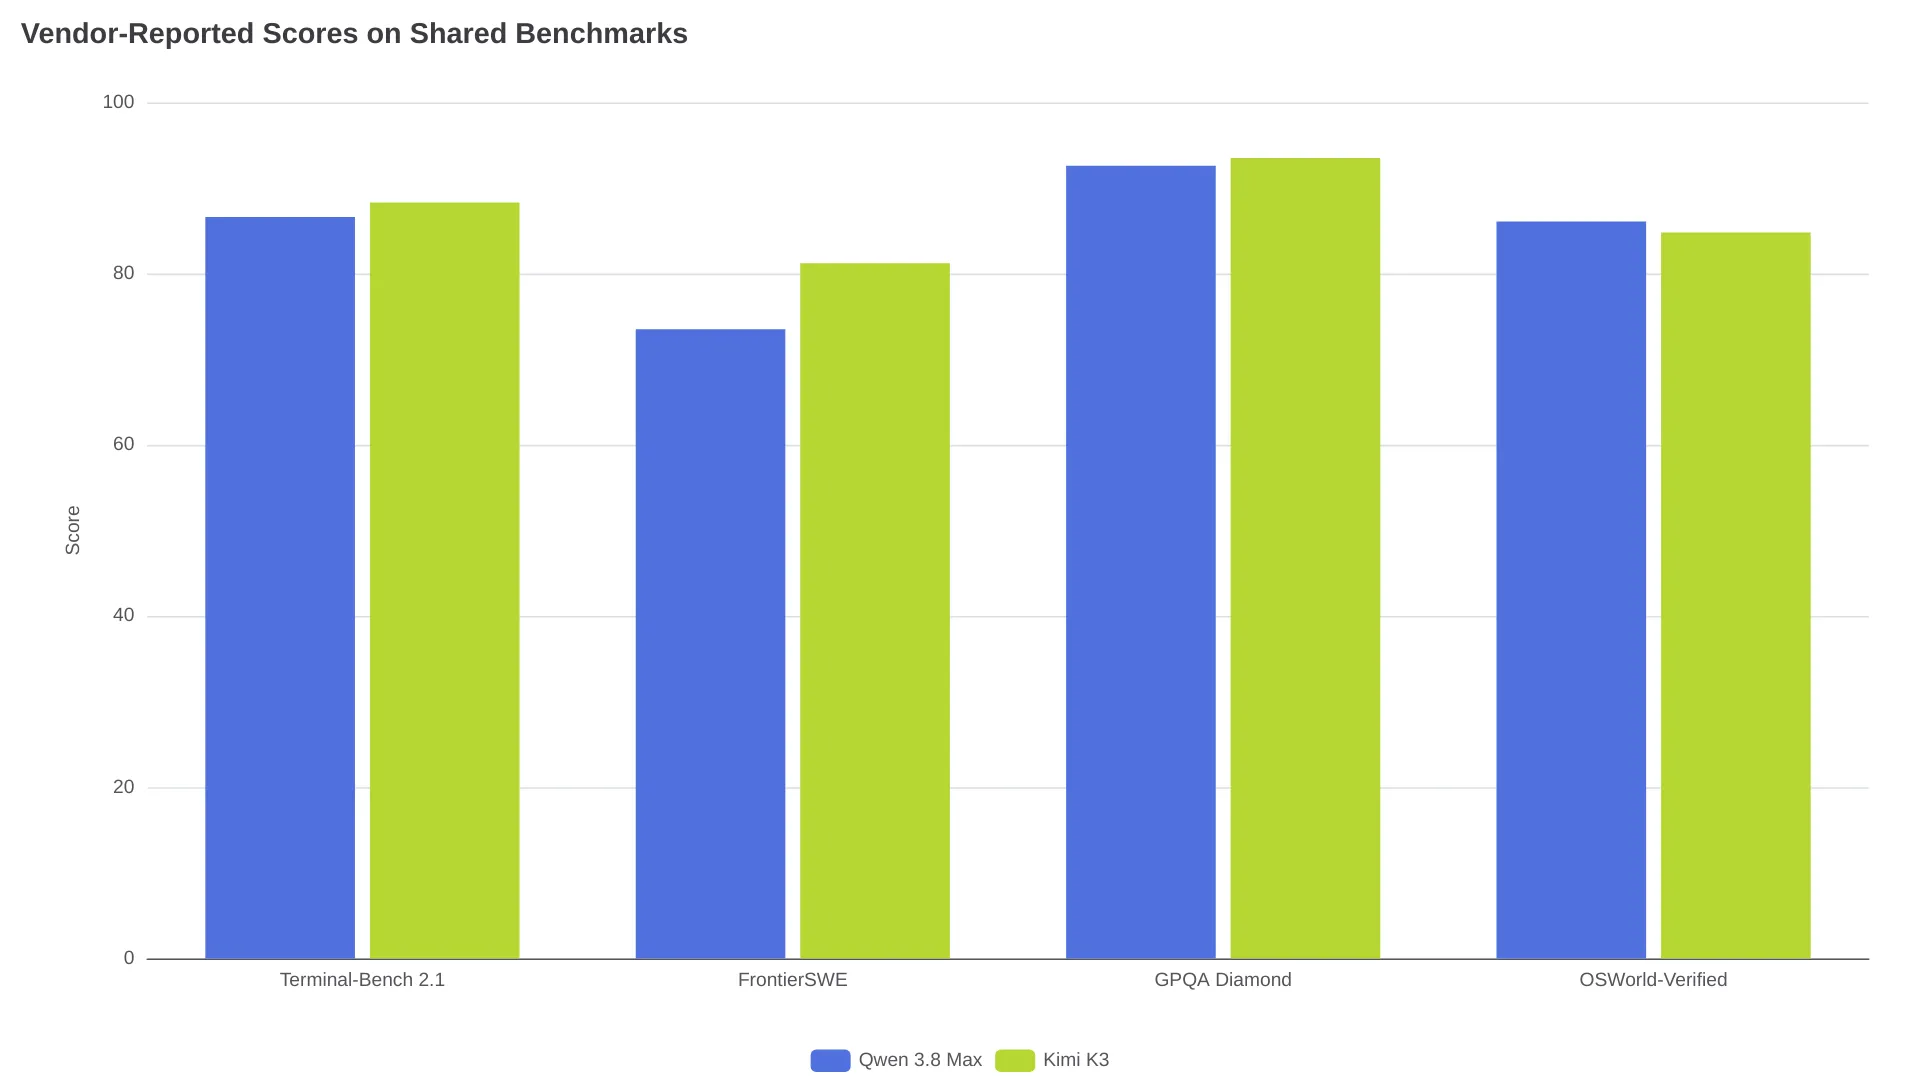
Sur ces lignes communes, Kimi K3 prend l’avantage là où les agents de code sont jugés : selon sa model card, il atteint 81,2 contre 73,5 sur FrontierSWE et 88,3 contre 86,6 sur Terminal-Bench 2.1 (côté Qwen : la model card 2.4T). Les supports de lancement de Qwen annoncent 86,1 sur OSWorld-Verified, contre 84,8 sur la carte de K3. La carte Qwen affiche aussi des résultats isolés marquants — 93,0 sur PaperBench, 82,8 sur IFBench et 67,7 sur SWE-bench Pro — tandis que K3 publie 42,0 sur SWE-Marathon, 91,2 sur BrowseComp et 94,5 sur MCPMark-Verified, sur des tests que Qwen ne renseigne pas.
À ce stade, les données indépendantes penchent nettement d’un côté. Le suivi d’Emergent attribue à Kimi K3 un Artificial Analysis Intelligence Index de 57 au lancement et de 60 dans la version actuelle de l’indice, derrière Claude Fable 5 et GPT-5.6 Sol. Le comparatif d’Orcarouter lui ajoute une première place dans Frontend Code Arena avec 1 679 Elo. Qwen 3.8 Max n’était pas indexé indépendamment au lancement ; le tracker de cheapestinference.com a rapporté un score de 53 dans l’indice Artificial Analysis, tandis que les publications communautaires évoquant une mise à jour à 56 restent non vérifiées.
Le seul face-à-face sur une tâche identique, l’analyse d’architecture StackPerf de TrilogyAI (documentée par Orcarouter), donne 83/100 à K3 contre 80/100 à Qwen sur l’endpoint preview. Qwen a relevé 354 citations de dépôt contre 274 pour Kimi, effectué 22 requêtes de passerelle contre 53, et n’a subi aucun appel d’outil échoué, contre deux pour Kimi.
Reste une ligne absente des tableaux partagés : sur sa propre carte, le 27B obtient 84,3 sur OSWorld-Verified, contre 84,8 pour K3. Un modèle dense de 27B se situe ainsi à moins d’un demi-point d’un flagship de 2,8T sur l’usage d’ordinateur. Il n’évolue pas dans la même catégorie que K3 en programmation — 73,0 contre 88,3 sur Terminal-Bench — mais ses 90,3 sur LiveCodeBench v6 et 61,7 sur SWE-bench Pro en font un véritable outil de travail. Un fil de comparaison pratique sur r/AISEOInsider aboutit au même constat : Qwen remporte davantage de réalisations en une seule passe, Kimi prend l’avantage lorsque le contexte et la profondeur des révisions augmentent.
Coût API : le seuil des $15 en sortie et le prix du raisonnement
Les tarifs catalogue vont tous dans le même sens. En conditions réelles, l’écart se creuse encore : les deux modèles raisonnent par défaut — K3 avec reasoning_effort: max, Qwen avec xhigh — et les tokens de raisonnement sont facturés comme des tokens de sortie.
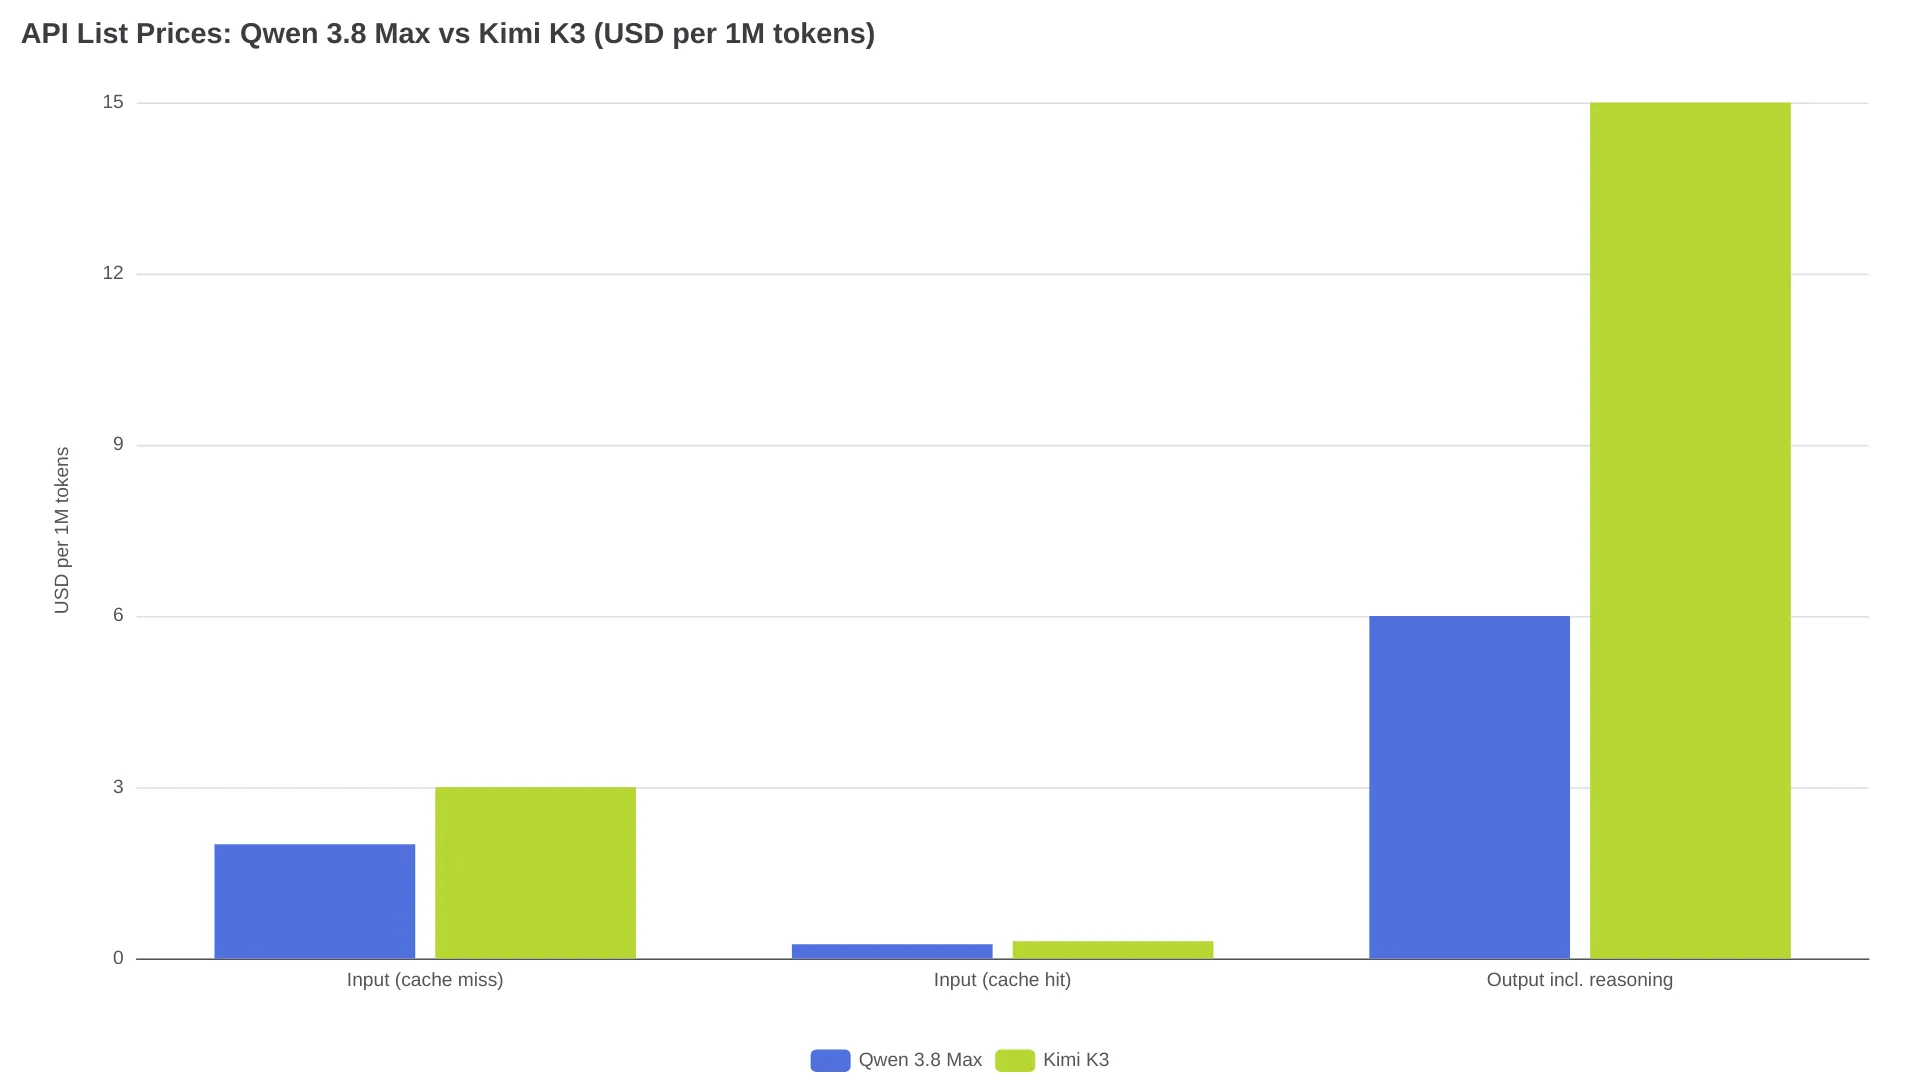
| Pour 1M tokens | Qwen 3.8 Max (QwenCloud) | Kimi K3 (Moonshot) |
|---|---|---|
| Entrée (cache manqué) | $2.00 | $3.00 |
| Entrée (cache touché) | $0.25 | $0.30 |
| Sortie, raisonnement inclus | $6.00 | $15.00 |
| Création / lecture explicite de cache | $2.50 / $0.17 | — |
Deux scénarios calculés avec les tarifs catalogue d’août 2026 :
| Session | Qwen 3.8 Max | Kimi K3 | Écart |
|---|---|---|---|
| Code agentique : 500K en entrée (60 % en cache), 40K en sortie | $0.72 | $1.29 | 1,8× |
| Pipeline documentaire à contexte neuf : 2M en entrée, 100K en sortie | $4.60 | $7.50 | 1,6× |
La règle de routage qui en découle est simple : n’envoyez une tâche à K3 que si son taux d’acceptation sur votre charge de travail dépasse celui de Qwen de plus que l’écart de coût au token d’environ 1,8×. Moonshot propose lui-même une alternative plus économique : Kimi K2.7 Code à $0.95 en entrée et $4.00 en sortie, avec 256K de contexte. Le chemin Kimi le moins cher pour coder n’est donc pas K3. Si vous routez K3 aujourd’hui, son endpoint API est listé ici aux tarifs publiés par Moonshot ; les mécanismes tarifaires détaillés des deux côtés sont analysés dans l’analyse des prix de Qwen3.8-Max et le guide tarifaire Kimi K3.
Auto-hébergement : 1,56 To face à une RTX 4090
C’est ici que les deux promesses d’open weights se séparent d’environ deux ordres de grandeur.
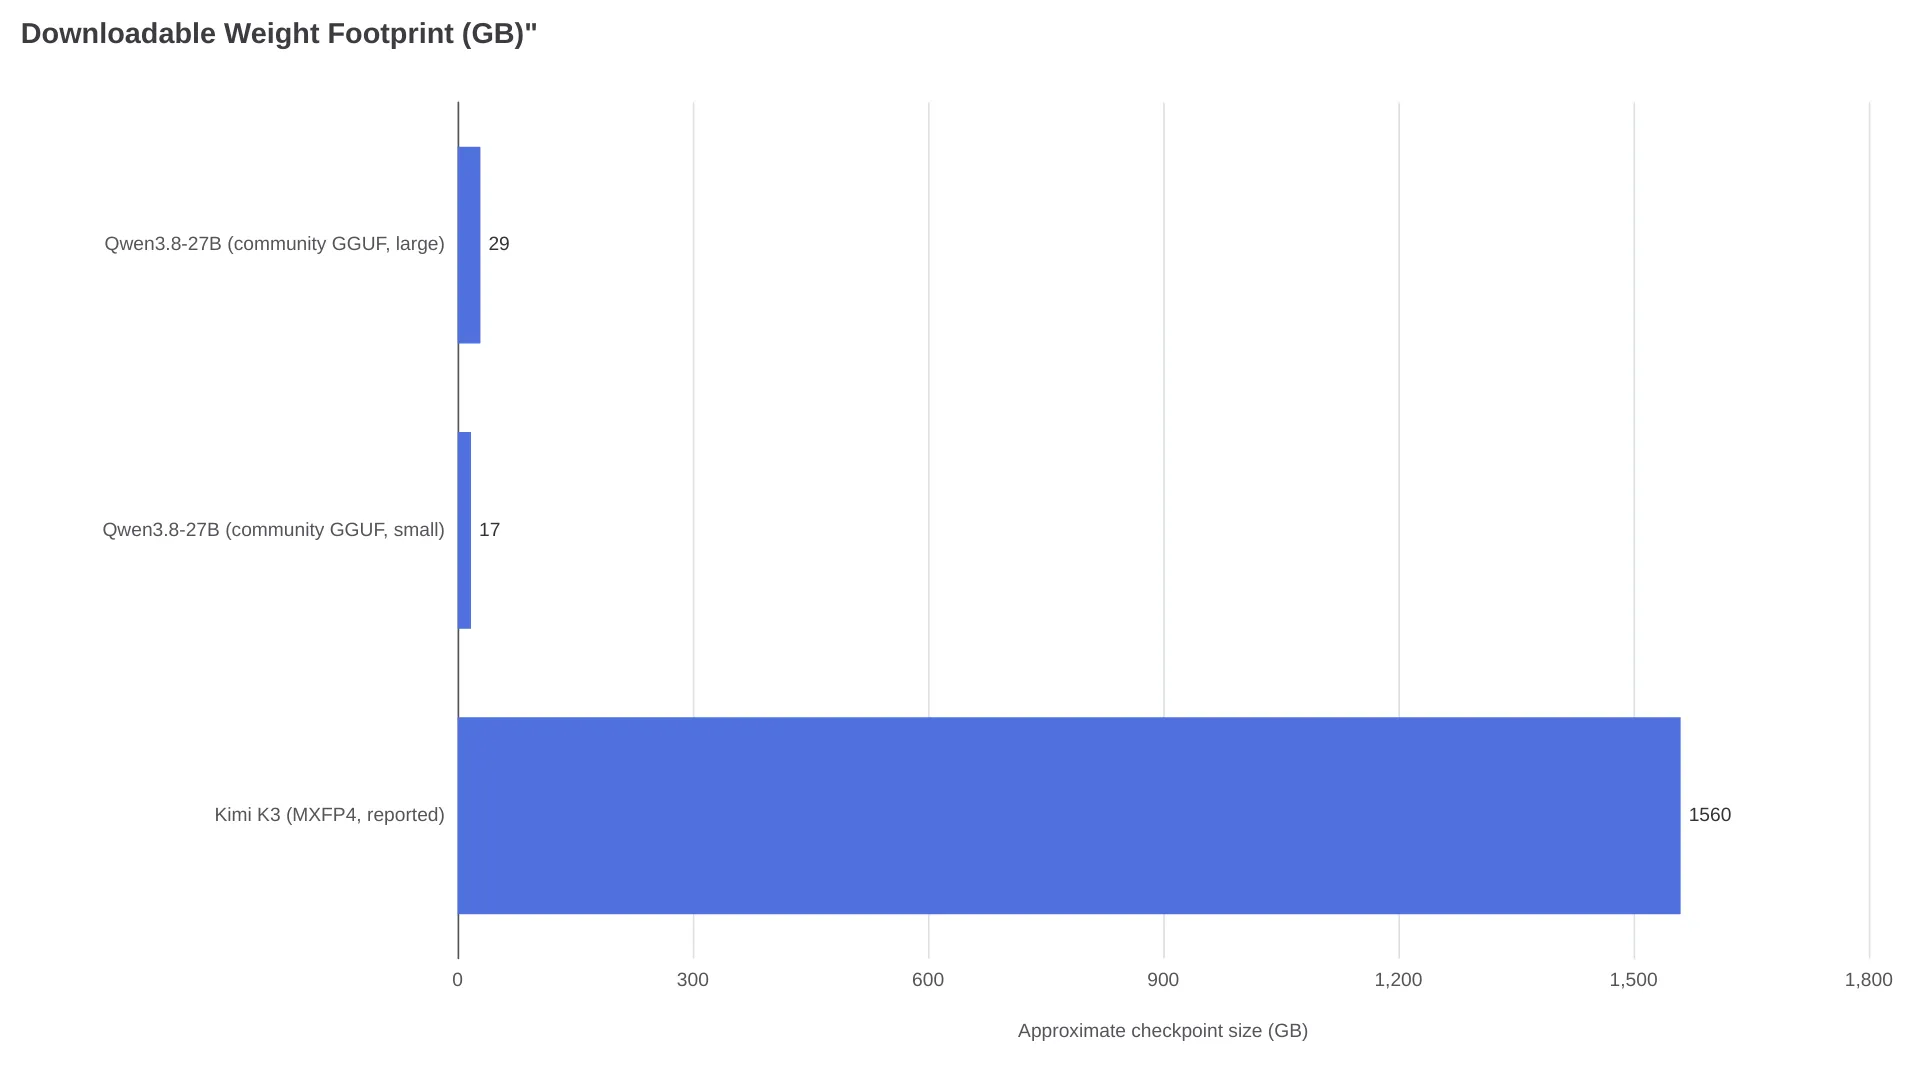
K3 est publié avec des poids MXFP4 adaptés à la quantification (model card), mais un checkpoint annoncé à 1,56 To relève d’un projet de cluster. La même source recommande vLLM sur 64 accélérateurs ou plus. C’est un poste de coût concret, même à la location, avant d’avoir servi le moindre token, auquel s’ajoutent les conditions de licence applicables à grande échelle.
Le 27B raconte l’histoire inverse. Les builds GGUF communautaires s’étendent d’environ 8,5 Go à 28,9 Go ; les builds Dynamic GGUF et NVFP4 d’Unsloth démarrent autour de 17 Go, et une variante FP8 officielle existe pour les déploiements serveur. Il fonctionne sur du matériel déjà présent chez de nombreux utilisateurs :
« Qwen3.8-27B à 160K de contexte sur UNE SEULE RTX 4090 — 47–57 tok/s, offload GPU complet » — publication de déploiement sur r/Qwen_AI
Les poids Max se situent entre les deux. Qwen3.8-2.4T-A95B et sa version FP8 sont téléchargeables sous la licence propriétaire qwen3.8-max, mais l’artefact ouvert ne traite que le texte et son raisonnement ne peut pas être désactivé. Les entrées vision, un mode sans raisonnement et le contexte par défaut de 1M résident dans la couche API QwenCloud, pas dans le checkpoint. Pour le détail de ce que le 27B peut faire — ou non — selon chaque quantification, consultez le guide de terrain Qwen3.8-27B, avec les runtimes et tableaux VRAM ; la sortie des poids K3 est détaillée dans l’article sur les open weights de Kimi K3.
Les détails d’intégration qui font ou défont un projet d’agent
Trois comportements relevés dans les model cards peuvent facilement vous coûter une journée de débogage en production.
| Modèle | Comportement / limite | Conséquence d’implémentation |
|---|---|---|
| Kimi K3 | Raisonnement toujours activé ; les clients multi-tours et tool-use doivent renvoyer l’intégralité du précédent message assistant, y compris reasoning_content et tool_calls (carte) | Supprimez la trace de raisonnement et les boucles d’agent se dégradent ; conservez-la et la dépense augmente avec la longueur de la boucle |
| Qwen3.8-27B | preserve_thinking est activé par défaut ; reasoning_effort peut descendre à medium/low ; YaRN au-delà de 262K applique une mise à l’échelle statique (carte) | La désactivation par requête est prise en charge ; la carte avertit qu’un effort moindre ne réduit pas toujours le temps total, car les tentatives supplémentaires consomment l’économie ; n’activez YaRN que pour les tâches longues |
| Limites Qwen 3.8 Max vs K3 | Max : 991,8K en entrée / 131,07K en sortie (QwenCloud) ; K3 : 1 048 576 en entrée / 131K en sortie par défaut, montant vers 1M | Aucun des deux « contextes 1M » ne garantit 1M de sortie utile ; un test d’aiguille tiers a retrouvé 18/18 faits à 248K et n’a rien testé au-delà |
FAQ
Qwen 3.8 est-il meilleur que Kimi K3 pour programmer ?
Au vu des éléments disponibles, non. Kimi K3 mène sur les lignes décisives en code agentique — FrontierSWE 81,2 contre 73,5, Terminal-Bench 2.1 88,3 contre 86,6 — et possède les seuls scores d’indices indépendants. Qwen 3.8 Max reste proche pour le travail en terminal et coûte moins cher au token comme dans les sessions modélisées ; le 27B appartient à une tout autre catégorie de poids.
Lequel est le moins cher, Qwen 3.8 ou Kimi K3 ?
Qwen 3.8 Max sur toutes les lignes tarifaires : $2 contre $3 en entrée, $6 contre $15 en sortie. Comme les deux modèles facturent leur raisonnement activé par défaut en sortie, le désavantage de Kimi s’accentue avec la difficulté des tâches : environ 1,8× sur une session agentique avec cache dans le calcul ci-dessus.
Peut-on les auto-héberger, et sous quelles licences ?
Oui, les trois checkpoints sont téléchargeables. Qwen3.8-27B est sous Apache-2.0 et tient, quantifié, sur un seul GPU de 24 Go ; Kimi K3 exige du matériel à l’échelle d’un cluster pour son checkpoint MXFP4 d’environ 1,56 To et utilise la licence propriétaire Kimi K3 License ; les poids Qwen3.8-Max sont publics sous le nom Qwen3.8-2.4T-A95B avec la licence propriétaire qwen3.8-max.
La fenêtre de contexte de 1M est-elle réelle sur les deux ?
Dans les grandes lignes, oui. Kimi K3 spécifie 1 048 576 tokens ; Qwen 3.8 Max annonce 1M, avec 991,8K en entrée maximum ; le 27B est natif à 262 144 et n’atteint 1M qu’avec une mise à l’échelle YaRN qui dégrade la qualité en contexte court. Une vérification indépendante n’existe qu’au niveau de 248K.
Quel modèle choisir, et ce qui pourrait faire évoluer ce choix
| Votre cas d’usage | Choix | Pourquoi |
|---|---|---|
| Agents de code via API, priorité à la qualité | Kimi K3 | FrontierSWE 81,2, Terminal-Bench 88,3, AA vérifié à 60 |
| Travail API sensible au budget, riche en documents/vision | Qwen 3.8 Max | $6 contre $15 en sortie, OSWorld 86,1, cache explicite à $0.17/lecture |
| Auto-hébergement sur votre propre matériel | Qwen3.8-27B | Apache-2.0, quantifications d’environ 17–29 Go, 160K de contexte sur une RTX 4090 |
| Auto-héberger un flagship de frontière | Kimi K3 | Le seul checkpoint ouvert ici avec des scores indépendants de niveau frontière — prévoyez un cluster |
Deux éléments pourraient modifier une partie de ce tableau : une évaluation indépendante de Qwen 3.8 Max — le score de 53 rapporté par un tracker face aux 60 vérifiés de K3 repose sur des éléments limités — et la publication des conditions de la licence propriétaire qwen3.8-max. D’ici là, le face-à-face API Qwen 3.8 Max vs Kimi K3 traite plus en profondeur le scénario API uniquement.
À lire aussi : Qwen3.8-27B: What's Confirmed and What 17GB Really Runs · Kimi K3 Open Weights · Qwen 3.8 Max vs Kimi K3: API Edition