 AIREITER
Opus 5.5 l’emporte sur la qualité, GPT-6.1 Sol sur le tarif affiché — mais uniquement tant que chaque requête reste sous les 272K tokens d’entrée. Au-delà, la surtaxe long contexte efface l’essentiel de l’avantage de Sol. Plusieurs utilisateurs de Codex affirment aussi que Sol paraît plus lent en temps réel.
Les deux modèles sont disponibles aujourd’hui. Anthropic a lancé Claude Opus 5.5 le 22 septembre 2026, premier modèle Claude 5.5, tandis qu’OpenAI a lancé GPT-6.1 Sol le 29 septembre 2026 avec l’identifiant API gpt-6.1-sol. Les tableaux de caractéristiques ne disent pas tout : pour calculer la facture, trois éléments comptent vraiment — le seuil du long contexte, le niveau d’effort et le fonctionnement des quotas dans les abonnements.
La réponse en 30 secondes
Choisissez Claude Opus 5.5 lorsqu’un patch erroné ou inutilement volumineux coûte plus cher que les tokens : migrations longues, audits multi-dépôts et agents autonomes. Préférez GPT-6.1 Sol pour les tâches très volumineuses et bien cadrées, sous 272K tokens d’entrée par requête : automatisation de tickets, extraction de PDF et workflows métier.
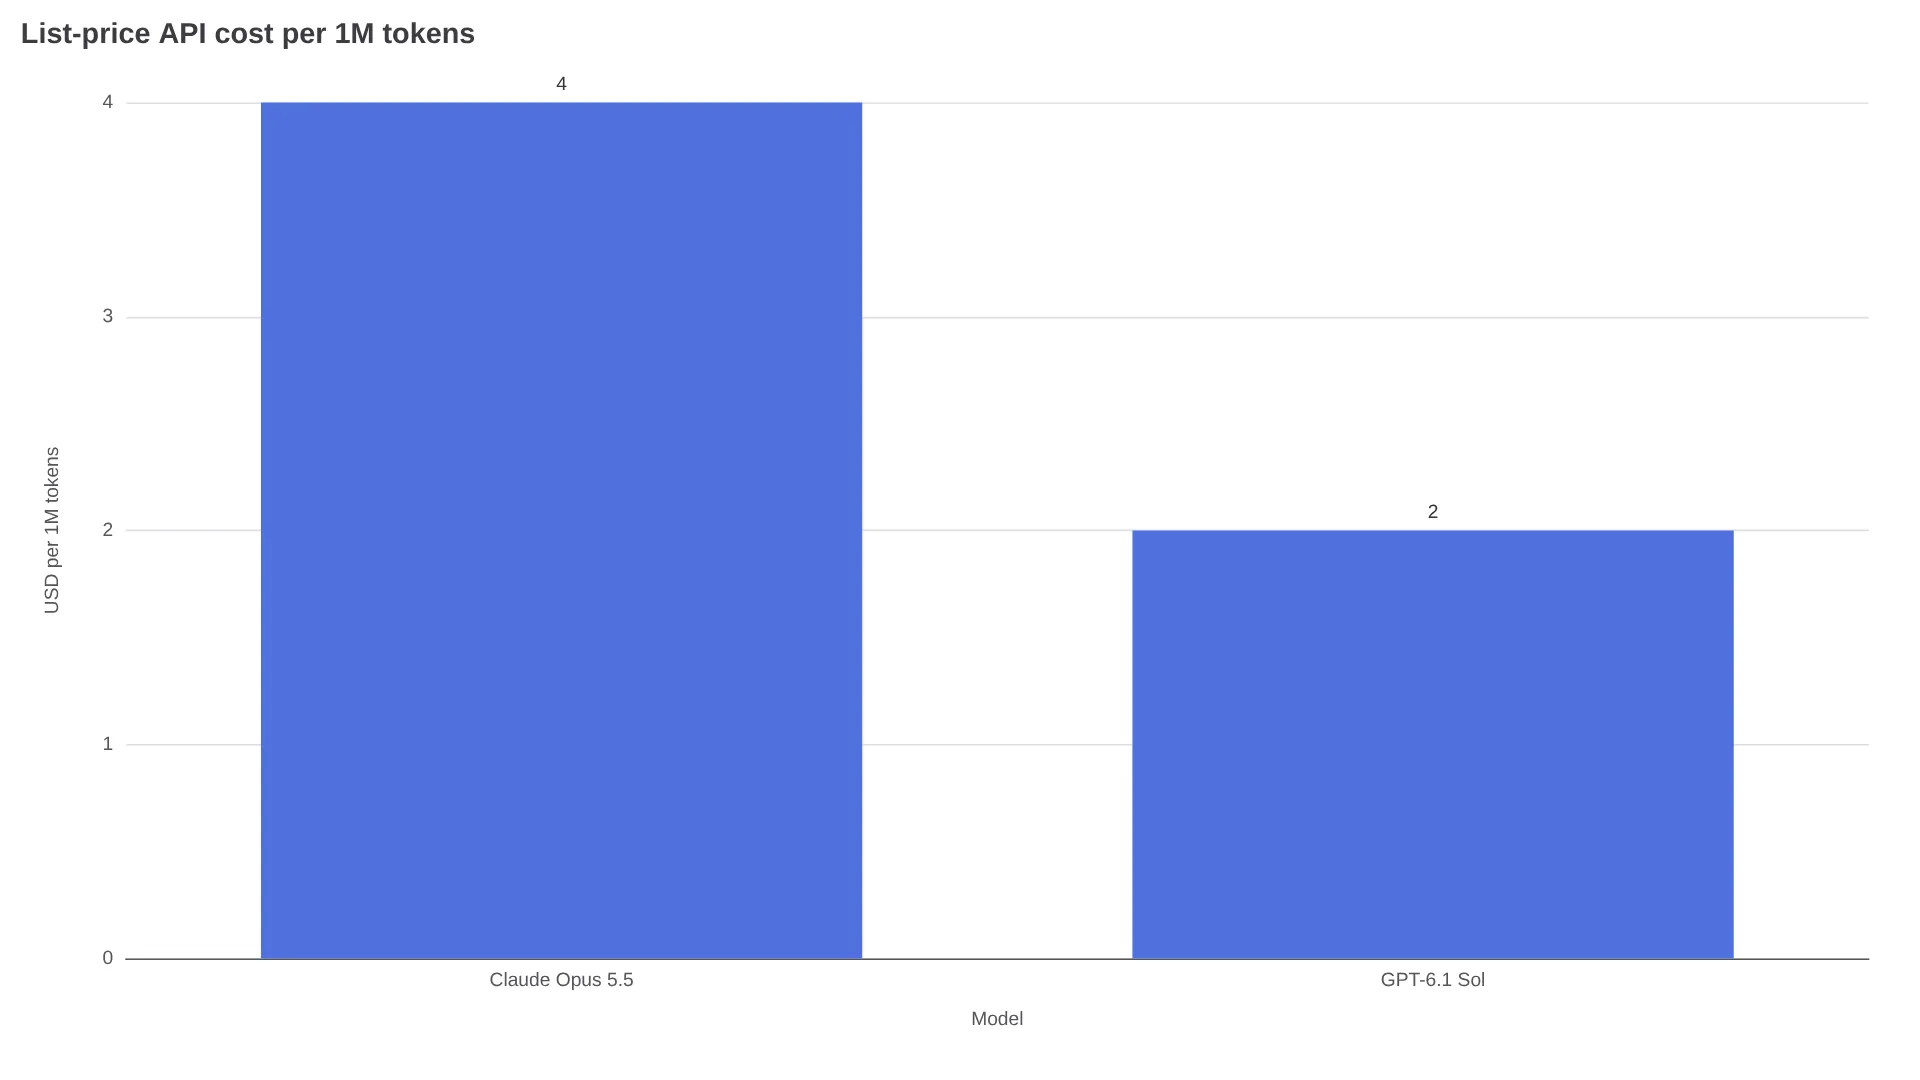
Sur le papier, l’écart technique reste limité : 1M contre 1,05M de contexte, 128K tokens de sortie maximum pour les deux, et 4/20 $ contre 2/10 $ par million de tokens d’entrée/sortie. En pratique, la différence est plus nette : Opus 5.5 obtient de meilleurs résultats en développement agentique (66,4 % à Terminal-Bench 4.0, 54,4 % à FrontierCode v1.1 et 57,8 % à CursorBench 4.0), tandis que Sol répond avec un tarif environ deux fois inférieur et une victoire documentée à AutomationBench pour un tiers du coût par tâche. Côté abonnements, un autre élément entre en jeu : des tests de quotas publiés sur Reddit montrent que Sol consomme l’allocation plus vite que ne le laisserait penser son prix API.
Tarifs, contexte et plateformes disponibles
| Claude Opus 5.5 | GPT-6.1 Sol | |
|---|---|---|
| Fournisseur | Anthropic | OpenAI |
| Sortie | 22 septembre 2026 | 29 septembre 2026 |
| Identifiant API | famille claude-opus-5-5 sur la plupart des passerelles | gpt-6.1-sol |
| Entrée / sortie par million | 4,00 $ / 20,00 $ | 2,00 $ / 10,00 $ |
| Lecture d’entrée en cache par million | 0,20 $ | 0,10 $ |
| Fenêtre de contexte | 1 000 000 tokens | 1 050 000 tokens |
| Sortie maximale | 128K tokens | 128K tokens |
| Mode rapide | Mode Fast à 8 $ / 40 $, jusqu’à 2,5 fois plus rapide | Ultrafast jusqu’à 8 fois plus rapide dans Codex, environ 2 fois les tarifs affichés |
| Disponible via | Claude Code, API, Bedrock, Vertex, Foundry, OpenRouter | Codex, ChatGPT Work, API, Azure, Bedrock, OpenRouter |
| Absent de | — | Chat grand public classique au lancement |
Pour passer de l’un à l’autre, il suffit de modifier la chaîne du modèle. AIReiter permet d’utiliser les deux depuis une seule console, sans avoir à gérer deux clés fournisseur.
Ce que coûtent vraiment les charges de travail
Au tarif catalogue, Sol semble 50 % moins cher. Mais le coût réel dépend de la taille de chaque requête et de l’utilisation du cache.
La surtaxe d’OpenAI s’applique à chaque requête dépassant 272K tokens d’entrée : les tarifs d’entrée et de cache sont doublés, tandis que la sortie passe à 1,5 fois le tarif normal pour l’ensemble de la requête. Anthropic facture toute sa fenêtre de 1M aux mêmes tarifs, sans surtaxe par requête annoncée. La lecture en cache coûte 0,20 $ contre 0,10 $, ce qui permet à Sol de conserver une partie de son avantage dans les boucles fortement dépendantes du cache.
| Charge de travail | Opus 5.5 | GPT-6.1 Sol | Écart |
|---|---|---|---|
| Assistant équilibré : 1M en entrée / 250K en sortie, requêtes sous 272K chacune | 9,00 $ | 4,50 $ | Sol 50 % moins cher |
| Récupération, requêtes sous 272K : 10M en entrée / 1M en sortie | 60 $ | 30 $ | Sol 50 % moins cher |
| Récupération, chaque requête dépassant 272K : 10M en entrée / 1M en sortie | 60 $ | ~55 $ | Sol seulement ~8 % moins cher |
| Boucle avec beaucoup de cache : préfixe de 100K écrit une fois, puis 1 000 fois (5K nouveaux + 100K lus en cache + 1K en sortie) | ~60,50 $ | ~30,25 $ | Sol ~50 % moins cher |
Ces totaux utilisent les tarifs catalogue, avant prise en compte des différences de tokenisation. L’avantage de Sol est maximal sur les requêtes courtes et nombreuses, et minimal sur les énormes requêtes de récupération lancées en une seule fois.
Le calcul change avec les abonnements. Lors d’une comparaison menée par un utilisateur sur 128 prompts entre GPT-6.1 Sol, GPT-6 Sol et Opus 5.5 avec des prompts identiques, la consommation de l’abonnement par la famille Sol s’est révélée supérieure à ce que laissait prévoir le prix des tokens. Un commentaire de suivi résume la situation :
"my chatgpt just cited this. anyways they may be a match usage-wise but opus is way faster on the wall clock and i regret swapping this month." — u/ebrbrbr, fil de test des quotas sur r/ChatGPT
Un autre utilisateur de Codex rapporte une consommation similaire :
"I wouldn't mind using GPT 6.1 Sol if the usage was decent, but man, even though it's more 'efficient' I'm still getting drained on usage. It's unbelievable." — u/Longjumping_Stop6269, r/codex
Règle simple pour le budget : si vos requêtes médianes dépassent 272K, intégrez la surtaxe dans vos calculs avant de migrer. Avec un abonnement à 20 $ ou 100 $, mesurez la part de quota consommée par pull request fusionnée, pas le nombre de tokens par dollar.
Code et agents : benchmarks et deux tests pratiques
Les résultats tiers ci-dessous donnent une tendance ; les harnesses et les niveaux d’effort ne sont pas identiques. Sources : Anthropic, OpenAI, test de build DataCamp, débit OpenRouter, synthèse de benchmarks SpringPrompt.
| Benchmark | Opus 5.5 | GPT-6.1 Sol | Remarque |
|---|---|---|---|
| Terminal-Bench 4.0 | 66,4 % | non publié | Test Anthropic, xhigh |
| FrontierCode v1.1 Main | 54,4 % | égale Fable 5.1, aucun chiffre | Sources différentes |
| CursorBench 4.0 | 57,8 % | non publié | Test Anthropic |
| DeepSWE v1.1 | non publié | égale Astra, +6,4 points par rapport à GPT-6 Sol | Test OpenAI, effort maximal |
| AutomationBench (47 outils) | 40,0 % | +2,2 points par rapport à Opus en mode moyen, ~1/3 du coût | Test indépendant, sans solution de repli, selon le compte rendu Anthropic du test Zapier |
| OSWorld 2.0 partiel | 81,8 % | ~60,5 % sur l’ensemble hors ligne | Sous-ensembles différents, tests fournisseurs |
| GDPval-AA v2.1 | 1 846 Elo | Sol bat Opus avec solutions de repli sur GDP.pdf pour <1/2 du coût | Affirmation inter-fournisseurs d’OpenAI |
Opus 5.5 dispose de l’ensemble publié le plus complet en développement agentique ; les meilleurs résultats documentés de Sol concernent les workflows métier et l’analyse de documents, pour un coût par tâche inférieur. Anthropic précise que ses scores ont été obtenus avec les protections de production activées.
Deux tests tiers permettent d’affiner le tableau :
- Création d’un Tetris dans un seul fichier (DataCamp, OpenCode, même prompt, effort élevé, une seule tentative). Les deux modèles ont réussi la logique complexe d’inversion de la gravité. Sol a obtenu 5,0 contre 4,3 sur la mécanique, la complétude et les sensations de jeu ; Opus a terminé en 3 tours et 2 appels d’outils contre 6 tours et 9 appels, mais a coûté 0,87 $ contre 0,26 $ après avoir consommé 22,5K tokens de raisonnement, contre 8,1K pour Sol.
- Test de quotas sur 128 prompts (Reddit, prompts identiques, quota et temps mesurés). Sol a consommé davantage de quota d’abonnement que GPT-6 Sol sur la même charge, tandis qu’Opus a terminé plus rapidement en temps réel.
Un retour revient régulièrement chez les utilisateurs : la retenue d’Opus.
"The biggest win with Opus 5.5 for me isn't even raw coding speed, it's that it doesn't over-engineer simple fixes. Previous models would rewrite 4 files when you asked for a 3-line patch; 5.5 respects the existing architecture" — u/food_fatherr, r/ClaudeAI
Mais un témoignage d’hyperproduction raconte l’inverse : un développeur a rapporté que Sol avait écrit 30 000 tests pour une demande de rendu au pixel près, avant de n’en supprimer que 25 lorsqu’on lui a demandé de réduire la voilure.
La vitesse ressentie face à la vitesse mesurée
Les fiches techniques donnent l’avantage à Opus en décodage : environ 96 contre 53 tokens/s sur Artificial Analysis via SpringPrompt, et 74 contre 29 en débit médian sur OpenRouter. Sol devance légèrement Opus sur le temps avant le premier token selon SpringPrompt (1,71 s contre 6,89 s en faible effort). Les témoignages cités sur Codex décrivent pourtant l’inverse sur les délais de bout en bout, avec notamment des tâches simples prenant plusieurs minutes et des traitements de documents longs.
Ces deux constats peuvent être vrais : les tokens/s mesurent le décodage après le premier bloc ; le temps réel inclut aussi le raisonnement, la file d’attente et le surcoût du harness.
- Le mode Fast d’Opus coûte 8/40 $ (2 fois plus) pour une vitesse jusqu’à 2,5 fois supérieure ; le mode Ultrafast de Sol promet jusqu’à 8 fois plus de vitesse dans Codex, pour environ 2 fois les tarifs.
- Les rapports cités sur Codex et Work parlent de latence, pas de débit API en décodage. Un traitement PDF de 40 minutes n’a utilisé que 6 % d’une fenêtre de 5 heures dans un témoignage isolé, ce qui ne constitue pas un rythme typique.
- Si votre boucle est interactive (Cursor, Claude Code, Codex CLI), testez trois tickets réels avec chaque modèle avant de trancher.
Les réglages qui déterminent la facture
Les réglages par défaut comptent davantage que le nom du modèle :
- Commencez Opus en mode Medium ou High. Les retours d’utilisateurs cités suggèrent que les niveaux Extra High et Max consomment beaucoup de quota pour un gain limité sur les patchs ordinaires.
- Les contrôles du raisonnement ne fonctionnent pas de la même manière. Le raisonnement d’Opus ne peut pas être désactivé, l’utilisation forcée d’outils est refusée et la modification du contexte sur les comptes récents peut provoquer une erreur 400 (notes API de DataCamp). Sol propose une échelle allant de
noneàmaxet permet de modifier l’effort en cours de conversation sans invalider le cache (contrôles du raisonnement de DataCamp), ce qui convient mieux aux boucles avec budget plafonné. - Les garde-fous peuvent rediriger la tâche. La plupart des tâches de cybersécurité avec Opus sont redirigées vers Opus 4.8 hors du Cyber Verification Program ; les tâches liées à la biologie nécessitent le programme Life Sciences (Anthropic). Sur ces sujets, prévoyez des surprises de qualité et de quota liées aux solutions de repli.
Quel modèle pour quelle charge de travail ?
| Pour… | Choisissez… | Pourquoi |
|---|---|---|
| Migration de 200K lignes, audit multi-dépôts, agent actif pendant 9 heures | Opus 5.5 | Meilleurs scores agentiques, moins de réécritures superflues, tarif stable jusqu’à 1M |
| 10K tickets par jour, chacun sous 272K, RAG avec petits segments | GPT-6.1 Sol | Moitié du tarif affiché, bons résultats à AutomationBench et sur GDP.pdf au coût par dollar |
| Énorme récupération en une seule requête dépassant 272K | Opus 5.5 ou Sol avec découpage | La surtaxe de Sol réduit son avance à ~8 % |
| Questions-réponses financières et juridiques centrées sur les PDF | Testez Sol en premier | Victoire revendiquée sur Opus avec solutions de repli pour <1/2 du coût par tâche ; vérifiez sur vos documents |
| Abonné à 20 $, CLI interactive | Testez les deux ; les rapports cités favorisent Opus | Les utilisateurs signalent que Sol consomme plus vite que ne le prévoit le calcul des tokens et paraît plus lent |
Il n’y a pas de vainqueur universel. Sol mise sur l’efficacité, Opus sur la retenue et l’autonomie. Une répartition pragmatique consiste à confier la planification et la revue à Opus, puis l’exécution en volume à Sol.
FAQ : Opus 5.5 contre GPT-6.1 Sol
Lequel est le moins cher via l’API ?
Sol au tarif affiché (2/10 $ contre 4/20 $, et 0,10 $ contre 0,20 $ pour les lectures en cache). L’écart tombe à ~8 % lorsque chaque requête dépasse 272K tokens d’entrée.
Lequel est le meilleur pour les agents de code ?
Opus 5.5 domine les résultats publiés à Terminal-Bench, FrontierCode et CursorBench ; Sol répond avec une parité avec Astra à DeepSWE et une victoire à AutomationBench pour un tiers du coût.
Lequel est le plus rapide en pratique ?
Le décodage favorise Opus (~74–96 tok/s contre ~29–53) ; Sol est légèrement meilleur jusqu’au premier token. Les rapports Codex d’octobre 2026 penchent vers des temps d’attente plus longs pour Sol.
Quels sont les identifiants des modèles API ?
gpt-6.1-sol, et les slugs claude-opus-5-5 sur la plupart des passerelles.
GPT-6.1 Sol est-il disponible dans le ChatGPT classique ?
Pas au lancement du 29 septembre : Work, Codex et API en premier. Vérifiez votre abonnement si cet accès est important.
Quel niveau d’effort utiliser ?
Commencez avec Opus 5.5 en mode Medium ou High, pas Max ; lancez Sol en mode medium et augmentez uniquement si les nouvelles tentatives se multiplient. Les tokens de raisonnement sont facturés selon le même compteur par token pour les deux modèles (notes de facturation DataCamp).
Le compromis qu’aucun prompt ne peut contourner
Opus 5.5 respecte mieux le dépôt, mais facture le raisonnement ; Sol réduit le prix des tokens, mais peut vous noyer sous le travail à relire et vous faire attendre. Si une erreur silencieuse peut envoyer un bug en production, payez pour Opus. Si les erreurs coûtent peu et que le volume prime, profitez des économies de Sol sous 272K.
À lire aussi : test et tarifs de Claude Opus 5.5, test des tarifs API de GPT-6.1 Sol.