 AIREITER
Une API affichée à 0,15 $/heure peut facturer 0,30 $ pour une heure d'audio, là où une offre à 0,36 $/heure facturera bien 0,36 $ pour ce même fichier. Ce détail de facturation pèse davantage sur les budgets STT que la plupart des classements de précision — et il est souvent passé sous silence.
La meilleure API de transcription en 2026 dépend avant tout de votre usage : fichiers enregistrés ou agent vocal en direct. Pour traiter des enregistrements à moindre coût, commencez par AssemblyAI Universal-2 à 0,15 $/heure. Pour des agents live où la gestion des tours de parole est cruciale, regardez d'abord Deepgram Flux ou Nova-3 en streaming. Si vous avez besoin de plus de 90 langues et d'une prise en charge étendue de la diarisation, testez ElevenLabs Scribe v2 à 0,22 $/heure en batch. Les tarifs ci-dessous correspondent aux offres phares en paiement à l'usage, ramenées à l'heure d'audio avant remises sur volume.
Batch et streaming : deux achats distincts
Ne mettez pas transcription batch et streaming temps réel dans le même panier. Les API batch facturent l'heure d'audio traitée, généralement via un dépôt de fichier suivi d'un polling. Les API de streaming, elles, facturent la minute de session, y compris lorsque le WebSocket reste ouvert sans activité, et leur valeur dépend directement de la vitesse des résultats partiels.
Latence des résultats partiels, latence de finalisation et latence de fin de tour ne mesurent pas la même chose : apparition des premiers mots, moment où le texte cesse d'être modifié, et détection de la fin de parole de l'appelant. Comparer des fournisseurs en mélangeant ces définitions est trompeur, comme le rappellent les comparatifs streaming de Dexto et versusref.
En pratique, la séparation est simple :
- Archives d'enregistrements, podcasts, réunions, journaux d'appels : privilégiez le coût par heure, la précision de diarisation, la gestion des gros fichiers et le temps de correction.
- Sous-titrage live ou agents téléphoniques : privilégiez la stabilité des partiels, l'endpointing, la gestion des interruptions et le délai de bout en bout, LLM et TTS compris.
- Appels de centre de contact sur AWS ou GCP : les contraintes d'achat et la facturation par canal l'emportent souvent sur un écart de 0,05 $/heure dans les tarifs catalogue.
"Testez ces API sur de vrais enregistrements clients. Pièces bruyantes. Accents indiens. Alternance hindi-anglais... Précision, latence et fiabilité d'abord. Le prix ensuite." — @Aditya_Chawla20
Cette publication comparait AssemblyAI à 0,21 $/heure, ElevenLabs Scribe v2 à 0,22 $/heure et Deepgram Nova-3 autour de 0,26 $/heure. Sa conclusion : l'écart de 5 cents compte moins que la capacité du modèle à tenir sur de l'audio réel.
Le coût réel d'une heure d'audio
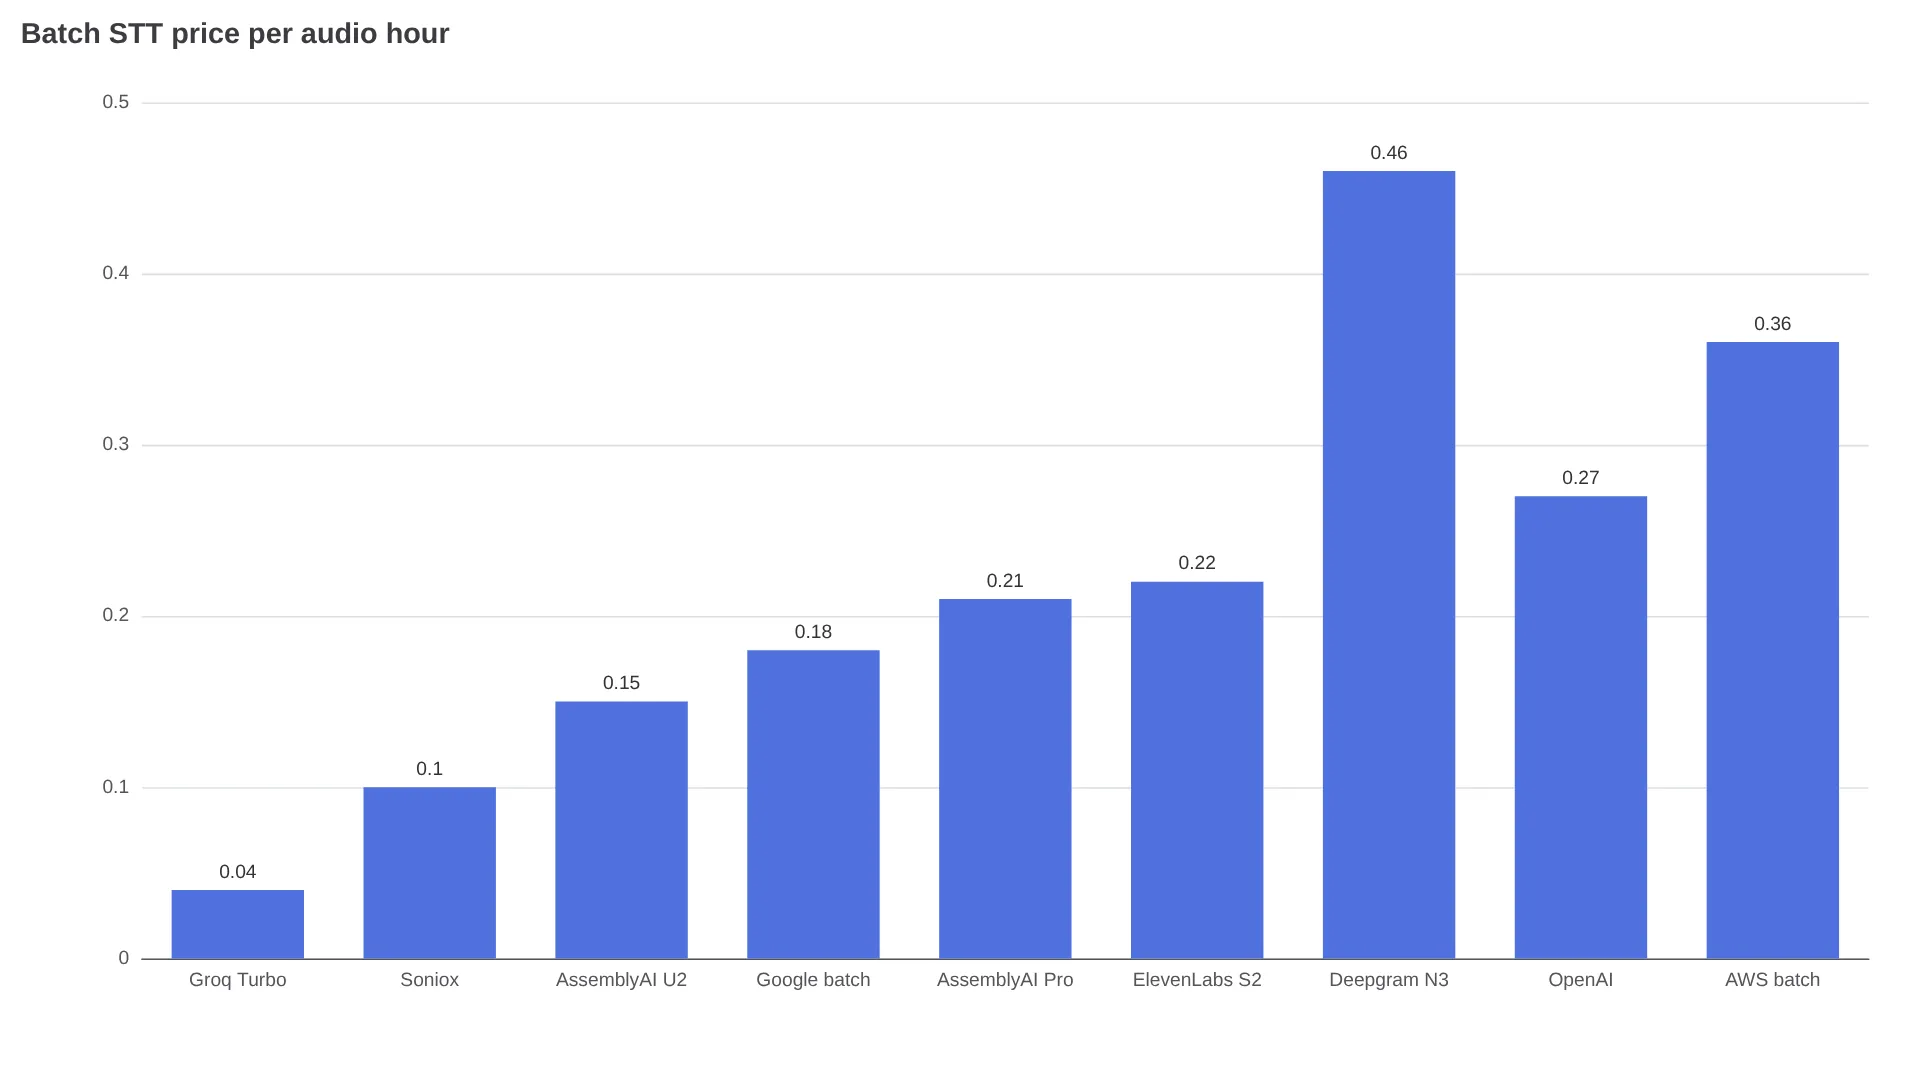
| Fournisseur | Batch | Streaming / temps réel | Langues | Offre gratuite de départ |
|---|---|---|---|---|
| Groq Whisper | Large v3 Turbo 0,04 $/h | Pas d'endpoint streaming | Jeu multilingue de Whisper | Palier gratuit avec limites |
| Soniox | ~0,10 $/h en asynchrone | ~0,12 $/h en temps réel | 60+ dans un seul modèle | Aucune indiquée |
| AssemblyAI | Universal-2 0,15 $/h ; Universal-3.5 Pro 0,21 $/h | Universal-Streaming 0,15 $/h ; Pro Realtime 0,45 $/h | 99 sur U2 ; 18 sur 3.5 Pro | 50 $ de crédit, sans carte |
| Google Cloud | Dynamic Batch 0,18 $/h ; Standard 0,96 $/h | Standard 0,96 $/h sur les 500 000 premières min | 125+ locales annoncées | 300 $ de crédit Cloud |
| ElevenLabs Scribe | Scribe v2 0,22 $/h | Scribe v2 Realtime 0,39 $/h | 90+ | ~4,5 h avec le plan gratuit |
| Deepgram | Nova-3 0,26–0,46 $/h selon l'offre (promo ou tarif monolingue standard) | Promo Nova-3 ~0,29 $/h ; Flux English 0,39 $/h (0,0065 $/min) | 45+ | 200 $ de crédit |
| OpenAI | gpt-transcribe 0,27 $/h (0,0045 $/min) | gpt-live-transcribe 1,02 $/h (0,017 $/min) | Indiqué par modèle, Whisper 98 | Aucune indiquée |
| AWS Transcribe | 0,36 $/h (0,006 $/min) | 0,60 $/h (0,01 $/min) | Large couverture, variable selon la fonctionnalité | 60 min/mois pendant 12 mois |
| Speechmatics | Melia 1 0,24 $/h de base | Linden 1 0,30 $/h ; Enhanced 0,80 $/h | 55+ | 100 $ de crédit |
| Gladia | Solaria-3 0,16 €/h | 0,68 €/h | 100+ sur Solaria-1 ; 6 sur Solaria-3 | 50 € de crédit, 1 an |
La fourchette Deepgram reflète les tarifs promotionnels et standards de la transcription monolingue préenregistrée ; vérifiez l'offre actuellement active sur la page tarifaire de Deepgram avant de bâtir votre budget.
Le piège du multicanal
Une heure d'audio stéréo ne correspond pas systématiquement à une heure facturable. AssemblyAI et Google facturent chaque canal séparément : un appel de 60 minutes sur deux canaux avec Universal-2 revient donc à 0,15 $ x 2 = 0,30 $. Ce même appel coûte 0,96 $ x 2 = 1,92 $ avec Google Standard. AWS Transcribe inclut jusqu'à deux canaux dans la durée facturée ; dans l'exemple US East à haut volume cité par CometAPI, cet appel stéréo reste donc proche de 0,36 $ en batch. Vérifiez le décompte des canaux avant de comparer deux prix horaires.
Les options qui changent le classement
La transcription de base n'est que la première ligne de facture. Selon le détail poste par poste de CometAPI, Deepgram Nova-3 monolingue préenregistré passe de 0,0077 $/min à 0,0097 $/min avec diarisation, puis à 0,0117 $/min avec diarisation et masquage ; le prompting par termes clés ajoute encore 0,0013 $/min. AssemblyAI facture 0,02 $/heure pour la diarisation d'enregistrements, mais 0,12 $/heure en streaming. ElevenLabs ajoute 0,08 $/heure pour les termes clés temps réel et 0,07 $/heure pour la détection d'entités.
Coût total par transcription validée = traitement API + fonctionnalités payantes + nouvelles tentatives + stockage/transfert + temps de correction humaine. Dans l'exemple chiffré de CometAPI, avec un coût relecteur de 30 $/heure, une solution à 0,15 $/heure nécessitant 8 minutes de correction atteint 4,15 $, tandis qu'une solution à 0,60 $/heure nécessitant 3 minutes de correction revient à 2,10 $.
Pour un agent vocal, commencez par tester la prise de tour
Les agents vocaux échouent sur les interruptions et les silences, pas sur le WER d'un audio propre. Comparez directement le mécanisme de prise de tour, les contrôles de contexte, le prix temps réel et la principale limite de chaque offre.
| Fournisseur | Prise de tour | Prix temps réel | Limite |
|---|---|---|---|
| Deepgram Flux | Événements EndOfTurn, seuil réglable ; mode eager + TurnResumed ; le mode eager peut augmenter les appels LLM de 50 à 70 % selon la documentation Deepgram citée par Dexto | Flux English 0,0065 $/min ; promo Nova-3 streaming ~0,0048 $/min | Flux multilingue limité à 10 langues ; les promotions expirent |
| AssemblyAI | Prompt + termes clés + 1 750 caractères de réponse précédente de l'agent ; endpointing basé sur la ponctuation | Universal-Streaming 0,15 $/h ; Pro Realtime 0,45 $/h | Le palier streaming économique est orienté anglais ; le temps de socket inactif est facturé |
| ElevenLabs Scribe | ~150 ms de latence modèle annoncée par le fournisseur ; 90+ langues ; diarisation batch jusqu'à 32 locuteurs | Scribe v2 Realtime 0,39 $/h + 0,08 $/h pour les termes clés temps réel | Diarisation temps réel non indiquée ; le chiffre fournisseur exclut le réseau et la pile agent |
| OpenAI | Deltas de transcription via WebSocket ; pas de VAD côté serveur ; le client valide le tour ; pas d'étiquettes de locuteur ni d'horodatage des mots en temps réel | gpt-live-transcribe 0,017 $/min | Endpointing côté client obligatoire ; prix temps réel par heure le plus élevé ici |
Mesurez aussi le délai des appels d'outils et du LLM. Un créateur d'agent hôtelier sur X a signalé 5 à 7 secondes de silence après un appel d'outil malgré un STT rapide : @albertolco88. Ce délai de bout en bout n'apparaît jamais dans les tableaux limités au STT.
Pour les enregistrements, évaluez séparément le texte et la diarisation
Un benchmark utilisateur relayé sur r/speechtech a testé une véritable réunion suédoise de 2 heures et 22 minutes, avec six participants, contre une vérité terrain pyannote. Son auteur a trouvé Deepgram le plus rapide et le plus solide en diarisation, ElevenLabs meilleur pour le texte suédois mais incapable d'identifier deux des six locuteurs, et AssemblyAI proche en précision mais beaucoup plus lent dans ce pipeline. Plutôt que de désigner un vainqueur, il a combiné les fournisseurs.
"Deepgram est le plus solide des trois, et il a été très rapide." — u/DoctorNootNoot sur r/speechrecognition
Trois vérifications propres aux enregistrements distinguent les API réellement utilisables de celles qui deviennent vite frustrantes :
- Alternance de langues au sein d'une même phrase. Dans le fil consacré aux réunions multilingues, des développeurs rapportent des zones de transition dégradées lorsque les intervenants alternent finnois et anglais, ou espagnol et anglais, au milieu d'une phrase. Universal-3.5 Pro annonce la prise en charge du code-switching dans 18 langues ; Gladia et Speechmatics mettent en avant la détection multilingue. Aucun fournisseur ne traite parfaitement toutes les paires européennes sans configuration : testez vos couples de langues réels.
- Diarisation à grande échelle. Demandez combien de locuteurs sont pris en charge — ElevenLabs en annonce 32 en batch, Azure 35, Speechmatics ne précise pas de plafond en temps réel —, si la diarisation live existe réellement, ainsi que son impact sur le prix et le délai. Le même auteur du benchmark suédois jugeait le délai de traitement d'AssemblyAI trop long pour son pipeline de production, malgré une précision textuelle proche.
- Gros fichiers. OpenAI limite les imports audio à 25 Mo, ce qui complique les enregistrements longs. Les API conçues d'abord pour le batch acceptent les tâches par URL, les fichiers de plusieurs heures et le polling asynchrone persistant. Dans le fil sur la transcription batch, un utilisateur indique qu'il « ne peut pas importer de gros fichiers » et ne comprend pas le traitement par URL : un frein à l'adoption qu'aucun tableau WER ne mesure.
Whisper large-v3 auto-hébergé reste l'option hors ligne. Dans le test sur le même audio d'Echosaw, couvrant 22,7 minutes d'anglais lu et de parole en réunion, les API hébergées sont restées sous 2,1 % de WER sur les chapitres propres. Une configuration Whisper à deux vCPU a en revanche obtenu 10 à 17 % avec des segments perdus, puis 32,7 % sur l'audio de réunion à 0,5x le temps réel. En production, l'auto-hébergement repose généralement sur un GPU, avec VAD et découpage en segments, pour atteindre un débit utilisable.
Cloud, spécialiste ou auto-hébergement ?
- Hyperscaler natif. Google Dynamic Batch à 0,18 $/heure convient aux gros fonds d'archives non urgentes déjà sur GCP ; Standard à 0,96 $/heure pénalise le temps réel. AWS Transcribe s'intègre bien aux flux d'appels S3/IAM avec deux canaux inclus. Azure Speech facture le batch autour de 0,18 $/heure et le temps réel autour de 1,00 $/heure, avec un palier gratuit temps réel de 5 heures/mois. Intégrez les frais de stockage, de transfert et de masquage en dehors de la ligne transcription.
- Batch managé économique. Groq Whisper Turbo à 0,04 $/heure est moins cher que toute API managée pour des lots batch simples, mais n'offre ni streaming ni diarisation indiquée. Soniox, autour de 0,10 $/heure en asynchrone, affiche le plus bas tarif batch du tableau avec plus de 60 langues, diarisation et horodatages inclus, mais bénéficie d'une couverture plus limitée par les benchmarks indépendants.
- Pipeline hybride. Utilisez ElevenLabs pour le texte lorsqu'il est meilleur, Deepgram pour la diarisation lorsqu'il domine, et Whisper ou Groq pour les lots de débordement à bas coût. Cette approche ajoute un coût d'orchestration ; mais si aucun fournisseur ne domine à la fois le texte et les étiquettes de locuteur sur vos audios, deux appels peu coûteux valent mieux qu'une coûteuse passe de correction.
À noter pour la migration : OpenAI marque whisper-1, gpt-4o-transcribe, gpt-4o-mini-transcribe et gpt-4o-transcribe-diarize comme obsolètes, avec un arrêt prévu le 26 février 2027. Les équipes qui utilisent encore ces modèles doivent tester les remplaçants avant cette échéance, en particulier si les comportements de diarisation et d'horodatage des mots diffèrent.
Testez sur vos propres audios pendant 7 jours
Les chiffres WER des fournisseurs reposent sur des jeux de données, des normalisations et des versions de modèles différents : ils ne sont pas directement comparables. Rassemblez 30 à 50 tours d'appelants ou segments de réunion réels, représentatifs de vos accents, nuisances sonores et termes métier. Transcrivez manuellement la référence une fois, puis envoyez ou streamez exactement les mêmes audios vers deux ou trois fournisseurs sans modifier le reste de votre pipeline.
Journalisez les secondes audio, le nombre de canaux, les fonctions activées, la version du modèle, la latence des partiels, le délai de finalisation, le délai agent de bout en bout, le taux d'erreur de diarisation et les minutes de correction par transcription validée. Évaluez séparément les tokens critiques pour l'activité — noms, e-mails, montants, termes produits — du WER général. La solution la moins chère à l'heure qui double le temps de relecture humaine perd généralement sur le coût total.
FAQ
Quelle est l'API de transcription la moins chère en 2026 ?
Soniox autour de 0,10 $/heure et AssemblyAI Universal-2 à 0,15 $/heure sont les tarifs catalogue batch managés les plus bas du tableau ci-dessus avec prise en charge de la diarisation. Groq Whisper Turbo, à 0,04 $/heure, est encore moins cher pour du batch brut sans streaming ni diarisation.
Quelle API offre la plus faible latence en streaming ?
D'après la synthèse des annonces fournisseurs de Dexto : ElevenLabs annonce ~150 ms de latence modèle, Deepgram ~260 ms de fin de tour, Speechmatics une finalisation moyenne <350 ms. Testez les délais partiels, de finalisation et de bout en bout sur vos propres appels.
Quelle API STT choisir pour un agent vocal ?
Deepgram Flux pour la prise de tour native, AssemblyAI pour les prompts contextuels, ElevenLabs Realtime pour une large couverture linguistique dans une pile vocale ElevenLabs, et la transcription live d'OpenAI pour les piles nativement OpenAI capables d'implémenter l'endpointing.
Quelle API gère le mieux l'audio multilingue et le code-switching ?
ElevenLabs (90+), AssemblyAI U2 (99 ; 3.5 Pro 18 avec code-switching), Gladia Solaria-1 (100+), Speechmatics (55+). Testez précisément votre paire de langues : l'alternance en milieu de phrase dégrade encore les transitions.
Faut-il choisir un seul fournisseur ou séparer transcription et diarisation ?
Si un fournisseur domine le texte mais reste moins bon sur les étiquettes de locuteur dans vos audios, comme dans le rapport suédois à six intervenants lié plus haut, combiner les fournisseurs peut être préférable à l'un ou l'autre seul. Comparez le coût d'orchestration et la double facturation au temps de correction économisé.
OpenAI Whisper va-t-il être arrêté ?
OpenAI a marqué comme obsolètes d'anciens modèles de transcription, dont whisper-1 et les variantes gpt-4o-transcribe, avec un arrêt prévu le 26 février 2027. Les voies actuelles sont gpt-transcribe pour les fichiers et gpt-live-transcribe pour l'audio en direct.
| Charge de travail | Commencez par | Pourquoi |
|---|---|---|
| Grande archive d'enregistrements | AssemblyAI U2 / Google Dynamic Batch / Groq Whisper | Coût horaire minimal ; Groq est le moins cher sans besoin de diarisation |
| Agent vocal en direct | Deepgram Flux / AssemblyAI Realtime / ElevenLabs Realtime | Prise de tour, prompts contextuels, faible latence modèle |
| Réunions multilingues | ElevenLabs Scribe v2 / Speechmatics / Gladia | Positionnement 90+/55+/100+ langues, conception pour le code-switching |
| Natif AWS ou GCP | Transcribe / Cloud STT | IAM, stockage et achats l'emportent sur le tarif catalogue |
| Hors ligne ou résidence des données | Whisper auto-hébergé | L'audio ne quitte jamais votre matériel |
À lire aussi : Best Text-to-Speech API, Best Voice Cloning API 2026, Gemini 3.5 Transcribe API Guide.