 AIREITER
Tant qu'une requête ne dépasse pas 100 000 tokens, Haiku 5.5 coûte vingt fois moins cher que Sonnet 5.5. Au-delà, l'écart retombe à 4x — et les boucles d'agents atteignent ce seuil bien plus vite que la plupart des équipes ne l'imaginent. Pour les tâches API courtes et répétitives, Haiku 5.5 fait très bien l'affaire ; pour le débogage et le code en plusieurs étapes, Sonnet 5.5 justifie toujours son surcoût.
Un tarif 20 fois inférieur... jusqu'au seuil des 100K tokens
Claude Haiku 5.5 et Claude Sonnet 5.5 affichent les mêmes capacités sur le papier, mais pas la même facture. Les deux modèles proposent une fenêtre de contexte de 1M de tokens et une sortie maximale de 128K tokens ; leurs identifiants sont respectivement claude-haiku-5-5 et claude-sonnet-5-5. Sonnet 5.5 est sorti le 28 septembre 2026, et Haiku 5.5 le 7 octobre 2026, selon les annonces d'Anthropic pour Haiku 5.5 et d'Anthropic pour Sonnet 5.5. La documentation de la plateforme Claude pour Sonnet 5.5 confirme les mêmes limites : 1M de contexte et 128K de sortie.
| Caractéristique | Claude Haiku 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| ID du modèle | claude-haiku-5-5 | claude-sonnet-5-5 |
| Sortie | 7 oct. 2026 | 28 sept. 2026 |
| Contexte / sortie max. | 1M / 128K | 1M / 128K |
| Entrée / sortie sous 100K | 0,10 $ / 0,50 $ par 1M | 2 $ / 10 $ par 1M |
| Entrée / sortie au-delà d'un prompt de 100K | 0,50 $ / 2,50 $ par 1M | 2 $ / 10 $ par 1M (sans palier) |
| Lecture du cache | 0,01 $ par 1M | 0,10 $ par 1M |
| Effort par défaut | medium | high |
Ces prix correspondent aux tarifs catalogue d'Anthropic. Dès que les tokens du prompt dépassent 100 000, Haiku 5.5 applique son palier supérieur à l'intégralité de la requête, y compris aux lectures et écritures de cache, selon le récapitulatif des tarifs Anthropic par APIKO.
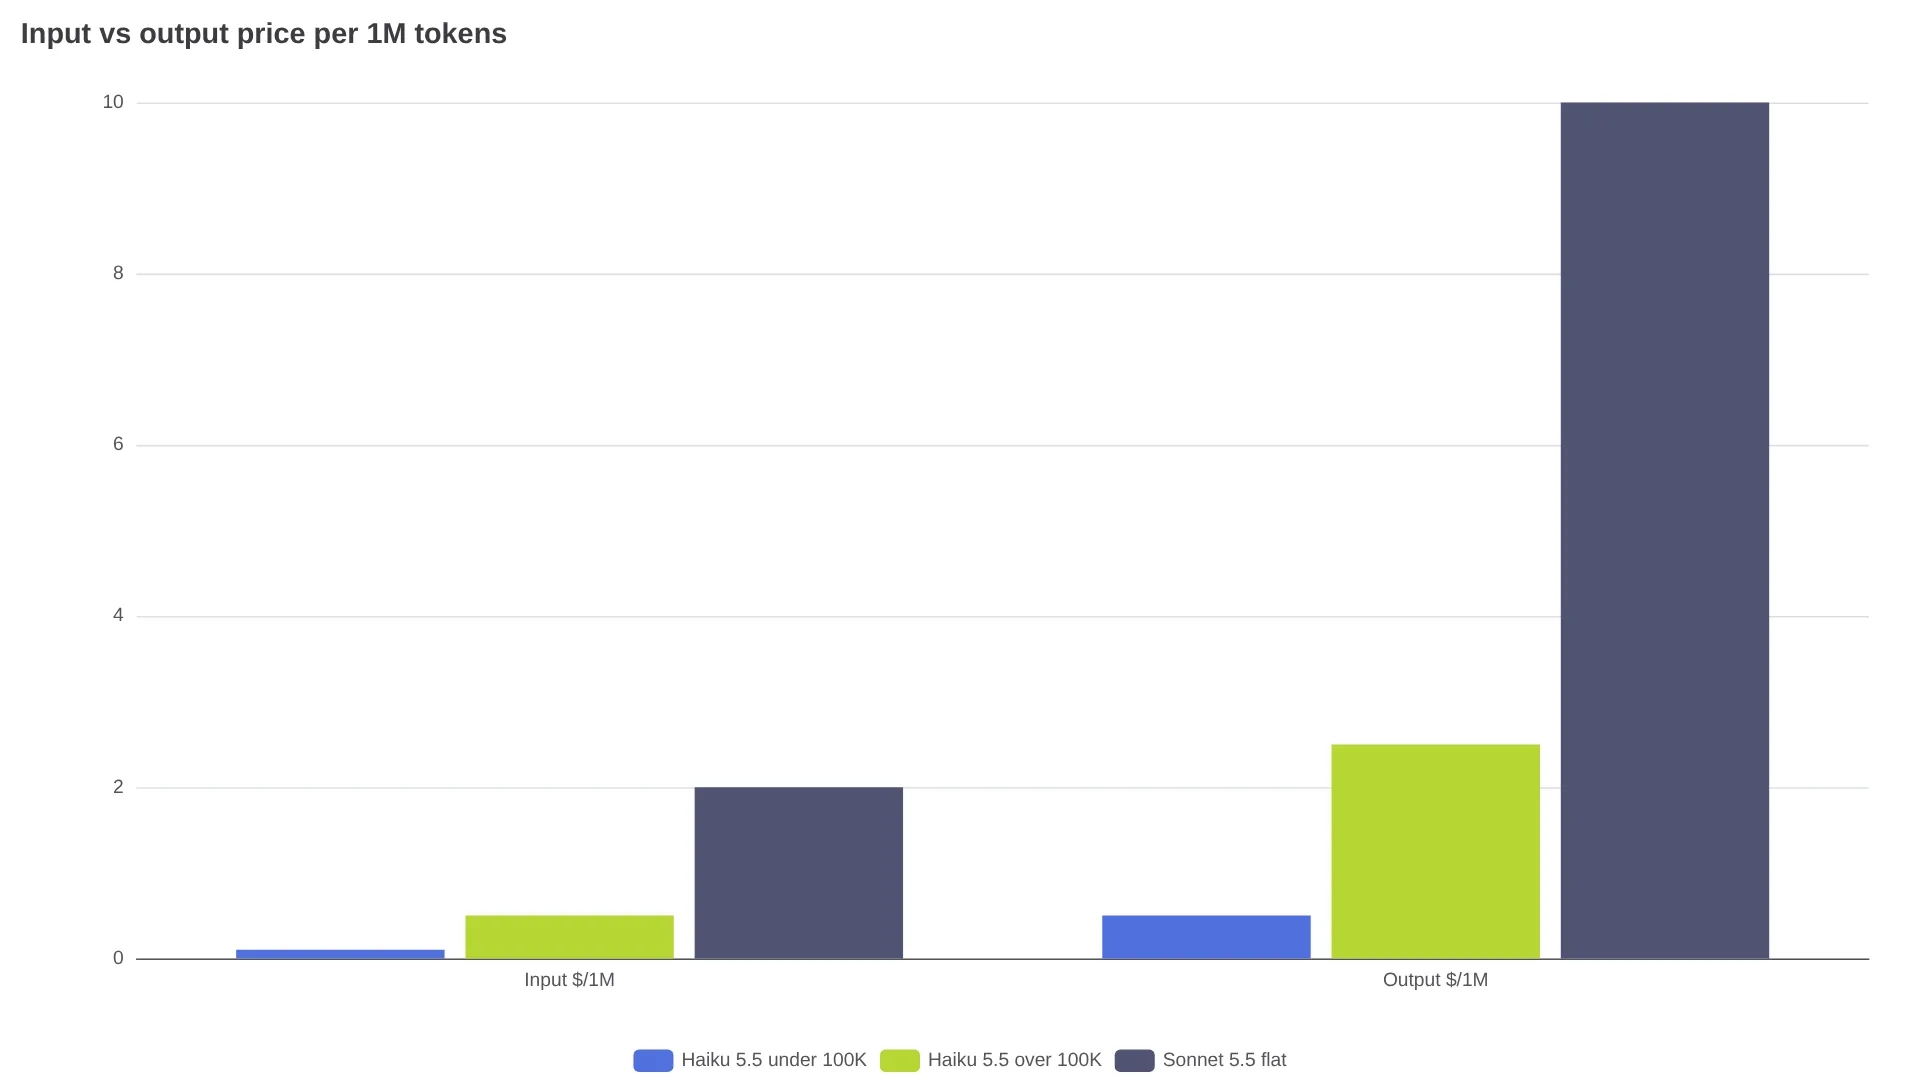
Pour 1 000 documents identiques de 99K tokens avec 1K token de sortie chacun, le lot revient à environ 10,40 $ au tarif catalogue — APIKO annonce 4,54 $ pour le même lot à ses propres tarifs. Avec 1 000 documents de 101K tokens, la facture atteint environ 53,00 $ au tarif catalogue : cinq fois plus pour seulement 2 000 tokens supplémentaires par document. À comparer aux quelque 212,00 $ de Sonnet 5.5 pour le même lot de 101K. Ce calcul découle directement des tarifs catalogue rapportés dans le test Haiku 5.5 vs Sonnet 5.5 d'APIKO. Un lot modélisé de 1 000 appels comprenant chacun 10K tokens d'entrée et 1K de sortie coûte 30,00 $ avec Sonnet 5.5, contre 1,50 $ avec Haiku 5.5 : une réduction de 95 %, d'après le comparatif tarifaire Sonnet 5.5 vs Haiku 5.5 de Sim.
Les boucles d'agents atteignent ce seuil presque mécaniquement. Dans un fil r/ClaudeAI consacré à l'usage des tokens de Haiku 5.5, un utilisateur a constaté le franchissement des 100K vers le vingtième appel au modèle ; 145 des 164 appels suivants ont alors été facturés au palier supérieur, car l'historique et les sorties d'outils s'accumulent. Les pistes proposées dans ce fil : découper davantage les tickets, cibler précisément les fichiers, réduire les sorties de test et lancer de nouveaux sous-agents plutôt que de conserver une conversation interminable. Les tâches courtes restent très abordables sur Haiku. Les pipelines à contexte long doivent intégrer Sonnet au budget.
« Le prix avantageux de Haiku 5.5 ne tient que sous 100K de contexte. Au-delà de 100K tokens d'entrée, le prix est multiplié par 5 ; les petites tâches comme la traduction et les résumés permettent d'économiser, tandis que les travaux à contexte long devraient passer sur Sonnet. » — @zookmas1314
Consultez aussi les tarifs de l'API Claude Haiku 5.5 et notre test et les tarifs de l'API Claude Sonnet 5.5 pour une analyse détaillée de chaque modèle.
Ce que révèlent les benchmarks Haiku 5.5 vs Sonnet 5.5
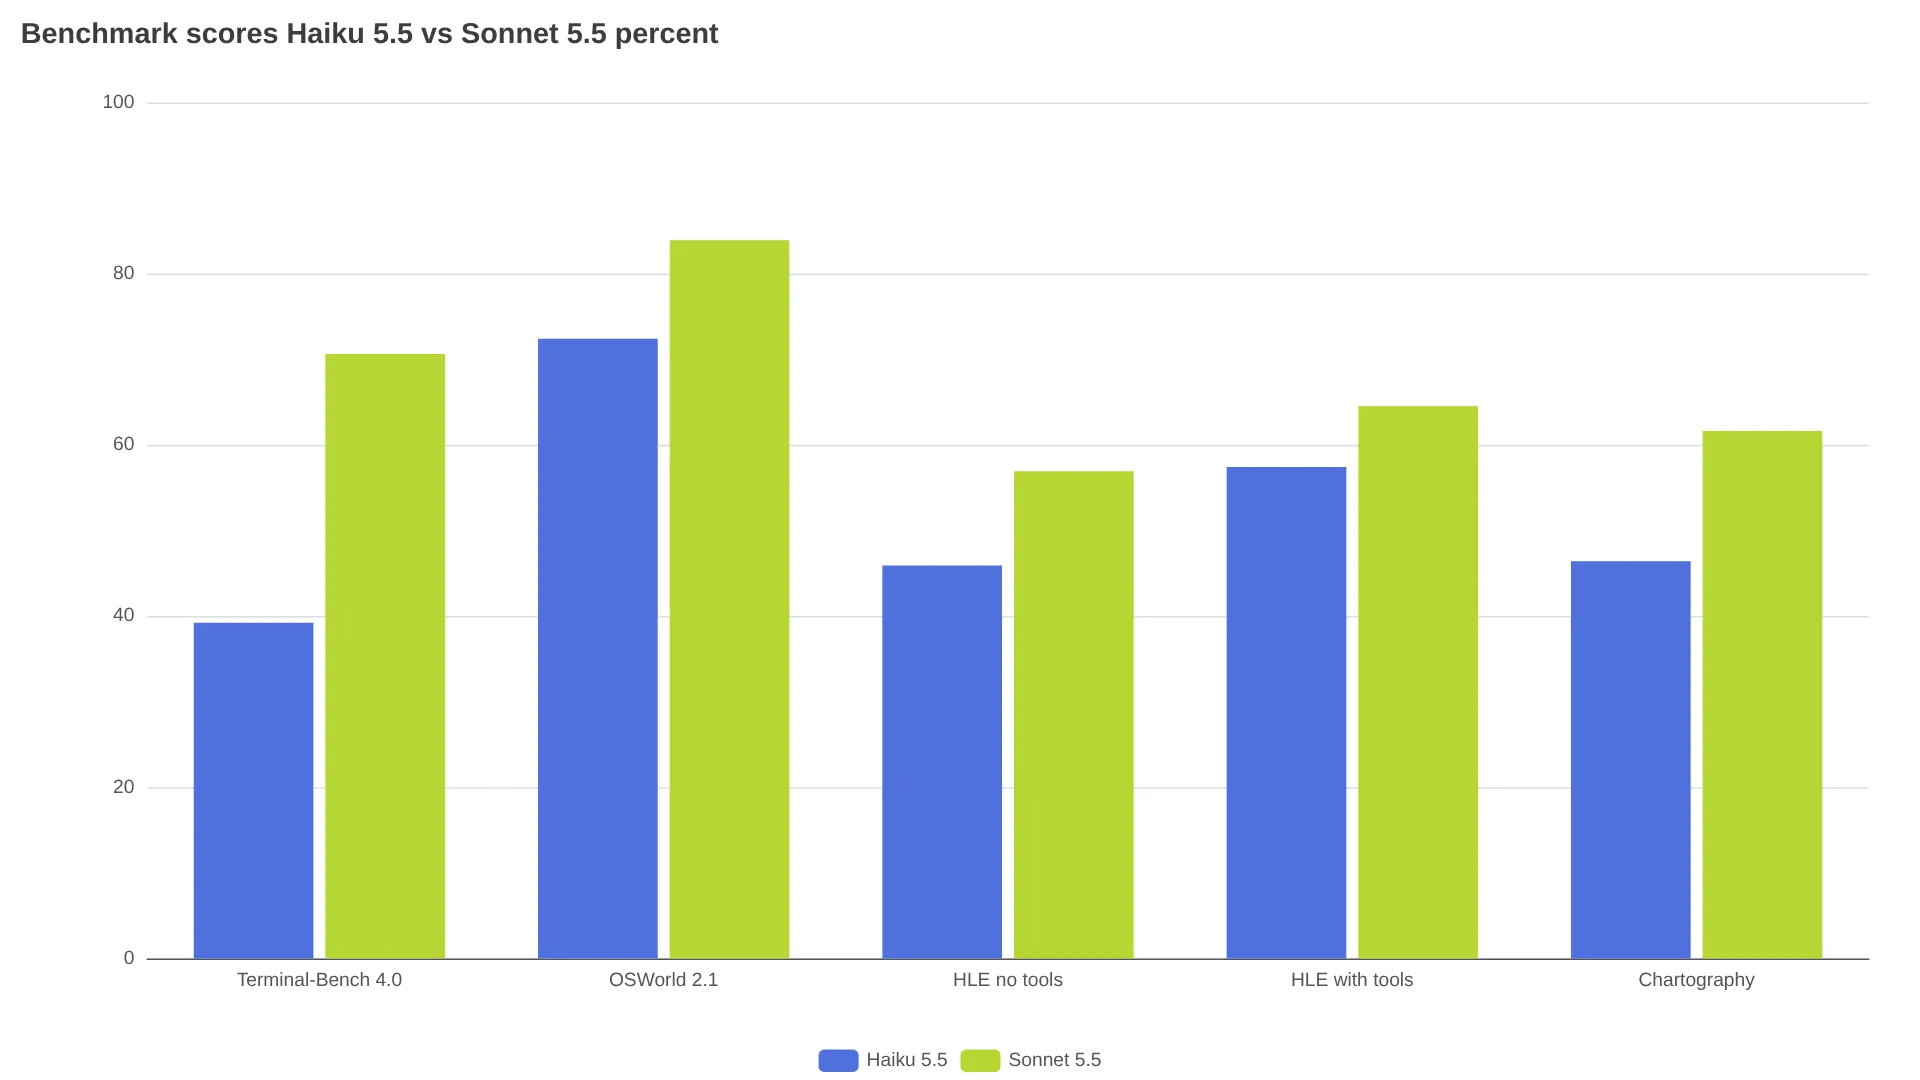
Dans tous les résultats comparatifs publiés par Anthropic, Sonnet 5.5 devance Haiku 5.5. L'écart est particulièrement net lorsque les agents doivent écrire et exécuter du code. Sur Terminal-Bench 4.0 pour le code agentique, Haiku 5.5 obtient 39,2 % contre 70,6 % pour Sonnet 5.5. L'écart est plus resserré sur l'usage d'ordinateur avec OSWorld 2.1 : 72,4 % contre 83,9 %. Sur Humanity's Last Exam sans outils, les scores sont de 45,9 % et 56,9 %, puis de 57,4 % et 64,5 % avec outils, selon le tableau de benchmarks compilé dans le comparatif d'APIKO.
Le réglage d'effort peut réduire ou élargir ces écarts. Les résultats d'Artificial Analysis cités dans ce même comparatif placent Haiku xhigh et Sonnet medium à 41 sur l'Intelligence Index, avec des scores Terminal-Bench presque identiques, 29,3 % contre 29,8 %. Mais Haiku xhigh coûtait 0,12 $ par tâche, contre 0,48 $ pour Sonnet medium, en prenant 295 secondes au lieu de 122 secondes. Aucune configuration de Haiku n'a atteint le score de 47 obtenu par Sonnet avec son réglage par défaut high dans ce jeu de données. Ces coûts ne prennent pas en compte le palier Haiku au-delà de 100K : pour les tâches à contexte long, considérez-les donc comme un plancher.
L'extraction ou la classification ciblée n'ont pas besoin de la marge de Sonnet en programmation. En revanche, les agents de code principaux, les longues boucles d'outils et le raisonnement visuel — Chartography affiche 46,4 % contre 61,6 % — en bénéficient. Un score Elo ou un indice unique ne constitue pas un classement universel de la qualité. Un test Reddit a par exemple trouvé que Haiku-medium égalait Sonnet sur une base de code mixant Rust et code historique, pour 0,08 $ contre 1,68 $. Dans le même workflow, Haiku-high a effectué 385 requêtes sans gain de qualité, selon le test contrôlé de Haiku 5.5 pour le code sur r/ClaudeCode.
Le niveau d'effort compte davantage que le nom du modèle
Le réglage d'effort par défaut explique une bonne partie des remarques du type « Haiku est trop verbeux ». Haiku 5.5 utilise medium par défaut, quand Sonnet 5.5 utilise high ; leur configuration du raisonnement diffère également. Haiku désactive le raisonnement avec {"type": "disabled"}, tandis que Sonnet emploie {"type": "between_tools"} avec un effort high ou inférieur, puis adaptive ou aucun paramètre de raisonnement en xhigh/max, comme l'indiquent la documentation de la plateforme Claude et les notes d'APIKO sur le comportement des modèles.
Lors de l'évaluation d'APIKO du 10 octobre 2026 sur l'endpoint Messages — 22 tâches et 528 requêtes — Haiku en low a réussi 65 exécutions sur 66, contre 64 à 66 pour Sonnet selon la configuration, pour un coût via la passerelle d'environ un dix-huitième sur ces tâches courtes. Désactiver entièrement le raisonnement a fait tomber Haiku à 56 sur 66, avec des échecs surtout concentrés sur le raisonnement et le respect strict de format, par exemple une somme CSV ou le suivi d'exécution d'un code. Haiku avec son réglage par défaut medium a réussi les 66 exécutions, mais a généré 4,4x plus de tokens de sortie que Haiku en low, principalement des tokens de raisonnement.
Quelques règles pratiques tirées de ces données et des retours utilisateurs :
- Commencez en Haiku
low. Pour les tâches bornées — classification, routage, extraction, JSON court — évitez le réglage par défautmedium. - Montez Haiku avant de basculer vers Sonnet. Essayez Haiku
highouxhighavant Sonnetlowsi vous cherchez une meilleure qualité tout en restant proche des tarifs Haiku. Selon les chiffres d'Artificial Analysis cités dans le comparatif d'APIKO, Haikumaxa obtenu 43 contre 36 pour Sonnetlow, pour environ 60 % du coût. - Réservez Sonnet
mediumet plus aux tâches qui le justifient. Débogage, implémentation multi-étapes et longues séquences d'outils sont les cas où la latence supplémentaire de Haiku-high n'apporte plus de gain de qualité. - Définissez explicitement le raisonnement selon le modèle. Dans du code partagé, un template envoyant
between_toolsà Haiku oudisabledà Sonnet déclenche une erreur 400 en amont, selon le test de passerelle d'APIKO.
« Opus/Sonnet comme orchestrateur principal et relecteur, et Haiku comme exécutant, avec une nouvelle instance Haiku par fonctionnalité. » — u/ohrajaaa sur r/ClaudeAI
Routez selon le coût d'une erreur silencieuse, pas selon la difficulté
La bonne question de routage n'est pas « cette tâche est-elle difficile ? », mais « que se passe-t-il si Haiku se trompe de manière plausible sans qu'aucun relecteur ne le voie ? ». Plusieurs tests utilisateurs cités arrivent à la même conclusion : Haiku échoue discrètement sur les tâches de jugement, tandis que Sonnet devient rentable lorsque la vérification coûte cher.
| Si la tâche ressemble à | Modèle principal |
|---|---|
| Classification de sentiment, routage de tickets, conversion de permis en JSON, résumés de logs, OCR et annotation, sélection SQL, sous-agents de compaction | Haiku 5.5 |
| Recherche dans une base de code, modifications d'un seul fichier, traitement de documents en un tour | Haiku 5.5 |
| Agent de code principal, véritable débogage, refactorings multi-étapes, vérification de faits, attribution de documents | Sonnet 5.5 |
Des utilisateurs signalent une vitesse multipliée par 3 et de fortes baisses de consommation sur des usages Haiku en un seul tour et à gros volume. Un cas évoque notamment le traitement de plusieurs mégaoctets de documents pour quelques dollars, selon la discussion r/ClaudeAI « What is Haiku 5.5 best suited for? ».
Une comparaison de sous-agents sur six tâches a trouvé Haiku peu coûteux, mais sensiblement moins fiable pour la recherche et le jugement factuel, avec des fichiers oubliés qui « donnent l'impression d'un résultat propre », selon le test de sous-agents Haiku vs Sonnet vs Opus sur r/ClaudeCode. La règle de sécurité proposée dans ce fil est sans détour :
« Si la sortie déclenche une action… elle part soit vers un modèle plus grand, soit elle est contrôlée par un modèle plus grand. » — u/vladgladi sur r/ClaudeCode
Un point d'attention en production : le respect des sorties structurées n'est pas acquis avec Haiku. L'évaluation d'APIKO a relevé un écart de format strict en low — les bonnes étiquettes étaient contenues dans un objet JSON au lieu d'un tableau brut — et des utilisateurs de r/ClaudeCode rapportent des vérifications sautées ou des contraintes ignorées à faible effort, d'après ce même test contrôlé de programmation.
Une architecture Haiku-first viable en production
Le code d'intégration doit gérer les particularités de chaque modèle : raisonnement, choix d'outil et historique, selon le test de passerelle APIKO du 10 octobre sur les patterns documentés. Haiku accepte un tool_choice forcé, alors que Sonnet le refuse en amont — utilisez auto ou des sorties structurées. Haiku ne peut pas lire les blocs de raisonnement de Sonnet ; Sonnet peut lire ceux de Haiku si l'historique reste append-only. Rejouer des blocs Sonnet modifiés peut renvoyer une erreur 400.
Voici le pattern Haiku-first vers lequel convergent indépendamment de nombreux utilisateurs :
- Premier passage avec Haiku 5.5 en
low. Utilisez-le pour classifier, extraire ou produire un brouillon. Pour désactiver totalement le raisonnement, employezthinking: {"type": "disabled"}. - Validez avant d'accepter. N'acceptez que des libellés autorisés ou du JSON valide selon le schéma ; faites remonter à Sonnet 5.5 en
mediumtout résultat incertain, invalide ou à conséquence. - Gardez des sous-agents jetables. Lancez une instance Haiku par fichier ou par fonctionnalité au lieu de faire grossir une seule conversation au-delà de 100K.
- Ajoutez Sonnet ou Opus comme relecteur. C'est indispensable dès qu'une sortie déclenche une action, envoie un message ou modifie du code de production.
« Haiku est très bon si vous savez quoi lui demander et comment évaluer la qualité de son travail. » — u/Awric sur r/ClaudeCode
Anthropic présente Haiku 5.5 comme un sous-agent adapté aux tâches à fort volume, telles que les résumés, aux côtés de Sonnet ou Opus, selon @ClaudeDevs. Une configuration partagée utilise des essaims de Haiku pour chercher dans un dépôt, pendant que Sonnet conserve les diffs et les tests, selon @mirku21.
FAQ : Haiku 5.5 vs Sonnet 5.5
À quel point Haiku 5.5 est-il moins cher que Sonnet 5.5 ?
Aux tarifs catalogue, Haiku est 20 fois moins cher sous 100K tokens de prompt — 0,10 $/0,50 $ contre 2 $/10 $ par 1M — et 4 fois moins cher au-delà de 100K — 0,50 $/2,50 $ contre 2 $/10 $. La lecture du cache coûte 0,01 $ contre 0,10 $ par 1M.
Haiku 5.5 et Sonnet 5.5 ont-ils la même fenêtre de contexte ?
Oui. Tous deux annoncent une fenêtre de contexte de 1M de tokens et une sortie maximale de 128K, d'après Anthropic et la documentation de la plateforme.
Haiku 5.5 est-il suffisamment fiable pour une API en production ?
Oui pour les tâches ciblées, à gros volume et facilement contrôlables, généralement avec l'effort low et une validation de schéma. Pour le code piloté par un agent principal et la recherche exigeant beaucoup de jugement, les utilisateurs rapportent davantage d'erreurs et de faux positifs qu'avec Sonnet 5.5.
Quel modèle choisir pour des agents de code ?
Sonnet 5.5 pour l'agent principal et le débogage — 70,6 % contre 39,2 % sur Terminal-Bench. Haiku 5.5 pour la recherche, la saisie de code et les sous-agents sur un seul fichier, avec relecture par Sonnet ou Opus.
Comment rester sous le seuil tarifaire des 100K de Haiku ?
Découpez les documents avant le seuil, limitez les sous-agents aux fichiers ciblés, réduisez les sorties de test trop bavardes et créez de nouveaux sous-agents par tâche. L'historique agentique franchit les 100K en une vingtaine d'appels environ.
Puis-je passer d'une conversation Sonnet 5.5 à Haiku 5.5 en cours de route ?
Pas proprement. Haiku ne peut pas lire les blocs de raisonnement de Sonnet : restez donc sur Sonnet ou redémarrez avec Haiku. Faire évoluer un historique Haiku vers Sonnet préserve le raisonnement si l'historique reste append-only.
Le compromis auquel aucun routage n'échappe
| Si votre charge ressemble à | Choisissez | Pourquoi |
|---|---|---|
| Des centaines de classifications, extractions, résumés et normalisations JSON | Haiku 5.5 en low | Des taux de réussite proches de Sonnet sur les tâches courtes, pour environ 1/18 du coût lorsque les résultats sont validés |
| Une grosse base de code, de longues boucles d'outils, un débogage qui doit être juste | Sonnet 5.5 | 31 points d'avance sur Terminal-Bench et moins d'erreurs silencieuses |
| Des documents à cheval sur le seuil de 100K | Chiffrez les deux | Le palier Haiku multiplié par 5 efface l'essentiel de l'écart ; Sonnet ne coûte plus que 4 fois plus au-dessus du seuil |
| Tout cas où une erreur discrète part en production | Brouillon Haiku, relecture Sonnet | Le coût par réussite vérifiée compte plus que le prix nominal du token |
Haiku 5.5 l'emporte sur le prix par tentative. Mais Sonnet peut coûter moins cher dès que la relecture et les nouvelles tentatives pèsent davantage que les tokens. Construisez votre routeur autour de cette distinction : aucun des deux modèles ne sera alors un pari.