 AIREITER
Muse Spark 1.3 aparece actualmente en OpenRouter con un precio de 1,25 dólares por millón de tokens de entrada y 4,25 dólares por millón de tokens de salida, pero esa cifra no basta para decidir si merece la pena. El modelo resulta especialmente interesante para programación con contextos largos y tareas con agentes; el lanzamiento aún es reciente, el modo de razonamiento máximo no estaba activo al publicarse y la latencia hasta el primer token puede ser elevada.
Qué es Muse Spark 1.3 y qué significa que esté “disponible”
Muse Spark 1.3 es el modelo propietario de razonamiento de Meta para tareas prolongadas con agentes, programación y trabajos multimodales. Meta lo anunció el 2 de septiembre de 2026 y explicó que comenzaría a desplegarlo en Muse Code y en Meta Model API; los modos de razonamiento existentes estarían disponibles primero, mientras que el razonamiento máximo requería pruebas de seguridad adicionales. (Anuncio de Meta AI Research)
Como el gráfico del lanzamiento incluye resultados del modo máximo, aunque ese modo todavía necesitaba pruebas de seguridad adicionales, no conviene asumir que esas cifras se podrán reproducir desde el primer día.
Meta afirma que Muse Spark 1.3 conserva mejor las restricciones durante tareas largas, gestiona las interrupciones dentro de un mismo hilo, formula preguntas de aclaración, solicita confirmación antes de ejecutar acciones importantes y reconoce cuándo se ha quedado atascado. También asegura que realiza aproximadamente un 20 % menos de llamadas a herramientas y utiliza un 25 % menos de tokens que Muse Spark 1.2 en comparativas internas de programación. Son cifras comunicadas por el proveedor, sin un conjunto de tareas reproducible ni márgenes de error.
La publicación del lanzamiento presenta los pesos abiertos como una posibilidad futura. Las fuentes revisadas aquí describen Muse Spark 1.3 como un modelo alojado y accesible únicamente mediante API, y no documentan ningún checkpoint descargable, licencia confirmada, número de parámetros ni requisito de hardware.
El precio de la API es sencillo; calcular el coste real, no tanto
La tarifa pública más clara está en la página de Muse Spark 1.3 en OpenRouter, no en la publicación de lanzamiento de Meta. OpenRouter indica unas tarifas estándar de 1,25 y 4,25 dólares por millón de tokens de entrada y salida, respectivamente, además de cargos independientes por lecturas de caché y búsquedas web.
| Uso | Precio indicado | Qué conviene vigilar |
|---|---|---|
| Entrada | 1,25 $ / 1 M de tokens | Tokens nuevos del prompt y del contexto |
| Salida | 4,25 $ / 1 M de tokens | Aproximadamente 3,4 veces la tarifa de entrada |
| Lectura de caché | 0,15 $ / 1 M de tokens | Útil para contextos repetidos en agentes |
| Búsqueda web | 2,50 $ / 1.000 llamadas | Se cobra aparte de los tokens |
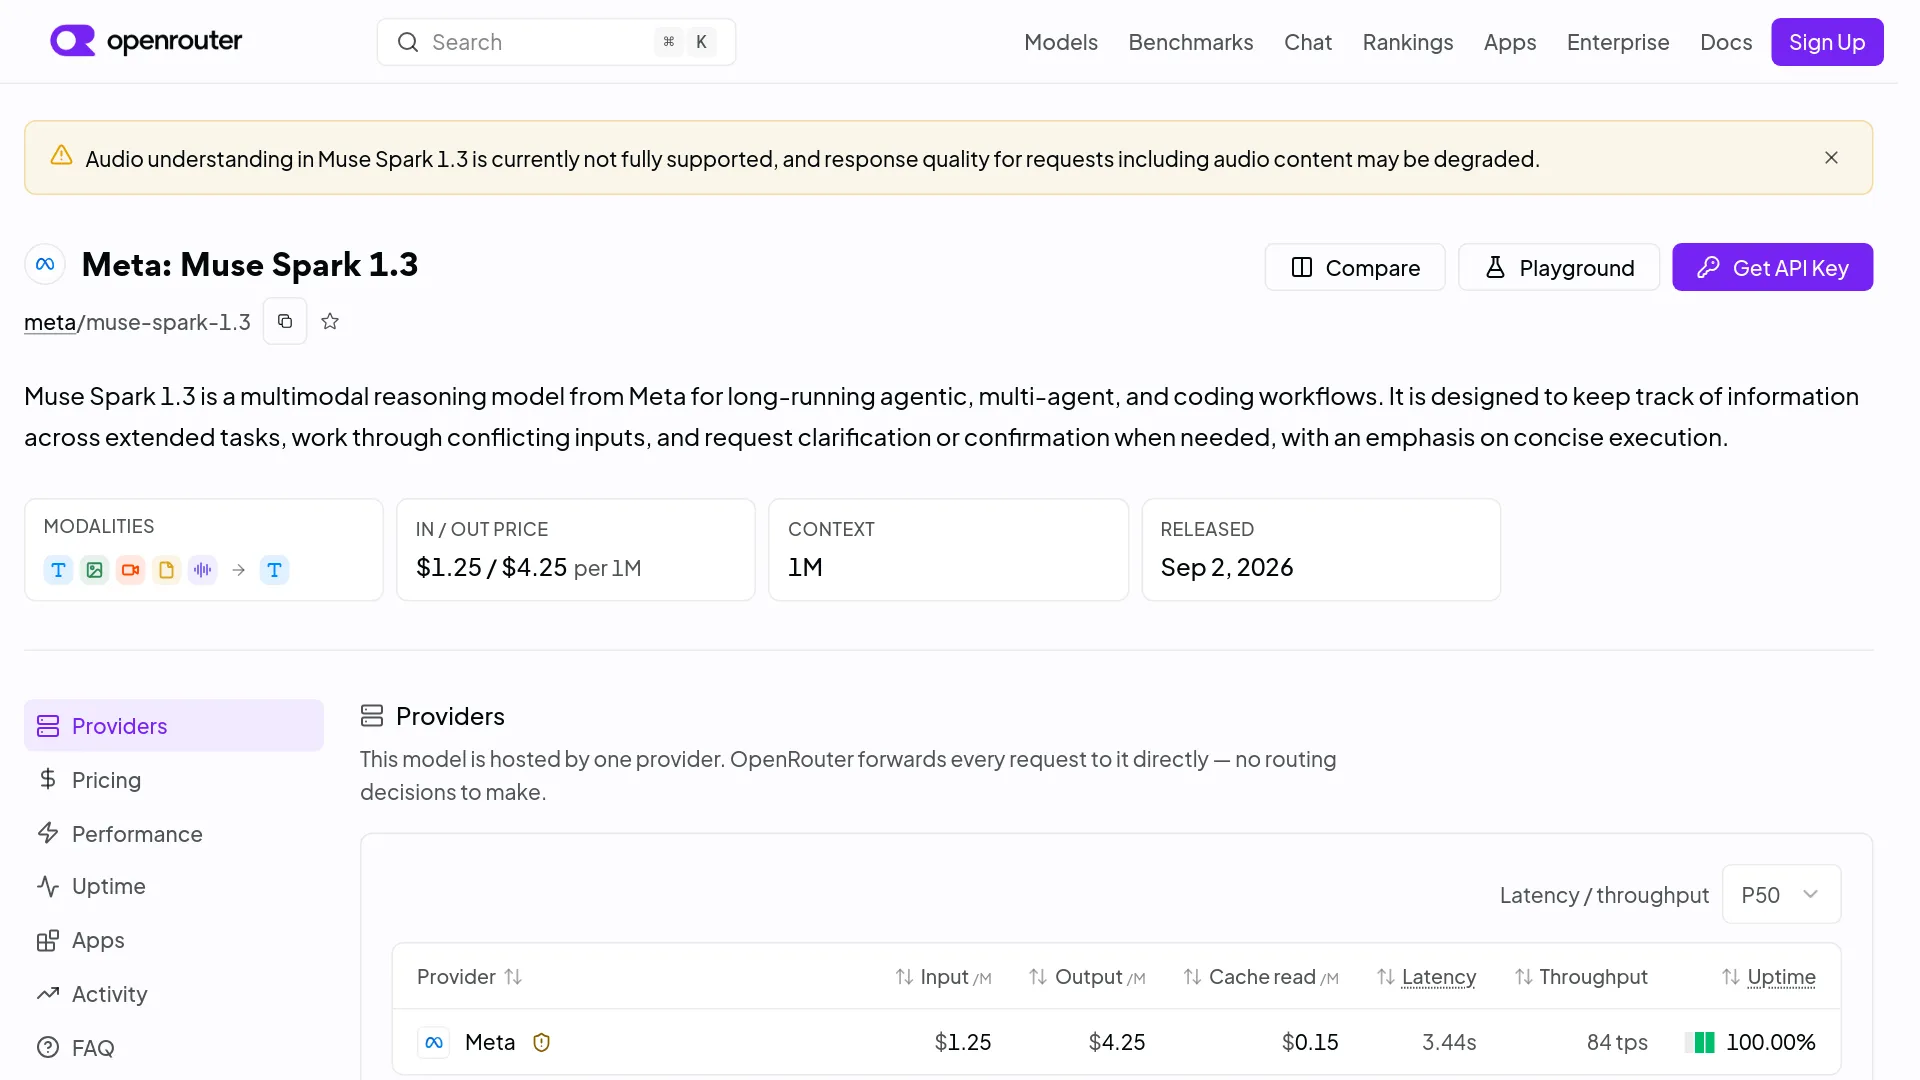
Una petición con 100.000 tokens de entrada nuevos y 20.000 tokens de salida cuesta aproximadamente 0,21 dólares antes de sumar la caché o las búsquedas web: 0,125 dólares por la entrada y 0,085 por la salida. Los bucles de agentes, los reintentos y el contexto repetido encarecen las tareas completas.
Artificial Analysis informa de un precio combinado de 0,78 dólares por millón de tokens, calculado con una combinación de 7:2:1 entre aciertos de caché, entrada y salida. Los flujos con contexto nuevo o con mucho contenido de salida costarán más, así que conviene interpretar esta cifra como una estimación para un escenario concreto, no como una tarifa universal.
No traslades automáticamente a Muse Spark 1.3 las condiciones de Contributor de la guía de precios de la API de Muse Spark 1.2. La ficha pública de la versión 1.3 establece la tarifa estándar anterior, pero las fuentes revisadas aquí no confirman un contrato completo de Contributor para 1.3 que cubra el uso de datos, los límites de velocidad o la disponibilidad regional. Hasta que tu proveedor confirme lo contrario, calcula el presupuesto con la tarifa estándar.
Los datos apuntan a un modelo de programación potente, no a un ganador absoluto
La evidencia respalda a Muse Spark 1.3 como un modelo sólido para programación y contextos largos, pero no como líder universal. La tabla utiliza las puntuaciones de la metodología de evaluación enlazada por Meta; las escalas de los benchmarks son distintas, y una cifra más alta solo se puede comparar dentro de su propia fila.
| Evaluación | Muse 1.3 max | Muse 1.3 xhigh | Muse 1.2 xhigh | GPT-5.6 Sol | Claude Opus 5 | Valor más alto mostrado |
|---|---|---|---|---|---|---|
| MRCR 512K–1M | 98.1 | 93.1 | 55.5 | 73.8 | — | Muse 1.3 max |
| DeepSWE v1.1 | 75.4 | — | 55.0 | 73.0 | 74.0 | Muse 1.3 max |
| SWE-Atlas Codebase QnA | 59.4 | 54.0 | 46.2 | 53.5 | 52.7 | Muse 1.3 max |
| Terminal-Bench 2.1 | 88.8 | 89.2 | 82.9 | 88.8 | 86.7 | Muse 1.3 xhigh |
| OSWorld 2.0 | 66.9 | 57.2 | 47.6 | 62.7 | 68.3 | Claude Opus 5 |
| DeepSearchQA | 89.4 | 89.4 | 85.9 | 93.0 | 90.4 | GPT-5.6 Sol |
| GDPVal-AA v2 | 1754 | 1709 | 1615 | 1710 | 1824 | Claude Opus 5 |
El mejor argumento a favor de Muse Spark 1.3 está en la programación con contexto largo: su resultado máximo es de 98.1 en MRCR con un contexto de 512K–1M y de 75.4 en DeepSWE, frente a 55.5 y 55.0 de Muse Spark 1.2 xhigh. La misma tabla también muestra alternativas superiores en algunas evaluaciones de trabajo profesional, uso de ordenadores y navegación web.
La metodología de Meta explica que las celdas pueden proceder de evaluaciones de Meta, de una clasificación oficial o de resultados comunicados por un proveedor. Las pruebas de programación utilizaron herramientas restringidas y no permitieron acceso a Internet externo, por lo que deben verse como señales útiles, no como una comparación independiente repetida de principio a fin.
Artificial Analysis informa de una puntuación de 61 en el Intelligence Index, con el puesto n.º 10 de 196 modelos comparables, frente a una mediana de 36 entre esos modelos. ModelCap muestra un ModelCap Index de 81,7 y el puesto n.º 4 de su clasificación, pero le asigna solo un 20 % de respaldo y una observación de benchmark público. Las diferencias entre sistemas refuerzan una conclusión: la base de evidencia todavía es limitada.
Para un flujo de trabajo real, empieza probando Muse Spark 1.3 en la exploración de repositorios, agentes de terminal de larga duración y preguntas sobre bases de código. No extrapoles esos resultados a cualquier tarea de navegación intensiva o de uso profesional del ordenador.
La paradoja de la velocidad: rápido cuando arranca, lento al principio
Muse Spark 1.3 parece rápido una vez que empieza a generar respuestas, pero el primer resultado visible puede tardar bastante más. Eso lo hace más apropiado para trabajos sostenidos o por lotes que para un ciclo de programación interactiva en el que cada turno debe comenzar de inmediato.
Artificial Analysis registra 181,7 tokens de salida por segundo, frente a una mediana de 68,1 en modelos comparables. También indica 27,51 segundos hasta el primer token, frente a una mediana de 3,04 segundos, y estima 41,26 segundos para una respuesta de 500 tokens en su carga de trabajo. Su página de proveedores muestra 38,51 segundos hasta el primer token de respuesta y un coste de 0,55 dólares por tarea del Intelligence Index.
OpenRouter muestra cifras P50 diferentes: 62 tokens por segundo y 1,83 segundos de latencia. No son métricas directamente intercambiables, porque las páginas utilizan cargas de trabajo y definiciones distintas; además, Artificial Analysis incluye el tiempo de razonamiento en su métrica de primera respuesta. Mide tanto el tiempo hasta el primer token como el tiempo total de la tarea en tu propio sistema de pruebas.
“Como algunos preguntaban, mi primera impresión (lo estoy ejecutando ahora mismo): parece mecánico (excelente para trabajar, no sé si tanto para estrategia) y muy capaz. Parece muy rápido.” — u/NewYak4281, r/singularity
Esta primera impresión, sin controles, coincide con el equilibrio que reflejan las mediciones: generación rápida después de una espera potencialmente larga, junto con un estilo de interacción que puede resultar mecánico. Es un contexto útil, pero no sustituye a una prueba controlada.
Capacidades de la API y límites del despliegue que conviene revisar antes de producción
Muse Spark 1.3 incorpora las funciones de integración habituales en un modelo de agentes moderno, pero varios detalles de producción dependen del proveedor o todavía no se han hecho públicos. La evidencia más sólida disponible sobre la API procede de la página activa del modelo en OpenRouter y del seguimiento de proveedores de Artificial Analysis, no de una especificación pública completa de Meta en la publicación del lanzamiento.
| Capacidad o límite | Evidencia actual | Implicación para producción |
|---|---|---|
| Ventana de contexto | OpenRouter y ModelCap indican 1.048.576 tokens | Confirma el límite efectivo del endpoint |
| Salida máxima | ModelCap indica 944K tokens | Los límites de salida del proveedor pueden ser inferiores |
| Entradas | Texto, imágenes, vídeo y archivos; el audio aparece con una advertencia | Considera incomprendida la compatibilidad con audio |
| Salida | Texto | Diseña un flujo basado en texto |
| Llamadas a herramientas | Figura como compatible | Prueba los esquemas y los errores de herramientas en tu SDK |
| Salida estructurada | Se indica compatibilidad con respuestas en formato JSON Schema | Prueba los fallos con esquemas estrictos |
| Cobertura de proveedores | En la página de OpenRouter y en el seguimiento de Artificial Analysis aparece un proveedor de Meta | No des por hecha la redundancia para conmutación por error |
| Pesos del modelo | Solo mediante API; no aparecen pesos descargables | No hay una vía de autoalojamiento establecida |
ModelCap advierte que un proveedor concreto puede ofrecer un límite de contexto o de salida inferior al máximo publicado. El panel de disponibilidad de OpenRouter muestra un 99,97 % de disponibilidad durante tres días, pero cifras inferiores en sus vistas de 72 y 24 horas. Son métricas distintas de la página, así que utiliza los datos de estado actuales y tus propios registros de errores al dirigir tráfico de producción.
Meta no publica en la nota de lanzamiento el número de parámetros, la arquitectura, los límites formales de la API, las condiciones de licencia ni los resultados detallados de las pruebas de seguridad. Sí afirma que el modelo resiste mejor la inyección de prompts y juzga mejor las acciones irreversibles, pero no aporta tasas de éxito frente a ataques ni un protocolo de red teaming reproducible.
¿Deberías usar Muse Spark 1.3 ya?
Muse Spark 1.3 merece una prueba inmediata en tareas de programación con contexto largo y agentes que utilizan muchas herramientas, especialmente cuando el bajo coste por token y la generación sostenida importan más que una respuesta inicial instantánea. No está preparado para ser el único modelo de producción en sistemas sensibles a la latencia, centrados en audio, con requisitos estrictos de privacidad o que necesiten redundancia crítica.
| Tu situación | Decisión |
|---|---|
| Repositorio grande, preguntas sobre la base de código o tarea larga en terminal | Prueba primero Muse Spark 1.3 |
| Trabajo de agentes por lotes donde importa la velocidad de salida | Buen candidato; mide el coste total de la tarea |
| Programación interactiva en pareja | Úsalo solo si la espera del primer token resulta aceptable |
| Flujo de trabajo basado en audio | Espera o elige una opción con compatibilidad de audio confirmada |
| Código de clientes sensibles o datos regulados | Verifica primero el contrato sobre los datos |
| Servicio crítico que necesita conmutación por error | Mantén un segundo modelo y una ruta alternativa |
Un despliegue gradual y de bajo riesgo aporta más que otra captura de una clasificación:
- Empieza con un repositorio que no contenga información sensible y entre cinco y diez tareas fijas.
- Limita los permisos de shell, escritura de archivos, red y herramientas destructivas a lo estrictamente necesario.
- Registra la tasa de finalización, las llamadas a herramientas, la latencia hasta el primer token, la duración, los tokens y el coste facturado.
- Compara las mismas tareas con tu modelo de referencia actual y conserva una alternativa para los tiempos de espera agotados o las ediciones de baja confianza.
Introduce Muse Spark 1.3 detrás de un indicador experimental para los agentes de programación y decide a partir de la prueba con tu repositorio, no del ranking del día del lanzamiento. El precio y los resultados con contextos largos justifican la prueba; la respuesta inicial lenta, la escasa oferta de proveedores, la compatibilidad de audio incompleta y la cobertura todavía provisional de benchmarks desaconsejan depender exclusivamente de él.
Preguntas frecuentes sobre la API y los precios de Muse Spark 1.3
¿Muse Spark 1.3 se ha lanzado oficialmente?
Sí. El anuncio de Meta del 2 de septiembre de 2026 indica que Muse Spark 1.3 comenzó a desplegarse en Muse Code y Meta Model API. El razonamiento máximo todavía estaba pendiente de pruebas de seguridad adicionales.
¿Dónde puedo acceder a Muse Spark 1.3?
Meta menciona Muse Code y Meta Model API. OpenRouter también incluye meta/muse-spark-1.3; el acceso puede variar según el proveedor, la cuenta y la región.
¿Cuánto cuesta Muse Spark 1.3?
La ficha de OpenRouter muestra 1,25 dólares por millón de tokens de entrada, 4,25 dólares por millón de tokens de salida, 0,15 dólares por millón de tokens leídos de la caché y 2,50 dólares por cada 1.000 llamadas de búsqueda web. Considera estas cifras como las tarifas citadas de OpenRouter, salvo que tu proveedor directo confirme su propia tabla de precios.
¿Muse Spark 1.3 tiene una ventana de contexto de un millón de tokens?
OpenRouter y ModelCap indican 1.048.576 tokens, mientras que Artificial Analysis lo redondea a 1 millón. Confirma los límites efectivos de contexto y salida en el endpoint que vayas a utilizar.
¿Es compatible con visión, vídeo, herramientas y salida JSON?
OpenRouter indica compatibilidad con entradas de texto, imágenes, vídeo y archivos, además de llamadas a herramientas y salidas estructuradas mediante JSON Schema. También incluye el audio, aunque con una advertencia que señala que la comprensión no está plenamente respaldada.
¿Muse Spark 1.3 es de código abierto o se puede autoalojar?
Las fuentes revisadas no establecen la existencia de pesos descargables ni de un paquete para autoalojamiento. Meta presenta los pesos abiertos como trabajo futuro de su hoja de ruta, no como un artefacto disponible de Muse Spark 1.3.
¿Está disponible el razonamiento máximo?
Meta indicó que primero estarían disponibles los modos de razonamiento existentes y que el razonamiento máximo llegaría después de pruebas de seguridad adicionales. El anuncio no ofrecía una fecha concreta.
¿Puedo asumir que los precios de Contributor de Muse Spark 1.2 se aplican a 1.3?
No. Las condiciones de Contributor de la versión 1.2 están documentadas por separado, pero las fuentes revisadas aquí no establecen un contrato completo de Contributor para 1.3. Calcula el presupuesto con la tarifa estándar de 1.3 hasta que tu proveedor confirme un nivel, una política de datos y un límite de velocidad diferentes.
Haz una prueba pequeña con un repositorio que no contenga información sensible antes de pasar a producción: compara las mismas tareas con tu modelo actual y registra la espera hasta el primer token, los cambios completados, las llamadas a herramientas y el coste. Esa medición responderá a la cuestión del despliegue con más fiabilidad que los rankings del día del lanzamiento.