 AIREITER
Veredicto sobre Muse Spark 1.2
Meta lanzó Muse Spark 1.2 el 5 de agosto de 2026 junto a un nuevo agente de terminal diseñado para este modelo. Mejora los resultados de codificación de la versión 1.1, aunque Claude Opus 5 sigue encabezando los tres gráficos de programación. Ahí está la clave de esta actualización: el avance existe. Meta amplió el cómputo dedicado al entrenamiento de código, coentrenó el modelo con su agente Muse Code y los resultados subieron. Sin embargo, parte del salto entre versiones se debe al nuevo harness y no solo al modelo; en Terminal-Bench, DeepSWE y la evaluación interna de programación de Meta, el modelo de Anthropic mantiene una ventaja de entre 4 y 9 puntos.
Aun así, el precio hace que merezca atención. La tarifa estándar se mantiene en $1.25/$4.25 por millón de tokens, mientras que la tarifa contributor reduce ese coste aproximadamente 12x más. Hay dos contrapartidas importantes: la opción predeterminada permite a Meta usar tu código para entrenar sus modelos y, en el nivel máximo de razonamiento, el tiempo hasta el primer token empeoró cerca de nueve veces. Si estás valorando Muse Spark 1.2 para programación en producción, estos dos factores pesan más que su posición en una clasificación.
Las novedades reales frente a 1.1
Muse Spark 1.2 es una actualización centrada en programación del modelo de razonamiento de frontera de Meta. Se lanzó el 5 de agosto junto con Muse Code, un agente de programación para terminal que ahora está en beta. La propia Meta la define como una "mejora moderada" respecto a Muse Spark 1.1. Es una descripción deliberadamente prudente para una versión que concentra sus avances justo donde más los necesitan los agentes de código: refactorizaciones de varios archivos, depuración prolongada y tareas que van mucho más allá de un único prompt.
Hay dos decisiones de entrenamiento detrás de la mejora. La primera es que Muse Code formó parte del ciclo de entrenamiento desde el primer día. Meta coentrenó el modelo con trayectorias de harness muestreadas por rechazo, afinándolo para rendir mejor dentro de su propio agente. La compañía afirma haberlo entrenado con varios harnesses, por lo que el modelo sigue siendo útil con otras herramientas de programación. La segunda fue un ciclo de auto-mejora: Muse Spark 1.1 generó entornos de programación exigentes y plantillas de seguimiento de instrucciones, y después evaluó las soluciones candidatas frente a ellos para crear el conjunto de entrenamiento de 1.2. Según Meta, ese proceso hace que 1.2 siga instrucciones complejas de forma mediblemente mejor.
La actualización apunta al punto débil de la familia Muse. Cuando Muse Spark debutó en abril de 2026, iba por detrás en programación agéntica: logró 77.4 en SWE-Bench Verified frente a los 80.8 de Claude Opus 4.6. Un checkpoint especializado en código, combinado con un harness diseñado expresamente para ello, es la respuesta directa, manteniendo al mismo tiempo las capacidades agénticas generales.
Qué dicen los benchmarks, sin maquillar
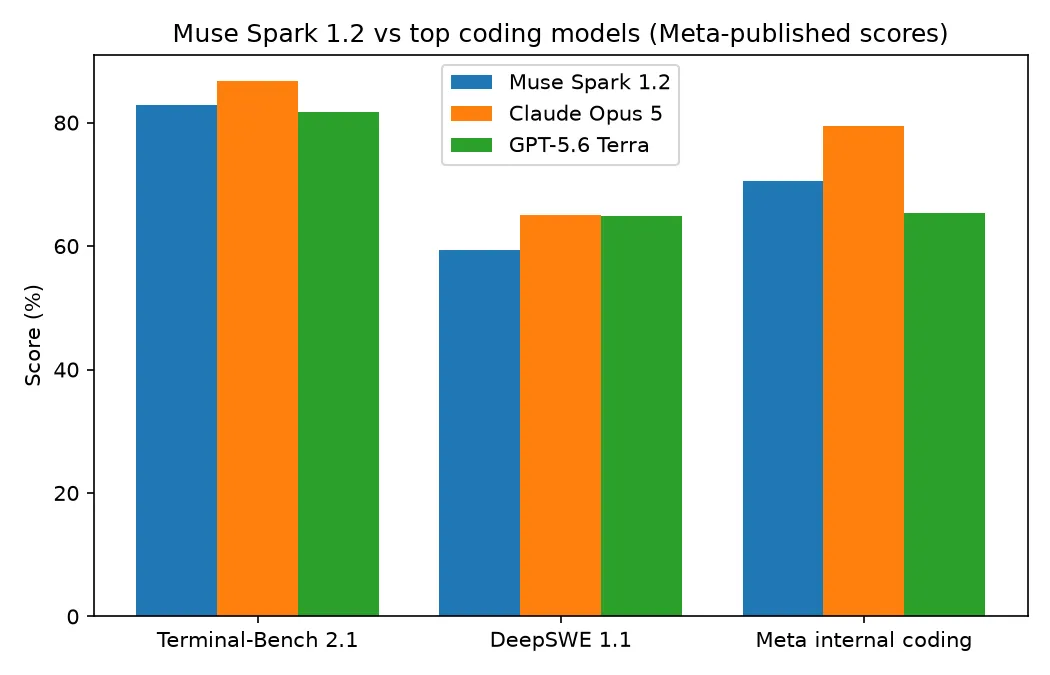
En Terminal-Bench 2.1, Muse Spark 1.2 ejecutado en Muse Code obtuvo 82.9%, por delante de GPT-5.6 Terra en Codex (81.8%) y de Grok 4.5 en Grok Build (81.6%), pero por detrás de Claude Opus 5 a esfuerzo máximo en Claude Code, que lidera con 86.7%. En DeepSWE 1.1 consiguió 59.3%, en tercera posición tras Opus 5 (65.0%) y GPT-5.6 Terra (64.8%). La evaluación interna de programación de Meta es la más transparente de las tres: el 70.6% de Muse Spark 1.2 supera a GPT-5.6 Terra (65.4%) y a Gemini 3.6 Flash (63.9%), pero queda casi nueve puntos por debajo del 79.4% de Opus 5. Claude encabeza los tres gráficos.
La mejora generacional es tangible: Muse Spark 1.2 sube 6.7 puntos frente a 1.1 en Terminal-Bench y 6.3 en DeepSWE. Pero hay un detalle relevante en las etiquetas de los gráficos para quien compare ambas versiones. Las puntuaciones de 1.1 se registraron con un harness genérico mini-swe-agent, mientras que 1.2 se ejecutó en Muse Code. Una parte de ese salto corresponde al nuevo harness, no únicamente al modelo. En el Intelligence Index combinado de Artificial Analysis, 1.2 obtiene 54 puntos y ocupa el puesto #14 entre 186 modelos, frente a una mediana de clase de 32. Mejora los 51 de 1.1, un avance más discreto de lo que sugieren los gráficos de programación.
La comparación directa con Claude y GPT es justo lo que los compradores siguen preguntando. En Reddit, un desarrollador lo planteó claramente antes de que existieran datos de 1.2:
"¿Alguien ha usado MUSE Spark 1.1 de Meta? Tengo curiosidad por saber cómo se compara con Claude y GPT en razonamiento, programación, velocidad, precisión y gestión del contexto."
Los benchmarks de 1.2 ofrecen la primera respuesta rigurosa a esa pregunta: es competitivo, claramente segundo en programación y supera a las opciones de GPT-5.6 y Gemini en la mayoría de los gráficos.
Dos pegas que importan en producción
Hay dos detalles prácticos que determinan si Muse Spark 1.2 encaja en un flujo de trabajo real, y ninguno aparece reflejado en una posición de ranking.
La regresión de latencia en xhigh
Muse Spark es un modelo de razonamiento: piensa antes de responder y no puedes desactivar ese comportamiento. El ajuste /effort abarca cinco niveles, desde minimal hasta xhigh, y los tokens de razonamiento se facturan como salida. En el extremo superior, el coste se dispara en dos sentidos. Mediciones independientes publicadas por OrcaRouter muestran que el tiempo hasta el primer token pasa de 2.90 segundos en 1.1 a 26.12 segundos en xhigh, aproximadamente nueve veces más, mientras que la velocidad de salida baja de 213.5 a 165.0 tokens por segundo. Ejecutar la evaluación Intelligence Index de Artificial Analysis en 1.2 costó $637.85, un 16% más que los $548.07 de 1.1, únicamente porque el modelo delibera más. Para programación interactiva, donde un desarrollador espera una respuesta, el esfuerzo máximo intercambia latencia por precisión de una forma que a menudo no compensa.
La tarifa contributor cambia tu código por descuento
Meta ofrece Muse Spark 1.2 en dos tarifas, y la que propone a los nuevos usuarios incluye una condición. La tarifa contributor ($0.10/$0.20 por millón de tokens de entrada/salida, frente a $1.25/$4.25 en la estándar) es aproximadamente 12x más barata en entrada y 21x en salida, con entrada en caché casi gratuita a $0.002. El intercambio es explícito: autorizas a Meta a utilizar tus prompts y completions para entrenar futuros modelos. Es la tarifa más barata de la comparativa anterior; la pagas con tus datos.
La incorporación predeterminada de Muse Code lleva a los desarrolladores a esta tarifa. En las pruebas recogidas por VentureBeat, el instalador de una línea funcionó en un Mac mini —una descarga de 97 MB y un inicio de sesión—, pero el agente no llegó a ejecutar nada: indicó que no había modelos visibles y exigió un método de pago incluso en la tarifa rebajada. Decir que es barato es correcto; decir que es gratis, no. Los límites de uso también son más estrictos: 60 solicitudes por minuto frente a 3,000 en la tarifa estándar. Es una señal clara de que está dirigida a particulares y prototipos, no a producción. Los equipos con bases de código propietarias deben cambiar conscientemente a la tarifa estándar o solicitar retención cero de datos a través del equipo comercial de Meta.
Precios frente a la competencia: dónde se sitúa Muse Spark
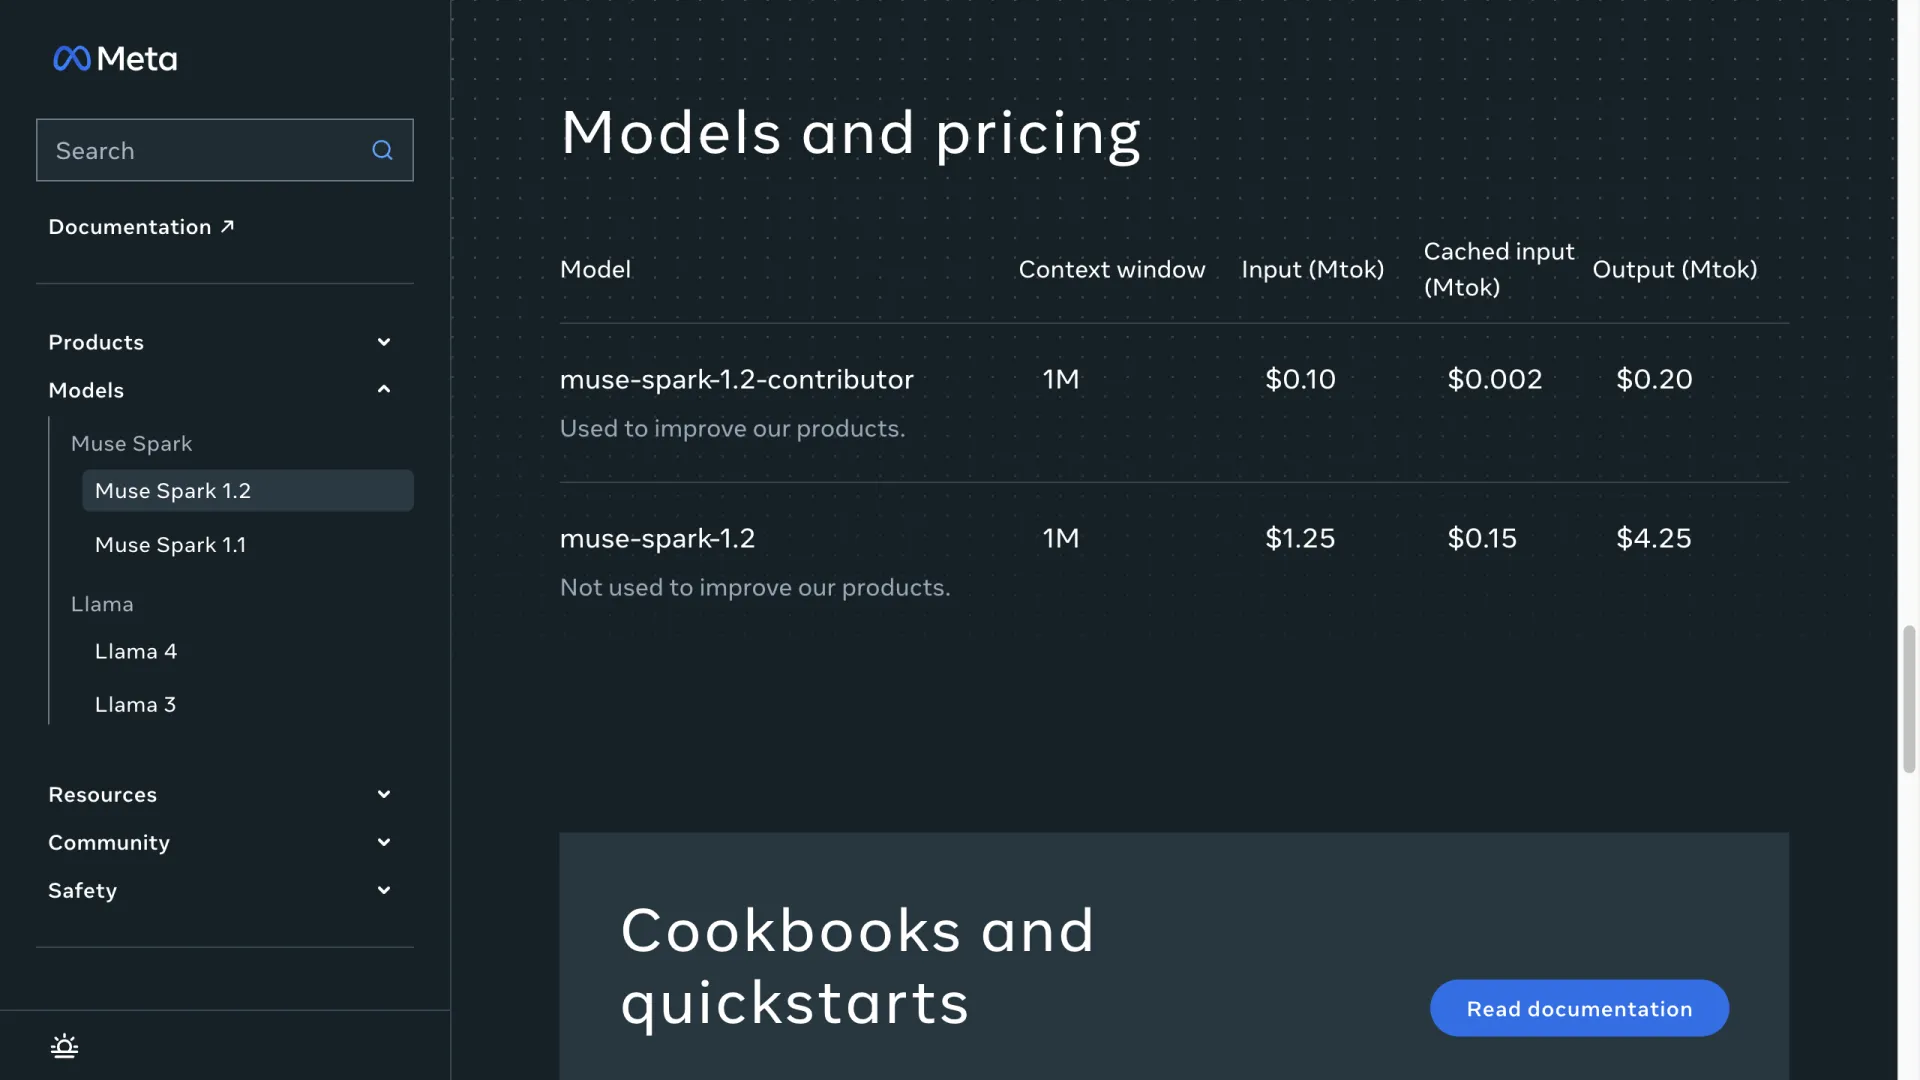
La tarifa estándar de Muse Spark 1.2 ($1.25 por millón de tokens de entrada, $0.15 en caché, $4.25 de salida, ventana de contexto de 1M tokens y sin recargo por contexto largo) se sitúa en la franja media-baja del mercado de modelos para programación. Es notablemente más barato que los líderes de código de frontera: Claude Opus 5, a $5/$25, y GPT-5.5, a $5/$30, cuestan aproximadamente entre 4 y 7x más en salida. Está casi al mismo nivel que Z.ai's GLM-5.2, a $1.40/$4.40, y un escalón por debajo de Grok 4.5, a $2/$6. En el extremo económico, DeepSeek V4 Pro a $0.435/$0.87 lo rebaja varias veces, igual que la propia tarifa contributor de Muse Spark.
| Modelo | Entrada $/M | Salida $/M | Caché $/M | Contexto |
|---|---|---|---|---|
| Muse Spark 1.2 (estándar) | 1.25 | 4.25 | 0.15 | 1M |
| Muse Spark 1.2 (contributor)* | 0.10 | 0.20 | 0.002 | 1M |
| Claude Opus 5 | 5.00 | 25.00 | — | — |
| GPT-5.5 | 5.00 | 30.00 | — | — |
| GLM-5.2 | 1.40 | 4.40 | — | — |
| Grok 4.5 | 2.00 | 6.00 | — | — |
| DeepSeek V4 Pro | 0.435 | 0.87 | — | — |
\*la tarifa contributor concede a Meta derechos para entrenar con tus datos; límite de 60 solicitudes/min.
Dónde está disponible y qué usar mientras tanto
Muse Spark 1.2 está disponible en tres lugares: la Meta Model API, el agente de terminal Muse Code y OpenRouter. Aún no figura en todos los agregadores; el catálogo de AIReiter, consultado el 6 de agosto de 2026, no lo incluye. Si tu infraestructura depende de una API unificada y necesitas un modelo de programación hoy, tendrás que elegir entre los que ya están disponibles mediante routing.
La alternativa disponible con la tarifa más cercana es GLM-5.2, a $1.40/$4.40. El 6 de agosto de 2026 ejecuté una tarea puntual de razonamiento para programación con glm-5.2, enrutado mediante la API de la plataforma, para comprobar qué ofrece una opción disponible hoy: una función Python de retirada que no verificaba el descubierto. GLM-5.2 respondió en 3.2 segundos (85 tokens de prompt y 128 de completion), identificó correctamente la falta de una comprobación de saldo, propuso la corrección (if amount > 0 and account_balance >= amount:) y escribió una prueba que falla antes del arreglo y pasa después. Es una sola tarea, no un benchmark, pero demuestra que hay un modelo de programación funcional al mismo nivel de precio y disponible ahora mismo. DeepSeek V4 Pro, Kimi K3, Claude Sonnet 5 y la familia GPT-5.6 completan las opciones con capacidad de programación que ya figuran en el catálogo de AIReiter.
¿Deberías usar Muse Spark 1.2?
La decisión se divide en tres escenarios, según qué quieras optimizar.
Elige Muse Spark 1.2 si haces programación a gran escala con sensibilidad al precio —refactorizaciones grandes de varios archivos, depuración larga o tareas agénticas de largo recorrido— y estás dispuesto a usar Meta, Muse Code u OpenRouter directamente. Por $1.25/$4.25 ofrece capacidad de programación de clase frontera a precios de gama media, y su ventana de contexto de 1M con compactación de contexto se adapta bien a trabajos que superan un único prompt. Mantén el esfuerzo de razonamiento por debajo de xhigh, salvo que tu tarea pueda asumir 26 segundos hasta el primer token.
Elige Claude Opus 5 si necesitas la primera posición en los gráficos de programación. Lidera los tres benchmarks en los que aparece Muse Spark 1.2. Pagas entre 4 y 6x más por token a cambio de esa ventaja en precisión.
Elige un modelo que ya esté en tu agregador si necesitas lanzar algo hoy y Muse Spark no está en tu plataforma. GLM-5.2 ofrece la misma franja de precio sin esperar; DeepSeek V4 Pro es aún más barato cuando el coste bruto es el factor dominante.
Preguntas frecuentes
¿Muse Spark 1.2 programa mejor que Claude Opus 5?
No. Claude Opus 5 lidera los tres benchmarks de programación publicados por Meta —Terminal-Bench 2.1, DeepSWE 1.1 y la evaluación interna de programación de Meta—, con márgenes de entre 3.8 y 9 puntos. Muse Spark 1.2 es un claro segundo y supera a GPT-5.6 Terra y Gemini 3.6 Flash en la mayoría de los gráficos.
¿Muse Spark 1.2 es de código abierto?
No. A diferencia de la familia Llama de Meta, Muse Spark es propietario: solo funciona en la nube, no tiene pesos descargables ni permite alojamiento propio. Mark Zuckerberg ha dicho que tendrá "más que compartir" sobre posibles lanzamientos de código abierto, pero 1.2 llega sin pesos ni licencia.