 AIREITER
Un trabajo multinodo en Modal se factura según la asignación completa de recursos, no mediante una suscripción independiente al clúster. Modal Clusters está disponible de forma general, pero la factura sigue dependiendo de las GPU, la CPU, la memoria, el almacenamiento y el tráfico de red que consuma cada contenedor.
Precios de Modal Clusters en un minuto
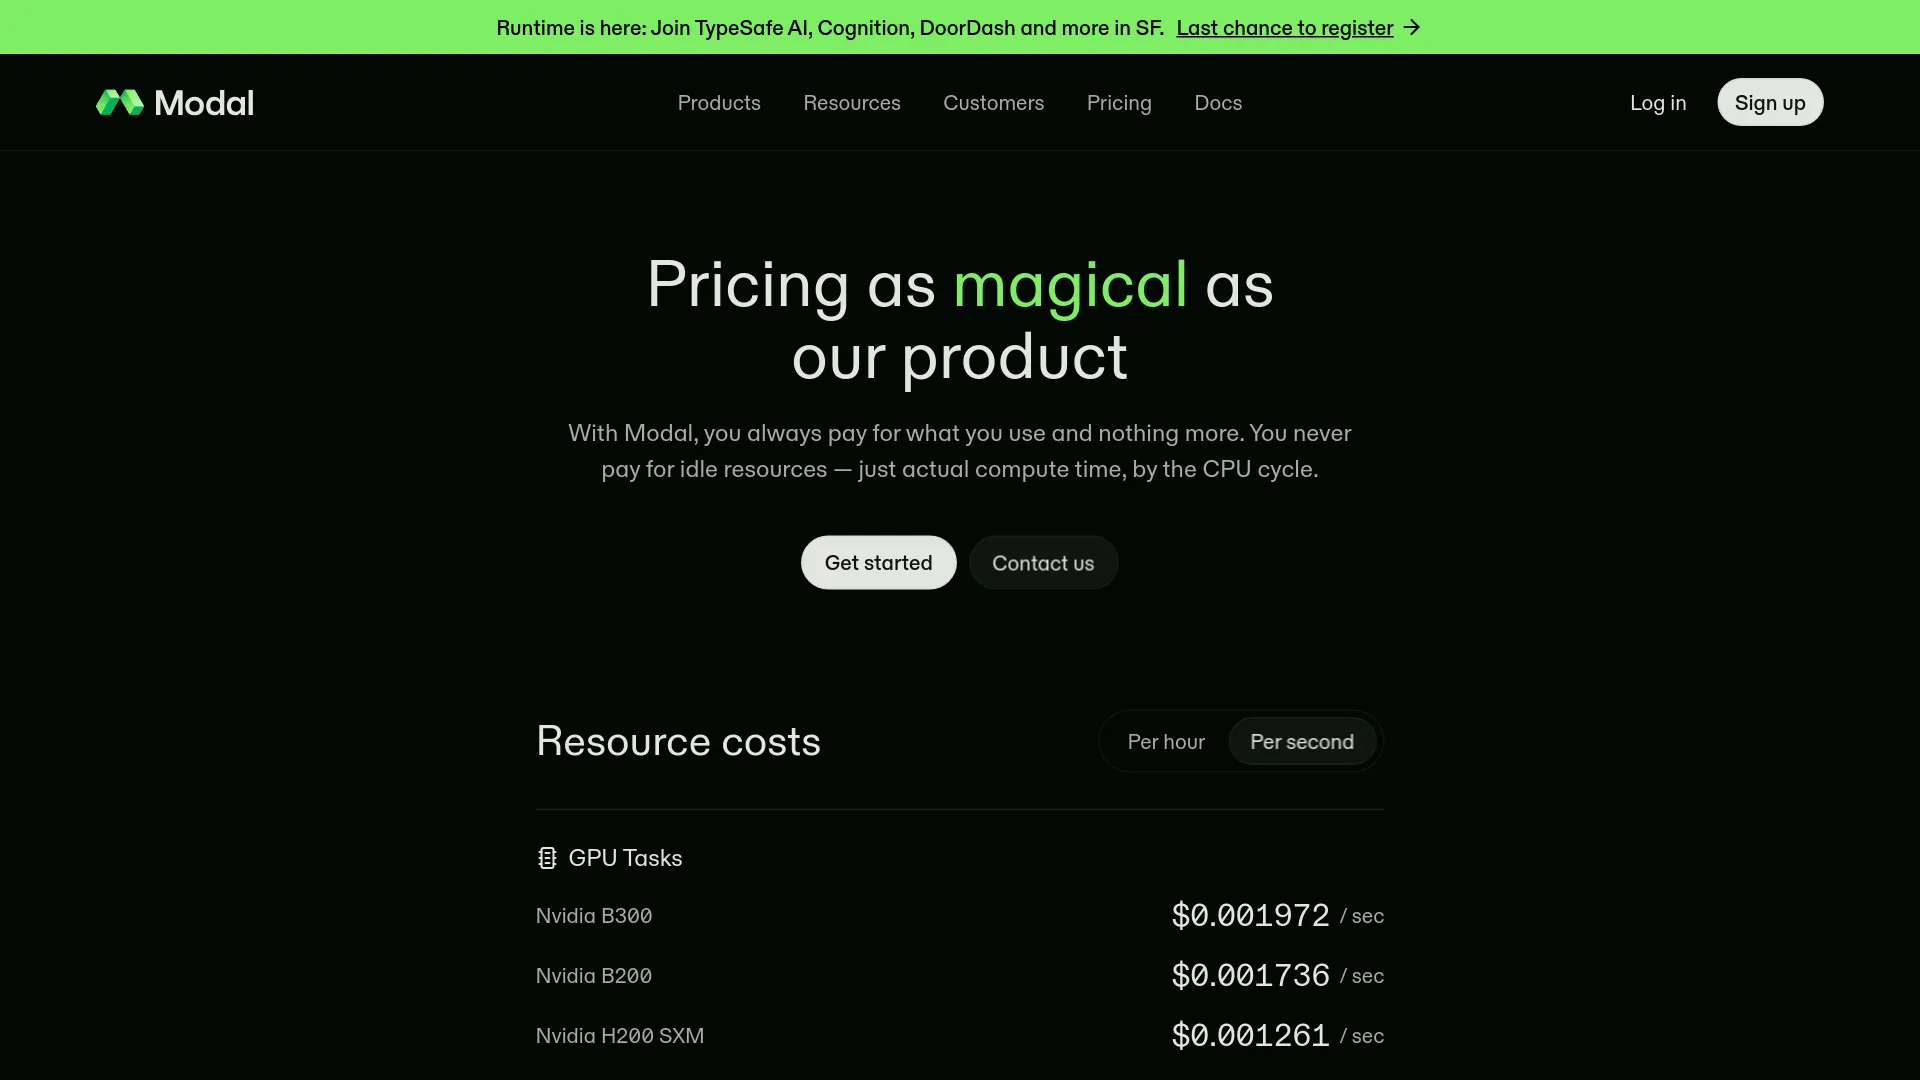
La página oficial de precios de Modal y el anuncio de disponibilidad general describen una facturación basada en el uso y el punto de entrada @modal.clustered para lanzar varios contenedores al mismo tiempo. RDMA es opcional y cambia la vía de comunicación, pero no la fórmula básica de precios.
número de GPU × segundos de GPU × tarifa de GPU + segundos de CPU + GiB-segundos de memoria + almacenamiento + tráfico de salida aplicable
Esta fórmula es importante porque un clúster multiplica la asignación completa de cada nodo. Si un trabajo solicita cuatro nodos con ocho GPU H100 por nodo, se facturan 32 H100, no un coordinador más varios workers «gratis».
Qué añade Modal Clusters a la tarifa
La versión GA de Modal Clusters, publicada el 1 de octubre de 2026, convierte la ejecución multinodo en una capacidad gestionada. size define el número de contenedores, mientras que rdma=True activa la vía de comunicación de alta velocidad allí donde está disponible (anuncio de Modal).
La documentación describe un sistema de planificación conjunta: Modal intenta ubicar todo el grupo solicitado en lugar de iniciar un trabajo parcial que no pueda avanzar. Entre las cargas compatibles están el entrenamiento distribuido, el fine-tuning, la inferencia paralela por modelo y las arquitecturas de prefill/decode que necesitan comunicación sincronizada entre GPU.
La documentación de clústeres también marca varios límites prácticos: la asignación de GPU se realiza por nodo completo, los clústeres solo de CPU no son compatibles y un contenedor fallido o desalojado puede hacer que falle la llamada agrupada. Solo se devuelve la salida del rank 0, así que los trabajos largos necesitan checkpoints fuera del contenedor.
Las tarifas de GPU que determinan la factura de Modal Clusters
Las siguientes tarifas públicas son un buen punto de partida para preparar una estimación. Las cifras por hora se calculan a partir de los precios por segundo y no incluyen CPU, memoria, almacenamiento ni posibles multiplicadores regionales.
| GPU | Por segundo | Aprox. por GPU-hora |
|---|---|---|
| B300 | $0.001972 | $7.10 |
| B200 | $0.001736 | $6.25 |
| H200 SXM | $0.001261 | $4.54 |
| H100 SXM5 | $0.001097 | $3.95 |
| A100 80 GB | $0.000694 | $2.50 |
| L4 | $0.000222 | $0.80 |
Modal también fija la CPU en $0.0000131 por núcleo físico-segundo y la memoria en $0.00000222 por GiB-segundo. Los volúmenes cuestan $0.09 por GiB al mes, con el primer 1 TiB gratis. El tráfico de salida figura a $0.04 por GiB una vez superada la cantidad incluida. Comprueba las cifras vigentes en la tarifa oficial antes de lanzar un trabajo de gran tamaño.
Ejemplo práctico: cuatro nodos con ocho H100
Supongamos que un trabajo de entrenamiento distribuido solicita size=4 y H100:8 en cada nodo.
- Cuatro nodos × ocho GPU = 32 GPU H100.
- 32 × $3.95 por hora = aproximadamente $126.40 por hora en GPU.
- Considera los $126.40 como el coste mínimo de GPU; CPU, memoria, almacenamiento y tráfico de salida se cobran aparte.
Esta es la cifra que debes comparar con una capacidad reservada o dedicada. La ventaja serverless es que el clúster puede reducirse a cero cuando termina el pico de trabajo; no que un clúster completamente ocupado salga barato.
Los límites del plan pueden importar más que la tarifa
Una función disponible de forma general no equivale a capacidad ilimitada. Los planes de workspace publicados por Modal incluyen límites de concurrencia y restricciones de plataforma que pueden bloquear un clúster grande antes de que el precio sea el problema.
| Plan | Cuota de plataforma | Crédito de cómputo incluido | Concurrencia de GPU publicada |
|---|---|---|---|
| Starter | $0/mes | $30/mes | 10 GPU |
| Team | $250/mes | $100/mes | 50 GPU |
| Enterprise | Personalizado | Personalizado | Personalizado / límites superiores |
Un experimento con 32 H100 ya consume 32 GPU, por lo que el plan Starter no puede admitir el ejemplo anterior con un límite de concurrencia de 10 GPU. Team puede encajar sobre el papel, pero la disponibilidad real, la región elegida y el hardware solicitado siguen influyendo en la planificación.
No confundas el crédito de $30 del plan Starter con 30 horas de GPU gratis. Con la tarifa indicada para H100, equivale aproximadamente a 7,6 horas de GPU H100, antes de contar el resto de recursos del trabajo.
Cuándo tiene sentido económico Modal Clusters
Modal Clusters resulta especialmente interesante cuando el trabajo es grande, intermitente y demasiado costoso de mantener aprovisionado de forma permanente. Un pico de entrenamiento que dura unas horas y después desaparece aprovecha mejor la capacidad de escalar a cero que un clúster activo durante semanas.
Es una buena opción para:
- Fine-tuning distribuido en el que todos los nodos deben arrancar juntos.
- Picos breves de entrenamiento con capacidad de GPU cara.
- Inferencia multinodo que necesita RDMA o paralelismo de modelo.
- Equipos de Python que, de otro modo, tendrían que operar Kubernetes, SLURM o una configuración manual de RDMA.
Una función de Modal en un solo nodo encaja mejor cuando el modelo cabe en una máquina. La infraestructura dedicada o reservada merece una comparación seria cuando el uso es predecible, la carga necesita un SLA fijo o el objetivo principal es conseguir el menor coste sostenido por GPU-hora.
Una conversación entre usuarios también marca un límite útil. En un hilo sobre visión por computador, u/Substantial_Camel735 recomendó mantener la búsqueda vectorial en una VPS en lugar de ejecutar esa parte en workers de Modal (debate en Reddit). Tómalo como la preferencia arquitectónica de un profesional, no como una comparativa de toda la plataforma.
«Estamos a punto de dejar Modal, pero ese diseño parece acertado; yo no usaría los workers de Modal para hacer búsquedas. Lo dejaría en tu VPS, contra tu base de datos vectorial». — u/Substantial_Camel735, r/computervision
Comprobaciones operativas antes de lanzar un trabajo grande
- Multiplica la asignación completa. Comprueba
size × GPU por nodoy compara el total con la concurrencia del workspace. - Empieza por el clúster más pequeño que permita validar el caso. Una prueba de dos nodos puede revelar problemas de imagen, NCCL, rangos y rendezvous antes de que un lanzamiento de 32 GPU multiplique la factura.
- Separa RDMA de la depuración de la aplicación. Valida el trabajo distribuido sin RDMA si la carga lo permite; después activa
rdma=Truey mide la ruta sensible a la comunicación. - Guarda checkpoints en almacenamiento persistente. Un rank fallido o desalojado puede hacer que falle toda la llamada; repetir sin checkpoint puede obligarte a ejecutar de nuevo todo el trabajo caro.
- Presupuesta CPU, memoria y tráfico de salida. El cálculo de GPU solo es la primera línea de la factura, especialmente cuando los datasets o los resultados cruzan regiones.
- Decide si necesitas fijar la región. Limitar la ubicación puede cambiar el conjunto de recursos disponibles para la planificación y el multiplicador de precio; trata la proximidad como un requisito que debe medirse y verifícala en la documentación actual de precios regionales.
RDMA no aparece como un cargo independiente en los precios oficiales de Modal. Su valor está en el rendimiento: el entrenamiento sincronizado y las transferencias grandes de cachés KV pueden quedar limitados por la red cuando usan TCP convencional. La contrapartida es que el hardware compatible con RDMA y las opciones de ubicación pueden reducir la disponibilidad.
Preguntas frecuentes sobre Modal Clusters
¿Modal Clusters cobra una tarifa independiente por su API?
No se publica ningún recargo específico por el clúster. Modal factura los recursos utilizados por cada contenedor: GPU, CPU, memoria, almacenamiento y el tráfico de red aplicable.
¿Cuál es el tamaño máximo de un clúster?
El material de disponibilidad general describe clústeres públicos de hasta 32 nodos o 256 GPU; las necesidades superiores se gestionan directamente con Modal (anuncio de disponibilidad general). La concurrencia del workspace y la capacidad disponible siguen siendo factores limitantes.
¿Se puede usar Modal Clusters para inferencia?
Sí, siempre que la carga encaje con el modelo de ejecución agrupada. La inferencia multinodo o paralela por modelo es un caso de uso más claro que un endpoint HTTP normal; las funciones web agrupadas tienen limitaciones, entre ellas que el tráfico se entrega al rank 0 (documentación de clústeres).
La decisión práctica
| Tu carga de trabajo | Mejor punto de partida |
|---|---|
| El modelo cabe en una GPU o un nodo | Función normal de Modal |
| Pico breve de entrenamiento multinodo sincronizado | Modal Clusters, después de una prueba pequeña |
| Uso completo, predecible y prolongado | Comparar capacidad de GPU dedicada o reservada |
| Búsqueda o trabajo de base de datos junto a la inferencia en GPU | Mantener el servicio de datos separado salvo que las mediciones justifiquen ubicarlo junto a la inferencia |
| Necesidad estricta de red privada o de alojamiento propio | Evaluar otro modelo de despliegue |
Modal Clusters simplifica el inicio de la orquestación de GPU multinodo, pero eso no significa que sea más barato por definición. La ubicación serverless y la ergonomía de Python pueden ahorrar tiempo de ingeniería, mientras que el uso sostenido, las restricciones regionales y los reintentos de todo el clúster pueden disparar la factura. Primero calcula el número total de nodos; después compara el coste de esa comodidad con una capacidad dedicada.