 AIREITER
MiniMax califica la capa de preprocesamiento de H3 como «crítica para la calidad del resultado final» en su propia model card. Sin embargo, un hilo de Reddit sobre prompting para H3 con 220 votos positivos se lee más bien como un informe de errores sobre diálogos ininteligibles. Este análisis de prompts de MiniMax H3 contrasta el formato oficial con pruebas y reportes de creadores: la cámara y el control mediante referencias resultan más fiables que el diálogo y el audio, y en algunos casos los mejores resultados llegan al apartarse deliberadamente de la sintaxis recomendada.
Así funciona realmente el formato de prompt de MiniMax H3
El prompt oficial de MiniMax H3 es un documento estructurado con tres campos: integrated_multimodal_description, overall_soundscape y non_diegetic_music. Incluye planos con marcas de tiempo, identificadores persistentes para los hablantes y etiquetas de diálogo <d>. Tiene sentido porque H3 espera una representación intermedia estructurada, normalmente generada por un preprocesador alojado llamado H3-Context-IR, que MiniMax no incluyó en la versión de pesos abiertos. En la API alojada, este componente convierte por ti las peticiones informales; con los pesos abiertos de 33B ejecutados localmente mediante SGLang, vLLM, Diffusers o ComfyUI, debes redactar esa estructura a mano.
MiniMax también incluye una skill portátil llamada h3-prompt-writing en el repositorio oficial de GitHub. Son dos archivos de guía, base-en.txt y ref-en.txt, que cualquier agente de programación puede leer sin realizar llamadas a APIs externas. Los creadores la usan desde Claude o Cursor para transformar un briefing en lenguaje natural al formato completo; @AI__TSUBAKI documenta precisamente ese flujo de trabajo para clips cinematográficos.
Los límites técnicos que condicionan cada prompt
| Restricción | Valor | Consecuencia al escribir el prompt |
|---|---|---|
| Duración del clip | 4–15 segundos, 24 FPS | Las marcas de tiempo deben aumentar estrictamente y permanecer dentro de la duración |
| Audio | Estéreo a 32 kHz, generado de forma conjunta | Los campos de ambiente y música son obligatorios; se permite N/A |
| Resolución | 768p por defecto; 2K mediante H3-Regenerate-2K, solo por API | Prueba a 768p y paga por 2K cuando el prompt esté cerrado |
| Tipos de tarea | T2VA (texto), I2VA (primer fotograma a 0.00 s), FL2VA (primer y último fotograma), L2VA (último fotograma), Ref2VA (referencia omni) | Cada tipo necesita su propia frase de alineación |
| Límites de referencias | 9 imágenes + 3 clips de vídeo + 3 clips de audio, 12 archivos en total, ≤15 s totales por tipo de medio | Más referencias implican más enrutamiento; no siempre mejoran el resultado |
| Tamaño del prompt | Los ejemplos oficiales tienen 300–700 palabras; el texto a vídeo puro admite ~7.000 caracteres | Los prompts breves sin referencias son un modo de fallo señalado en el manual oficial |
Un prompt mínimo completo —los tres campos, una instrucción de cámara, una persona visible que habla entre comillas y sin banda sonora— cabe en diez líneas:
integrated_multimodal_description: Cinematic, live-action. [Shot 1] A woman in her
late twenties sits on a sunlit sofa, a matte-green skincare bottle in hand. The
camera pushes in, small amplitude, slow speed. She is visible on screen and says:
"This is the one product I repurchase every year." At 00:05.500 she sets the
bottle down.
overall_soundscape: Quiet room tone, faint traffic outside, soft fabric movement,
gentle contact of the bottle on the table.
non_diegetic_music: N/A
La sintaxis completa campo por campo —todas las etiquetas, frases de alineación y plantillas— está en nuestra guía de prompts de MiniMax H3. Aquí nos centramos en si toda esa sintaxis compensa el esfuerzo.
Las tres promesas del formato, puestas a prueba
La guía oficial plantea tres promesas implícitas. Los reportes citados respaldan bastante las dos primeras, pero son mucho menos favorables con la fidelidad del audio.
Promesa 1: «La estructura te acerca a lo que esperabas»
Es la afirmación con evidencias más sólidas. El creador de X @AIWarper publicó una comparación de antes y después al pasar al formato oficial:
"I STRONGLY encourage you to adhere to the prompting guide released by Minimax. It really helps a lot with getting exactly what you expected.... My last post did not follow the suggested prompt structure." — @AIWarper, 306 likes
El registro de pruebas de terceros refleja el mismo patrón en el nivel de detalle: solicitó un corte exactamente en 00:05.000 y lo obtuvo, transcribió literalmente un testimonio escrito y mantuvo estable la composición del primer fotograma en un clip I2VA de 6 segundos. Los informes sobre storyboards coinciden: los tableros de @aimikoda se respetan como guía secuencial de planos, y el de @nanyuan0412 se siguió sin improvisaciones, salvo en los campos de sonido que olvidaron incluir y que acabaron en un silencio casi total.
La limitación que más se repite no es que el modelo se niegue, sino el ritmo. «Biggest problem has been pacing», escribe u/Relevant_One_2261: los fallos estructurales recurrentes son diálogos que no caben en el metraje y marcas de tiempo demasiado juntas.
Promesa 2: «Las órdenes de cámara superan a las descripciones de resultado»
Un fallo de encuadre resuelto lo confirma. Un usuario de r/StableDiffusion pidió a H3 que mantuviera visible el cuerpo entero de una persona caminando con la instrucción simple «entire subject remains visible throughout», pero falló repetidamente. La solución fue expresar el resultado deseado en la gramática de cámara nativa de H3:
"The camera pulls out with large amplitude at the same speed as the subject walks forward, maintaining a full-body composition." — u/Powerful-Goal52, confirmado como funcional por el autor de la publicación
La instrucción encaja directamente con las tres dimensiones de cámara de H3: tipo de movimiento, amplitud y velocidad, además de su regla de una instrucción de cámara por plano. Esta es una tabla de traducción rápida:
| Resultado buscado | Orden que H3 sigue |
|---|---|
| El sujeto permanece completamente visible mientras camina | Pull Out con amplitud grande a la velocidad de caminata del sujeto |
| Énfasis sutil sin romper el encuadre | Push In, amplitud pequeña, velocidad lenta |
| Mostrar el entorno alrededor de un sujeto inmóvil | Truck Left o Truck Right, amplitud media |
| Cambiar la altura sin inclinar la cámara | Pedestal Up / Pedestal Down a velocidad lenta |
La guía oficial de prompting enumera 13 familias de movimientos: Zoom, Push, Pull, Pan, Tilt, Truck, Pedestal, Arc, Tracking, Static, Shake, Roll y POV. Cada una se modula mediante amplitud y velocidad. En la práctica, distinguir entre un zoom, que cambia la distancia focal, y un push, que desplaza físicamente la cámara, importa: no son términos intercambiables.
Promesa 3: «Separar los campos de audio mantiene todo limpio»
Este es el eslabón más débil. Separar el ambiente diegético de la música no diegética es un buen diseño, pero el cumplimiento es irregular:
"I use this, but about 20% of the time it adds music anyway lol" — u/TheElectriking sobre
non_diegetic_music: N/A
El hilo con 220 votos positivos del que procede la cita recoge el resto del patrón: artefactos de audio en los bordes del clip, personajes que pronuncian galimatías y frases dichas por la persona equivocada. u/krigeta1 informa de que entregó tres referencias de audio personalizadas y recibió «a random voice or not the audio I assign to the characters». Otro hilo independiente resolvió diálogos en pantalla que se leían como voces en off asociando explícitamente el ID del hablante al personaje visible.
El texto en pantalla arrastra una fragilidad similar. La wiki comunitaria advierte que «exact text is fragile»: si las letras son críticas para la marca, conviene aportarlas como referencia de imagen o componerlas en posproducción. Hay además un informe discrepante: @web4miko afirma que, en sus pruebas, H3 «can't even beat Seedance 2.0» en comprensión de texto y contexto. En los reportes citados, el enrutamiento de audio, el texto exacto y los contextos densos son los puntos débiles recurrentes.
Cuándo conviene saltarse la sintaxis oficial
Las comparativas directas y los testimonios de primera mano citados muestran tres desviaciones del formato oficial. Merece la pena conocerlas antes de comprometerse con toda la estructura.
Las comillas a veces funcionan mejor que las etiquetas <d>. En una comparación publicada en r/StableDiffusion, con ~105 votos positivos y 81 comentarios, el autor original descubrió que eliminar el etiquetado <d>[Language]...台词...</d> de la guía y usar diálogo normal entre comillas producía voz limpia, mientras que la versión etiquetada añadía audio no solicitado. Un comentarista que realizó pruebas comparables coincidió:
"the official dialogue prompting is buggy as hell... quotes approach is still not nearly as buggy as the
<d></d>tagging." — u/networking_noob
La lectura práctica es sencilla: prueba primero <d>, porque es la vía sobre la que se entrenó el modelo, pero si el habla sale distorsionada o genera demasiado audio, vuelve a intentar la misma frase entre comillas en lugar de reescribir todo el prompt.
non_diegetic_music: N/A sirve como control independiente. u/Nextil indica que evita la música «even if you ignore most of the other structure». Si no vas a estructurar nada más, incluye al menos este campo: la banda sonora no deseada es una queja recurrente en los informes citados.
Los trabajos cargados de referencias necesitan menos texto, no más. Si las imágenes aportan la identidad y un vídeo aporta el movimiento, el prompt se limita a enrutar esas referencias y describir la acción nueva. Las plantillas más compartidas de @aimikoda, una de ellas con más de 1.300 marcadores, son minimalistas por esa misma razón. Por su parte, @CharaspowerAI mostró cómo el propio agente Design de MiniMax ampliaba una única línea —«act as an expert FPV director and turn this into something viral»— a un prompt estructurado completo de forma automática. Un bloque de enrutamiento de referencias podría ser así:
@Image 1 is the character reference: preserve the face, short black hair, red silk jacket.
@Video 1 supplies the sword-draw rhythm.
@Audio 1 sets the mood with quiet traditional strings.
A partir de ahí, el prompt solo debe describir el plano nuevo. El flujo práctico que emerge de estos reportes es: fija primero los fotogramas estáticos, deja que las referencias hagan el trabajo pesado y usa palabras solo para lo que cambia.
Diagnóstico de fallos: lo que el manual no resuelve
La guía oficial de prompting se queda en la sintaxis. No explica qué hacer cuando una generación vuelve rota. Esta tabla reúne los fallos descritos anteriormente:
| Síntoma | Causa probable | Solución |
|---|---|---|
Se añade música pese a N/A | Un usuario observó filtraciones en aproximadamente el 20% de sus ejecuciones | Regenera; evita pedir un «mood» musical en cualquier otra parte del prompt |
| Otro personaje dice una frase | Conflicto en el enrutamiento entre hablante y audio | Vincula explícitamente el ID del hablante al personaje visible en pantalla |
| Una frase en pantalla se lee como voz en off | Falta la asociación con el lip-sync | Indica que el hablante es visible; para una voz en off real añade «lips remain closed» |
| Se ignora una referencia de audio | Se superan los límites de 3 clips / 15 segundos o no se asignó una función | Asigna un papel a cada clip; recorta el total de audio de referencia |
| El modelo local ignora diálogo en chino | ComfyUI reutilizó el tokenizador de Qwen; la codificación de la shell alteró el texto | Usa el tokenizador del repositorio, requisito oficial, envío seguro para Unicode y <d>[Chinese] 台词</d> (solución reportada por la comunidad) |
| Un plano secuencia largo (>15 s) se descompone | Está fuera del margen de diseño de 4–15 s; los objetos se simplifican y la continuidad deriva | Divídelo en segmentos de 15 segundos y planifica la continuidad entre ellos |
La fila sobre ejecución local merece atención adicional. En el informe de @eternityspring, el problema de que «H3 won't speak Chinese» se debía a la reutilización del tokenizador y a la codificación, no al prompt.
El coste real: tokens, iteraciones y portabilidad
La estructura no sale gratis. El repositorio oficial publica el consumo de tokens de Context-IR para sus tres casos reproducibles, y las cifras crecen con rapidez al aumentar el número de referencias:
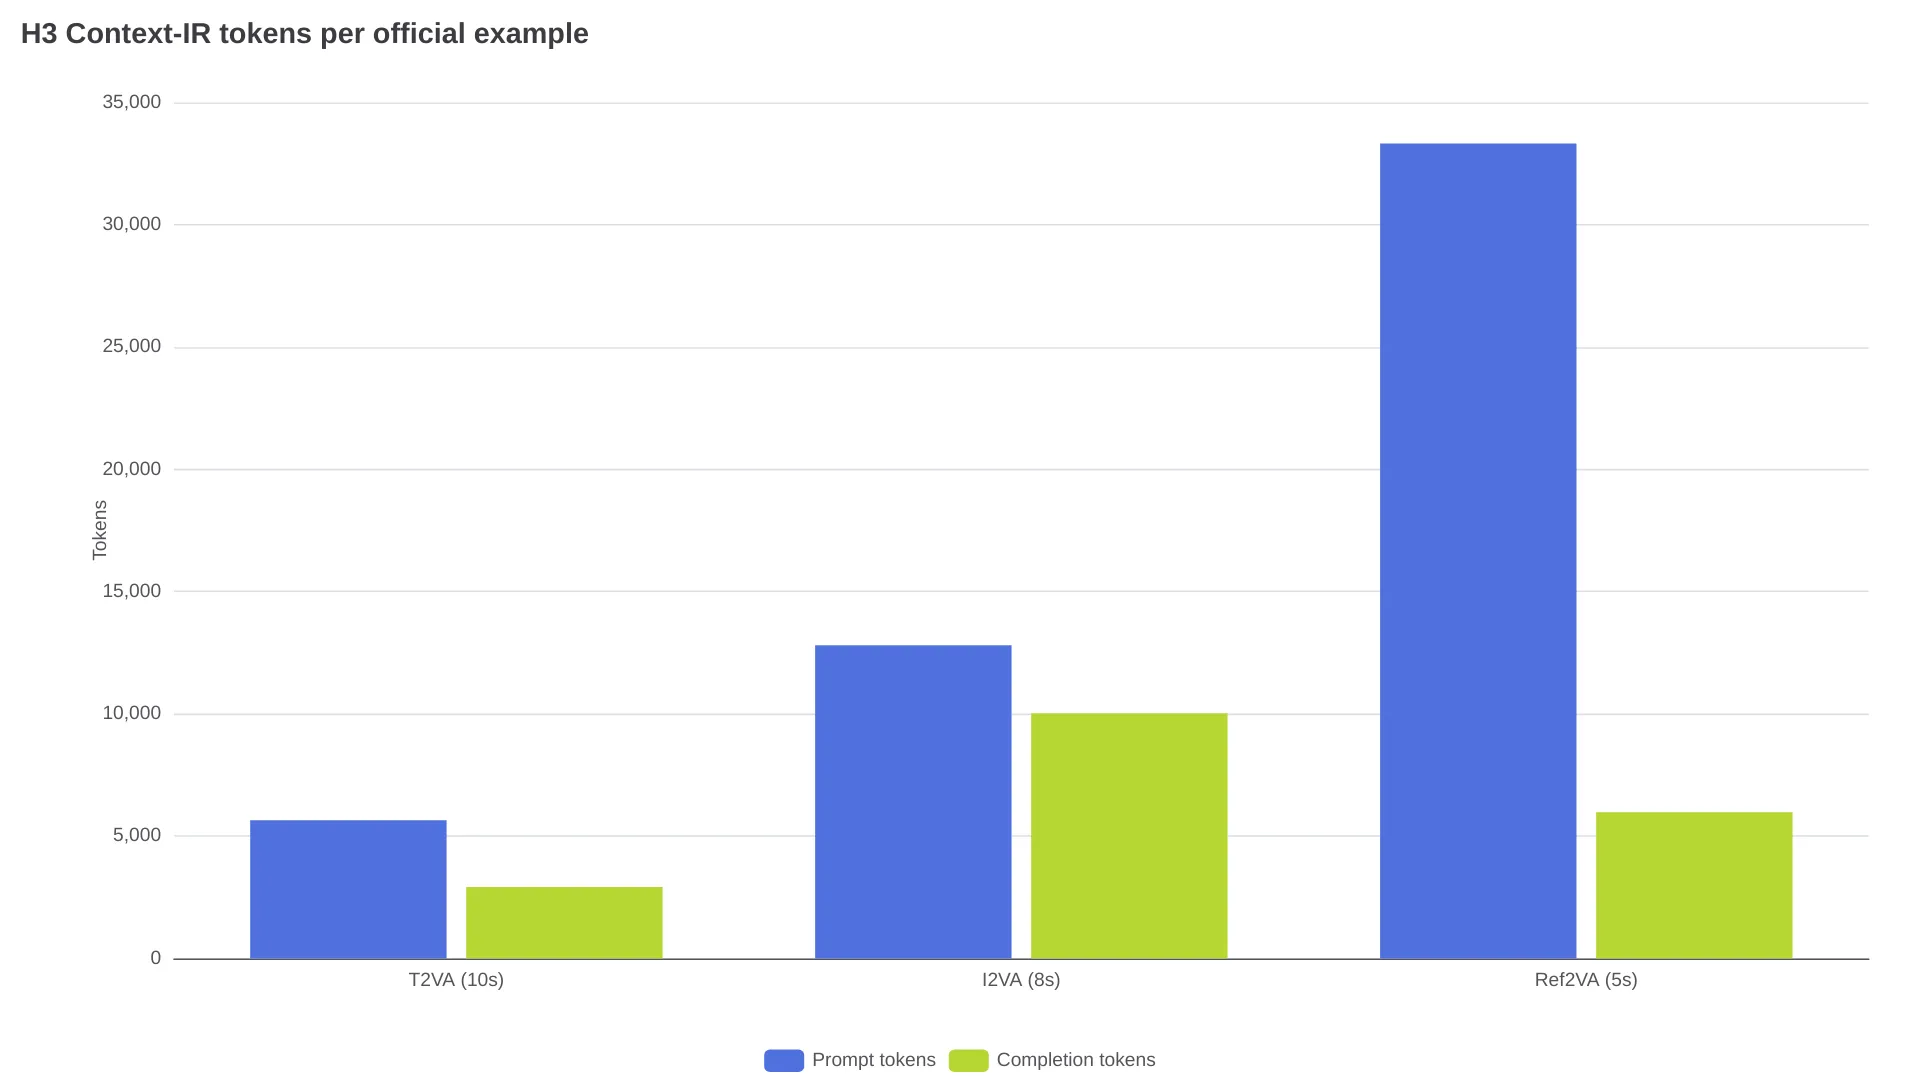
Una generación solo con texto consume 8.565 tokens de preprocesamiento; un trabajo multimodal con referencias consume 39.299, de los cuales 33.323 corresponden al lado del prompt. En ejecuciones locales, esos tokens añaden latencia de preprocesamiento; en flujos alojados, suman carga de procesamiento incluso cuando el precio se expresa por segundo generado. El tiempo también tiene un coste real: un creador de X documentó 48 horas afinando un solo prompt de cámara orbital para tres personas antes de conseguirlo (@LoveUolanda). La forma económica de iterar consiste en trabajar a 768p, donde una prueba de 6 segundos cuesta aproximadamente $0.68, y enviar a 2K únicamente el prompt ya cerrado. La página del modelo del relay lista tarifas de $0.1125/s para 768p y $0.1825/s para 2K en MiniMax H3.
La portabilidad es el último coste oculto. Los campos, IDs de hablante y etiquetas de H3 son un dialecto, no un estándar. Un recorrido entre modelos señala que Veo 3.1 quiere párrafos normales con etiquetas SFX: integradas, mientras que Seedance 2.0 utiliza una descripción de seis campos. Ninguno acepta los campos, IDs de hablante o etiquetas de H3. Una biblioteca de prompts creada para H3 exige reescritura, no un simple copiar y pegar, en cualquier otro modelo.
Preguntas frecuentes sobre los prompts de MiniMax H3
¿Es obligatorio usar el formato estructurado en MiniMax H3?
No. En la API alojada, Context-IR convierte las peticiones informales en lenguaje natural a la representación interna. La estructura importa sobre todo en ejecuciones locales con pesos abiertos y cuando necesitas cortes, marcas de tiempo y enrutamiento de hablantes exactos.
¿Cómo evito que MiniMax H3 añada música de fondo?
Termina con non_diegetic_music: N/A y no pidas una atmósfera musical en ninguna otra parte. Aun así pueden producirse filtraciones, por lo que regenerar es normal.
¿Qué longitud debe tener un prompt de MiniMax H3?
Los ejemplos de MiniMax tienen entre 300 y 700 palabras, y el texto a vídeo puro admite hasta unos 7.000 caracteres. Cuando las referencias ya aportan identidad y movimiento, el prompt debería acortarse, no crecer.
¿Puedo reutilizar prompts de H3 en Seedance o Veo?
No. Los campos con nombre, IDs de hablante y etiquetas de H3 son específicos del modelo. Seedance usa un formato de seis campos y Veo acepta párrafos normales, así que cada modelo de destino necesita su propia reescritura.
¿Por qué mi instalación local de H3 ignora diálogos que no están en inglés?
Normalmente el problema está en la cadena de herramientas, no en el modelo. Las configuraciones que reutilizan el tokenizador de Qwen o las shells que alteran Unicode rompen el diálogo antes de generar. Usa el tokenizador oficial del repositorio y el formato de diálogo <d>[Language].
Veredicto: quién debería aprender el formato
| Tu caso de uso | Veredicto |
|---|---|
| Corto con varios planos y diálogo | Aprende el formato completo; reserva intentos extra para audio y usa comillas como alternativa |
| Producto o animación de imagen fija (I2VA) | Aprende la versión ligera: frase de alineación + movimiento + campos de sonido |
| Storyboard o serie con consistencia de personajes | Sí: las referencias hacen el trabajo pesado; mantén prompts mínimos y fáciles de enrutar |
| Clips únicos y uso casual | Sáltate la mayor parte: una descripción normal + non_diegetic_music: N/A es suficiente |
| Crear una biblioteca de prompts para varios modelos | No: cada dialecto de modelo necesita su propia versión; escribe para cada modelo |
Aprende el formato para trabajos con varios planos, marcas de tiempo o referencias: ahí es donde su cumplimiento está documentado y resulta reproducible. Para clips aislados, puedes prescindir de él en gran medida, y en audio cargado de diálogo conviene esperar reintentos más que obediencia perfecta.
La propia comunidad está dividida en torno a este intercambio. El mismo mes produjo una maratón de 48 horas afinando un prompt de cámara y una publicación con 880 votos positivos en la que un comentarista escribió que «reading the manual was actually exciting». Hasta que la fidelidad a los campos de audio alcance la precisión que ya ofrece con la cámara, la postura práctica es clara: deja que un agente redacte la estructura, verifica personalmente los campos de audio y prueba barato a 768p antes de comprometerte con 2K.