 AIREITER
El precio por token de Hy4 preview no basta para decidir cómo consumirlo. Tencent ha publicado sus tarifas en CNY y OpenRouter ofrece un endpoint activo, pero la mejor vía depende del uso de caché, la compatibilidad con herramientas y la capacidad de tu equipo para operar un modelo distribuido en ocho nodos.
Precios de la API de Hy4 preview, de un vistazo
Tencent Cloud TokenHub fija para Hy4 preview un precio de CNY 6 por millón de tokens de entrada, CNY 18 por millón de tokens de salida y CNY 0.30 por millón de tokens de entrada en caché. En su página del modelo alojado, OpenRouter muestra $0.834, $2.501 y $0.042, respectivamente.
| Vía de acceso | Entrada / 1M tokens | Salida / 1M tokens | Entrada en caché / 1M tokens | ID del modelo |
|---|---|---|---|---|
| Tencent Cloud TokenHub | CNY 6 | CNY 18 | CNY 0.30 | Verificar en TokenHub |
| OpenRouter | $0.834 | $2.501 | $0.042 | tencent/hy4-preview |
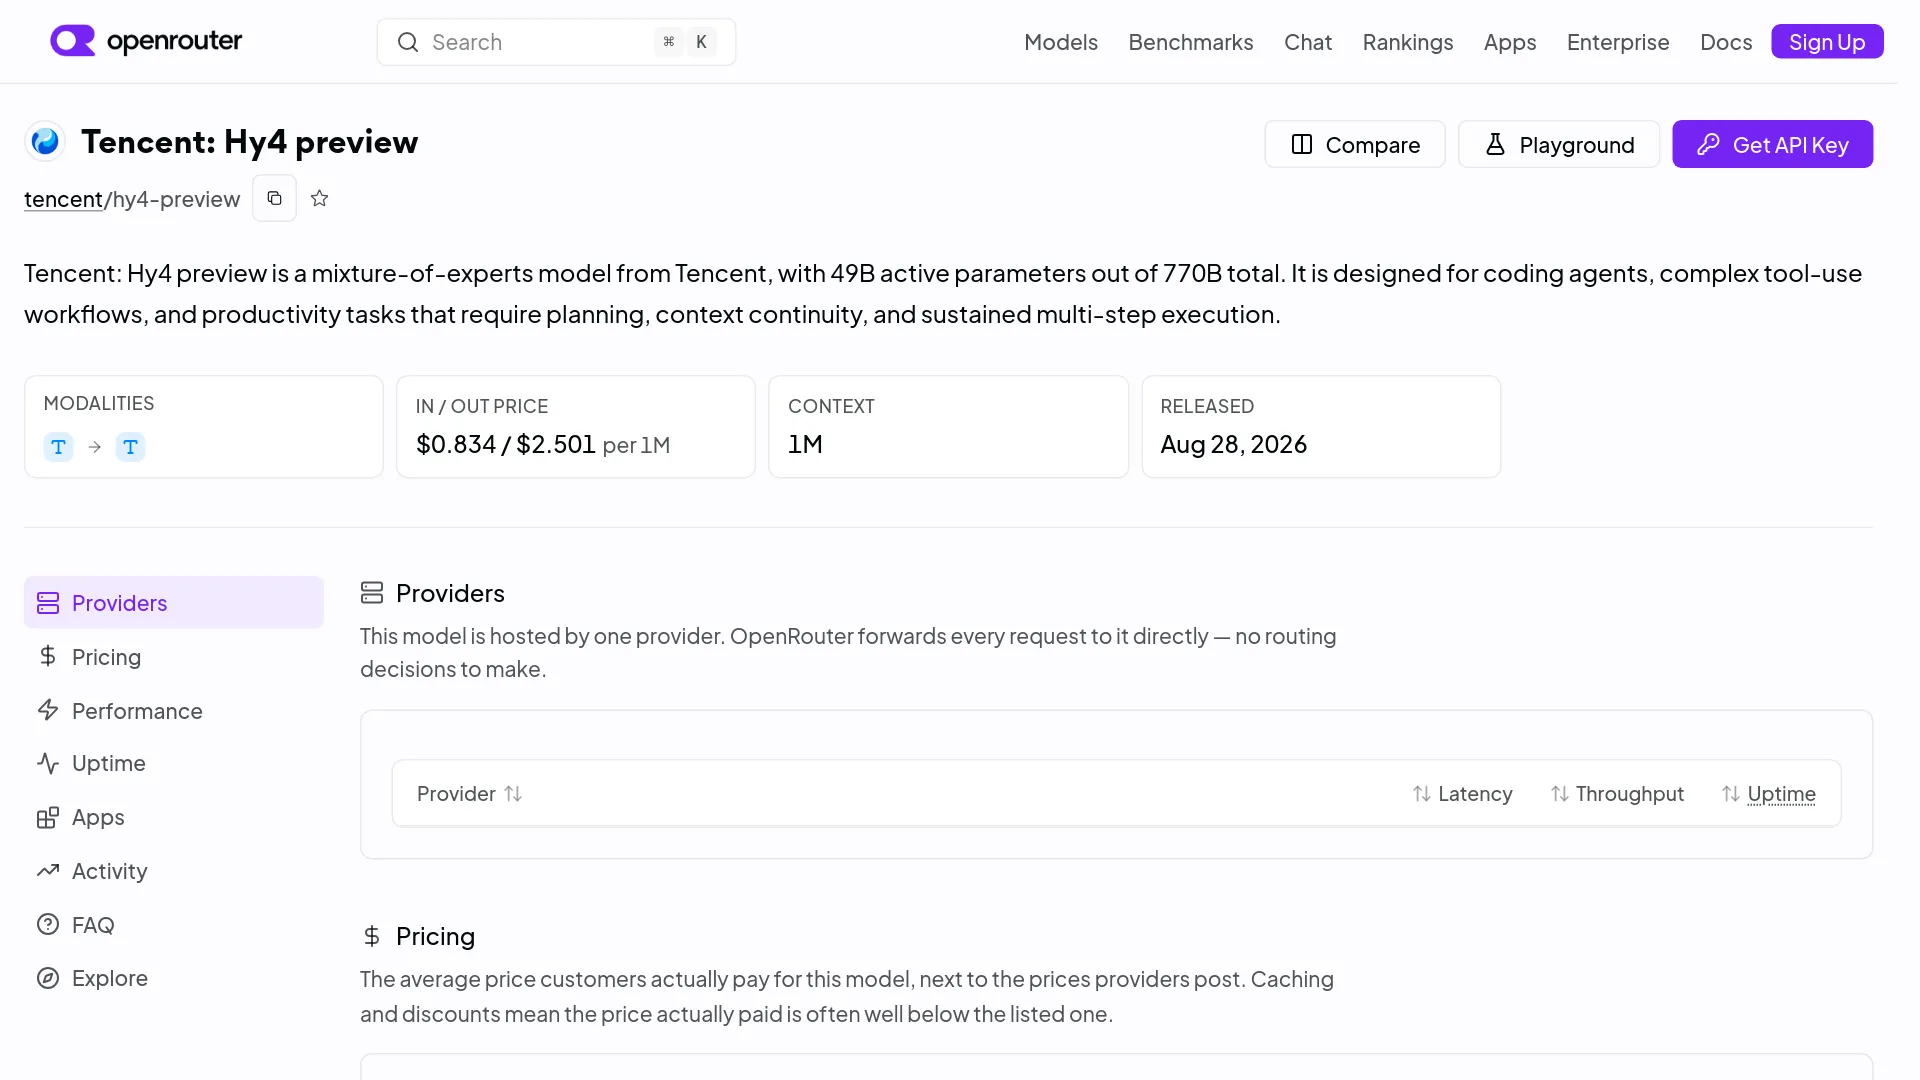
La página oficial de precios de Tencent Cloud TokenHub, actualizada el 28 de agosto de 2026, es la fuente más sólida para las tarifas en CNY. La página del modelo en OpenRouter documenta el ID del modelo alojado, el límite exacto de contexto, el máximo de finalización y las funciones disponibles en el endpoint.
Al dividir cada importe de OpenRouter entre su equivalente de Tencent se obtiene aproximadamente $0.139 por CNY en los tres conceptos. Es una correspondencia implícita entre las tarifas publicadas por ambos proveedores, no una cotización del tipo de cambio de mercado; los impuestos, costes de conversión, condiciones de la cuenta y el enrutamiento pueden modificar la factura.
Ejemplo práctico de coste con Hy4
Una solicitud con 100.000 tokens de entrada y 10.000 tokens de salida cuesta CNY 0.78 según la tarifa publicada por Tencent:
- Entrada:
0.1 × CNY 6 = CNY 0.60. - Salida:
0.01 × CNY 18 = CNY 0.18. - Total: CNY 0.78.
Si los 100.000 tokens de entrada obtienen un acierto de caché, la misma solicitud cuesta aproximadamente CNY 0.21: 0.1 × CNY 0.30 + 0.01 × CNY 18.
Con los precios mostrados por OpenRouter, los totales equivalentes son $0.10841 sin caché y $0.02921 con la entrada almacenada en caché. Estas cifras asumen exactamente los volúmenes de tokens indicados y excluyen cargos específicos del proveedor o ajustes de cuenta.
La salida puede disparar el coste
En ambas tarifas mostradas, los tokens de salida cuestan tres veces más que los tokens de entrada sin caché. Por eso, las trazas largas de agentes, los parches de código y los informes generados pueden concentrar la mayor parte del gasto, incluso si se ha almacenado en caché un prompt de sistema estable o el prefijo de un repositorio.
Registra por separado la entrada nueva, la entrada leída desde caché y la salida. Un acierto de caché reduce la parte correspondiente al prompt, pero no abarata la respuesta generada.
Qué ofrece la API por ese precio
Hy4 preview es un modelo Mixture-of-Experts con una arquitectura de 770B parámetros totales, 49B parámetros activos por token y una ventana de contexto de 1M tokens. Tencent lo posiciona para trabajo de software de largo recorrido, planificación y tareas de productividad, aunque la evidencia disponible sobre su calidad procede del proveedor y no de un benchmark independiente de API.
| Dato de la API o del modelo | Detalle verificado |
|---|---|
| ID del modelo en OpenRouter | tencent/hy4-preview |
| Contexto | 1M tokens en la tarifa de Tencent; 1,048,576 en OpenRouter |
| Máxima finalización | 64,000 tokens en OpenRouter |
| Licencia | Apache License 2.0 en la ficha del modelo de Tencent |
| Checkpoints publicados | Hy4 preview y Hy4 preview-FP8 |
| Runtimes locales oficiales | vLLM y SGLang |
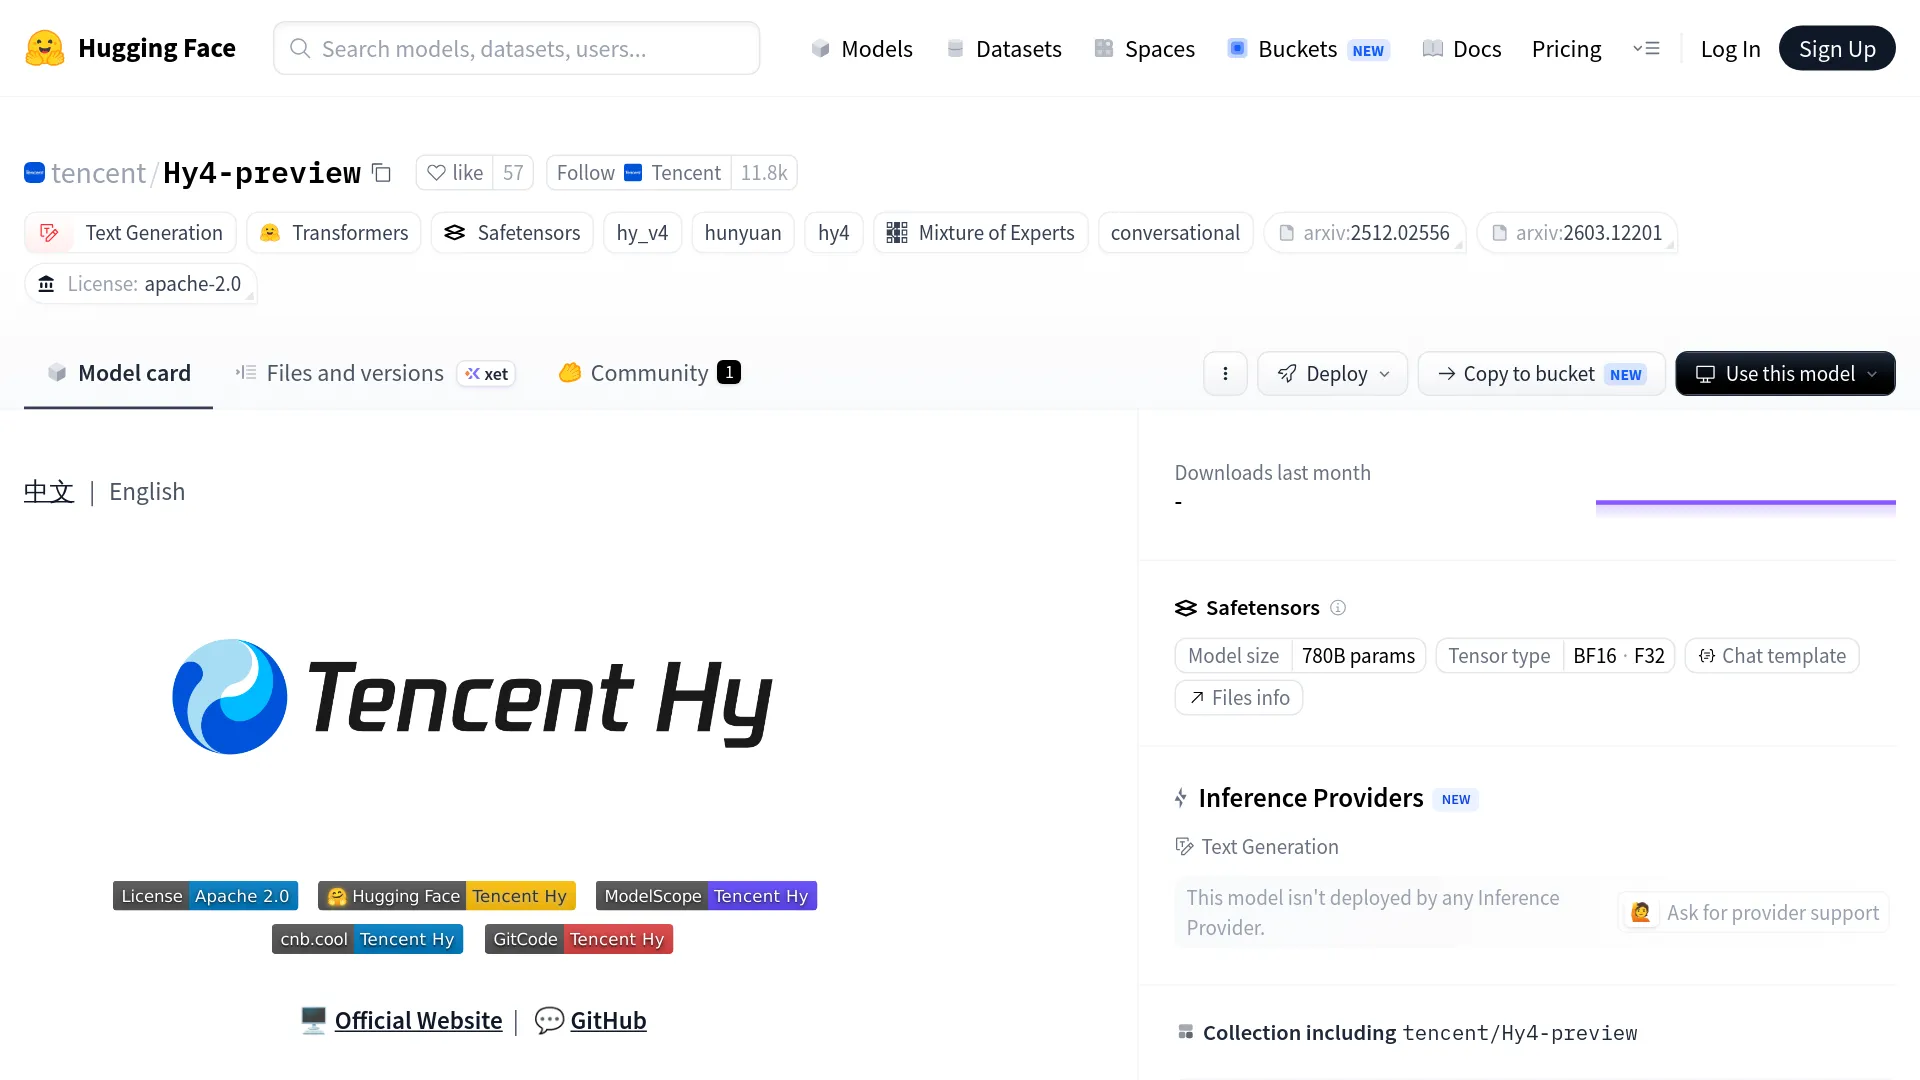
La ficha oficial del modelo de Tencent publica los pesos, la licencia y la documentación de despliegue. En sus ejemplos de serving recomienda el checkpoint FP8, pero no cuantifica sus diferencias de memoria, rendimiento o calidad frente al checkpoint sin FP8.
La limitación para agentes: OpenRouter no expone herramientas ni JSON forzado
La ficha de OpenRouter indica que este endpoint no acepta tools ni admite response_format para imponer salida estructurada. Es una limitación de esa vía de acceso, no una prueba de que todas las implementaciones locales de Hy4 carezcan de soporte para parsers.
Los ejemplos de Tencent para vLLM y SGLang incluyen parsers de llamadas a herramientas y razonamiento de Hy4. Si tu aplicación depende de function calling nativo o de JSON validado contra un esquema, confirma el comportamiento del proveedor elegido antes de integrarlo y prepara una capa externa de orquestación o validación cuando sea necesario.
¿API alojada o despliegue local?
Para evaluar el modelo y para la mayoría de las primeras pruebas en producción, el acceso alojado evita el trabajo de almacenamiento, GPU y runtime que exige la receta local publicada. Servirlo localmente solo tiene sentido si tu equipo ya opera GPU distribuidas o tiene una necesidad firme de control sobre los datos.
| Factor de decisión | API alojada | Despliegue local de Hy4 |
|---|---|---|
| Puesta en marcha | Cuenta del proveedor y clave de API | Descargar los pesos y preparar el runtime |
| Escalado | Gestionado por el proveedor | Los ejemplos oficiales usan paralelismo tensorial de 8 vías |
| Almacenamiento | Sin pesos locales | Repositorio de Hugging Face listado con unos 1.56 TB |
| Comportamiento de la API | Depende del proveedor | La configuración de vLLM/SGLang queda bajo tu control |
| Riesgo principal | Límites de preview y cambios de ruta | Hardware, compatibilidad del runtime y coste operativo |
Cuándo tiene sentido ejecutar Hy4 en local
Autoaloja Hy4 solo si ya dispones de infraestructura multi-GPU adecuada, necesitas mantener los prompts dentro de tu entorno, puedes mantener vLLM o SGLang y aceptas el comportamiento de un modelo preview. Tencent documenta vLLM con Python 3.12 y SGLang con transformers>=5.6.0, pero esos comandos son ejemplos, no requisitos mínimos garantizados.
Un hilo inicial de la comunidad ilustra además por qué la cuestión del hardware debe resolverse antes de hablar de benchmarks:
“I don't know who ... runs 780b models...” — u/_-_David in the r/LocalLLaMA Hy4 preview discussion.
Es la reacción de un usuario, no una medición de capacidad. Aun así, sirve como filtro: que un modelo tenga 1M de contexto no implica automáticamente que sea práctico ejecutarlo en local.
Hy3 sigue siendo la referencia más económica
Hy3 estándar es la opción de menor coste en la tabla actual de TokenHub de Tencent: CNY 1 de entrada, CNY 4 de salida y CNY 0.25 de entrada en caché por millón de tokens. La entrada nueva de Hy4 cuesta seis veces más y la salida 4.5 veces más, así que el cambio debe justificarse por una necesidad real de mayor contexto o de mejor rendimiento en tareas difíciles.
| Pregunta de selección | Elige Hy4 preview cuando… | Elige Hy3 estándar cuando… |
|---|---|---|
| Contexto | Tu carga de trabajo necesita la clase de 1M tokens | Tus prompts caben en un límite actual menor |
| Presupuesto | La capacidad adicional justifica el precio de CNY 6/18 | Lo más importante es reducir el coste por token |
| Estabilidad | Puedes probar una ruta preview | Prefieres una referencia consolidada y más sencilla |
La misma página oficial de TokenHub señala que Hy3 preview se retirará el 31 de agosto de 2026, por lo que no es un objetivo sensato para una integración nueva.
Antes de llevar Hy4 preview a producción
- Registra el proveedor, el ID del modelo, la divisa, la región y la fecha de la tarifa.
- Envía una solicitud breve y verifica el modelo y el proveedor devueltos.
- Repite una solicitud con un prefijo estable para comprobar la facturación de caché.
- Prueba la longitud de contexto que realmente necesita tu aplicación, en lugar de asumir calidad en toda la ventana.
- Evalúa por separado una finalización larga, ya que la salida es el concepto más caro.
- Envía solicitudes de llamadas a herramientas y salida estructurada si tu aplicación las necesita; OpenRouter actualmente indica que ambas no son compatibles.
- Registra entrada nueva, lecturas de caché, salida, errores y reintentos.
- Mantén una alternativa y prompts de regresión mientras la ruta acumula historial de disponibilidad y uso.
OpenRouter informa actualmente de datos insuficientes de disponibilidad y uso por aplicaciones para Hy4 preview. Esto no demuestra una fiabilidad deficiente, pero sí implica que hay poco historial público del servicio para planificar capacidad.
Preguntas frecuentes sobre el precio de la API de Hy4 preview
¿Cuál es el precio de la API de Hy4 preview?
Tencent Cloud TokenHub lista CNY 6 de entrada, CNY 18 de salida y CNY 0.30 de entrada en caché por millón de tokens. OpenRouter muestra $0.834, $2.501 y $0.042 para esos mismos conceptos en su página alojada.
¿Cuál es el ID de Hy4 preview en OpenRouter?
Usa tencent/hy4-preview. Confirma el proveedor y el modelo devueltos en tu cuenta, porque la configuración de enrutamiento alojado puede cambiar.
¿Hy4 preview admite una ventana de contexto de 1M tokens?
Sí. La ficha del modelo de Tencent indica 1M tokens, mientras que OpenRouter especifica 1,048,576 tokens y un máximo de finalización de 64,000 tokens para su ruta.
¿Hy4 preview es open source?
Tencent publica los checkpoints de Hy4 preview bajo Apache License 2.0 en su ficha oficial del modelo. Para los checkpoints descargables, «open-weight» es una descripción más precisa.
¿El endpoint de OpenRouter admite llamadas a herramientas?
La ficha de OpenRouter recopilada indica que no. No acepta tools ni admite salida estructurada forzada mediante response_format; el serving local y otros proveedores pueden presentar un comportamiento diferente.
La decisión, en una línea
Usa una ruta alojada de Hy4 preview para evaluaciones controladas y experimentos de contexto largo; autoalójalo solo si la capacidad de GPU distribuidas, las necesidades de control de datos y el riesgo propio de un modelo preview encajan con tu carga de trabajo.