 AIREITER
GLM-5.2 ocupa el segundo puesto en el Code Arena Frontend board de Arena, con 1.595 Elo, y queda a un solo punto de Claude Opus 4.8 en FrontierSWE. Aun así, muchos desarrolladores buscan salir de él. No suele ser por falta de capacidad: desde su lanzamiento en junio de 2026, se repiten tres problemas en las conversaciones de desarrolladores citadas más abajo: las cuotas de los planes de programación se evaporan a mitad de tarea, aparecen errores en horas punta y el modelo consume tantos tokens que sus $1.40/$4.40 dejan de parecer tan baratos en bucles largos de agentes. La mejor alternativa a GLM-5.2 depende de cuál de esas barreras te hayas encontrado.
Selección rápida: la mejor alternativa a GLM-5.2 según el problema
Estas son las cinco conclusiones principales; más abajo está la evidencia.
- Cuotas agotadas / coste por bucle de agente: DeepSeek V4 Flash, por $0.14/M de entrada, $0.28/M de salida y 1M de contexto.
- Bucles de agentes inestables: Kimi K2.7 Code, por $0.95/M de entrada y $4.00/M de salida.
- Máximo rendimiento en las tareas más difíciles: Claude Opus 4.8, con el doble de puntuación que GLM-5.2 en SWE-Marathon, a precios de modelo cerrado.
- Autoalojamiento o control de datos: Qwen3-Coder, bajo Apache 2.0, o los propios pesos MIT de GLM-5.2 si dispones de 372–475 GB de RAM para una compilación de 4 bits.
- No tienes ningún problema; solo quieres lo más nuevo: GLM-5.3, con el mismo precio de $1.40/$4.40, confirmado por Z.ai el día de su lanzamiento.
Qué hace bien GLM-5.2 y cuánto cuesta operarlo
La documentación oficial de Z.ai presenta GLM-5.2 como su modelo insignia solo de texto: ventana de contexto de 1M de tokens, salida máxima de 128K y precios API de $1.40/M de entrada, $4.40/M de salida y $0.26/M de entrada en caché. Sus pesos se publicaron bajo licencia MIT el 16 de junio de 2026, tras un despliegue del 13 de junio que inicialmente restringió el acceso al GLM Coding Plan. En su model card figura con 81.0 en Terminal-Bench 2.1 frente a 85.0 de Opus 4.8; 62.1 en SWE-bench Pro frente a 69.2; y 74.4 en FrontierSWE frente a 75.1.
Son cifras al borde de la frontera de los modelos cerrados, pero con precios de pesos abiertos. El problema aparece en la capa operativa. El nivel Pro del Coding Plan pasó de menos de $35 a $65 al mes alrededor del lanzamiento de 5.2, una subida que @bridgemindai documentó el mismo día. Sin embargo, las quejas sobre las cuotas del plan son más duras que las del precio:
"GLM 5.2 will end your weekly rate limit in a day." — u/intl_spy, r/opencode
"I like GLM-5.2, but my god it is a token muncher." — @atomtanstudio
Un desarrollador que utilizaba agentes autoevolutivos con GLM-5.2 en trabajo real informó de más de $500 en un solo fin de semana. También señaló que cambiar de modelo durante una ejecución elimina la caché KV y obliga a volver a pagar por el mismo contexto (@Xianbao_QIAN). Otro desarrollador resumió así el límite de su propuesta de valor:
"GLM 5.2 is great but my $200/m Codex sub still gets me more usage for $200 of GLM 5.2 API usage. It's a great supplemental model... but not a replacement by any means." — @mweinbach
A esto se añaden los problemas de capacidad en horas punta. @gengdaJ, suscriptor del plan desde GLM-4.5, describe cómo los servidores por la noche "explotan" y le obligan a volver a modelos más antiguos. Ese es el contexto completo detrás de las búsquedas de alternativas a GLM-5.2 por parte de usuarios a quienes, en realidad, les gusta el modelo.
Alternativas comparadas por precio y problema
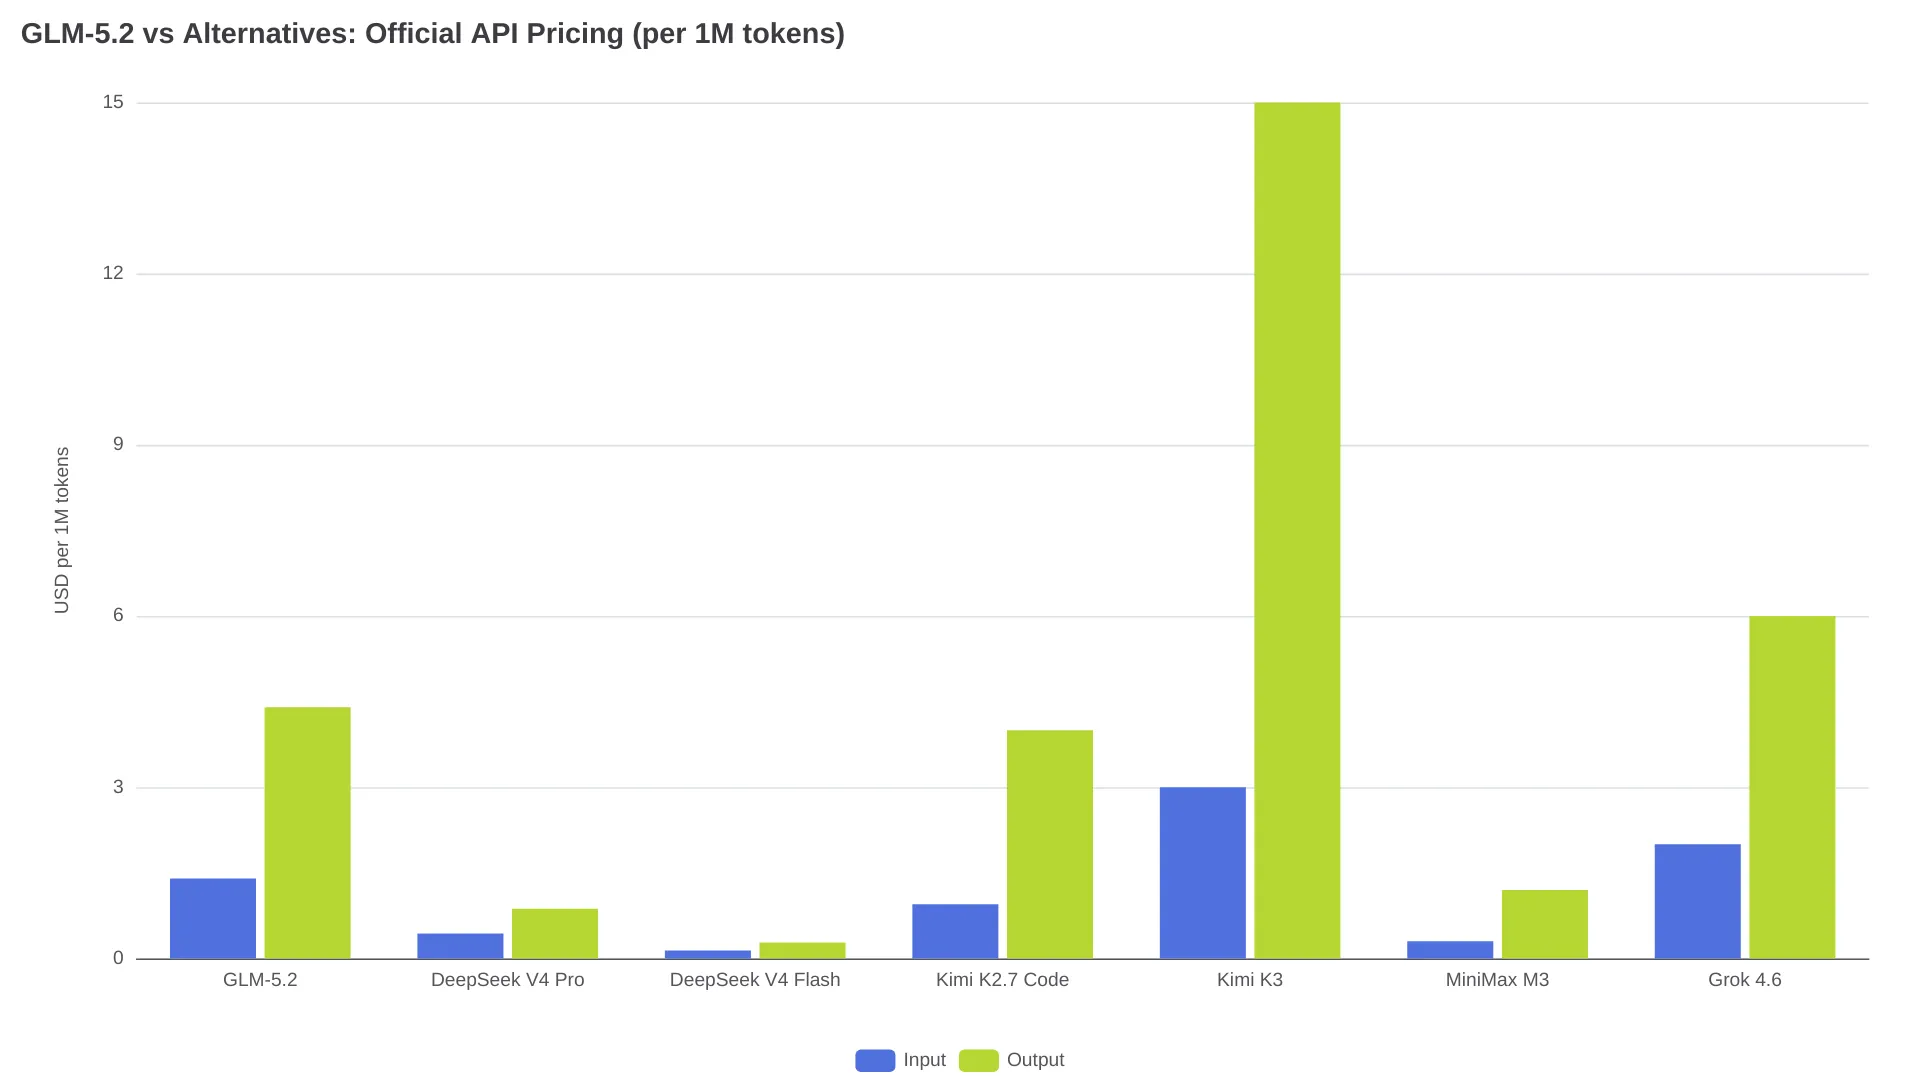
Todos los precios que aparecen a continuación proceden de las páginas de precios de cada proveedor y fueron consultados en agosto de 2026. Los precios de Kimi K3 y MiniMax M3 corresponden a entrada sin caché; sus niveles con acierto de caché son mucho más baratos.
| Modelo | Contexto | Pesos / licencia | Precio API ($/1M, entrada / salida) | Cámbiate si… |
|---|---|---|---|---|
| GLM-5.2 (referencia) | 1M | MIT | $1.40 / $4.40 | — |
| DeepSeek V4 Pro | 1M | Abierto (MIT, según Layer3 Labs) | $0.435 / $0.87 | Buscas razonamiento complejo más barato con el mismo contexto |
| DeepSeek V4 Flash | 1M | Abierto | $0.14 / $0.28 | El consumo de cuota es todo tu problema |
| Kimi K2.7 Code | 256K | Abierto (MIT modificada) | $0.95 / $4.00 | La fiabilidad de los bucles de agentes importa más que el tamaño de contexto |
| Kimi K3 | 1M | Cerrado | $3.00 / $15.00 | Necesitas la estabilidad de Kimi y 1M de contexto |
| MiniMax M3 | 1M | Cerrado | $0.30 / $1.20* | Necesitas entrada multimodal o trabajo de alto volumen sensible al precio |
| Qwen3.8 Max / Qwen3-Coder | 1M | Apache 2.0 | Pesos gratis; alojamiento variable | Tu objetivo es autoalojar o ajustar el modelo |
| Grok 4.6 | 500K | Cerrado | $2.00 / $6.00 | Priorizas velocidad y un contexto amplio pero manejable |
Además de estos siete, hay dos rutas de actualización: Claude Opus 4.8 para equipos que fallan de forma repetida en las tareas más difíciles, y GLM-5.3 para actualizar dentro de la misma familia y al mismo precio.
\* El nivel de MiniMax M3 aplica a entradas de ≤512K tokens; el precio se duplica por encima de ese umbral. GLM-5.3 mantiene un precio idéntico al de GLM-5.2 según el anuncio de lanzamiento de Z.ai, por eso no aparece en la comparativa de costes.
Qué modelo elegir según el síntoma
La cuota desaparece: deriva el bucle a DeepSeek V4 Flash
Las cuentas son contundentes. En entrada sin caché, GLM-5.2 cuesta $1.40/M, frente a los $0.14/M de DeepSeek V4 Flash: 10x más. En salida, la diferencia entre $4.40 y $0.28 es de 15.7x. En la parte de ejecución de un bucle de agente —edición de archivos, corrección de pruebas y código repetitivo— esa distancia se acumula en cada turno. Además, DeepSeek ofrece la misma ventana de contexto de 1M de tokens y una salida máxima de 384K. V4 Pro, por $0.435/$0.87, conserva gran parte del descuento y apunta a las ejecuciones de razonamiento más exigentes; nuestro análisis de GLM-5.2 frente a DeepSeek V4 Pro explica dónde gana cada uno, y el cara a cara con V4 Flash cubre la opción económica.
El patrón al que han llegado los suscriptores de OpenCode Go no es sustituir un modelo por otro, sino dividir el trabajo: GLM-5.2 para planificación y revisión, y un modelo barato para la parte pesada. "I use OpenCode Go GLM 5.2 for planning only", escribe u/narkeeso; en el mismo ecosistema, u/Endoky lo resume como "only use GLM 5.2 as escalation model or for planning."
Los bucles de agentes fallan: Kimi K2.7 Code
Cuando el problema es el servicio y no la capacidad, Kimi es la alternativa que más aparece en los hilos revisados. Así lo resumió un usuario, originalmente en chino:
"The model capability is about the same, but the inability to serve it stably is why I chose Kimi over GLM." — @wonjder
Kimi K2.7 Code es la opción especializada en programación: $0.95/M de entrada, $4.00/M de salida y $0.19/M en aciertos de caché. Su contexto es de 262,144 tokens, una cuarta parte de la ventana de GLM-5.2, y esa es la concesión real. Acepta entrada de texto, imagen y vídeo, por lo que también cubre la carencia multimodal de GLM-5.2 como modelo solo de texto. Si 256K no bastan para tu repositorio, Kimi K3 ofrece 1M de contexto por $3.00/$15.00. Ten en cuenta que esos $15 de salida son 3.4x la tarifa de GLM-5.2: K3 es una compra de estabilidad, no de ahorro. La comparativa de Kimi K2.7 Code frente a GLM-5.2 profundiza en los benchmarks.
Un techo más alto para las tareas más duras: Claude Opus 4.8
En SWE-Marathon —compilaciones de compiladores, trabajo de kernel y tareas autónomas de varias horas— Opus 4.8 logra 26.0 frente a 13.0 de GLM-5.2. En NL2Repo, la diferencia es 69.7 frente a 48.9, según la model card de Z.ai. GLM-5.2 sigue siendo el modelo abierto mejor clasificado en ambos tableros, de acuerdo con esa misma model card, pero la distancia crece justo cuando las tareas se alargan. Opus es cerrado, no puede autoalojarse y tiene precios premium; la comparativa de GLM-5.2 frente a Opus detalla cuándo compensa pagar esa prima.
Autoalojamiento y control de datos: Qwen3-Coder o los propios pesos de GLM
Qwen3-Coder y Qwen3.8 Max se distribuyen bajo Apache 2.0, con 1M de contexto y variantes compactas pensadas para servir en una sola GPU. Tanto Layer3 Labs como glm5.app los señalan como la opción para autoalojamiento. Para ajuste fino y despliegues privados, son la alternativa práctica dentro de esta lista; nuestro artículo sobre los pesos abiertos de Qwen 3.8 Max cubre la familia.
La opción contraintuitiva es autoalojar el propio GLM-5.2, ya que la licencia MIT lo permite. Pero los requisitos físicos son poco amables: los pesos BF16 ocupan 1.51 TB, e incluso una cuantización de 4 bits de la versión GGUF de Unsloth necesita 372–475 GB de memoria para cargarse. En la práctica, una compilación de 4 bits requiere un servidor con varias GPU, BF16 completo opera a escala de clúster y las herramientas locales aún son recientes: llama.cpp no incorporó soporte para el indexador de GLM-5.2 hasta el 24 de julio de 2026, en la PR #25407. Autoalojar GLM-5.2 es una decisión de soberanía de datos, no de comodidad; sin un clúster, las variantes compactas de Qwen son la alternativa de clase workstation.
Multimodalidad y volumen económico: MiniMax M3
MiniMax M3 combina 1M de contexto con entrada multimodal por $0.30/M de entrada y $1.20/M de salida en el nivel de ≤512K. Ambas cifras se duplican al superar ese umbral, así que conviene presupuestarlo. Para equipos, los planes de tokens de MiniMax cuestan $20/$50/$120 al mes y cubren la gama M3, M2.7, imagen y voz de la compañía, con cuota medida en ventanas móviles de 5 horas y semanales.
Si la velocidad es lo primero: Grok 4.6
Grok 4.6 cuesta $2.00/M de entrada y $6.00/M de salida, con 500K de contexto. La página API de xAI afirma ofrecer rendimiento líder del sector en programación y llamadas a herramientas, pero no publica la tabla de benchmarks; trátalo como posicionamiento, no como prueba. La señal de usuarios sí existe: @bourneliu66 sostiene que Grok ocupó el lugar de GLM en su "big three", al considerarlo más potente, rápido y barato. Valídalo con tu propia carga de trabajo antes de aceptar ese orden.
No hay ningún problema; quieres el GLM más reciente: GLM-5.3
GLM-5.3 llegó a la API el 18 de agosto de 2026 por el mismo precio que GLM-5.2, según el anuncio de Z.ai. Si estás mirando alternativas por ansiedad de actualización y no por un problema concreto, la comparativa de GLM-5.2 frente a GLM-5.3 explica qué cambió realmente.
La estrategia de dos modelos: conserva GLM-5.2, pero bájalo de categoría
En los hilos anteriores aparece una solución recurrente que no consiste en una migración total: relegar GLM-5.2 a planificador o revisor mientras un modelo más barato ejecuta. Encaja con el perfil del modelo: Z.ai lo posiciona para trabajo de agentes de ingeniería de larga duración, y es el más caro por token dentro del segmento económico.
Dos detalles determinan si esta división funciona. Primero, la pérdida de caché KV: cualquier cambio de modelo a mitad de ejecución, o de proveedor para el mismo modelo, obliga a pagar de nuevo el contexto. Segundo, las diferencias entre proveedores: usuarios de r/opencodeCLI describen grandes diferencias de velocidad entre Fireworks, NeuralWatt y OpenCode Go sirviendo el mismo modelo.
Un único endpoint compatible con OpenAI resuelve la mitad operativa: mantienes una misma estructura de solicitud de la API de GLM-5.2 para ambas fases, rediriges cuando un proveedor se degrada y centralizas una sola factura. No hace que el contexto sea gratis: la reutilización de caché nunca se transfiere entre modelos ni entre proveedores, el coste que explica el informe de $500 en un fin de semana. Por eso, enruta en los límites de la tarea, no a mitad de ejecución. Si tu división de modelos vive dentro de Claude Code, nuestra guía para usar GLM-5.2 en Claude Code cubre la parte del entorno.
Tabla de decisión en 30 segundos
| Tu síntoma | Elección | Qué sacrificas |
|---|---|---|
| La cuota semanal se agota en un día | DeepSeek V4 Flash | Parte del refinamiento en programación agéntica de GLM |
| Los bucles de agentes mueren por errores del proveedor | Kimi K2.7 Code | Contexto de 1M; tendrás 256K |
| Fallan las tareas más difíciles de varias horas | Claude Opus 4.8 | Pesos abiertos, precio bajo y autoalojamiento |
| Necesitas pesos en tu propia infraestructura | Qwen3-Coder | El rendimiento líder en programación frontend de GLM |
| Consume demasiados tokens en trabajo general | MiniMax M3 | Por encima de 512K de entrada, los precios se duplican |
| Requisitos regulatorios o de compras | Pesos autoalojados de Qwen o GLM | La comodidad de un servicio gestionado |
| Quieres el GLM más reciente | GLM-5.3 | Nada; mismo precio |
Preguntas frecuentes
¿Cuál es la mejor alternativa general a GLM-5.2?
DeepSeek V4 Pro es el sustituto más cercano en términos generales: 1M de contexto, pesos abiertos y un coste por token entre 3 y 5 veces menor. Kimi K2.7 Code es mejor elección cuando la fiabilidad en ejecuciones largas de agentes importa más que la diferencia de benchmarks.
¿DeepSeek es mejor que GLM-5.2 para programar?
Para razonamiento algorítmico complejo, la comparativa de glm5.app sitúa a DeepSeek V4 Pro por delante. Para trabajo agéntico de varios archivos y largo horizonte, el contexto de 1M de GLM-5.2 y su entrenamiento para agentes de largo recorrido —la especialización declarada por Z.ai— lo mantienen por delante. En la práctica: DeepSeek ejecuta; GLM planifica.
¿Cuál es la alternativa más barata a GLM-5.2?
DeepSeek V4 Flash, por $0.14/M de entrada y $0.28/M de salida, con entrada en aciertos de caché a $0.0028/M, prácticamente gratuita para contexto repetido.
¿Qué alternativas igualan el contexto de 1M de tokens de GLM-5.2?
DeepSeek V4 Pro y V4 Flash, Kimi K3, MiniMax M3 y Qwen3.8 Max incluyen ventanas de 1M de tokens. Kimi K2.7 Code, con 256K, y Grok 4.6, con 500K, no.
¿Se puede ejecutar GLM-5.2 localmente en vez de cambiar de modelo?
Técnicamente sí, porque existen pesos MIT, pero una compilación de 4 bits necesita 372–475 GB de RAM y el soporte de llama.cpp no se integró hasta el 24 de julio de 2026. Para la mayoría de equipos, el acceso por API alojada es la única vía práctica.
¿Cuánto cuestan al mes las alternativas a GLM-5.2 por suscripción?
Los planes de tokens de MiniMax cuestan $20–$120 al mes. Code CLI de Kimi empieza en $19 al mes y el Coding Plan de Z.ai en $18 al mes, según la cobertura de precios de Digital Applied; el nivel Pro de Z.ai cuesta $65 desde la subida de junio.