 AIREITER
Gemini 3.8 Flash cuesta $0.75 por cada millón de tokens de entrada y $3.75 por cada millón de tokens de salida hasta el 31 de diciembre de 2026, aunque su razonamiento más intensivo puede encarecer las tareas completadas. Tiene sentido probarlo en agentes multimodales y especializados, no migrar automáticamente todas las solicitudes de Gemini 3.7 Flash.
La respuesta rápida: qué es realmente Gemini 3.8 Flash
Gemini 3.8 Flash se lanzó el 2 de septiembre de 2026, según el anuncio de lanzamiento de Google, con el ID estable de modelo para la API gemini-3.8-flash. Google lo orienta a la ingeniería de software, los agentes autónomos y los flujos de trabajo empresariales de varios pasos. La página del modelo de Google AI for Developers lo presenta como estable, mientras que la ficha de modelo de Google DeepMind indica que está basado en Gemini 3.7 Flash.
Qué cambia frente a Gemini 3.7 Flash
Google afirma que Gemini 3.8 Flash da más pasos de razonamiento y utiliza las herramientas de forma iterativa en tareas complejas, aunque advierte de que un mayor nivel de esfuerzo puede consumir más tokens. Artificial Analysis registra una puntuación de 59 en el Intelligence Index con razonamiento alto, frente a 56 en Gemini 3.7 Flash, pero también un coste por tarea de $0.58, frente a $0.40. (Anuncio de lanzamiento de Google; comparativa de Artificial Analysis)
Elige la carga de trabajo antes que el modelo
Gemini 3.8 Flash destaca cuando una solicitud necesita un contexto amplio, varias herramientas o información multimodal. En cambio, las tareas breves y repetitivas quizá no saquen partido de sus ciclos adicionales.
Usa Gemini 3.8 Flash para agentes multimodales y especializados
BenchmarkList registra un 61.4% en Finance Agent v2, un 54.9% en HLE-Verified, un 87.8% en LVBench, un 86.2% en CharXiv-R y un 86.2% en LABBench2. Sus registros diferencian entre resultados del anuncio de lanzamiento, resultados declarados por el propio proveedor y resultados procedentes de fuentes independientes; por eso, estas cifras deben interpretarse como señales y no como una única prueba independiente y homogénea. (registro del modelo en BenchmarkList)
| Carga de trabajo | Datos que conviene valorar | Decisión |
|---|---|---|
| Finanzas y análisis estructurado | Finance Agent v2: 61.4% | Buen candidato para un piloto controlado |
| Comprensión de vídeos o gráficos extensos | LVBench: 87.8%; CharXiv-R: 86.2% | Buen candidato cuando los modelos de texto no encajan bien |
| Biología y flujos de trabajo científicos | LABBench2: 86.2%; BioMysteryBench human-difficult: 56.5% | Probar con revisión de expertos |
| Documentos extensos y PDF | Límite de entrada de 1,048,576 tokens; admite entradas PDF | Útil para recuperación y síntesis, pero hay que validar la capacidad de recuperación |
La ficha de modelo de Google sigue enumerando las alucinaciones, los tiempos de espera agotados y cierta lentitud ocasional entre sus limitaciones. (ficha de modelo de Gemini 3.8 Flash)
Mantén Gemini 3.7 Flash para el tráfico sencillo y orientado a la eficiencia
Una canalización de clasificación, extracción, etiquetado o generación de resúmenes breves quizá no necesite razonamiento adicional. Artificial Analysis midió Gemini 3.8 Flash en $0.24 por tarea y 0.8 minutos con razonamiento bajo, frente a $0.58 y 2.5 minutos con razonamiento alto. Las cifras de Gemini 3.7 Flash con razonamiento alto fueron de $0.40 por tarea y 2.2 minutos.
Usa 3.8 cuando el razonamiento adicional evite que una tarea falle; mantén 3.7 cuando ese trabajo extra solo incremente el coste.
No lo consideres un ganador universal para la programación autónoma
BenchmarkList registra un 89.4% en Terminal-Bench 2.1 y un 73.7% en DeepSWE 1.1, pero solo un 19.1% en Terminal-Bench 4.0. También recoge un 59.0% en OSWorld 2.0, una evaluación de uso informático con horizontes largos. (resultados de programación y agentes de BenchmarkList)
Si tu agente de terminal o escritorio tiene que reconstruir estados ocultos, comprobar los cambios y continuar después de fallos en las herramientas, compara Gemini 3.8 Flash con tu modelo actual en el mismo flujo de trabajo antes de cambiar.
El coste se decide por tarea, no por millón de tokens
Precios de la API de Gemini 3.8 Flash hasta 2026
El anuncio oficial de lanzamiento de Google ofrece las siguientes tarifas directas para la API. El precio introductorio termina el 31 de diciembre de 2026 y la tarifa estándar comienza el 1 de enero de 2027. (anuncio de lanzamiento de Google)
| Periodo | Precio de entrada | Precio de salida | Lectura práctica |
|---|---|---|---|
| Hasta el 31 de diciembre de 2026 | $0.75 / 1M tokens | $3.75 / 1M tokens | Tarifa introductoria |
| Desde el 1 de enero de 2027 | $1.50 / 1M tokens | $7.50 / 1M tokens | Ambas tarifas se duplican |
Con la tarifa introductoria, la salida cuesta cinco veces más que la entrada. La documentación de Google también menciona Batch API, Flex inference y Priority inference, pero la página del modelo citada no muestra sus precios numéricos.
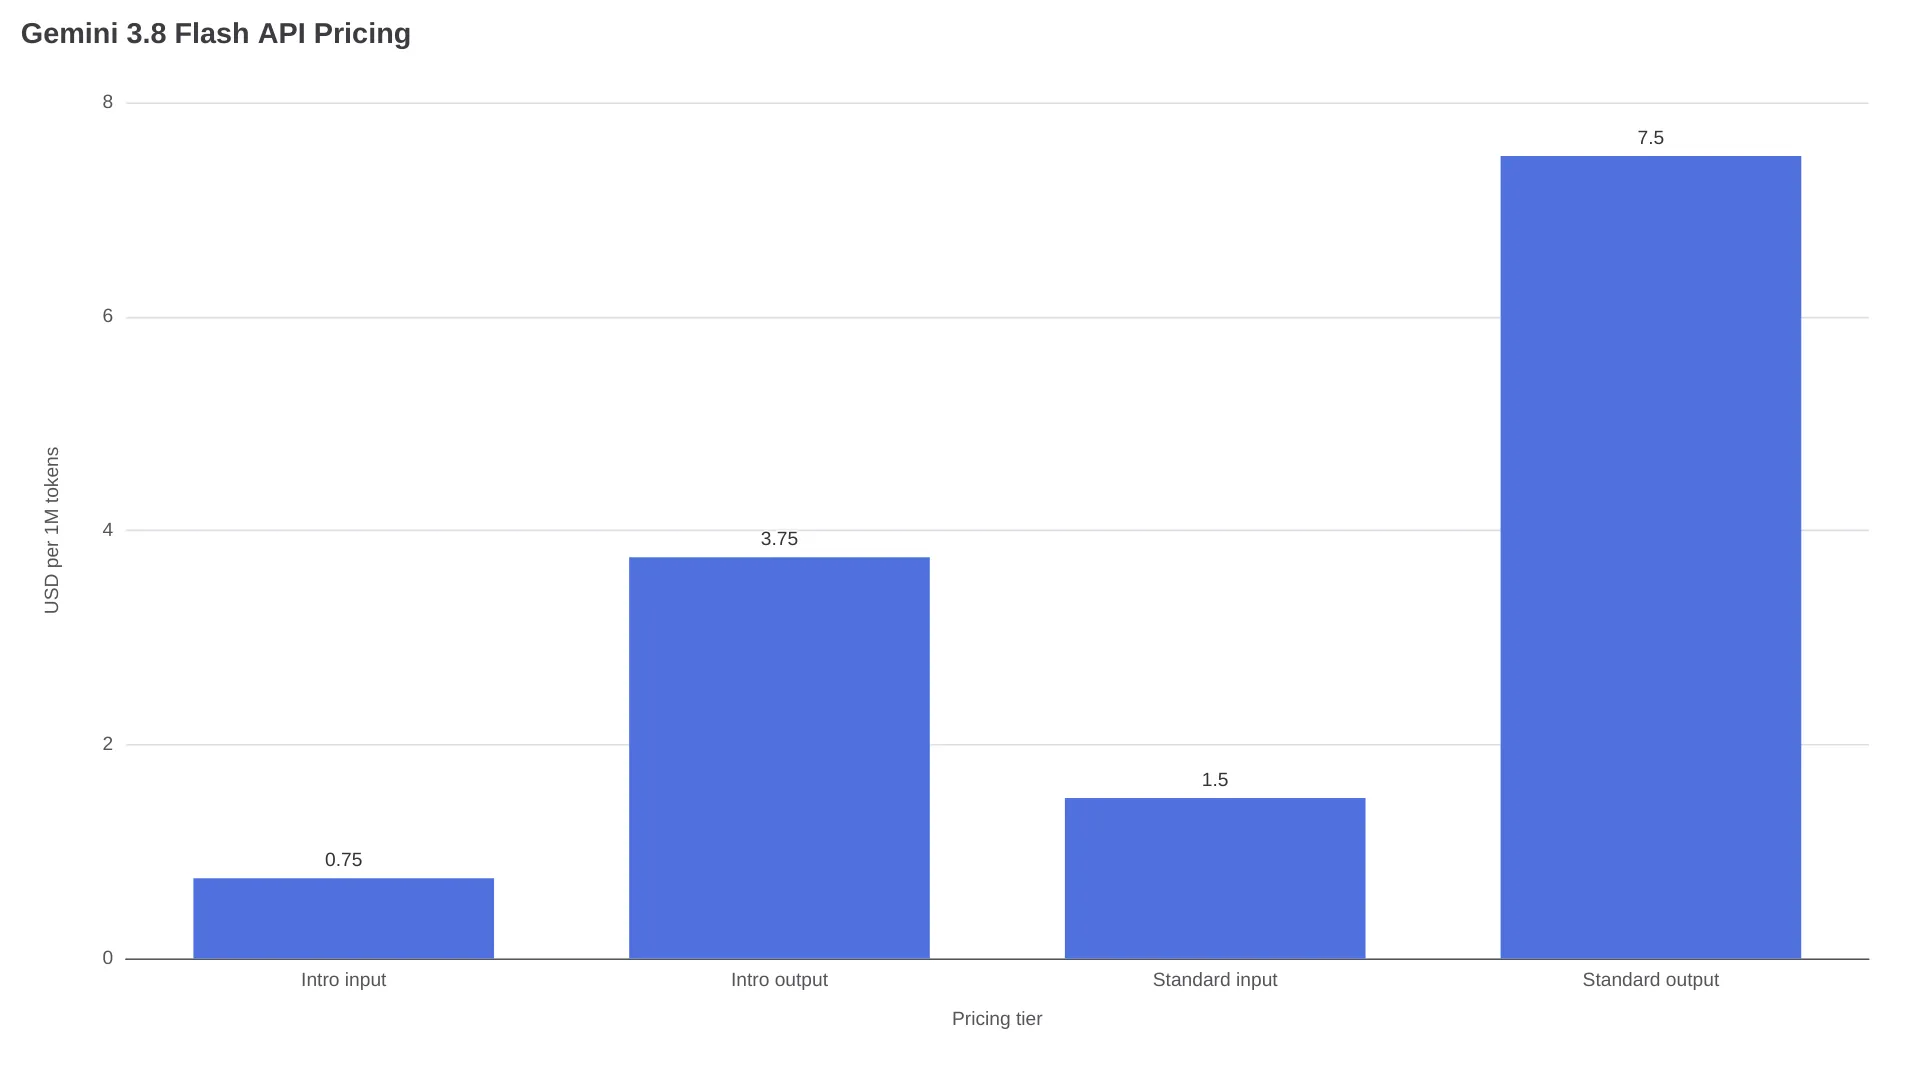
Una tarea que utilice 2 millones de tokens de entrada y 500,000 tokens de salida cuesta $3.38 con la tarifa introductoria: (2 × $0.75) + (0.5 × $3.75). La misma combinación cuesta $6.75 desde el 1 de enero de 2027: (2 × $1.50) + (0.5 × $7.50).
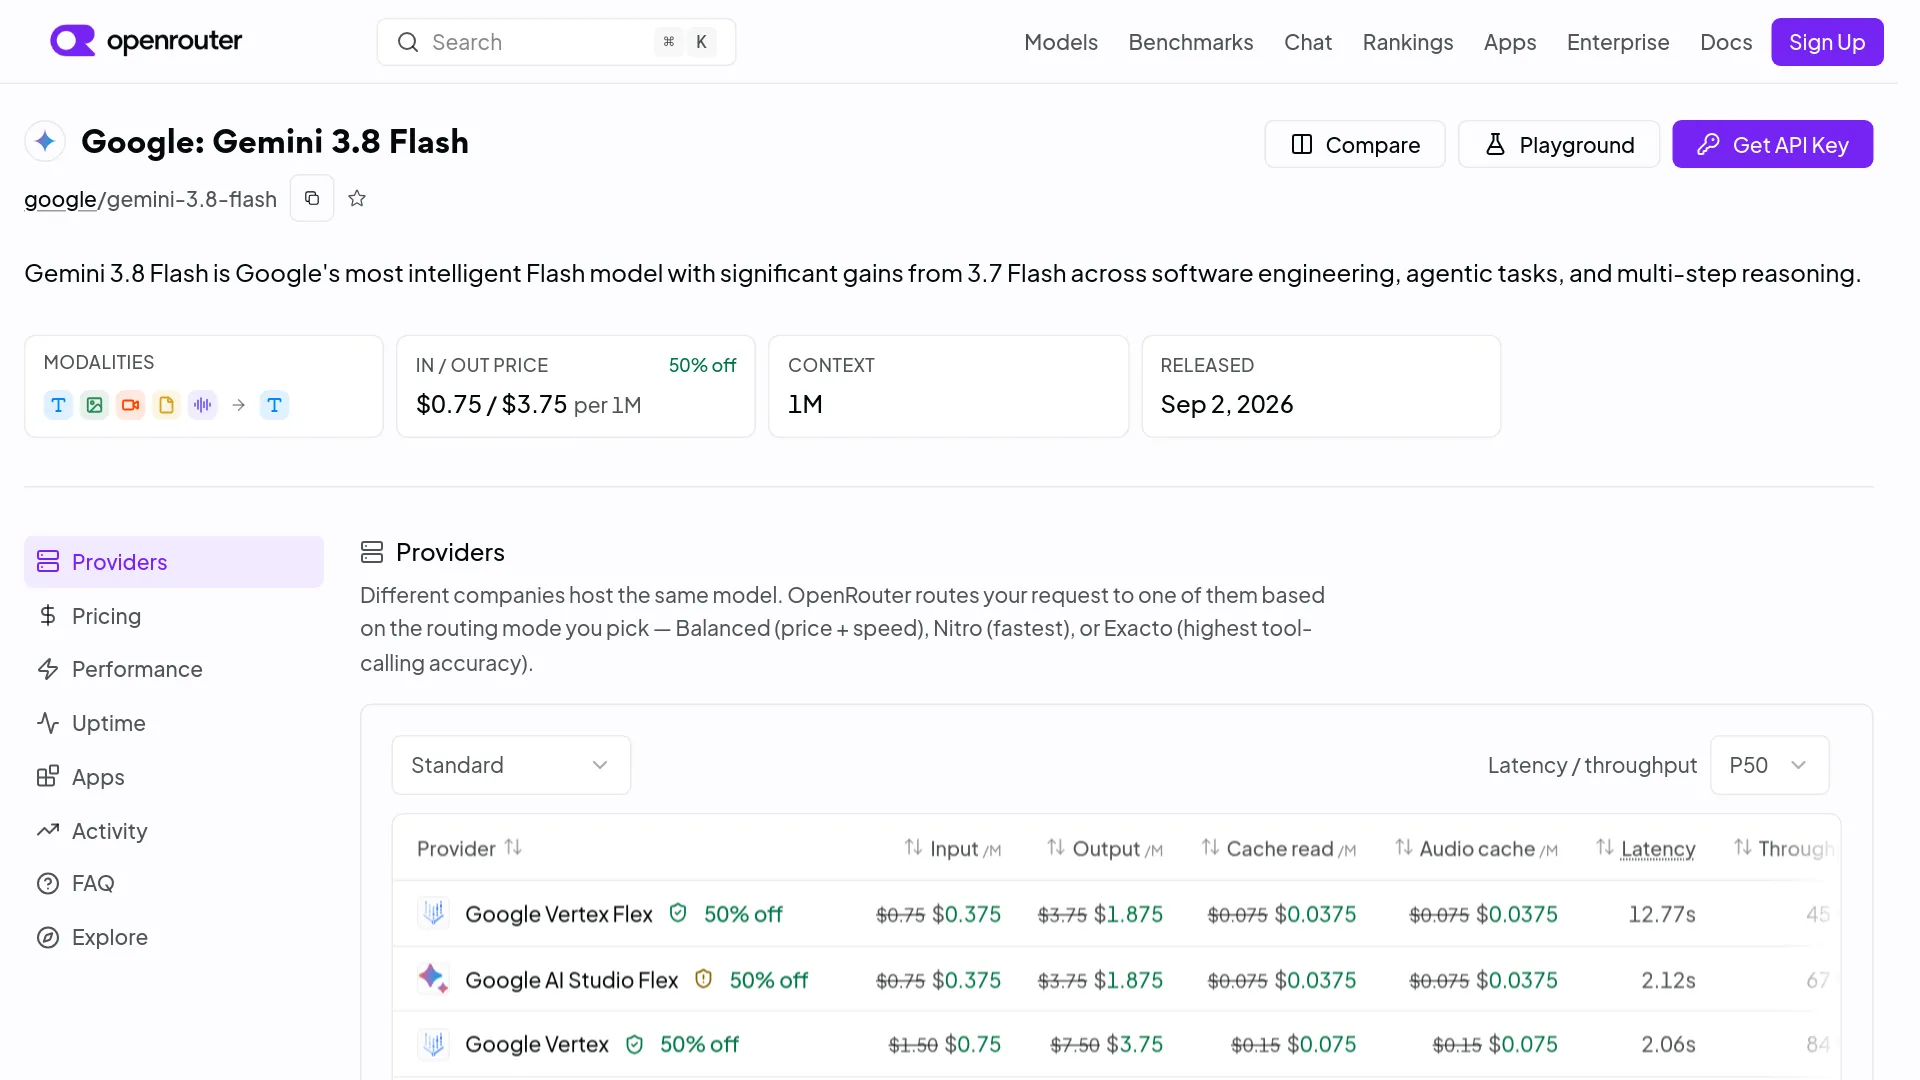
La página de Gemini 3.8 Flash en OpenRouter muestra por separado las rutas de Google Vertex y Google AI Studio, los precios de caché, la latencia, el rendimiento y un descuento visible. Comprueba el proveedor y la ruta de facturación antes de comparar el precio de un router con la tarifa directa de Google.
Por qué un token más barato puede acabar generando una factura mayor
Artificial Analysis ofrece las siguientes mediciones de Gemini 3.8 Flash según el nivel de razonamiento:
| Nivel de razonamiento | Intelligence Index | Coste por tarea | Tiempo por tarea |
|---|---|---|---|
| Bajo | 52 | $0.24 | 0.8 minutos |
| Medio | 57 | $0.41 | No indicado |
| Alto | 59 | $0.58 | 2.5 minutos |
Artificial Analysis no indica el tiempo con razonamiento medio en el análisis citado. El mismo análisis señala que Gemini 3.8 Flash generó 120 millones de tokens de salida durante su evaluación del Intelligence Index, frente a una mediana de 71 millones de tokens en modelos comparables. Es una medición de toda la evaluación, no una predicción para cada solicitud de la API. Aun así, deja claro por qué el precio por token, por sí solo, ofrece una visión incompleta del presupuesto de producción. (perfil del modelo en Artificial Analysis)
Para una comparación interna, calcula los tokens totales de entrada, entrada almacenada en caché, razonamiento y salida de cada tarea completada. Después, divide el gasto de la API entre las tareas correctas, no entre las solicitudes enviadas. Incluye las llamadas a herramientas, los reintentos y las correcciones humanas.
Límites y capacidades de la API
Qué admite la API estable
La página oficial del modelo indica un límite máximo de entrada de 1,048,576 tokens y un límite máximo de salida de 65,536 tokens. Gemini 3.8 Flash acepta entradas de texto, imágenes, vídeo, audio y PDF, y devuelve texto. Admite caché, ejecución de código, búsqueda de archivos, llamadas a funciones, grounding con Google Maps, grounding con búsquedas, salidas estructuradas, contexto de URL y uso del ordenador en Preview. (documentación oficial del modelo)
Los niveles de razonamiento son low, medium y high; minimal no es compatible y devuelve un error. El modelo no ofrece generación nativa de imágenes ni audio, y la documentación para desarrolladores no indica compatibilidad con Live API.
Dónde puedes usarlo y por qué Cyber es diferente
Google incluye Gemini 3.8 Flash en Gemini API, Google AI Studio, Android Studio, Stitch, Google Antigravity, Gemini Enterprise, la aplicación Gemini, AI Mode en Google Search y Gemini en Google Sheets. (anuncio de lanzamiento de Google)
Gemini 3.8 Flash Cyber es una variante de ciberseguridad independiente. Google afirma que el acceso a Fairwind se prioriza para defensores de confianza, incluidas autoridades gubernamentales, operadores de infraestructuras críticas y mantenedores de software. El anuncio de lanzamiento informa de más de un 70% de éxito en una prueba interna de descubrimiento de vulnerabilidades en 20 lenguajes de programación y de un 47.2% de pass@1 en la corrección de CWE-Bench; esas cifras corresponden a Cyber, no al modelo general. El anuncio de Google describe el acceso a través de Fairwind, así que no des por hecho que la ruta general de la API de Flash ofrece acceso a Cyber. (anuncio de Google sobre Cyber)
El despliegue inicial de un producto puede variar según la cuenta y la superficie. Un usuario de Reddit informó:
“3.8 Flash también me aparece ahora en la aplicación web de Gemini, así que parece que ya está oficialmente disponible. Estoy en Australia con una suscripción Pro, pero todavía no aparece en AntiGravity ni en la aplicación para iOS.” — u/DMAC80, r/GeminiAI
En una aplicación, verifica el ID de modelo de la API configurado, gemini-3.8-flash, y cualquier metadato de respuesta disponible para tu integración; la autodescripción de un modelo no verifica el endpoint.
Lo que las pruebas todavía no demuestran
| Limitación documentada | Implicación práctica |
|---|---|
| Artificial Analysis registra 13.39 segundos hasta el primer token de respuesta con razonamiento alto, pese a alcanzar después unos 304.6 tokens de salida por segundo. (perfil del modelo en Artificial Analysis) | Espera una pausa inicial de razonamiento seguida de una generación rápida. |
| La ficha de modelo de DeepMind indica un corte de conocimiento en marzo de 2026, con algunos dominios limitados a enero de 2025. (ficha de modelo de Gemini 3.8 Flash) | Usa grounding con búsquedas o recuperación verificada para la información actual. |
| El uso del ordenador solo está disponible en Preview, la documentación para desarrolladores no menciona una opción de alojamiento propio y la salida es texto, no imagen, audio ni vídeo. (documentación para desarrolladores de Google) | Mantén un despliegue o modelo alternativo para esos requisitos. |
Un plan de despliegue de bajo riesgo para el tráfico de producción
- Selecciona 30–50 tareas reales que representen tu mezcla de producción, incluidos los casos de contexto largo y los fallos conocidos.
- Ejecuta Gemini 3.8 Flash con niveles de razonamiento bajo, medio y alto frente a tu modelo actual.
- Registra los tokens totales, los aciertos de caché, los turnos de herramientas, los reintentos, el tiempo hasta el primer token, el tiempo de finalización, las correcciones humanas y la tasa de tareas aceptadas.
- Calcula el coste por tarea correcta y separa el tráfico interactivo del tráfico por lotes.
- Envía una pequeña parte de las solicitudes de producción al nuevo modelo antes de cambiar la ruta predeterminada.
- Mantén Gemini 3.7 Flash para los trabajos sencillos si el razonamiento adicional no mejora el coste por tarea aceptada.
- Presupuesta la tarifa del 1 de enero de 2027: $1.50 por millón de tokens de entrada y $7.50 por millón de tokens de salida.
La primera prueba debería tener un resultado verificable: un cambio en varios archivos con sus pruebas, un flujo documental con una respuesta conocida o una tarea de extracción multimodal con etiquetas revisadas.
Preguntas frecuentes sobre los precios de la API de Gemini 3.8 Flash
¿Cuánto cuesta Gemini 3.8 Flash?
La tarifa introductoria directa de la API de Google es de $0.75 por cada millón de tokens de entrada y $3.75 por cada millón de tokens de salida hasta el 31 de diciembre de 2026. Desde el 1 de enero de 2027, las tarifas indicadas pasan a ser de $1.50 y $7.50.
¿Es Gemini 3.8 Flash mejor que Gemini 3.7 Flash?
Obtiene mejores resultados en varias mediciones de razonamiento y capacidades agénticas del lanzamiento, incluido el resultado de 59 frente a 56 en el Intelligence Index de Artificial Analysis con razonamiento alto. Gemini 3.7 Flash puede seguir siendo más barato para el tráfico sencillo porque 3.8 puede utilizar más tokens de salida.
¿Es Gemini 3.8 Flash adecuado para agentes de programación?
Es un candidato sólido, con resultados publicados de 89.4% en Terminal-Bench 2.1 y 73.7% en DeepSWE 1.1. Su resultado del 19.1% en Terminal-Bench 4.0 indica que los flujos de trabajo de terminal y escritorio con horizontes largos necesitan una evaluación propia.
¿Gemini 3.8 Flash es gratis?
La API es de pago según las tarifas por token indicadas. Consulta por separado las condiciones actuales del proyecto en AI Studio y la tarifa directa de la API.
¿Qué es Gemini 3.8 Flash Cyber y quién puede acceder?
Gemini 3.8 Flash Cyber está optimizado para descubrir vulnerabilidades y automatizar parches. Google afirma que el acceso se prioriza a través del Fairwind Program para defensores de confianza; no es un modelo público general disponible con una clave normal de la API de Gemini 3.8 Flash.
Empieza con un nivel de razonamiento bajo o medio sobre un conjunto fijo de tareas, mide el coste por resultado aceptado y aumenta el nivel de esfuerzo solo cuando el trabajo adicional evite un fallo medible.