 AIREITER
Una llamada a gemini-2.5-pro el 2 de diciembre no fallará: responderá otro modelo. Google declaró obsoletos gemini-2.5-pro y gemini-2.5-flash el 2 de noviembre de 2026, y desde el 1 de diciembre de 2026 la Gemini Developer API redirigirá automáticamente esos identificadores a gemini-3.8-flash y gemini-3.5-flash-lite, aplicando las tarifas de los modelos de sustitución. El problema es que no se trata solo de cambiar de modelo: también cambia la categoría y hay parámetros incompatibles. Mantener la cadena antigua hasta diciembre es, por tanto, la opción más arriesgada.
Qué ha anunciado Google para el 1 de diciembre
Google ha declarado obsoletos gemini-2.5-pro y gemini-2.5-flash en la Gemini Developer API. Ambos identificadores ya han desaparecido del selector de Google AI Studio y el acceso a la API está limitado a los desarrolladores que hayan usado cada modelo anteriormente. Desde el 1 de diciembre de 2026, las solicitudes seguirán funcionando, pero se ejecutarán con otros modelos y tendrán tarifas distintas.
La correspondencia aparece en la página de obsolescencias de la Gemini API de Google:
| ID antiguo que utilizas | Modelo que responderá desde el 1 de diciembre de 2026 | Facturación desde el 1 de diciembre |
|---|---|---|
gemini-2.5-pro | gemini-3.8-flash | Tarifas de Gemini 3.8 Flash |
gemini-2.5-flash | gemini-3.5-flash-lite | Tarifas de Gemini 3.5 Flash-Lite |
gemini-2.5-flash-lite | sin cambios, no habrá redirección | sin cambios |
Google fija el 1 de diciembre de 2026 como fecha de redirección para ambos identificadores estables, y señala la entrada del registro de cambios del 2 de noviembre de 2026 como aviso oficial. Patrick Loeber, miembro del equipo de Google DeepMind, la enlazó en un aviso público en el que advertía que las integraciones avanzadas necesitan trabajo de migración.
Este aviso solo cubre la Gemini Developer API y AI Studio. Vertex AI sigue un calendario de retirada independiente para Gemini 2.5, con fechas de octubre de 2026 para esos mismos nombres de modelo en la documentación de Google Cloud. Por su parte, Firebase AI Logic mantiene su propia lista de modelos compatibles. Los usuarios de Vertex deberían consultar la consola de Cloud y no asumir que el 1 de diciembre se aplica a todos los servicios.
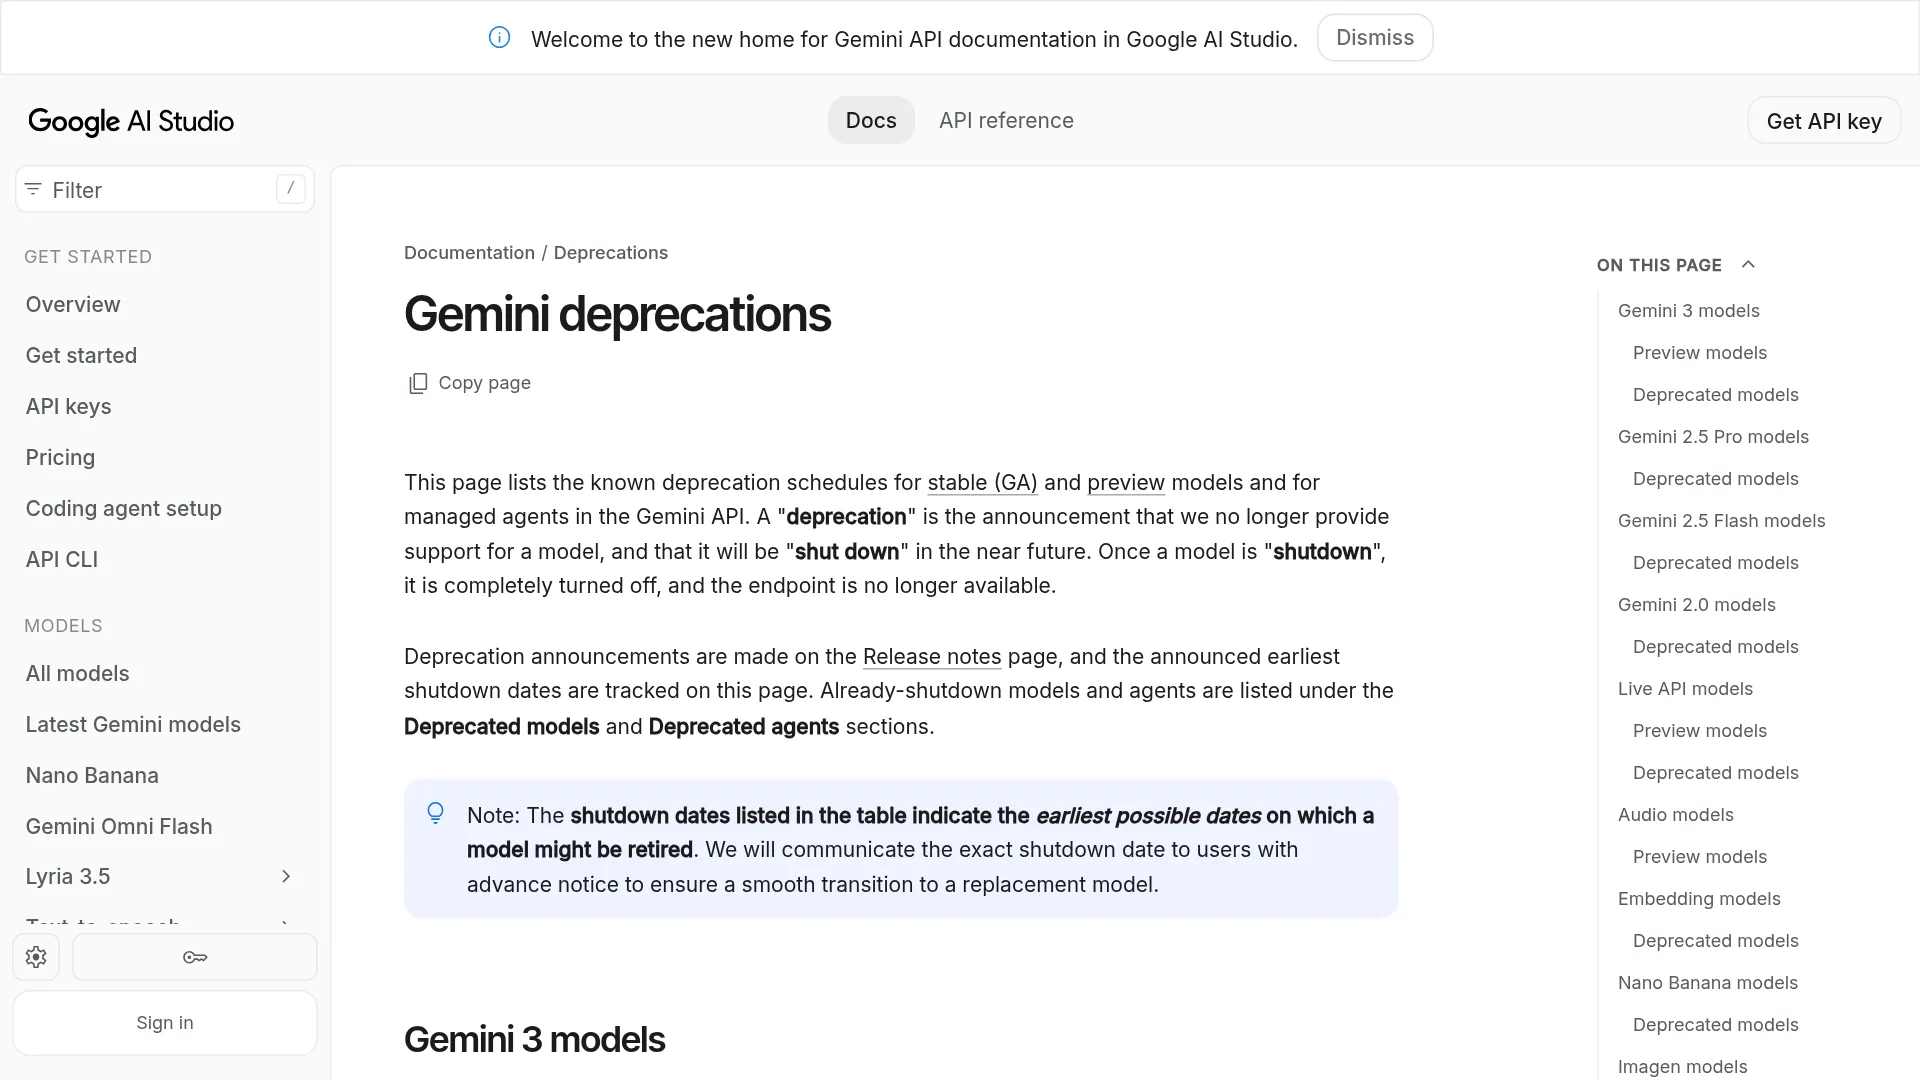
Google afirmó el 18 de septiembre que la versión 2.5 «no estaba obsoleta», pero la declaró obsoleta el 2 de noviembre. Conviene tratar el 1 de diciembre como una fecha definitiva. El historial de cambios recoge ese giro.
Cuánto costarán las llamadas redirigidas en diciembre y enero
El tráfico de Gemini 2.5 Pro será más barato en diciembre, aunque el coste de entrada subirá en enero. El tráfico de texto de Gemini 2.5 Flash mantendrá el mismo precio tras el cambio, mientras que la entrada de audio será mucho más barata. Todas las cifras siguientes son precios de lista del nivel de pago por cada 1M de tokens, tomados de la página de precios de la Gemini API de Google el 3 de noviembre de 2026. Para consultar los detalles de cada modelo, puedes ver los artículos sobre el precio de Gemini 3.8 Flash y Gemini 3.5 Flash-Lite.
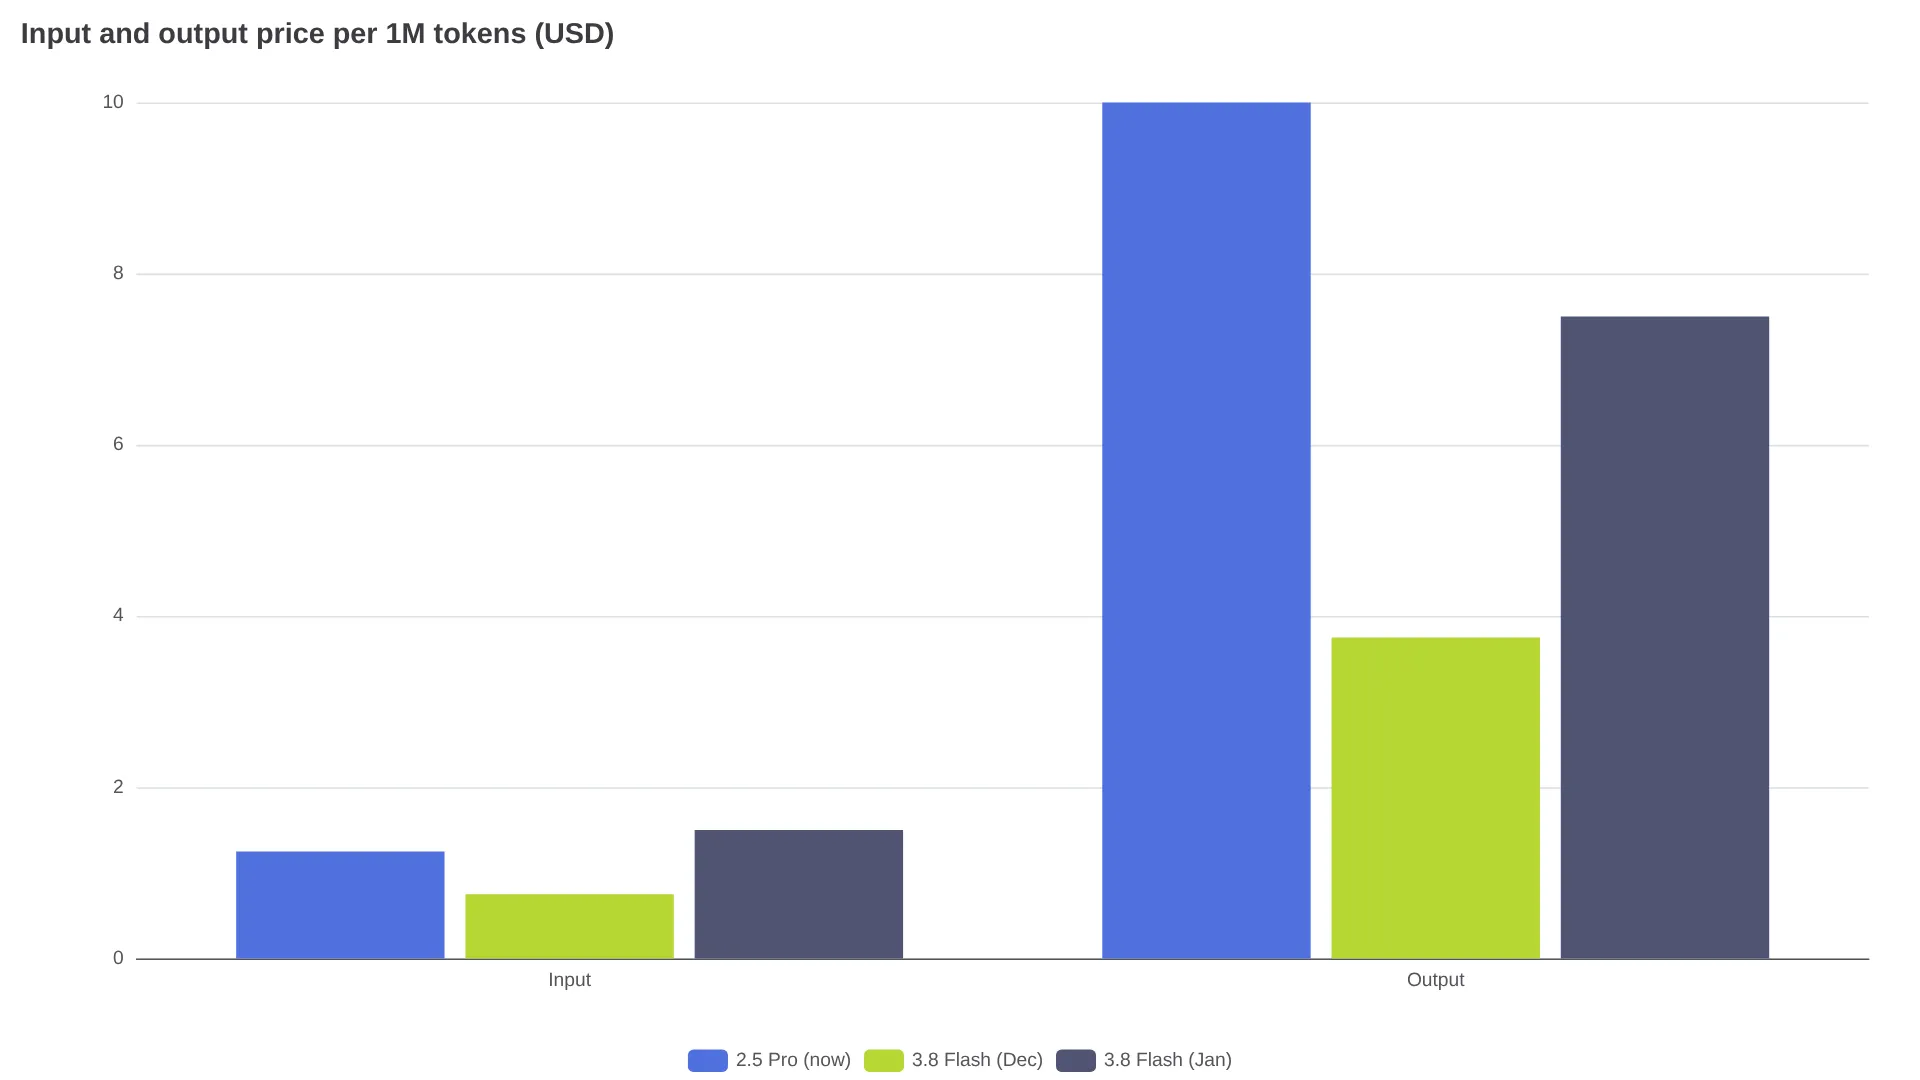
| Modelo y periodo | Entrada / 1M | Salida, incluido el razonamiento / 1M |
|---|---|---|
gemini-2.5-pro, prompts ≤200k tokens, hasta el 30 de noviembre | $1.25 | $10.00 |
gemini-2.5-pro, prompts >200k tokens, hasta el 30 de noviembre | $2.50 | $15.00 |
gemini-3.8-flash, del 1 al 31 de diciembre de 2026 | $0.75 | $3.75 |
gemini-3.8-flash, desde el 1 de enero de 2027 | $1.50 | $7.50 |
Gemini 3.8 Flash aplica una única banda de precios independientemente de la longitud del prompt, así que las cargas con más de 200.000 tokens de contexto son las que más ahorran. Un prompt de documento largo con 300k tokens de entrada y 4k de salida cuesta aproximadamente $0.81 en Gemini 2.5 Pro a $2.50/$15.00, unos $0.24 con las tarifas de diciembre de Gemini 3.8 Flash a $0.75/$3.75 y alrededor de $0.48 con las tarifas de enero a $1.50/$7.50. En enero, el único patrón que termina cerca de la factura anterior es el chat con prompts cortos y mucho peso de entrada.
El cambio de Flash es más sencillo:
| Modelo | Entrada de texto/imagen/vídeo | Entrada de audio | Salida |
|---|---|---|---|
gemini-2.5-flash hasta el 30 de noviembre | $0.30 | $1.00 | $2.50 |
gemini-3.5-flash-lite desde el 1 de diciembre | $0.30 | $0.30 | $2.50 |
La caché de contexto, el procesamiento por lotes y la prioridad siguen el mismo patrón: las tarifas de texto se mantienen y las de audio bajan. Hay un detalle importante para los presupuestos: los tokens de razonamiento se facturan como salida, y los modelos de sustitución pueden generar una cantidad distinta de estos tokens en tareas largas. No des por hecho que el recuento de salida será idéntico. Compara usage_metadata con tráfico real antes de cerrar una previsión.
Por qué la misma cadena de modelo puede romper código que funcionaba
La redirección automática conserva la respuesta HTTP 200, pero cambia el modelo que funciona por debajo. Gemini 3.x aplica reglas de solicitud que Gemini 2.5 aceptaba, así que el código puede empezar a fallar o a comportarse de forma diferente después del 1 de diciembre aunque nunca hayas tocado el nombre del modelo.
Gemini 3.x sustituye thinking_budget por thinking_level. Gemini 3.8 Flash admite low, medium y high, pero rechaza minimal; Gemini 3.5 Flash-Lite usa minimal por defecto. Enviar ambos campos devuelve HTTP 400, y compartir una configuración con minimal entre los dos reemplazos rompe la ruta de 3.8 Flash. Google recomienda minimal para extracción, enrutamiento y clasificación, y medium o high para subagentes, llamadas a herramientas, ejecución de código y razonamiento en varios pasos, con el fin de evitar que las herramientas terminen antes de tiempo.
También cambian los controles de muestreo y del historial, según la guía de migración a Gemini 3. Actualmente, temperature, top_p y top_k se ignoran en Gemini 3.x, y se espera que devuelvan HTTP 400 en futuras generaciones. candidate_count no es compatible. Cualquier solicitud cuyo último turno no vacío tenga el rol model —el truco clásico de prefijado que termina con Translation:— devuelve HTTP 400. Google recomienda usar system_instruction y salidas estructuradas.
Las llamadas a funciones también son más estrictas. Gemini 3.x valida thought_signature y exige que cada FunctionResponse incluya el ID y el nombre de la llamada correspondiente. Si eliminas la firma o reconstruyes el turno del modelo sin ella, puedes obtener respuestas STOP vacías o finales MISSING_THOUGHT_SIGNATURE en lugar de un error claro. Las pruebas de regresión deben comprobar el texto de la respuesta, no solo que no se lance una excepción.
Varios usuarios señalaron exactamente este problema pocas horas después del anuncio:
Google acaba de poner fecha al final de Gemini 2.5, y el detalle importante no es la obsolescencia, sino la redirección automática. ... Tu código no devolverá un 404. Empezará a responder discretamente con otro modelo. — @VarunChopr17597
Si tu agente todavía llama a gemini-2.5-flash, el 1 de diciembre empezará a ejecutarse en Gemini 3.5 Flash-Lite, cuyo razonamiento predeterminado es minimal. — @MarMarLabs
Migra en noviembre con este checklist de 7 pasos
La opción más segura es cambiar explícitamente el ID del modelo y revisar los parámetros durante noviembre; después, compara ambos modelos con una evaluación en paralelo frente al reemplazo de diciembre. No conviertas el enrutador automático en tu estrategia de migración.
- Localiza cada referencia y los alias de preview. Busca los dos identificadores afectados en el código, las configuraciones, los bancos de pruebas y la documentación, pero excluye el modelo Lite que no cambia:
grep -rnE 'gemini-2\.5-(pro|flash)([^-]|$)' .
- Cambia los IDs de forma explícita. Sustituye
gemini-2.5-proporgemini-3.8-flashygemini-2.5-flashporgemini-3.5-flash-liteen una rama, no la mañana del 1 de diciembre. - Corrige la configuración de razonamiento. Cambia
thinking_budgetporthinking_level, configúralo según el modelo (mediumohighpara agentes en 3.8 Flash;minimal,mediumohighde forma explícita para las cargas de Flash-Lite) y no compartasminimalcon 3.8 Flash. - Elimina los parámetros antiguos. Quita
temperature,top_p,top_k,candidate_county los turnos finales del modelo prefijados antes de probar. - Actualiza el SDK y la integración de herramientas. Instala un SDK actual, conserva los turnos completos del modelo, incluida
thoughtSignature, construyeFunctionResponsecon el ID y el nombre de la llamada, y vuelve a probar de extremo a extremo las llamadas a herramientas en varios turnos. - Repite las líneas base con el reemplazo. Compara calidad, latencia, longitud de salida y recuento de tokens de
usage_metadatausando prompts de producción; un modelo Flash no reproducirá en todas las tareas el estilo de un modelo Pro. - Recalcula el coste dos veces. Presupuesta diciembre a $0.75/$3.75 para la ruta de Pro y enero en adelante a $1.50/$7.50; revisa también las líneas de audio y caché de la ruta de Flash.
Los equipos que ya usan Gemini 3.x o gemini-2.5-flash-lite pueden saltarse esta migración. El resto debería completar el paso 6 antes del 30 de noviembre, porque una suite de pruebas en verde el 1 de diciembre podría significar únicamente que el enrutador está respondiendo, no que se haya conservado el comportamiento.
Quienes desarrollen agentes también deberían leer el desglose de precios de Gemini 3.8 Flash para tareas de agentes antes de elegir los niveles de razonamiento para cargas con muchas herramientas.
Preguntas frecuentes
¿Gemini 2.5 Pro se apagará el 1 de diciembre de 2026?
No. Google marca el 1 de diciembre de 2026 como fecha de redirección en la Gemini Developer API: las solicitudes a gemini-2.5-pro se enviarán a gemini-3.8-flash en lugar de devolver un error.
¿Las solicitudes redirigidas se facturarán con los precios antiguos o los nuevos?
Con los nuevos. Una solicitud enviada como gemini-2.5-pro después del 1 de diciembre se facturará con las tarifas de Gemini 3.8 Flash, mientras que una solicitud a gemini-2.5-flash se cobrará con las tarifas de Gemini 3.5 Flash-Lite.
¿Tengo que cambiar el código si la redirección es automática?
Sí. La configuración de razonamiento, los parámetros de muestreo, los turnos prefijados y la integración de llamadas a funciones cambian en Gemini 3.x. El código sin modificaciones puede encontrarse con parámetros ignorados, errores HTTP 400 o un comportamiento de razonamiento diferente sin aviso.
¿El 1 de diciembre también se aplica a Vertex AI?
No. El 1 de diciembre es la fecha de la Gemini Developer API. Google Cloud documenta fechas de retirada independientes, en octubre de 2026, para Gemini 2.5 en Vertex AI y Enterprise Agent Platform.
¿Gemini 2.5 Flash-Lite se ve afectado?
No. Google afirma que gemini-2.5-flash-lite no está obsoleto y seguirá disponible hasta nuevo aviso.
¿Qué reemplazo debería usar para cada carga de trabajo?
Elige según la tarea y después evalúa. No des por hecho que un modelo Flash equivale al antiguo modelo Pro.
| Carga actual | Objetivo explícito | Aspectos que debes vigilar |
|---|---|---|
| Prompts Pro generales, programación y documentos largos | gemini-3.8-flash con medium o superior | Cambio de categoría de Pro a Flash; vuelve a evaluar la calidad, la longitud de salida y el precio de entrada de enero |
| Agentes con herramientas | gemini-3.8-flash con medium o high | thought_signature, IDs de respuesta y STOP prematuro con minimal |
| Clasificación, extracción y enrutamiento | gemini-3.5-flash-lite con minimal | La opción más barata; sube a medium si añades herramientas |
| Procesos de transcripción de audio | gemini-3.5-flash-lite | La entrada de audio baja de $1.00 a $0.30; vuelve a comprobar las líneas de caché |
Qué hacer antes del 30 de noviembre
Cambia esta semana las dos cadenas de modelo, corrige la configuración de razonamiento y la integración de herramientas, y crea una nueva línea base con los modelos de sustitución mientras Gemini 2.5 todavía responde. La redirección de diciembre mantendrá el servicio activo, pero solo una migración en noviembre te permitirá conservar el control sobre el comportamiento y la factura.