 AIREITER
SWE-2 Flash parece la opción predeterminada para las colas rutinarias de Devin: alcanza 200 tokens por segundo y cuesta una quinta parte que SWE-2. La excepción son las cargas parecidas a Terminal-Bench 4.0, donde SWE-2 Flash se queda en el 20,0 %, frente al 27,3 % de SWE-2 y más del 40 % de los líderes.
Veredicto: Flash para la cola; SWE-2 para el 10 % más difícil
SWE-2 Flash merece ser la opción por defecto para el trabajo de ingeniería de gran volumen y baja ambigüedad dentro de Devin. A cambio de ciertas carencias en benchmarks concretos, ofrece una generación 3 veces más rápida y reduce de forma notable el gasto por tarea.
| Tipo de tarea | Usa | Motivo |
|---|---|---|
| Automatizaciones, revisiones de código, funciones pequeñas y actualizaciones de documentación | SWE-2 Flash | Cognition orienta SWE-2 Flash al trabajo diario; aquí importa más la velocidad que la planificación profunda |
| Refactorizaciones grandes, repositorios desconocidos y trabajo de terminal similar a Terminal-Bench-4.0 | SWE-2 | SWE-2 supera a SWE-2 Flash por 27,3 % frente a 20,0 % en Terminal-Bench 4.0 y por 73,0 % frente a 60,1 % en DeepSWE 1.1 |
| Trabajo sensible desde el punto de vista de la seguridad o en instalaciones propias | Esperar | Los pesos de SWE-2 Flash no son públicos; solo se ha prometido un futuro programa de acceso seguro |
El acceso gratuito desde Devin Desktop y CLI hasta el 30 de noviembre de 2026 permite probarlo sin apenas riesgo. Empieza las colas rutinarias nuevas con SWE-2 Flash y mide cuánto trabajo requiere rehacerse antes de comprometerte con él.
Qué es realmente SWE-2 Flash: Inkling-Small más entrenamiento intermedio
SWE-2 Flash es el modelo de programación rápida de Cognition, construido sobre Inkling-Small, de Thinking Machines. Combina una base de mezcla de expertos con 276B de parámetros totales y 12B activos con una nueva fase de entrenamiento intermedio de Cognition, previa al aprendizaje por refuerzo.
En esa fase se seleccionaron mezclas de datos mediante gráficas de eficiencia de tokens y se entrenó el modelo con unos cuantos billones de tokens, repartidos en tres fases y dejando los datos más escasos para el final. La pérdida en los datos reservados descendió a un ritmo log-lineal estable. Después, el aprendizaje por refuerzo con tareas auditadas elevó el resultado de Terminal-Bench 4.0 del 0,9 % al 20,0 % y el de FrontierCode 2.0 del 3,2 % al 24,0 %, según la publicación de Cognition del 4 de noviembre de 2026. Cognition también afirma que SWE-2 Flash alcanza 200 tokens por segundo, frente a los 60 tokens por segundo de SWE-2.
"Ya está aquí lo último de Cognition: ¡SWE-2 Flash! Un modelo Flash con 276B de parámetros totales y 12B activos. No pensaba que fuéramos a ver un modelo Flash para SWE-2; me ha sorprendido, pero lo celebro. Tiene muy buenos resultados en los benchmarks y no está tan lejos del modelo SWE-2 de 2,8T." — @ItsmeAjayKV, primera reacción de un usuario real
Los benchmarks no cuentan la misma historia: hay que leerlos por conjunto
Los resultados de SWE-2 Flash varían claramente según el conjunto de pruebas. El modelo rinde bien en tareas de software estructuradas, pero es bastante más débil en trabajos de terminal abiertos; por eso, una única media puede llevar a conclusiones equivocadas.
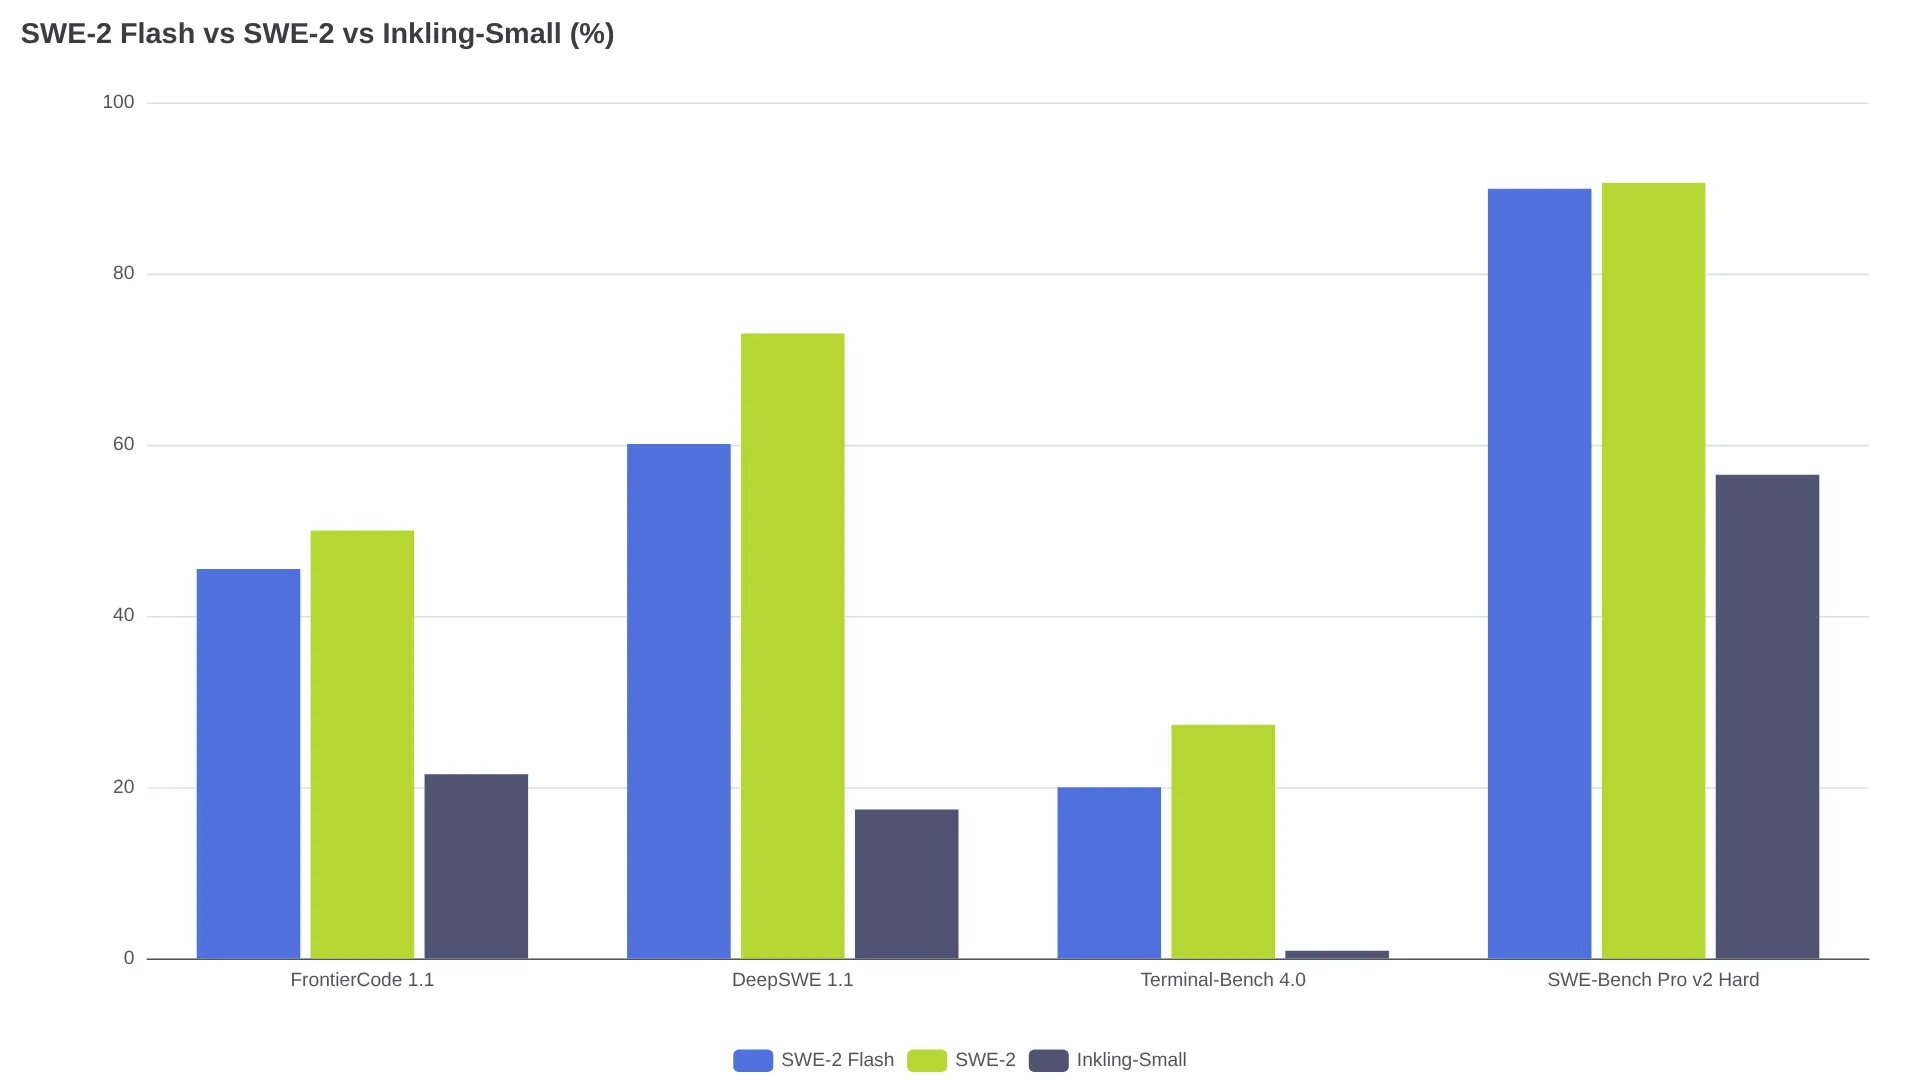
| Benchmark | SWE-2 Flash | SWE-2 (2.8T-A104B) | Inkling-Small | Mejor resultado de la tabla de Cognition |
|---|---|---|---|---|
| FrontierCode 1.1 Main | 45.5% | 50.0% | 21.5% | 50.0% SWE-2 |
| FrontierCode 2.0 | 24.0% | 23.8% | 3.2% | 27.7% Claude Haiku 5.5 |
| DeepSWE 1.1 | 60.1% | 73.0% | 17.4% | 77.0% DeepSeek V4.1 Flash |
| Terminal-Bench 2.1 | 89.2% | 92.8% | 64.7% | 94.4% Claude Haiku 5.5 |
| Terminal-Bench 4.0 | 20.0% | 27.3% | 0.9% | 42.3% DeepSeek V4.1 Flash |
| SWE-Bench Pro v2 Hard | 89.9% | 90.6% | 56.5% | 90.6% SWE-2 |
| SWE-Atlas QA | 50.0% | 56.3% | 27.4% | 71.0% DeepSeek V4.1 Flash |
| ExploitBench | 34.8% | 36.1% | 11.3% | 44.7% GPT-6 Luna |
La mejora tiene límites. SWE-2 Flash más que duplica a Inkling-Small en FrontierCode 1.1 Main (45.5 % frente a 21.5 %) y salta del 56.5 % al 89.9 % en SWE-Bench Pro v2 Hard, prácticamente a la altura de SWE-2, con un 90.6 %.
Flash no corrige los puntos débiles de SWE-2. No extrapoles el buen resultado de SWE-Bench Pro a sesiones largas de terminal: GLM 5.3 Flash alcanza un 41.8 % en Terminal-Bench 4.0 dentro de la misma tabla.
La afirmación sobre los pesos abiertos necesita contexto. SWE-2 Flash supera a Muse Spark Open en la mayoría de las filas (60.1 % frente a 60.0 % en DeepSWE 1.1 y 24.0 % frente a 6.2 % en FrontierCode 2.0), pero DeepSeek V4.1 Flash y GLM 5.3 Flash lo superan en Terminal-Bench 4.0, SWE-Atlas QA y DeepSWE 1.1. Todas las cifras proceden de los proveedores, cada modelo se evaluó con su configuración de máximo esfuerzo y los sistemas de evaluación no son iguales entre proveedores.
Qué significa pagar una quinta parte cuando no hay una tarifa pública
No existe una tarifa por token porque tampoco hay un endpoint independiente. La única referencia de precio es la proporción de coste por tarea de Cognition: una quinta parte de los dólares por ejecución de SWE-2, incluido el modelo, el sistema de evaluación y la infraestructura de servicio.
La proporción sirve como orientación, pero está incompleta. Cognition tampoco ha publicado nunca el coste por tarea de SWE-2; el desglose de SWE-2 de OrcaRouter solo pudo citar Fable 5.1 como referencia, con 3,28 $ por tarea de FrontierCode con esfuerzo medio y 12,83 $ al máximo. Los planes de Devin que aparecen allí eran Free, 0 $; Pro, 20 $ al mes; Max, 200 $ al mes; y Teams, 80 $ más 40 $ por puesto: facturación por suscripción, no tokens medidos. Que una tarea cueste una quinta parte no significa automáticamente que la factura de Devin vaya a bajar.
La lectura práctica es sencilla: el periodo gratuito hasta el 30 de noviembre de 2026 en Devin Desktop y CLI cubre a los usuarios de Pro, Max y Teams y ofrece la forma más barata de medir el consumo real. Sigue el número de tareas completadas por semana y la tasa de retrabajo, no los tokens. Si SWE-2 Flash resuelve los tickets rutinarios a la primera y a 200 tok/s, el ahorro real puede ser superior al que sugiere la proporción de 1/5; si necesita escalar tareas a SWE-2, el ahorro desaparece.
Quién puede usarlo: acceso exclusivo a Devin y un programa de pesos que no equivale a pesos abiertos
Por ahora, la disponibilidad de SWE-2 Flash es muy limitada. Cognition indica que se puede usar desde Devin Desktop y Devin CLI.
No hay un identificador de API público, pesos en Hugging Face ni una vía para ejecutarlo en infraestructura propia. Cognition justifica la restricción por la gestión del riesgo cibernético: el entrenamiento de SWE-2 Flash se orientó deliberadamente a tareas de ciberseguridad, lo que elevó ExploitBench del 11.3 % al 34.8 %, y esa misma capacidad podría ayudar a los atacantes. La solución propuesta es un programa para compartir los pesos de forma segura con socios industriales y laboratorios de investigación de confianza; los detalles llegarían en unas semanas. Hay que entenderlo como un plan de acceso controlado, no como un compromiso de publicar pesos abiertos.
Fuera de Devin, hoy no se puede evaluar SWE-2 Flash directamente: no existe un endpoint público ni una vía para alojarlo por cuenta propia.
¿Flash o SWE-2? Una regla de enrutamiento por tarea
El volumen va a SWE-2 Flash; la ambigüedad, a SWE-2.
Usa primero SWE-2 Flash para automatizaciones, actualizaciones de dependencias, incorporación de pruebas, respuestas a revisiones, funciones pequeñas con criterios de aceptación claros y actualizaciones de documentación. Son tareas que encajan con los conjuntos en los que SWE-2 Flash queda a pocos puntos de SWE-2: FrontierCode 2.0, con 24.0 % frente a 23.8 %, y SWE-Bench Pro v2 Hard, con 89.9 % frente a 90.6 %.
Escala a SWE-2 cuando la tarea requiera planificar cambios en varios archivos, ejecutar secuencias largas en terminal o razonar sobre problemas cercanos a la explotación. Ahí las diferencias son importantes: pierde 12.9 puntos en DeepSWE 1.1, 6.3 puntos en SWE-Atlas QA y 7.3 puntos en Terminal-Bench 4.0. El análisis de SWE-2 de HamiRev describe SWE-2 como un modelo ajustado para dar menos pasos y editar antes que SWE-1.7, una inclinación hacia las tareas cortas que SWE-2 Flash lleva aún más lejos.
Empieza cada ticket en SWE-2 Flash con un límite de dos ciclos y escala después el trabajo atascado a SWE-2. Revisa la decisión cuando termine el periodo gratuito de noviembre y el gasto real de Devin sustituya a la proporción de 1/5. El punto pendiente sigue siendo la transparencia: el programa de pesos seguros podría abrir la puerta al despliegue privado, pero los equipos regulados no pueden planificar en torno a SWE-2 Flash hasta conocer sus condiciones.
Preguntas frecuentes sobre SWE-2 Flash
¿Está disponible SWE-2 Flash mediante API?
No existe una API independiente de SWE-2 Flash. El acceso se realiza desde Devin Desktop y Devin CLI, gratis para los usuarios de Pro, Max y Teams hasta el 30 de noviembre de 2026.
¿SWE-2 Flash tiene pesos abiertos?
No. Cognition menciona el riesgo cibernético y solo promete un futuro programa de acceso seguro para socios y laboratorios de investigación seleccionados.
¿Cómo se compara SWE-2 Flash con SWE-2?
SWE-2 Flash funciona a 200 tok/s frente a 60 tok/s y cuesta una quinta parte según el cálculo de coste por tarea de Cognition. SWE-2 sigue por delante en DeepSWE 1.1 (73.0 % frente a 60.1 %) y Terminal-Bench 4.0 (27.3 % frente a 20.0 %).
¿Cuál es la ventana de contexto de SWE-2 Flash?
Cognition no ha publicado las especificaciones de ventana de contexto, salida máxima ni modalidades de SWE-2 Flash. No des por hecho que hereda los límites de Inkling-Small.
¿Qué ocurrirá después del periodo gratuito del 30 de noviembre?
Cognition no ha comunicado cómo se facturará SWE-2 Flash después de la promoción. Lo esperable es que el consumo se gestione mediante la suscripción de Devin, no con un precio independiente por token.